发布
发布文章
创建话题
创建版块
发布帖子
开通会员
黄金会员
全站资源折扣购买
部分内容免费阅读
一对一技术指导
VIP用户专属QQ群
开通黄金会员
钻石会员
全站资源折扣购买
部分内容免费阅读
一对一技术指导
VIP用户专属QQ群
开通钻石会员
简体中文
English
开通会员 尊享会员权益
登录
注册
找回密码
快速登录
QQ登录
微信登录
简体中文
English
开通会员 尊享会员权益
登录
注册
找回密码
快速登录
QQ登录
微信登录
数据源
共1篇
排序
更新
浏览
点赞
评论
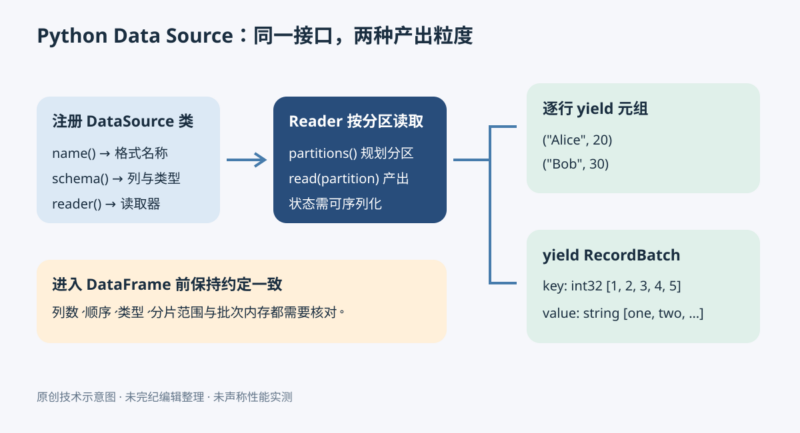
为 PySpark 注册按行和 Arrow 批次读取的数据源
完整实现两个Python批读取数据源:以元组逐行产出,或直接yield Arrow RecordBatch,理解注册、schema、分区与序列化约束。
技术译文
彩雨伞
5小时前
0
25
0
发布文章
创建话题
创建版块
发布帖子
在手机上浏览此页面
登录
没有账号?立即注册
手机号或邮箱
验证码
发送验证码
记住登录
账号密码登录
登录
用户名/手机号/邮箱
登录密码
记住登录
找回密码
|
免密登录
登录
社交账号登录
QQ登录
微信登录
使用社交账号登录即表示同意
用户协议
、
隐私声明
注册
已有账号,立即登录
设置用户名
手机号或邮箱
验证码
发送验证码
设置密码
注册
已阅读并同意
用户协议
、
隐私声明
扫码登录
使用
其它方式登录
或
注册
扫码登录
扫码登录即表示同意
用户协议
、
隐私声明


 5小时前5小时前
