
排序
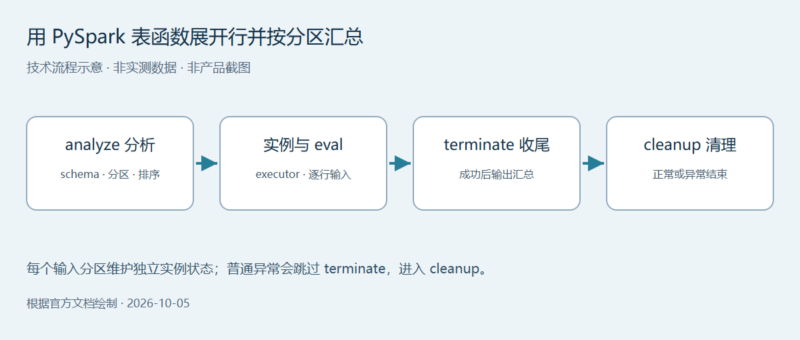
用 PySpark 表函数展开行并按分区汇总
完整讲解Python UDTF的生命周期、schema、LATERAL、Arrow、日期与文本展开、按表参数分区汇总,并修正动态analyze示意代码中的错误。

 3小时前
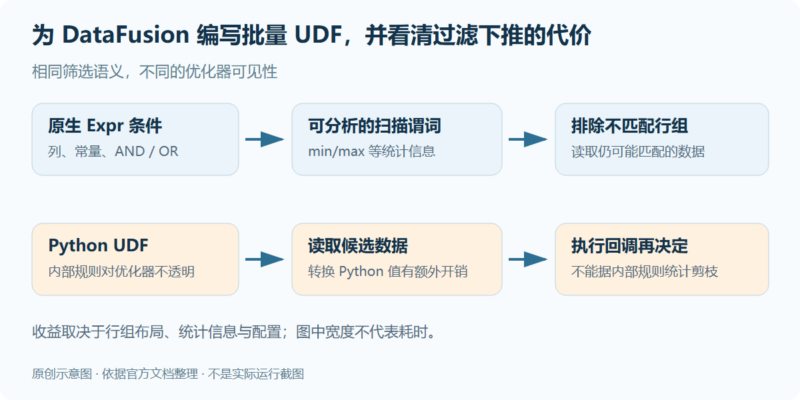
为 DataFusion 编写批量 UDF,并看清过滤下推的代价
从 Arrow 批量标量函数到可合并聚合状态、窗口函数和表函数,结合 Parquet 执行计划解释原生表达式与 Python 回调的差别,并标注当前接口修正。
5小时前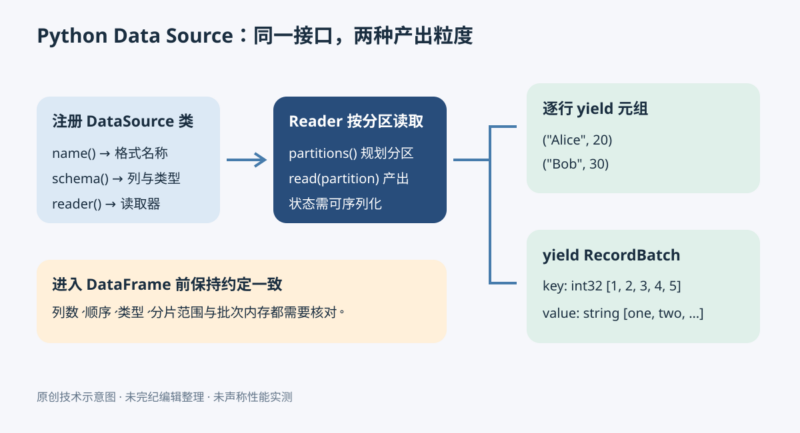
为 PySpark 注册按行和 Arrow 批次读取的数据源
完整实现两个Python批读取数据源:以元组逐行产出,或直接yield Arrow RecordBatch,理解注册、schema、分区与序列化约束。
6小时前