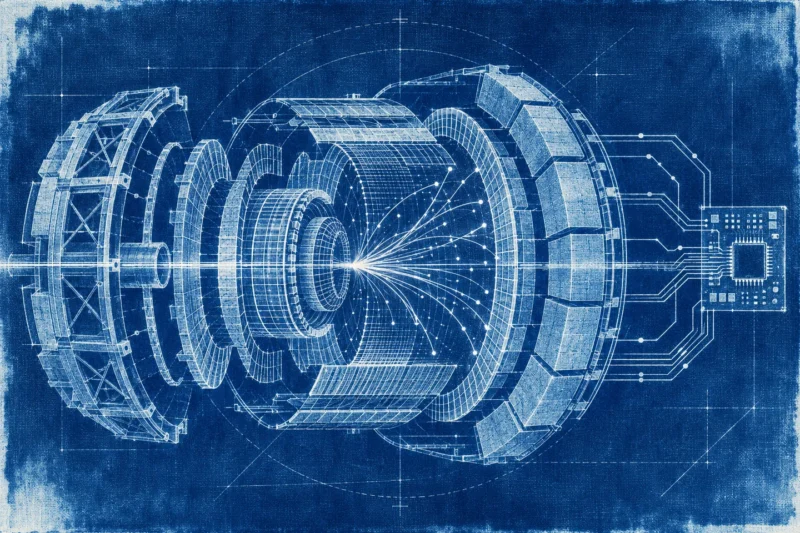

对撞机实验不能把所有探测器读数都长期保存。碰撞持续发生,探测器的读出带宽、存储和后续计算能力却有限,因此系统必须尽早筛选值得保留的事件。触发器承担的正是这道选择:在极短的时间里,判断一次碰撞是否具有某些目标特征,然后决定是否让它进入后续处理。
机器学习可以提高分类能力,但在触发系统中,离线测试成绩只是起点。输入何时到齐、运算需要多少时钟周期、芯片有没有足够资源,以及筛选是否改变物理分布,都可能决定一个模型能否使用。Duarte 等在 2018 年发表的 hls4ml 研究,以喷注分类为案例,展示了把训练后的神经网络转换为 FPGA 电路的路线。
为什么推理速度也是物理能力的一部分
实验的触发通常分层进行。较早的硬件层需要在严格时限内做粗筛,之后的软件层拥有更多信息和较长处理时间,可以执行更复杂的重建。CMS 对第一运行期触发系统的论文,具体描述了这种分层结构及其工作方式。不同运行时期的速率和延迟预算会变化,因此旧论文中的数字需要结合当时系统解释。
触发选择会直接决定哪些碰撞能够进入物理分析。如果某类低能信号很难通过简单阈值,后续再精巧的离线模型也无法找回没有保存的事件。一个在同样背景通过率下保留更多信号的实时分类器,可能扩大可研究的相空间。这种收益应在具体信号与工作条件下计算,不能由模型名称推出。
延迟与吞吐量又是两件事。延迟表示一个事件从输入到输出需要多久,吞吐量表示单位时间能够接收多少事件。流水线可让多个事件处在不同计算阶段,因此一个事件需要多个周期,并不意味着系统只能每隔这么多周期接收下一事件。报告“推理很快”时,必须同时说明两项指标以及输入输出的定义。
例如在一个合成流水线中,时钟周期为五纳秒,单个事件经过二十级运算,核心延迟就是一百纳秒。如果每一级都能在每个周期接收新输入,流水线填满后便可能每五纳秒输出一个结果;若某个单元必须复用四次,启动间隔又可能变长。两个设计可以拥有相同延迟,却有不同的持续输入能力。系统选择取决于数据到达方式与缓冲条件。
hls4ml 把网络变成了怎样的计算
普通神经网络的一层通常包含乘加运算与非线性函数。FPGA 允许把这些运算映射成可重配置的逻辑、乘法单元和存储,再由确定的时钟节拍推进。hls4ml 使用高层综合工具,将受支持的模型描述转换成硬件实现,减少研究者逐个编写底层电路的工作。
Duarte 等的案例使用喷注子结构特征区分不同来源的喷注,并考察网络规模、数值精度、延迟和资源消耗的关系。论文给出的特定实现达到约百纳秒尺度的推理。这一数字属于指定模型与硬件配置,既不等于完整触发系统的延迟,也不保证任何大型网络都能以同样速度运行。
资源分配的核心是并行程度。若许多乘法同时完成,延迟可以很低,但会占用更多算术资源;若让同一组计算单元反复处理不同乘法,芯片占用可下降,运算时间则可能增长。软件框架中的一个参数变化,在这里会变成电路规模、走线压力和时序收敛难度的变化,最终仍需综合和布局布线结果支持。
打开 HTML 互动演示 · 改变阈值,看看触发器保留了哪些事件
一个定点数算例:为什么少几位能够省资源
以下是解释数值精度的合成算例,不对应论文配置。设某个有符号定点格式总长十位,其中五位用于小数部分,则量化步长为三十二分之一,约为 0.03125。在采用就近舍入且未溢出的情况下,单次数值表示误差不超过约 0.015625。小于这一尺度的变化,可能被舍入为相同数值。
问题是,网络误差不能简单等同于一个量化步长。多项乘加会累积误差,激活函数可能改变传播方式,少数幅度很大的输入又可能使中间结果溢出。即使每个权重都能安全表示,累加器仍可能需要更宽的位数。确定格式时,应检查输入、乘积和累加结果各自的分布,以及边界条件下的最大值。
更合理的流程是先得到浮点参考,再逐层压缩精度,比较最终分类和物理指标的变化。量化感知训练可让优化过程提前适应离散表示,但也需要真正的硬件数值模拟验证。若只比较平均误差,少量接近决策阈值的事件可能被遗漏;而这些事件恰恰可能改变触发率或低能端效率。
模型竞争的基准应由触发任务决定
神经网络需要与简单阈值、线性分类器和树模型在同一数据、同一输入条件下比较。Summers 等在 2020 年研究了使用 hls4ml 将提升决策树部署到 FPGA 的方法,说明低延迟推理并非神经网络独有的优势。不同任务的特征维度和决策结构,会改变哪类模型更合适。
比较时,应固定允许的背景通过率,查看信号效率,而非只比较整体准确率。这里的信号效率是目标事件通过选择的比例,背景通过率是无关事件被保留的比例。二者还应按横向动量、角度、堆积碰撞条件等变量展开。一个总分更好的模型,可能在某个重要物理区域表现更差。
阈值也不能脱离碰撞速率理解。假设在某个合成条件下,每秒有一百万个可供选择的背景候选,允许输出一万个,那么背景通过率大约只能达到百分之一。运行条件改变后,候选数翻倍,即使分类器完全不变,同一阈值也可能令输出超过预算。因此,研究者需要区分分类性能稳定与触发率稳定,并决定如何在预先定义的条件下调整工作点。
还必须把前处理算进去。如果某个模型依赖在实时链路中无法及时获得的高精度特征,其离线优势没有直接部署意义。相反,较简单的模型若只需要现有硬件已经输出的量,可能拥有更低的工程成本。完整基准应包含特征形成、数据搬运、运算和输出接口,避免只测网络核心而忽略真正的瓶颈。
从模拟精度到真实碰撞,需要补哪些证据
训练常依赖模拟事件,但探测器响应、粒子形成过程和运行条件的建模都可能存在差异。若模型抓住的是模拟器特有的相关性,模拟测试集再独立也不能证明它适用于真实碰撞。研究者需要利用合适的控制样本,检查关键特征和分类分数在数据与模拟之间是否相容。
触发本身还会产生选择偏差。只观察已经被同一个触发器选中的样本,往往难以测出它漏掉了什么。实际效率测量通常需要独立选择路径或适合的标记与探测设计,再考虑这些参考样本自己的条件。模型更新后,也要检查新旧选择对物理质量谱和其他分析变量的影响。
假设一个合成测试中,某背景变量与分类分数相关,施加阈值后原本平滑的质量分布出现局部堆积,那么后续共振搜索就可能受到影响。即使整体误报率较低,这种形状变化也不能忽略。应通过独立样本、质量侧带或模型相关性研究,确定最终分析方法能够正确描述触发引入的结构。
上线之前,怎样证明硬件确实执行了同一个模型
浮点模型、定点仿真、综合生成的电路和真实板卡之间,需要建立逐级一致性。可以选择正常样本、极值输入和接近阈值的样本,逐项核对输出;对于允许的数值差异,明确它来自何种舍入规则。接口的位宽、符号解释和输入排序错误,都可能让一块运行正常的板卡计算错误的函数。
验证样本还应覆盖不常见的输入组合,例如多个特征同时取大值、缺失信息被编码为特殊数值,或者输入接近格式边界。平均情况下没有溢出,并不证明这些组合安全。对于本来不应出现的编码,也应明确系统如何处理,才能让实时链路的行为具有可预测性。
工程验收还包括最坏条件下的时序、连续输入下的吞吐、资源余量和系统复位行为。一次短暂演示成功,不能证明长时间运行中没有丢帧或背压。任何“满足延迟预算”的结论,都需要说明测量边界和配置,最好保留可重复生成固件的模型、转换参数与工具版本。
这项技术的科学价值,最终体现为在固定实时约束下保留了哪些事件。如果更低位宽导致重要信号效率下降,或真实板卡无法达到目标时钟,离线分类优势就不足以支持采用。反过来,若模型在控制背景、维持物理分布和硬件一致性方面都得到验证,它才真正把机器学习的识别能力转化为实验可以使用的选择能力。