
分子动力学反复执行同一个循环:根据原子位置计算受力,再用受力推进位置与速度。如果每一步都求解电子结构,大体系与长时间轨迹就会十分昂贵;如果改用简单经验势,计算可以更快,却可能遗漏研究所需的相互作用。机器学习势函数尝试在两者之间建立一条可验证的近似路线。
Zhang 等在 2018 年发表的 Deep Potential Molecular Dynamics,以电子结构参考数据训练神经网络势能,再由势能导数计算力。它的主要收益是将大量昂贵计算提前集中到数据生成与训练,让后续轨迹反复使用较便宜的模型。要判断这种节省是否有科学价值,需要追踪参考方法、表示假设、数据覆盖与目标物理量四个环节。
势函数近似了什么,哪些计算仍然存在
在常见的玻恩—奥本海默近似下,给定原子核位置后,电子结构计算提供一个势能面及其导数。机器学习势学习的是这个位置到能量与力的映射,并不直接消除电子问题的近似。若参考数据来自某个密度泛函、赝势与数值配置,模型继承的就是这套计算定义下的势能面。
因此,“达到量子计算精度”需要明确参照。与某套密度泛函数据十分接近,表示拟合误差较小,不等于已经消除该参考方法相对于实验的系统误差。训练数据的基组、截断能、电子收敛与应力计算,也应达到目标精度,否则网络可能忠实地学习了数值噪声或不一致标签。
实际成本还包括构型生成、参考标注、模型选择与最终验证。若只跑一条很短的轨迹,前期投入未必划算;若同一可靠势能面支持大量温度、压力或结构任务,成本才可能被充分摊薄。速度比较最好在相同目标误差和系统条件下进行,并区分训练总成本与部署后的单步成本。
局部原子环境为什么能让模型扩展到大体系
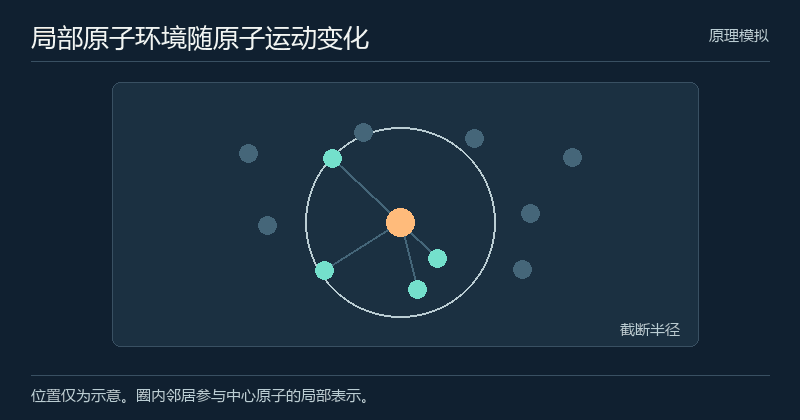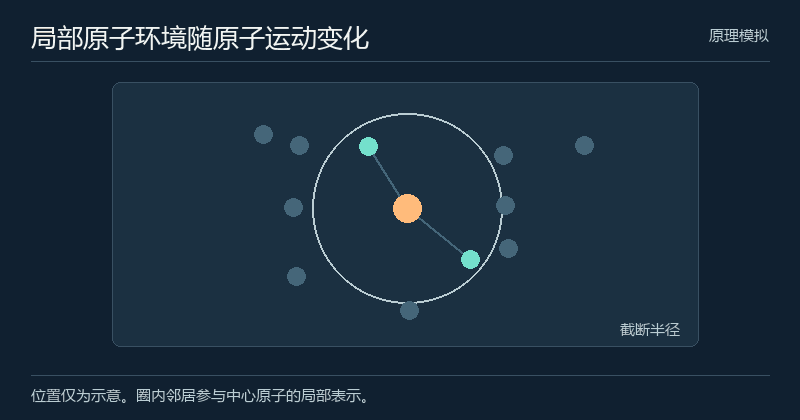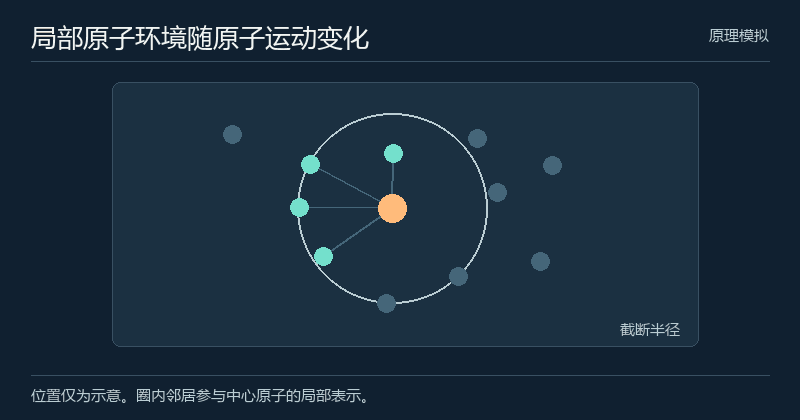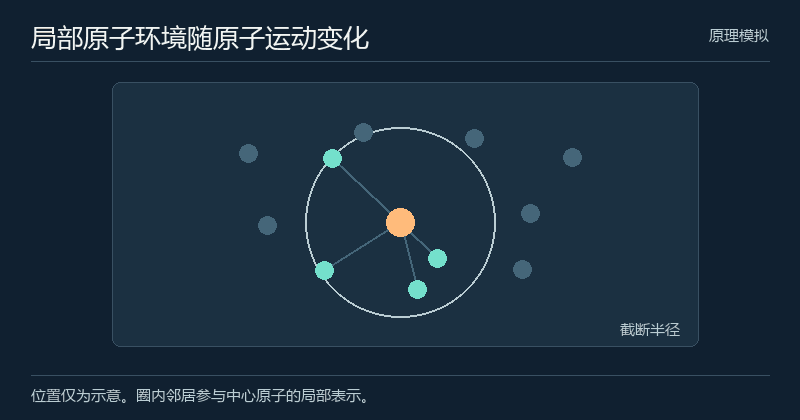
Deep Potential 将总势能表示为原子局部贡献之和。每个贡献由截断半径内的邻居环境决定,同种元素共享相应的模型规则。这种构造使模型能够处理不同原子数量,并在邻居数受控的条件下,让计算成本随体系大小近似线性增加。它利用的是物理局域性近似,而不是简单把所有坐标拼接到固定长度输入。
几何对称性尤其关键。整体平移或旋转不应改变总势能,同种原子的编号交换也不应改变物理结果。原始方法通过局部环境表示处理这些要求。力则需要随坐标旋转而相应旋转,不能像标量能量一样保持各分量不变。测试对称性时,必须区分不变量与随变换改变的矢量。
局部性同时带来适用边界。如果目标体系的重要作用延伸到截断范围之外,例如某些长程静电或极化效应,单纯缩小局部测试误差未必足够。可以改变截断半径、体系尺寸与电荷环境,检查目标量是否收敛;也可能需要显式长程部分。不能把某个局部模型在一种条件下的成功外推到所有材料。
原子能量贡献还需要谨慎解释。训练主要约束的是总能量与导数,局部分解通常并不唯一。两个模型可能对同一构型给出相同总能量和相近的力,却把能量分配到不同原子上。因此,某个原子的网络输出较高,不能直接当作独立测得的化学键能或局部稳定性。若要作这类解释,需要额外定义与验证。
展开演示动图 · 局部环境随位置改变
为什么能量、力与应力要一起检查
由同一个势能函数对坐标求负梯度得到力,有助于保持能量与力的一致性。但训练只拟合能量,仍可能在导数上产生较大误差:两条曲线数值接近,其局部斜率可以不同。原始研究使用能量、力及相关量的训练信息,正是为了让势能面在动力学需要的方向上受到更充分约束。
损失中的不同项需要单位与权重约定。总能量随原子数增长,而每个构型提供许多个力分量;若不适当归一化,某一项可能仅因数量更多而主导训练。评估也应同时给出每原子能量误差、力误差分布及高误差尾部。平均值无法反映少数极端构型是否会使轨迹失稳。
压力或应力对晶格变化、相稳定性和弹性性质很重要。即使常温固定体积下的力很准,模型也可能在压缩或拉伸方向上失真。针对这些任务,应单列体积扫描、应力响应和弹性变形,检查模型对晶胞自由度的导数,而不是认为原子力合格就意味着所有热力学量合格。
一个合成算例:小势垒误差怎样改变速率
考虑仅用于说明敏感性的跃迁模型,速率近似正比于 exp(−ΔE / k_B T)。若模型把势垒低估 0.05 电子伏,在三百开尔文时,k_B T 约为 0.0259 电子伏,预测速率可能因此增大约七倍。这里使用的是合成势垒与简单热激活近似,并非 Deep Potential 论文的实验结果。
这个例子说明,整体能量误差很小,也可能不足以支持稀有事件速率。决定速率的是初态与过渡区域之间的能量差,而训练数据常以平衡构型为主,过渡区域可能很少出现。模型在常见构型上取得优良平均误差,并不能代替对反应路径、缺陷迁移或成核相关构型的专项验证。
同样需要区分轨迹与统计量。分子动力学具有对初始条件的敏感性,近似势与参考势的原子轨迹可能很快逐点分离。逐帧位置不一致并不一定意味着平衡统计错误;反过来,一段动画看起来合理,也不能证明扩散常数或相稳定性正确。应该根据科学目标选择可比较的统计量。
数据覆盖比随机切分更决定能否外推
从一条轨迹随机抽取训练和测试帧,容易让两边包含高度相似的局部环境。这样的测试主要反映插值能力。若最终研究高温、缺陷、表面或相变,应按温度区间、结构族、独立轨迹甚至物相划分验证集,明确区分训练覆盖内与覆盖外的任务。
DP-GEN 在 2020 年提出的并发学习平台,将探索、参考标注与训练循环连接起来。常见做法是训练多个模型,利用它们在候选构型上的分歧筛选值得追加标注的样本,再用昂贵方法计算标签。这比无差别标注大量重复平衡构型更有针对性,但模型分歧仍是一种启发式信号。
多个模型也可能共享盲点,同时对陌生区域给出相近错误答案。因此,需要用独立参考计算校准分歧阈值,并加入研究目标要求的主动挑战样本。极端短程接触、不同配位和不常见化学环境尤其值得检查。探索算法没有访问某个区域,并不代表真实目标条件下不会出现它。
追加标注后,还要重新测量旧任务。新数据可能改善过渡态,却使训练权重分配发生变化,影响原先的平衡结构精度。保留覆盖已支持条件的固定回归集,能防止模型在扩展适用范围时悄悄丢失旧能力。数据量增长不是唯一目标,新增构型应能说明它补上了哪类物理环境。
从数值稳定到物理可信,验证应分几层
第一层是基本数值与几何检查:坐标单位、元素类型、周期边界与总能量约定一致,平移旋转测试通过,解析或自动微分的力与有限差分相容。第二层是独立参考构型上的能量、力和应力误差。这些环节能排除接口和拟合问题,却还没有证明长期统计正确。
第三层应直接面向目标物理量。液体可检查径向分布、角分布与扩散,晶体可检查晶格常数、振动与弹性,相变任务则需要比较有关相的自由能或相稳定性。不同量的误差传播不同,结构分布吻合并不自动保证动力学时间尺度吻合。原始 Deep Potential 研究与 DeePMD-kit 论文提供了相应体系上的方法和示例。
还要区分势函数误差与积分误差。孤立体系测试中的能量漂移,可能来自时间步过大、邻居更新或模型不够平滑;恒温器又可能掩盖某些漂移。可先缩小时间步检查收敛,再比较不同积分设置,并在适当条件下观察总能量。稳定跑完很多步只是必要线索,不能独立证明势能面正确。
输运系数则需要足够长的统计时间和尺寸检验。例如扩散常数从均方位移的长时间增长提取,短时间的弹道区间与统计噪声都可能影响拟合。若势函数误差与有限时间误差尚未分开,就很难解释结果偏离参考究竟来自模型,还是模拟没有采到足够多的独立运动过程。
怎样阅读一项“加速而不失精度”的结论
有说服力的报告应同时说明元素、结构、温度与压力范围,参考电子方法,训练数据生成方式,以及真正检验的观测量。对于某个温度点表现良好的模型,应把适用结论写在这个范围内。若要声称可研究缺陷或化学变化,需要提供这些过程的独立样本和相关结果。
基准方法也要合适。与简单经验势比较,可以展示表达能力;与同等参考数据训练的其他机器学习势比较,可以研究表示和数据效率;与直接电子结构轨迹比较,则能检验近似是否保留了目标统计。不同比较回答不同问题,任何一项都不能替代其余所有证据。
如果模型在参考测试上很好,却在目标条件下生成异常配位、错误相序或明显失真的迁移势垒,就需要扩大数据或调整物理表示。如果参考方法本身偏离实验,继续压低训练误差也无法解决根源。机器学习势真正省下的,是重复求解相同类型电子问题的成本;可靠性则来自对这次替代的适用范围进行持续、具体的验证。