
把一张照片反复混入少量随机噪声,轮廓和纹理会逐渐消失,最后接近无结构的随机数组。扩散模型把这个容易模拟的破坏过程,变成学习生成分布的入口:训练网络在不同噪声强度下预测可以用于去噪的信息,再从随机噪声开始,逐步生成新的样本。
Ho、Jain 与 Abbeel 在 DDPM 中给出了一套清晰的概率模型和训练方法。它既不是从某个随机种子里寻找一张早已藏好的照片,也不是每一步都查找最相似的训练图。网络学习的是一组反向转移规则,生成质量取决于数据、表示能力、训练目标和采样设置。DDPM 原论文
前向过程为什么可以预先规定
设干净图像为 x₀,第 t 步的噪声量为 βₜ,前向过程让 xₜ 等于 √(1−βₜ)xₜ₋₁ 加上标准差为 √βₜ 的高斯噪声。βₜ 随时间的安排称为噪声日程。它由建模者规定,不需要网络学习。经过足够多步后,原始图像的贡献变得很小,末端分布便接近便于采样的高斯分布。
令 αₜ=1−βₜ,ᾱₜ 为从第一步到第 t 步的 α 连乘,可以直接得到 xₜ=√ᾱₜ x₀+√(1−ᾱₜ)ε,其中 ε 是标准高斯噪声。这意味着训练时不必真的从第一步连续加噪到第 t 步;选定图像、时间步和一次噪声采样,就能构造对应训练输入。不同时间步提供了不同难度的去噪任务。
这个表达式还说明,所谓噪声等级既关系到扰动幅度,也关系到保留下来的信号比例。可以用 ᾱₜ/(1−ᾱₜ)描述一种信噪比。接近末端时,图像信息很少,网络更依赖训练分布中的整体规律;接近干净端时,输入已保留丰富结构,问题更偏向细节修正。时间步因此必须作为条件送入网络。
预测噪声怎样连接到生成图像
常见的简化训练目标,是让网络 εθ(xₜ,t)预测前向构造时加入的 ε,并最小化两者的平方误差。目标看起来只是回归噪声,但输入中混合了干净图像与噪声,模型要利用图像分布的规律才能给出有用估计。给定同一个带噪样本,原图与噪声一般并不唯一,最优预测涉及条件分布,而不是逐次精确找回某次随机数。
采样时,模型输出与预先规定的系数共同确定反向转移分布的均值,再按照采样规则加入相应随机项,得到前一个时间步。反复执行后,结果逐渐靠近数据分布。若网络在很多时间步都有小偏差,偏差还可能沿生成轨迹累积。因此,某个噪声等级上的低均方误差,不能独立保证整条采样链表现良好。
需要区分训练目标与实现选项。模型可以采用不同预测参数化、噪声日程和方差处理,它们之间存在数学联系,却不应在代码中随意混用。加载检查点时,要同时加载训练使用的配置。若把预测噪声的输出误当成干净图像,网络本身没有报错,采样结果仍会完全失真。
展开演示动图 · 前向加噪
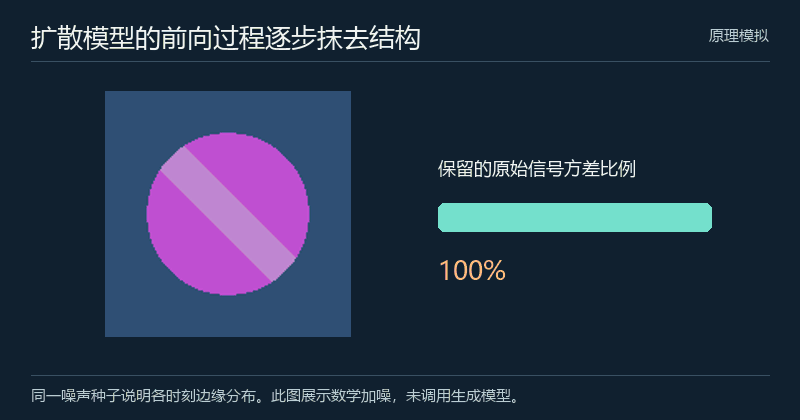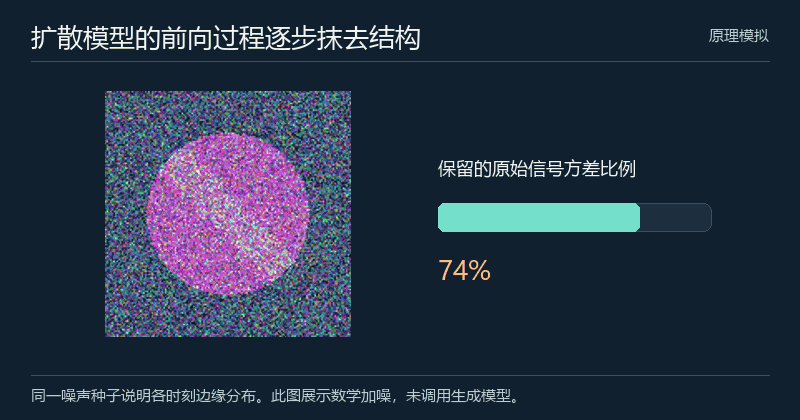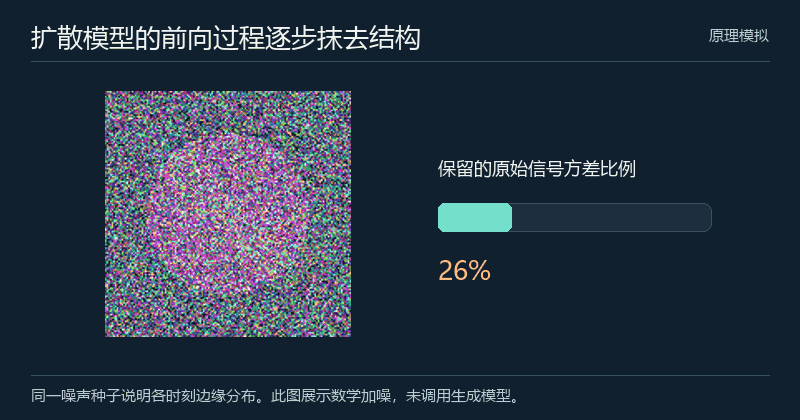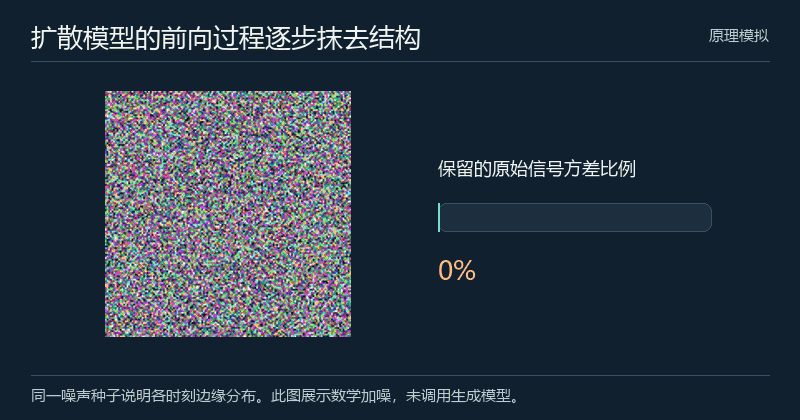
一个合成数值例子揭示信息损失
考虑单个像素的教学例子,设 ᾱₜ=0.81,干净值 x₀=0.8,本次噪声 ε=−0.5。则 xₜ=0.9×0.8+√0.19×(−0.5),约为 0.502。这个数值不是实验测量,只是展示混合关系。若知道真实噪声,可以通过代数运算恢复 0.8;生成时网络只能提供预测,因此恢复结果会受到预测误差影响。
假设网络把噪声估成 −0.4,按同样公式计算的干净值约为 0.752,已经产生约 0.048 的误差。更一般地,干净值估计对噪声预测误差的放大系数为 √((1−ᾱₜ)/ᾱₜ)。当 ᾱₜ 很小时,这个系数会变大。因此,在高噪声端直接要求恢复精确像素并不稳定,逐步采样与合理的参数化就显得重要。
这个例子也提醒我们不要把每张中间图都当作应当清晰可辨的结果。在高噪声阶段,可见形状很少是正常的;为了展示而把数值强行截断、锐化或改变对比度,可能让人误读采样轨迹。研究记录应保留真实张量范围与相同可视化设置,避免展示处理掩盖数值问题。
模型结构与数据处理有哪些取舍
图像扩散网络常用带时间条件的 U-Net 一类结构,通过多尺度特征处理局部细节与较大范围的关系。高分辨率会增加每次网络调用的成本,训练还需保存中间激活。若把扩散放在压缩表示中,可以降低空间尺寸,但压缩器的重建能力会成为另一项限制。像素空间与压缩空间的误差不能只用同一个直觉判断。
数据预处理也属于模型定义。图像范围是零到一还是负一到一,裁剪是否保留主体,通道顺序是否一致,都会影响学习与采样。若训练图中经常把物体裁成相似构图,模型可能生成漂亮但单调的结果。重复样本和来源高度集中的数据,也可能让模型对少数视觉模式过度偏好。
条件生成还要说明条件从哪里进入网络。类别标签、文字或其他图像不是自动存在于 DDPM 的基本公式里,需要相应的条件结构与数据。即使使用相同的去噪目标,无条件生成质量、文字遵循和精确布局控制仍是不同任务。不能把某个无条件图像实验的结果,直接当成完整文生图系统的能力证明。
少做几步能省多少,代价怎样测量
假设一次去噪网络调用在指定设备上耗时 20 毫秒,做 1000 次约需 20 秒,做 50 次约需 1 秒。这是忽略启动和数据搬运的合成预算,不能作为真实产品速度。它解释了为何减少网络调用数很有吸引力,但不能说明把原采样链随意跳步就能保持质量。不同时间步之间的转移规则也需要调整。
DDIM 研究了与 DDPM 训练目标兼容的一类非马尔可夫过程,为更少步数的采样提供方法。Improved DDPM 则研究了方差学习等改变与采样效率的关系。比较这些方案时,应固定检查点、分辨率、样本数量和硬件,再画出质量随网络调用次数变化的曲线。DDIM、Improved DDPM
除了平均延迟,还要看批次、显存和极端样本。一个方案可能在大批量吞吐上更好,却没有改善单张请求的等待时间。随机种子也会影响单张结果,不能只挑出各方案最好看的几张比较。可以对相同种子运行多套采样器,再结合大量随机样本统计,区分稳定收益与展示选择。
清晰、覆盖和复制风险怎样分开检查
图像质量至少包括局部真实感、全局结构与分布覆盖。常见的 FID 在预训练特征空间里比较生成样本与真实样本的统计,它是分布层面的指标,不能逐张判断物体数量是否正确,也不能直接代表审美或文字遵循。样本数量、缩放方式和特征提取实现都应固定,否则分数很难公平比较。
研究可以建立人工定义的结构任务,例如两个不同形状必须处于指定左右关系,或一组物体具有指定数量。把局部纹理与关系准确率分别记录,可以发现模型“看起来像真图”但组合关系不对的情况。对于数据覆盖,可以按少见类别、构图和颜色组合分层抽样,而不是只计算全体平均值。
还应检查生成图与训练集的近邻,结合多种相似度和人工复查,区分常见视觉模式与可能的样本复制。训练损失下降、分布指标改善和新颖性需要分别举证。一个可复查的扩散实验,应提供数据划分、网络配置、噪声日程、采样器、随机种子和评价代码。这样,逐步去噪才从令人惊讶的视觉演示,变成能够解释和比较的生成方法。
怎样定位训练与采样中的实现错误
一个有效的调试起点,是在很小的数据子集上确认模型能够降低去噪损失,并检查各时间步的误差,而不只是全体平均值。若高噪声端与低噪声端表现差异异常,应核对时间步采样、系数广播和输入范围。图像张量中的批次、通道与空间维度不同,把系数广播到错误轴上,有时仍能运行,却不再实现预期的前向分布。
还可以直接用已知的真实噪声代替网络预测,检查代数恢复是否符合构造公式。这项检查不证明生成能力,但可以排除部分系数、索引与归一化错误。随后固定噪声种子,让同一检查点生成稳定的诊断样本,观察训练变化。若每次都更换种子,很容易把随机样本差异误认为模型已经改善或退化。
损失的数值也需要结合目标解释。不同噪声日程、参数化和时间步权重,会改变平均损失的尺度。不能把两个配置的原始均方误差直接当作同一质量标尺。可以在共同的验证采样设置下比较分布指标,并辅以结构任务与人工抽查,让训练目标和最终使用之间建立对应关系。
研究还可以区分数据不足与模型容量不足:固定模型逐步增加训练数据,再固定数据增加容量,并按相同计算预算做对照。如果更多训练只改善常见图案,对稀有组合没有帮助,就应检查数据覆盖,而不是单纯延长训练。每次只改变少数因素并保存配置,能够使扩散实验的结论比一组精选图片更有解释力。