
稀疏混合专家(Mixture of Experts,MoE)把 Transformer 中部分前馈层改成可按输入选择的并行分支。同一层可以存放八个前馈专家,每个词元只执行其中一个或两个。同一批里的其他词元可能选择不同的专家,因此整批实际访问的权重范围通常比单个词元更大。总参数量、每词元激活参数量和实际推理成本,分别回答权重有多少、一次前向调用哪些权重、硬件为此付出多少时间和资源。
以 Switch Transformer 为例,路由器在每个稀疏层为每个词元选择一个专家。这个设计使专家库可以扩大,而单个词元所需的专家矩阵乘法仍与一个前馈网络同量级。实际收益取决于专家负载、权重驻留方式和设备间的数据移动。这里的词元(token)指模型分词后的序列单元,路由读取的是该位置在当前层的隐藏状态,同一个词元出现在不同上下文时可以走不同的分支。Switch Transformers,§2
专家替换了 Transformer 的哪一部分
常见的稀疏 Transformer 保留注意力子层,将指定层的前馈网络(FFN)替换为多个具有独立权重的 FFN。设有 E 个专家,x ∈ ℝᵈ 是当前词元送入分支的向量。用列向量记法,路由矩阵 Wᵣ ∈ ℝᴱˣᵈ 产生分数 z,Mᵢ(x) 表示第 i 个专家的输出。下面四行给出 Switch 的计算。
z = Wᵣx
pᵢ = exp(zᵢ) / ∑ⱼ exp(zⱼ)
i* = argmaxᵢ pᵢ
MoE(x) = p[i*] · M[i*](x)    (路由获准时)
Switch 先在全部专家上计算 softmax,再保留最大概率作为选中专家的输出权重。举例说,三个专家的概率为 (0.60, 0.25, 0.15) 时,入选的是专家 1,分支返回 0.60 × M₁(x)。Top-k 路由的输出通常写成入选专家的加权和,权重如何归一化取决于模型。Mixtral 选两个专家,对选中分数做 softmax。用同一组概率演示,这两个分支的合并权重分别约为 0.706 和 0.294。Switch Transformers,式 (1)–(2) · Mixtral of Experts,§2
路由决策随层和词元而变。注意力、归一化等公共部分继续执行,有些架构还包含每次都执行的共享专家。阅读模型报告时,应先查清哪些层用了稀疏 FFN、每层总专家数与入选数、是否另有共享分支,再理解其「激活参数」口径。
总参数、激活参数与每词元运算量
取一个教学算例,隐藏维度 d = 4096,专家中间维度 m = 16384,专家数 E = 8。普通两矩阵前馈网络有一个 d → m 投影和一个 m → d 投影。忽略偏置,每个专家有 P = 2dm = 134,217,728 个权重。若改用 SwiGLU,同一中间维度下有两路升维投影和一路降维投影,专家权重数约为 3dm。因此,比较两款 MoE 时还要核实专家结构和中间维度。GLU Variants Improve Transformer,§2
设这个示例层还有 S 个每次都会用到的共享权重。若各专家同宽,且每个词元的 k 次指派均获准,总参数与激活参数分别由下式给出。
P_total  = S + dE + EP
P_active = S + dE + kP
加上该层的四个标准多头注意力投影矩阵(Q、K、V、O,各为 4096 × 4096),得到 S = 67,108,864。取相同尺寸的普通前馈层作为稠密基线,此时 dE = 32,768 个路由权重只出现在 MoE 的账中。表内均为单层数据,数字以「百万」为单位。
| 单层结构 | 总参数数(百万) | 每词元激活参数数(百万) | 每词元专家或 FFN 线性层 FLOPs(百万) |
|---|---|---|---|
| 标准注意力 + 一个稠密 FFN | 201.33 | 201.33 | 268.44 |
| 标准注意力 + 八专家、top-1 | 1,140.88 | 201.36 | 268.44 |
| 标准注意力 + 八专家、top-2 | 1,140.88 | 335.58 | 536.87 |
表中的最后一列把一次乘加计为 2 FLOPs,所以专家线性层的前向计算约为 2kP。它只统计专家矩阵乘法。整层还要算注意力的投影、按序列长度增长的注意力分数和值聚合、路由、非线性等运算。对上述稠密基线而言,top-1 保持了相同的 FFN 矩阵乘法规模,八倍的增长发生在专家权重库上。使用 BF16 时,这个专家库占 2 GiB,每个专家占 256 MiB,均为纯权重计算,部署时另需计算共享权重、KV 缓存、运行缓冲区和其他开销。
公开模型报告中也能看到这两种口径。Mixtral 8×7B 每层有八个 SwiGLU 专家,每词元选两个。论文给出的全模型数据约为 470 亿总参数和 130 亿每词元激活参数。部署全量 BF16 权重,按公开权重索引约需 87 GiB 存储。分到多少张卡、每张卡为 KV 缓存留多少空间,则属于部署配置。Mixtral 论文,§2.1 · 官方权重索引
批处理还改变了权重的复用范围。假设每个词元独立且均匀地从八个专家里选两个,那么某个专家在 B 个词元中始终未被选中的概率是 (1 − 2/8)ᴮ,整个批次访问的不同专家数的期望是 8 × [1 − (1 − 2/8)ᴮ]。当 B = 8 时,这个期望约为 7.20。这是一道占用率算例,真实路由可能随内容相关、偏斜或被容量限制。它说明每词元只用两个专家与每批可能调用几乎全部专家可以同时成立。若权重需在显存和主存之间换入,批内覆盖和相邻批次复用还决定了多少传输进入推理路径。
路由偏斜与负载均衡损失
一个路由组有 T 个词元时,Switch 用两个量计算均衡辅助损失。fᵢ 是容量裁剪前 argmax 选中专家 i 的词元比例,Pᵢ 是所有词元对专家 i 给出的完整 softmax 概率的均值。
fᵢ = (1/T) ∑ₜ 1[argmaxⱼ pⱼ(xₜ) = i]
Pᵢ = (1/T) ∑ₜ pᵢ(xₜ)
L_balance = α · E · ∑ᵢ (fᵢ · Pᵢ)
离散的 fᵢ 反映路由器想把负载发到哪里,可微的 Pᵢ 为辅助项提供梯度。Switch 论文实验设置 α = 0.01,当两个分布都均匀时,损失等于 α。但辅助项接近这个值时也可能发生严重拥挤。例如四个专家面对所有词元都得到 (0.251, 0.250, 0.250, 0.249),第一个专家会拿到全部硬选择,辅助项却只有 1.004α。实际诊断应一起看裁剪前的指派直方图、裁剪后的处理量与溢出率,单个辅助损失很难定位是哪一层、哪一类输入过载。Switch Transformers,§2.2 式 (4)–(6),附录图 15
负载也可以从训练信号理解。某些专家更常被选中时,它们会在更多样本上接受该专家分支的梯度,少用的专家则在较少样本上更新。这个反馈是否加剧拥挤要用训练日志判断。记录各层最大负载与平均负载的比值、各专家收取的样本数以及欠载层,有助于把异常定位到具体模块。若怀疑少数语言或罕见词元受影响,可以按语言、任务、词频和序列位置分组,联看路由与分组验证损失。
容量上限、填充与溢出
Switch 的静态形状实现按路由组给每个专家预留容量。对 top-1,容量的基准为 C ≈ cT/E,其中 c 是容量因子。T 要用实际一起路由的词元数,避免把全局训练批次误当成一组。取整、最小容量和分组法随实现而变。GShard 的组内 top-2 实现使用约 2T/E 的专家额度,第二候选还受到容量和采样规则约束,单个词元实际完成的专家调用数可能低于二。Switch Transformers,式 (3) 与附录图 16 · GShard,§2.2 与算法 1
还用八个专家举例。若一个路由组有 4,096 个词元,c = 1.25,平均负载为 512,容量为 640。若某一个专家被指派 1,200 个词元、其他七个都未超额,则有 560 个词元溢出,占组内词元的 13.67%。八个专家合计预留 5,120 个槽位,但空闲专家的槽位无法被拥挤的专家自动借用。
展开演示动图 · 路由负载与容量
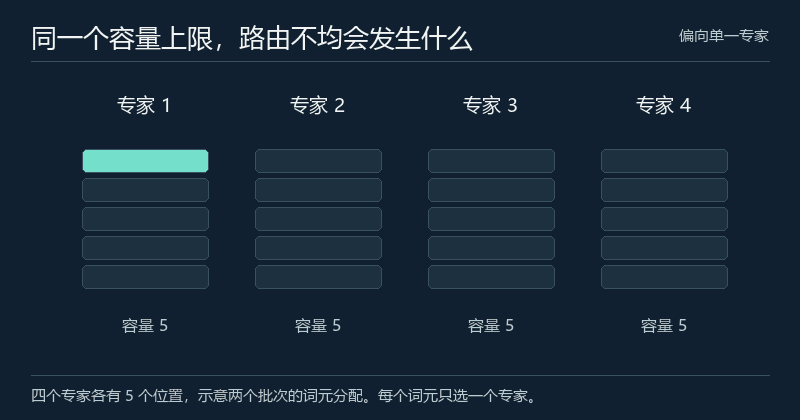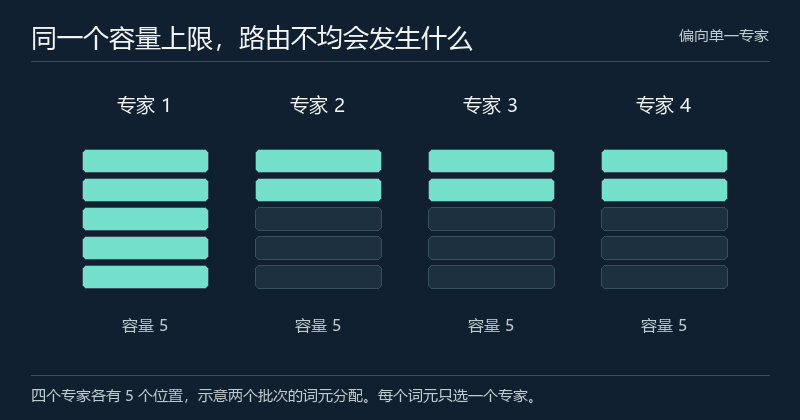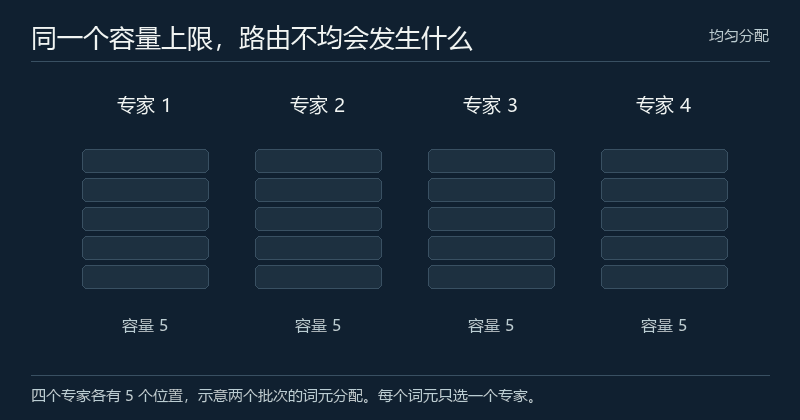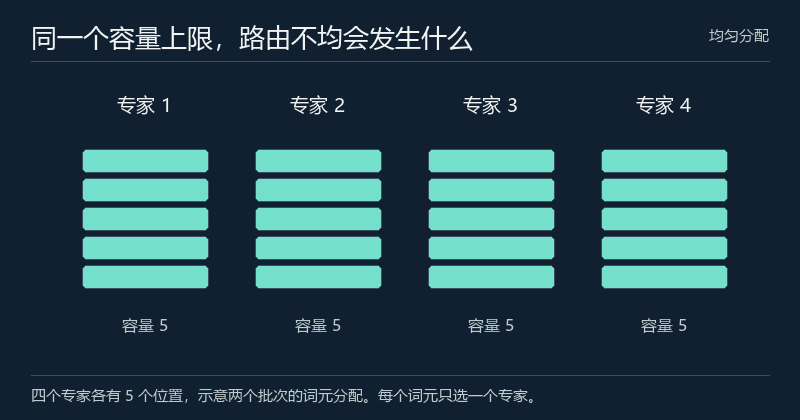
原始 Switch 在溢出时将该词元的专家分支输出置零,残差连接继续传递它的表示,后续层和主任务仍能处理该词元。提高容量因子可给热门专家留出余量,也会扩大固定的计算或内存缓冲,空槽可能产生填充开销。MegaBlocks 将动态分派映射到块稀疏计算,在其 dropless 方案中保留全部专家指派,仍需要按内核块大小对齐。即使采用 dropless 实现,热点专家也可能在同步时拖慢一组设备。Switch Transformers,§2.2 · MegaBlocks,§4–5
对固定容量实现,实验可把同一条请求分别与不同请求混批,检查它的专家接受率和输出是否变化。最好同时报告「被拒绝的指派数 ÷ 尝试指派数」和「完全没有专家接纳的词元数 ÷ 词元数」。在 top-1 中这两项可以一致,top-k 中一次拒绝后仍可能有别的分支继续执行。
专家并行的通信和推理开销
典型的专家并行会先按专家索引重排词元向量,再把向量发往持有该专家权重的设备。专家矩阵乘法完成后,输出沿反向路径返回,恢复原始词元顺序并按路由权重合并。跨设备分发及回收经常使用 all-to-all。GShard 还利用自动分片把这类数据交换纳入编译器的分布式执行计划。GShard,§3
若 T 个词元各完成 k 次指派,q 为其中落在远端专家的比例,隐藏向量有 d 个元素、每个元素 b 字节,则按分发和回收各传一次向量估算,整个专家并行组的一轮有效载荷约为 2 × q × T × k × d × b 字节。沿用 4,096 个词元、4,096 维 BF16、top-1 的例子,全部走远端时,分发约 32 MiB,往返约 64 MiB。这里统计整个组的有效载荷。实际链路字节量还取决于设备拓扑、填充、协议,以及是否合并了同一目的地的传输。
权重分片可以降低单设备驻留量。延迟进一步取决于跨节点带宽、启动开销、各专家矩阵的实际形状和计算与通信的重叠程度。在线解码的某个步骤如果只有少数词元分散在很多专家上,权重读取较难摊薄,分组与通信也可能占较大比例。长提示词的预填充(prefill)有更多词元可批量执行,但既要检查专家负载,也要把注意力和 KV 缓存纳入分析。短请求延迟与高并发吞吐应分别测量。
训练稳定性与专家特化
Switch 的选择性精度策略在本地以 FP32 计算路由概率,然后把参与后续执行的张量转回 BF16,以便保留低精度通信的优势。ST-MoE 另外引入 router z-loss。它对每个词元的路由 logits z 计算 log-sum-exp,对所得结果平方并取平均,再与主任务损失和负载均衡损失加权相加。
L_z = (1/T) ∑ₜ [log ∑ᵢ exp(zₜ,ᵢ)]²
L_train = L_task + L_balance + λ_z · L_z
所有专家 logits 同时增加一个常数时,softmax 概率保持原样,log-sum-exp 会随之改变。这个性质解释了 z-loss 约束的量。FP32 提高路由运算精度,z-loss 约束路由分数的数值尺度,均衡项则直接使用负载分配的统计。训练曲线出现尖峰时,可同步记录各层 router logits 的分位数、辅助项、溢出比例和主任务损失,再定位哪一类变化先出现。论文给出的损失权重是其特定训练设置的一部分。Switch Transformers,§2.4 · ST-MoE,式 (5)–(6)
这里的「专家」是可学习的网络模块。观察到某个专家经常接收代码或特定语言的词元,只能得到分配相关性,因为词频、分词粒度、标点和序列位置也会影响路由。可用平行译文和同义改写做配对比较,在控制文本长度、词元频率和层编号后,比较路由与任务结果。进一步做专家屏蔽或替换时,应比较随机屏蔽的基线,并记录重新路由导致的容量变化,避免把连锁过载归因于被替换专家的知识。
下游微调也要单独检验。ST-MoE 在论文所测的条件下发现,只更新专家部分的效果弱于更新非 MoE 参数,且稀疏、稠密模型对批大小和学习率的敏感性不同。若要把结论推广到其他模型,可在相近的数据量和可训练参数预算下,分别试验更新公共层、专家、路由器及其组合,再联合记录任务得分和各专家看到的训练样本数。已有任务若退化,还可按路由变化的幅度切片检查。ST-MoE,§4.2–4.3
怎样设计可复现的对照实验
模型对照先确定预算口径。若问「在相近的每词元训练计算量下谁表现更好」,应固定训练数据和训练词元量,报告估算 FLOPs 和验证结果。若问「达到同一质量要花多少资源」,则比较达到目标所需的训练词元、墙钟时间、设备时和能耗。对专家数、容量因子或辅助项做消融时,给出随机种子和重复次数,并同时记录任务损失、最大专家负载、溢出比例和通信占比。这样能追溯收益来自扩充参数容量、改变路由策略,还是加速了执行。
| 阶段 | 需要固定和公布的设置 | 建议报告的指标 |
|---|---|---|
| 预填充 | 输入长度分布、并发、批调度、精度、设备与互联拓扑 | 首词元时间(TTFT)的 P50/P95/P99、提示词元吞吐、显存峰值 |
| 逐词元解码 | 输出长度、采样策略、上下文长度分布、并发、专家放置及量化 | 相邻输出词元间隔(ITL)的 P50/P95/P99、输出词元吞吐、显存峰值 |
| 路由与内核 | 路由组大小、top-k、容量和溢出规则、专家并行度 | 裁剪前后负载、远端指派比例、通信与专家计算耗时 |
先用同一套请求与解码配置跑基线,再改变单项设置。线上压测应说明 TTFT 是否计入排队和网络,吞吐按全系统还是单设备统计,同时保留预热和稳态的测量条件。对于具体选型,模型卡上的总参数与激活参数适合先用于权重和算术预算,部署数据则要在自己的提示长度、批大小和互联条件下测量。
参考资料
- Fedus、Zoph 与 Shazeer,Switch Transformers: Scaling to Trillion Parameter Models with Simple and Efficient Sparsity,JMLR 2022
- Lepikhin 等,GShard: Scaling Giant Models with Conditional Computation and Automatic Sharding,2020
- Shazeer,GLU Variants Improve Transformer,2020
- Zoph 等,ST-MoE: Designing Stable and Transferable Sparse Expert Models,2022
- Gale 等,MegaBlocks: Efficient Sparse Training with Mixture-of-Experts,MLSys 2023
- Jiang 等,Mixtral of Experts,2024