


要点:LLM 的预测可以在 A/B 测试中代替人类结果,但这种有效性来自假设,而不是实验设计本身。在包含数千次 A/B 测试的 Upworthy 数据集上,用人类数据校准 LLM 输出后,可以恢复处理效应,但只有特定的一组方法有效。对新的处理方案,无法验证这些条件是否仍然成立;新方案越偏离过去的实验,这些假设就越不可信。恰恰在这种替代最有价值的场景,其依据也最薄弱。
这一设想很直接:让模型参加实验,而不是让用户参加;几个小时就得到结果,而无需等待数周,也不必分配用户流量。但多数用 LLM 替代人类进行 A/B 测试的提议,都跳过了让实验成立的统计问题:在什么条件下,实验才能识别我们关心的处理效应?
随机实验被视为黄金标准,因为它们通过设计本身实现对处理效应的因果识别。用 LLM 生成的预测代替真实用户响应,就失去了这一保证。此时,识别只能依赖假设。我们撰写了一篇论文,利用生物统计学中的替代终点理论,将这些假设形式化。思路很简单:如果替代结果捕捉了处理方案中所有对实际结果有影响的因素,那么它就是有效的代理,基于它做实验就能得到正确结果。临床试验常把实验室生物标志物用作快速、低成本的临床结果替代指标。在数字环境的 A/B 测试中,LLM 预测也成为用户响应的热门替代候选:人们期待它能绕过 A/B 测试所需的精力、时间和机会成本。
未经校准的 LLM 预测存在偏差,而不只是噪声
我们使用 Upworthy Research Archive 实证评估了基于 LLM 的 A/B 测试。这是目前最大的公开 A/B 测试数据集,包含数千次新闻标题变体实验的点击率。我们提示 gpt-4o-mini,分别为处理组和对照组的标题预测典型用户的点击率。在标准实验分析中使用这些原始预测,只恢复了观察到的人类处理效应的39%。如果把这些预测当作真实用户数据,就会得出处理方案的效果不足实际效果一半的结论。
这不只是随机噪声。偏差是系统性的,而且有明确方向:LLM 结果将处理效应向零压缩,让处理方案显得比实际更弱。A/B 测试用于了解用户重视什么,以便做出更好的产品决策。如果在许多功能和产品领域使用基于 LLM 的实验,这种衰减会让组织低估其为用户带来的价值,并可能做出错误的发布决策。
让 LLM 输出成为有效替代指标的两个条件
论文形式化了两个条件;当它们成立时,可以用 LLM 预测识别人类平均处理效应。
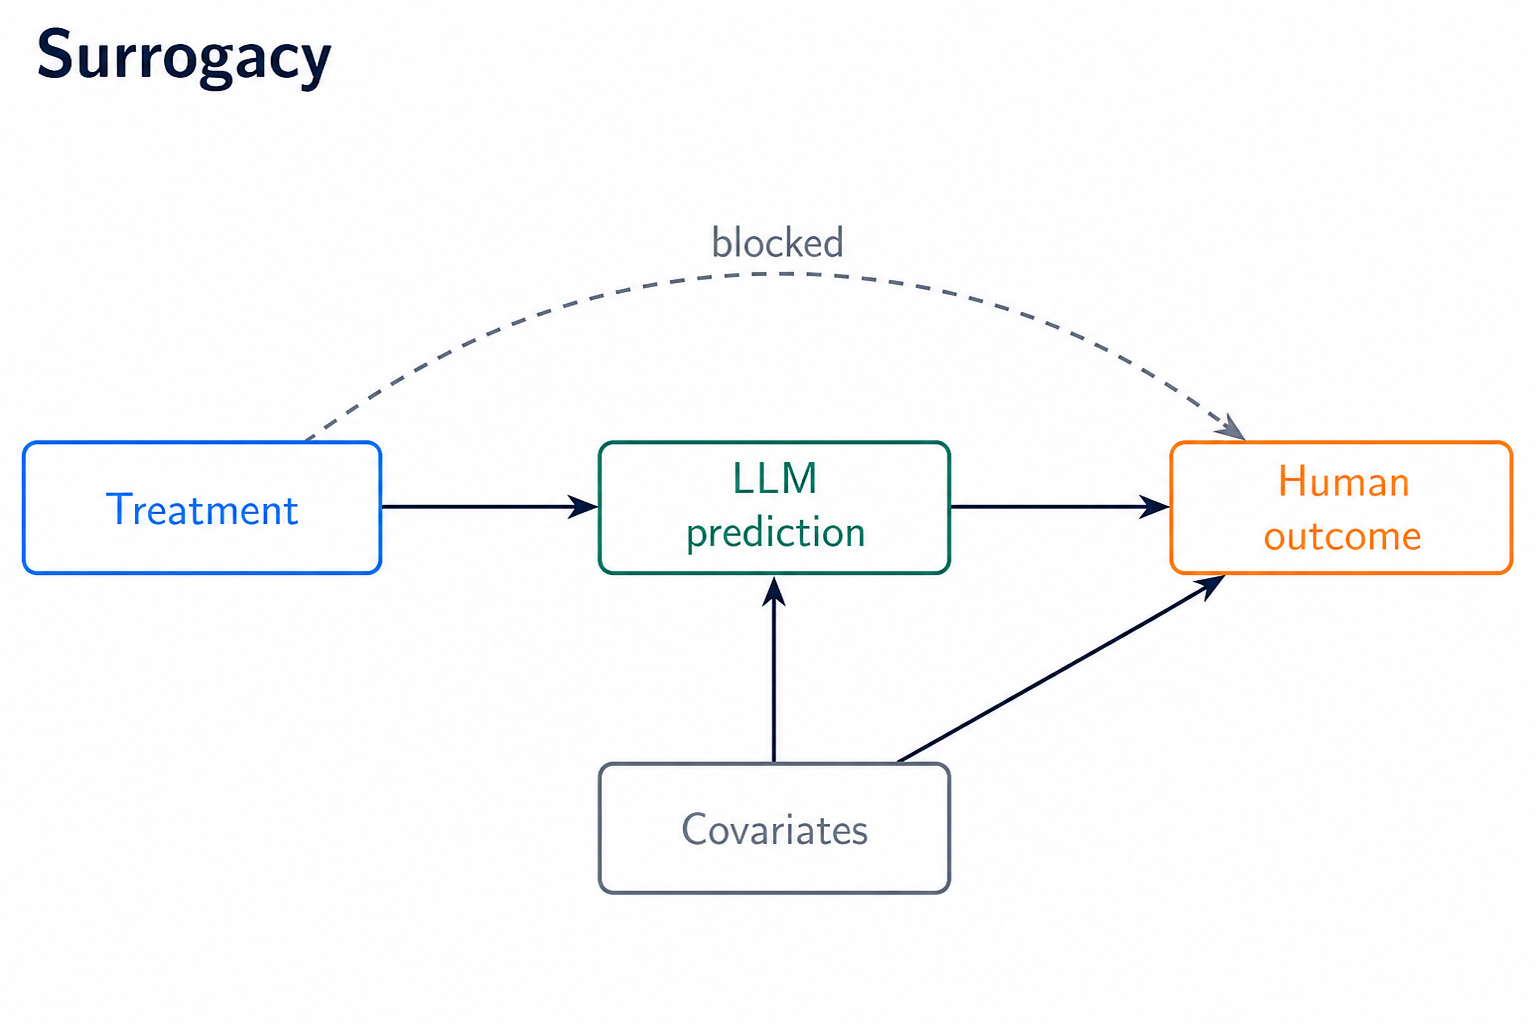
替代性(Surrogacy)。这一假设要求,LLM 输出完全中介处理方案对人类结果的影响。在考虑 LLM 预测,以及捕捉不受处理影响的基线特征的协变量之后,用户被分到处理组还是对照组,不再提供任何有关用户行为的额外信息。通俗地说,LLM 捕捉了处理方案中所有影响人类响应的因素。基于 LLM 的 A/B 测试往往隐含采用这一假设,却很少明确陈述,也很少进行验证。
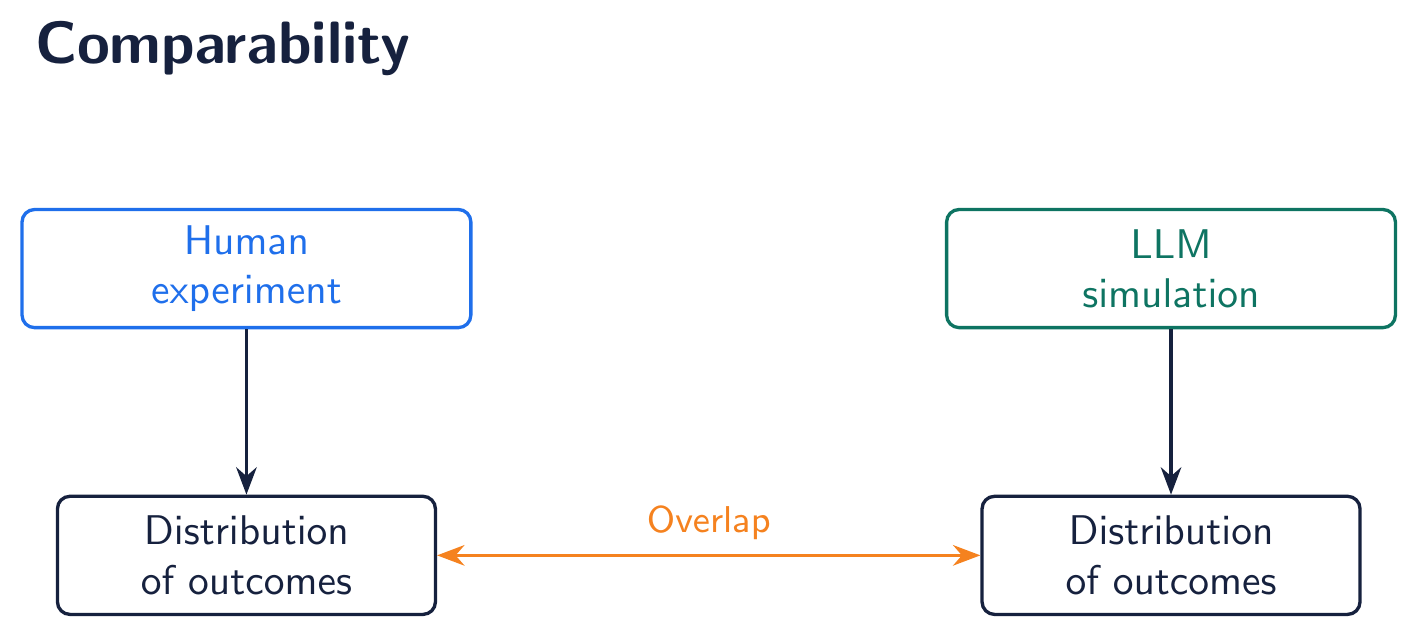
可比性(Comparability)。这一假设要求,LLM 预测与人类结果之间的关系,也就是校准函数,在新实验中与用于估计该函数的历史数据中保持一致。如果处理方案变化时,LLM 预测到人类行为的映射也发生变化,校准就会失效。这一假设可以推广为:处理前特征与 LLM 预测的完整分布在不同实验间保持稳定。条件满足时,除了平均处理效应,还能识别效应分布的其他量。
两个条件都成立时,可以用真实用户的 A/B 测试数据校准 LLM 输出,恢复人类处理效应。任一条件失效,估计就会有偏。这种偏差并不是数据不足造成的,而是因为这一程序识别了别的对象。即使生成无限多的 LLM 预测,恢复的也仍是处理方案对 LLM 的影响,而不是对用户的影响。与用户实验中的随机分配不同,这两个假设都没有得到实验设计本身的保证。
校准可以恢复效应,但必须选择合适的方法
不同校准方法的效果并不相同。我们在 Upworthy 数据上测试了两种方法。普通最小二乘法(OLS)的线性校准未通过证伪检验:这项统计检验比较在训练时留出的实验中,基于 LLM 响应测得的校准效应是否与人类效应不同。如果“没有差异”的零假设被拒绝,我们就认为校准估计器在历史数据上不可靠,也不应信任它在新数据上的结果。在这个案例中,OLS 拟合的线性校准过于僵硬,无法捕捉 LLM 预测与人类行为之间的映射;其结果与人类基准相距3.8个标准误。
机器学习模型——随机森林和梯度提升树——表现更好。这些方法的校准估计落在人类效应的抽样误差范围内,差异在统计上不显著。它们的灵活性足以学习 LLM 预测与人类结果之间的非线性关系,因此可以对 LLM 预测进行适当校准。
另一个问题是,单次 LLM 预测会受到采样温度,也就是 token 生成随机性的影响而产生噪声。如果不加处理,LLM 内在的随机性会使效应估计趋向零,并增加方差。论文借鉴测量误差理论,表明只需对每个实验单元生成多个 LLM 输出,再取平均值作为新的预测,就能缓解这一问题。直观上,多次取平均会抵消预测中的噪声,使剩余部分更接近真实信号。
真正的限制在于未来的干预
替代性与可比性可以在历史数据上进行部分评估,但对于从未测试过的处理方案,永远无法证明它们成立。
这是一个核心约束。新的处理方案越偏离过去测试过的方案,就越缺乏依据,把 LLM 输出视为人类响应的有效替代。对真正新的干预,例如不同的 UI 范式、新的定价模式、与已发布功能完全不同的新功能,这些假设本质上无法检验。也就是说,LLM 对 A/B 测试最有价值的场景,恰恰最不可能满足其成立条件。因此,真正的产品创新仍然离不开人类实验。
在这个背景下,Upworthy 数据集几乎是检验 LLM 替代性的理想案例:结果是二元的,点击或不点击;处理是文本型且语言形式相似,即标题变体;LLM 又接受了大量与标题吸引力相关的文本训练。对于改变布局、算法或定价的处理方案,基于 LLM 的 A/B 测试所需条件更难得到支持。目前没有实证证据表明,这些条件普遍成立,例如在一家公司的全部创新项目中都成立,而大规模使用恰恰需要这样的保证。
校准需要的,正是你试图避免收集的数据
研究表明,基于 LLM 的 A/B 测试在理论上可以成立,但需要强假设、谨慎且依赖具体情境的方法,以及充分验证。Upworthy 数据集包含数千次同类型的历史实验;多数产品团队拥有的却是来自不同界面和产品领域的多种实验,日志记录方式甚至也不同。这个框架没有消除用户实验的必要性;它表明,只有当新实验与已完成实验相似时,才能依赖外推填补部分空白,从而减少所需的用户实验数量。预先投入资源收集真实用户响应不是可选项,而是让基于 LLM 的 A/B 测试值得信赖的基础。
LLM 自身的变化又增加了复杂性。任何校准函数都是针对特定时间点的特定模型拟合的。供应商会更新和替换模型,即使模型名称相同,今天学到的校准函数也可能在六个月后失效。理想情况下,新的校准函数应基于新的用户实验拟合,否则可能带有时间偏差。即使更好的模型、提示或微调逐渐让替代性和可比性更可信,仍然需要运行用户实验来校准 LLM 输出,或检查它们是否确实映射到用户结果。LLM 预测能力的进步,不能免除人类验证。
结语:用户实验的有效性来自设计,LLM 实验的有效性来自假设
替代指标框架研究的是:何时 LLM 预测可以成为人类行为的有效代理指标。与所有代理指标一样,只要代理与实际结果之间的关系改变,LLM 替代指标就会失效。这个框架将这种关系明确化,使其可检验,并揭示关系失效后的影响。但它无法保证,这种关系在你最关心的那次实验——测试新事物的实验——中仍然成立。
不过,LLM 预测可以改善人类实验。它们可以在占用实验名额之前筛掉较弱的想法,也可以作为用于降低方差的协变量。当历史数据充分、新方案与过去的方案相似时,它们能改善实验选择与效率。用它们替代真实用户结果则是另一回事:你把基于设计的识别换成了基于假设的识别。不要轻易放弃前者。









暂无评论内容