



本周的《Loki 简明指南》聚焦 Grafana Loki 历史上一个有趣的话题:摄取乱序日志。
长期关注这个项目的人或许还记得:Loki 曾经会拒绝所有比已接收日志行更早的日志。这样做确实简化了内部实现,却给许多实际使用场景造成了很大不便。
问题影响很大,因此几年前我们决定解决它。当时 Owen Diehl 写了这篇 有关这项工作的文章,详细介绍了方案背后的工程考量。如果想了解实现细节,值得一读。总体而言,工程总是充满取舍;我们努力在性能、运维成本和功能之间取得平衡,选择对 Loki 及其用户最合适的方案。
今天我想聊聊这些取舍,重点是它们如何影响 Loki 的使用,而不是当初为何这样选择。我会用动画帮助大家理解其机制,以及向 Loki 导入旧日志时应该有什么预期。准备好进入“日志顺序简明指南”吧!
乱序摄取如何工作
正如 本系列第一篇文章 所述,Loki 的设计目标是摄取快速、成本低,通常处理较新的数据,也就是时间戳距当前时间只有几秒到几分钟的数据。因此,乱序方案的主要目标,是让 Loki 在合理时间范围内接收并存储延迟到达的日志。
我们把“合理时间”定为一小时。严格来说,该范围由 max_chunk_age/2 决定;但你应该像 Grafana Labs 一样,把 max_chunk_age 设为两小时,后文会解释。Loki 的乱序日志摄取规则是:
对于某一日志流,只要收到的日志时间戳落在该流已收到的最新日志之前的一小时内,就会接收并存储。比该流最新日志早超过一小时的日志,会被拒绝,并报错:
Entry too far behind。
上面的描述中,有两个概念最容易引起误解:最新日志(most recent log)和针对某个日志流(for a stream)。
most recent log 指 Loki 已接收的日志中时间戳最新的一条。看起来很简单,但与 for a stream 放在一起时就容易混淆,因为 Loki 是按每个日志流分别确定最新日志的,不能默认所有流都对齐到同一时间。
这里再用几个制作不算精致的动画来说明。先看单个日志流:
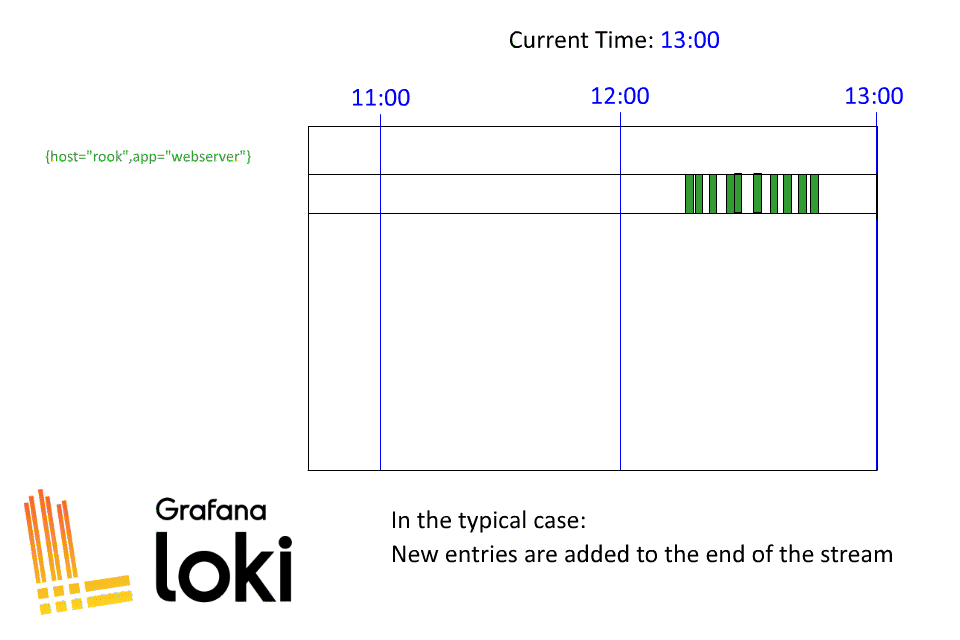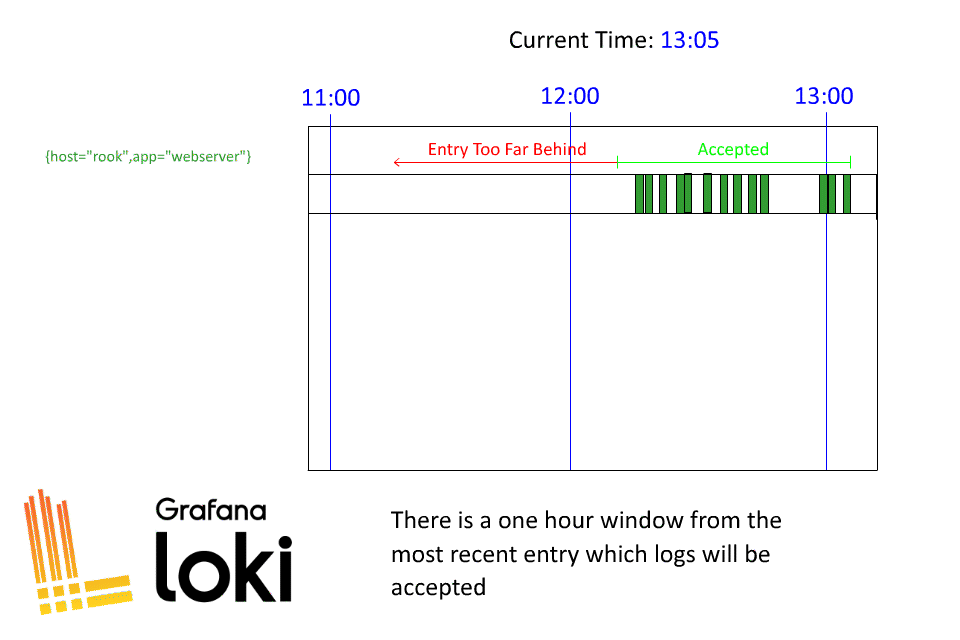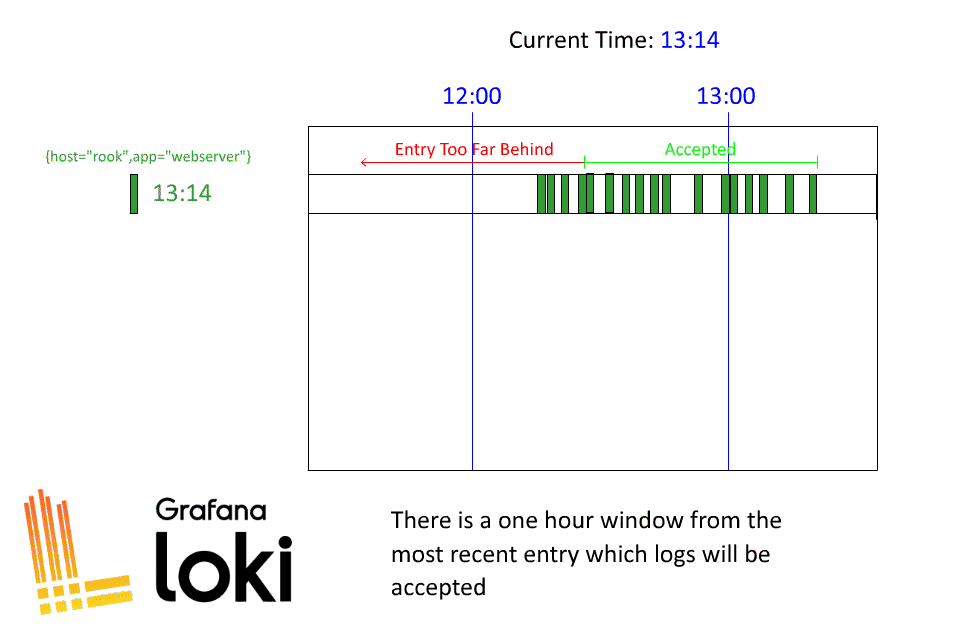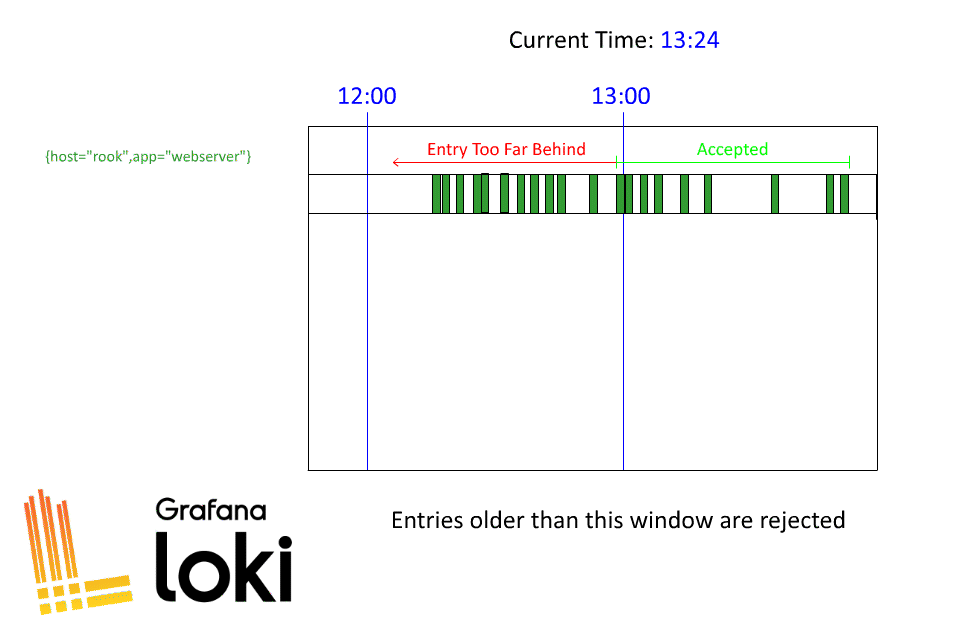
再把示例扩展到多个日志流:
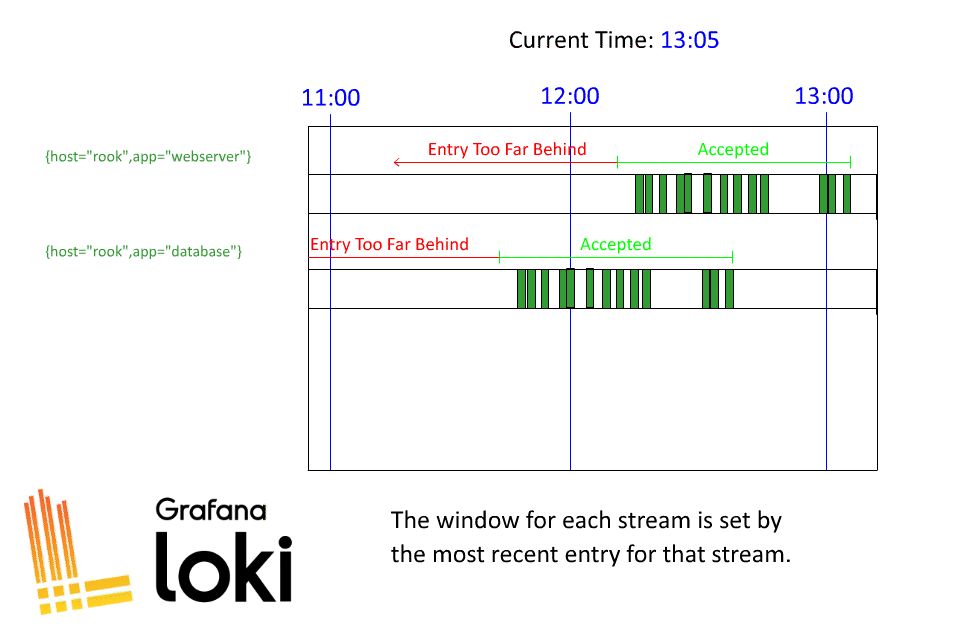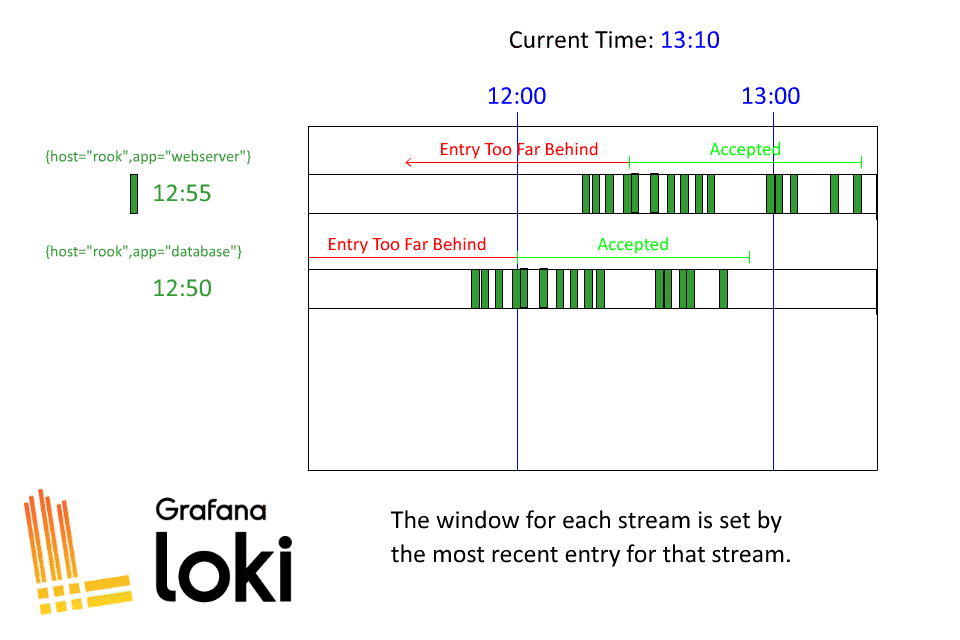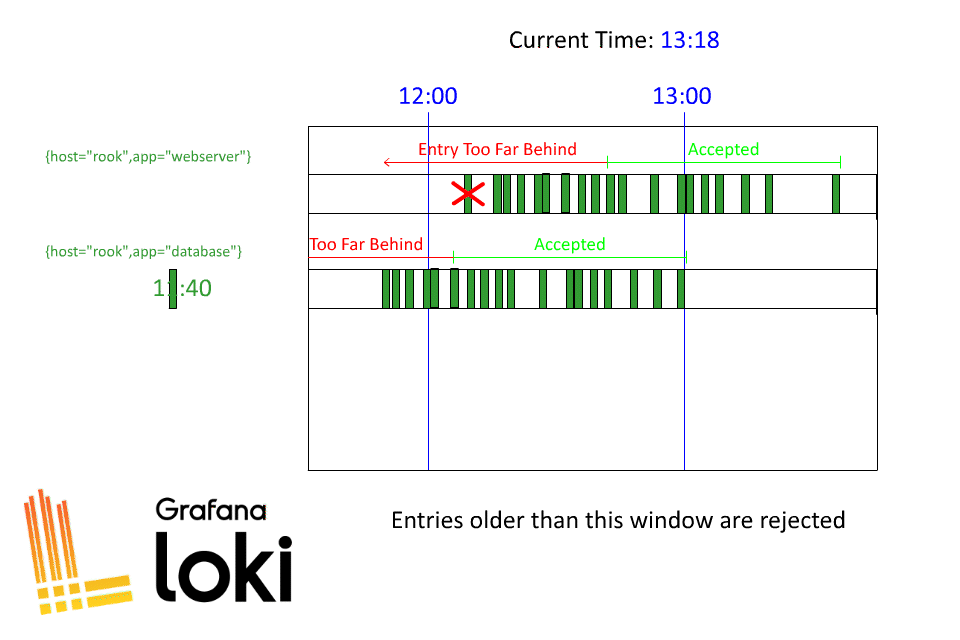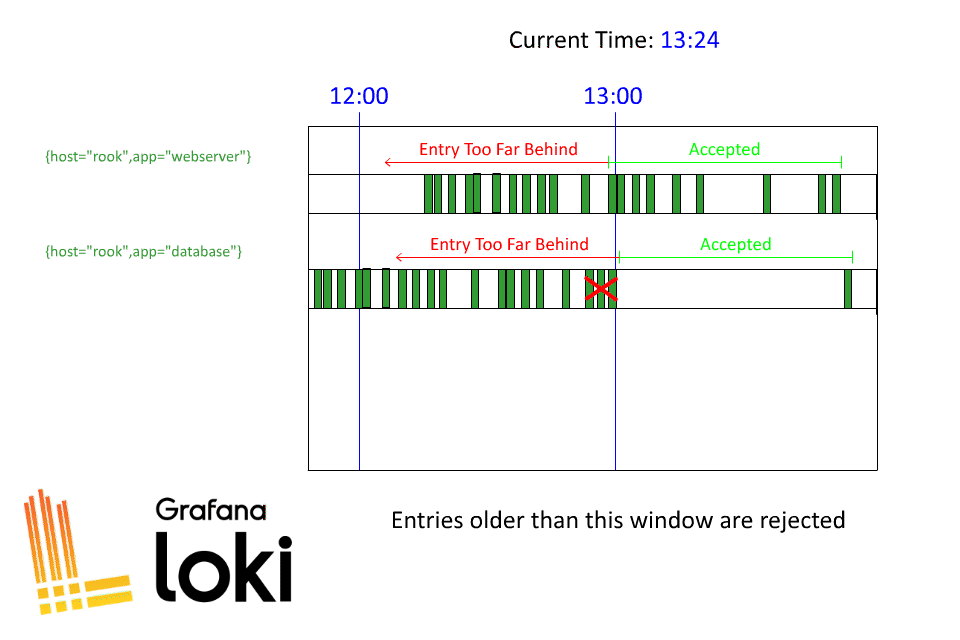
希望这些示例能帮助你理解 Loki 如何接收旧日志。
重要配置
有几个重要配置与 Loki 处理日志顺序的方式有关,接下来逐一看。
摄取较旧的数据
Loki 配置中的 limits_config 部分,有两个控制旧数据摄取的设置:
reject_old_samples: true
reject_old_samples_max_age: 1w
这些默认值很大程度上源于 Loki 过去支持 Amazon DynamoDB 作为索引类型。那时,Loki 会降低旧表的预置吞吐量来节省成本,因此也就无法继续接收旧时间范围的数据。
从几年前发布的 Loki 2.0 开始,我们已逐步摆脱这些外部索引类型。如果想发送一周以前,或者其他任意时间范围的日志,可以设置 reject_old_samples: false,也可以增大允许的时间窗口。
乱序窗口
开头提到,乱序数据的时间窗口为:
max_chunk_age / 2
max_chunk_age 位于 ingester 配置。
默认值是两小时。我强烈不建议通过增大这个值来扩大乱序窗口。Grafana Labs 并不这样运行 Loki,所以无法准确说明你可能遇到哪些问题。我的建议是设法使用标签区分日志流,让它们独立摄取。
如果仍决定增大该值,请务必同步增大 query_ingesters_within,使其与 max_chunk_age 匹配,确保这些数据可查询。
摄取旧数据时的查询注意事项
向 Loki 导入旧数据时有一个重要问题:如果数据的时间戳比当前时间早超过两小时,它不会立刻变得可查询。
原因是上一节的 query_ingesters_within。名称或许有点容易误解,本质上它表示“只有落在距当前时间这一窗口内的查询,才查询 ingester”。原文给出的默认值是三小时:距当前时间三小时内的数据查询会发给 ingester;窗口以外的查询不会。
Loki 这样设计,是因为我们知道 ingester 允许的 max_chunk_age 为两小时。不向 ingester 请求它们本来就不应保有的数据,可显著减轻负担。换句话说,查询昨天的日志时,我们不会问 ingester,因为它正常情况下不该保有昨天的日志。
问题在于:如果你今天发送昨天的日志,在刷写到存储之前——最多需要两小时——这些日志仍位于 ingester 中。在刷写完成前,查询结果中不会出现它们。
你可以把这个配置增大到48小时,从而在今天摄取昨天的日志时立刻查询它们。但我非常不建议这样做:48小时内的所有查询都会请求 ingester,使它们承担更多工作、增加运维费用。正常情况下 ingester 并没有两小时以前的数据,这种改法还会拖慢性能。
如果只是补录历史数据,我建议等两小时,让所有数据刷写完成。如果日常操作确实会摄取较旧日志,又不想等待,可以考虑调整 query_ingesters_within,但要认识到这会带来成本与性能方面的负面取舍。
结语
希望本文帮助你理解 Loki 的乱序日志与旧日志摄取方式。我们尽力在典型用例和其他用例之间取得恰当平衡,同时尽可能避免增加成本或牺牲性能。
想继续学习,可访问 Ed Welch 的 Grafana Labs 作者页,阅读 Loki 指南的其他篇章。
Grafana Cloud 可帮助你开始使用指标、日志、追踪和仪表盘等功能。Grafana Cloud 提供长期免费档及适合不同用途的方案。免费注册!









暂无评论内容