


连接通常是查询中开销最高的部分之一。表变大后,连接会显著影响运行时间和内存使用,尤其是执行引擎需要建立大型哈希表时。
如果连接键已经排序,Polars 现在可以采用成本更低的路径:流式排序合并连接。本文解释算法如何工作、如何使用、如何通过物理计划确认 Polars 选择了合并连接,以及什么时候值得使用。最后会展示原文基准测试中最高18倍的性能提升。
为什么排序合并连接重要
当昂贵的排序已经完成,或者数据到达时本来就有序、不需要排序时,排序合并连接尤其有吸引力。出租车行程日志、行情数据和传感器读数都是例子。
这时它具有三个实用特点:
-
不需要中间数据结构
-
额外内存压力较小
-
顺序访问模式适合流式执行
不过,如果数据未排序,哈希连接通常仍是更好的默认选择。可以把它理解为:有序数据解锁了成本更低的连接策略。
基本排序合并算法
算法核心是两个有序序列和一次线性扫描。
朴素算法
朴素方法要求连接键既有序又唯一。伪代码如下:
result = []
while not left.done and not right.done:
    if left < right:
        left.next()
    elif left > right:
        right.next()
    else:
        result.append(left + right)
        left.next()
        right.next()
return result用下面两个序列看看具体执行过程:Left = [1, 3, 4] 和 Right = [2, 3, 4]。
步骤1:
Left : [1]  3   4
Right: [2]  3   4
Output: []
1 < 2,所以 Left 前进。
步骤2:
Left :  1  [3]  4
Right: [2]  3   4
Output: []
3 > 2,所以 Right 前进。
步骤3:
Left :  1  [3]  4
Right:  2  [3]  4
Output: [(3, 3)]
现在两个键相同,因此输出一行连接结果,并同时推进两个序列。
步骤4:
Left :  1   3  [4]
Right:  2   3  [4]
Output: [(3, 3), (4, 4)]
键再次相同,继续输出并前进。
步骤5:
Left :  1   3   4   [done]
Right:  2   3   4   [done]
Output: [(3, 3), (4, 4)]
至少一个序列已结束,处理完成。
核心思路就是如此:每一侧只向前移动,不需要往回跳。两个指针配合推进。
问题:重复键
但真实数据中存在重复键。如果待连接序列是 Left: [2, 2] 和 Right: [2, 2],会发生什么?
当 Left = [2, 2]、Right = [2, 2] 时,朴素扫描一开始看起来没有问题:
第1帧:
Left : [2]  2
Right: [2]  2
Output: [(L[0], R[0])]
第2帧:
Left :  2  [2]
Right:  2  [2]
Output: [(L[0], R[0]), (L[1], R[1])]
接着,两个序列都用完了:
第3帧:
Left :  2   2   [done]
Right:  2   2   [done]
Output: [(L[0], R[0]), (L[1], R[1])]
还缺少 (L[0], R[1]) 和 (L[1], R[0]),但扫描无法回到匹配段的起点,也就不能输出匹配项的完整笛卡尔积。我们需要能够回退。
解决办法:mark
mark 保存 Right 中相同键开始的位置。当 Left 移到另一个具有相同键的行时,就回退 Right,只推进 Left,再次匹配,而不是同时推进 Left 和 Right。
内连接的伪代码如下:
result = []

while True:
    if left.done:
        break

    if right.done and not mark:
        break

    if not mark:
        while left < right:
            left.next()
            if left.done: break
        while left > right:
            right.next()
            if right.done: break
        mark = right

    if not right.done and left == right:
        result.append(left + right)
        right.next()
    else:
        right = mark
        left.next()
        mark = None

return result
步骤1:首次发现匹配时保存 mark。
Left : [2]  2
Right: [2]  2
Mark :  ^
Output: []
步骤2与3:为 L0 遍历完整的匹配段。
Left : [2]  2
Right:  2  [2]
Mark :  ^
Output: [(L[0], R[0]), (L[0], R[1])]
步骤4:将 Right 回退到 mark,然后推进 Left。
Left :  2  [2]
Right: [2]  2
Mark :  ^
Output: [(L[0], R[0]), (L[0], R[1])]
步骤5与6:再次遍历右侧同一匹配段,这次对应 L1。
Left :  2  [2]
Right:  2  [2]
Mark :  ^
Output: [(L[0], R[0]), (L[0], R[1]), (L[1], R[0]), (L[1], R[1])]
步骤7:回退 Right,但随后推进 Left 时,左侧元素已用完。处理结束,输出 (L[0], R[0]), (L[0], R[1]), (L[1], R[0]), (L[1], R[1])。
Left :  2   2   [done]
Right: [2]  2
Mark :  ^
Output: [(L[0], R[0]), (L[0], R[1]), (L[1], R[0]), (L[1], R[1])]
这就是 mark 的用途:把右侧连续的等键段,变成可以供左侧每个匹配行复用的范围。
重要的是,不必记住此前所有行,只需记住当前等键段的起点。只要左侧键不变,这一个书签就足够。
重复键是复杂因素之一,但不是唯一因素。空值语义、外连接行为、复合键,以及很大的重复键段,都会带来额外边界情况和状态记录。核心扫描不变,但完整的生产算法还必须处理这些情况。
Polars 何时可以使用它
查询规划器根据优化后的查询计划,决定使用哪些算法以最高效率执行。有关 Polars 查询执行机制,可继续阅读 Polars 查询执行机制概览。当规划器知道两侧连接键都已排序时,Polars 可对受支持的等值连接和范围连接采用排序合并路径。
这要求满足三个条件:
-
查询运行在流式引擎上
-
规划器知道两个连接列均按连接键有序
-
连接是在这些有序键上进行的等值连接或范围连接
不满足条件时,Polars 仍能执行连接,只是会选择其他策略。
实践中,“已知有序”是指优化器知道有序,而不仅仅是你知道。如果计划没有有序性信息,Polars 必须采取稳妥做法,回退到其他连接策略。
使用流式排序合并连接
最简单的方法是在惰性计划中保留或声明有序性,并在流式引擎上执行查询:
import polars as pl

# Set the streaming engine as default
pl.Config.set_engine_affinity("streaming")

# These input files have sorted "key" columns
left = pl.scan_parquet("left.parquet").set_sorted("key")
right = pl.scan_parquet("right.parquet").set_sorted("key")

result = (
    left
    .join(
        right,
        on="key",
        how="inner",
    )
    .collect()
)
这样,优化器就获得了选择排序合并连接所需的信息。
注意:set_sorted 不会排序,它只是向优化器作出“相信我,数据已排序”的声明。如果列实际上无序,Polars 不会替你排序,也不会在此处报错。相当于告诉引擎可以依赖一个不存在的顺序,可能导致错误结果。
如果不能完全确定输入已排序,应明确调用 .sort()。set_sorted 适用于数据源或上游步骤已保证顺序,而你希望 Polars 保留这一信息的场景。
如何确认 Polars 采用了该算法
构造惰性查询后,在收集结果前检查物理计划:
query = left.join(right, on="key", how="inner")
query.show_graph(plan_stage="physical")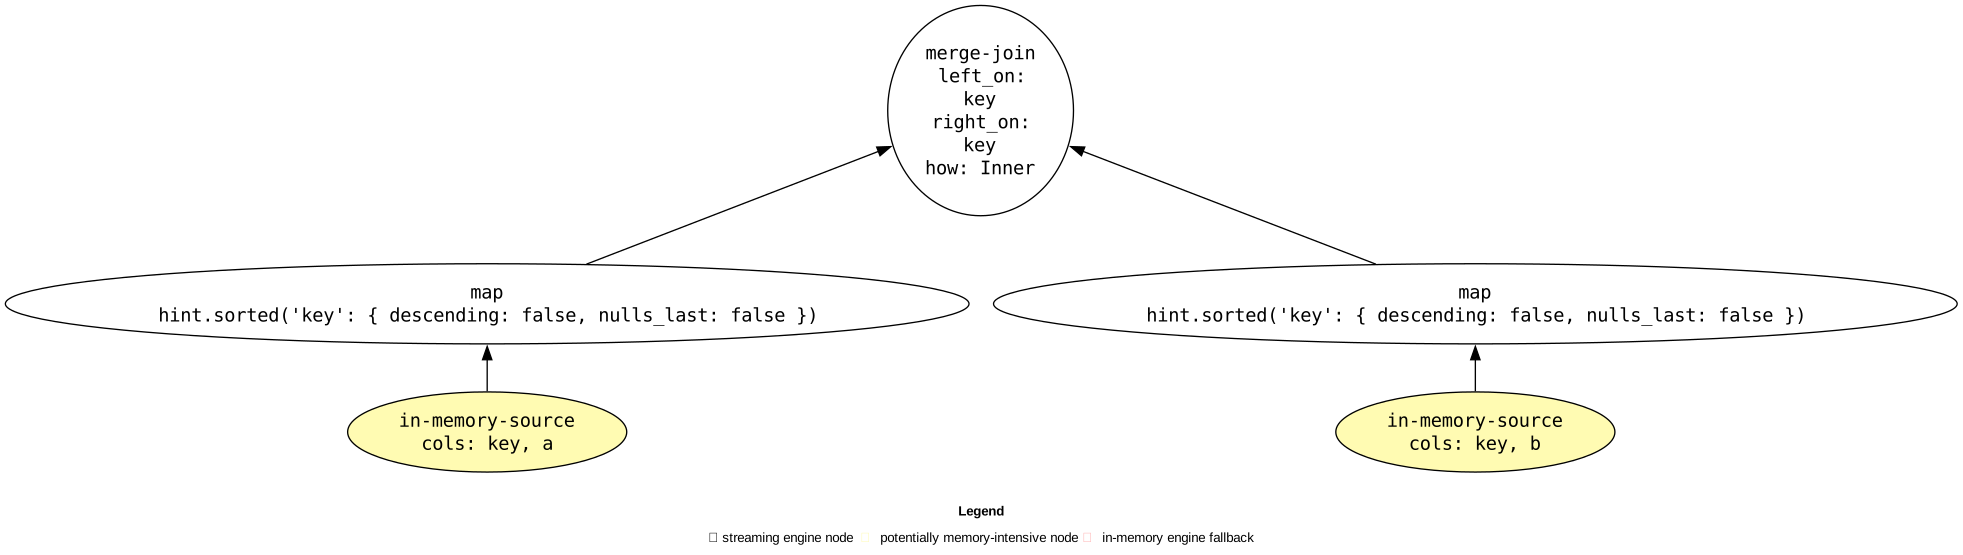
merge-join。每次依赖有序性时都值得检查。这样就能将“我认为数据有序”与“优化器确实使用了这一事实”联系起来。如果想本地复现,在两端确实有序的查询上运行以上代码,再比较移除 set_sorted 或显式排序前后的物理计划。
何时使用
如果只是为了让一次连接满足排序合并条件,而需要给两端额外排序,整体上哈希连接通常仍更便宜。以下情况会让排序合并路径更值得使用:
-
输入已排序
-
后续步骤本来就需要有序数据
微基准测试
原作者在14核 MacBook M4 Pro 上,用 NumPy 合成数据进行基准测试:每侧 100_000_000 行,唯一整数键,每侧一个负载列。
| 查询形式 | 执行路径 | 时间 |
|---|---|---|
| 没有有序性元数据 | 流式哈希连接 | 1.333s |
两侧都使用 .set_sorted("key") |
流式合并连接 | 0.074s |
| 加速比 | 18.0x |
这个基准使用唯一键,接近排序合并连接的最佳情况。含有大量重复键和空值的工作负载,差距会小一些,因为合并连接需要更多回退操作。
基准代码见下方附录,可自行复现。
真实场景基准:纽约出租车
前面的合成基准使用唯一键、完全预排序的数据,是最佳情况。下面看看同样的比较在真实数据上的表现。
原文使用 纽约市黄色出租车行程记录,即2023年纽约市3800万次出租车行程的公开数据集。为了形成大小相近的两张表,按上车区域ID的奇偶把行程拆成两组,表示两个分别按时间有序到达的事件流。基准开始前,两张表都按上车时间戳预排序并写入 Parquet,模拟下游操作本来就要求时间有序的管线。
连接查找来自两组区域、在同一秒开始的所有行程对。
| 查询形式 | 执行路径 | 时间 |
|---|---|---|
| 没有有序性元数据 | 流式哈希连接 | 0.347s |
两侧都使用 .set_sorted("pickup_ts") |
流式合并连接 | 0.099s |
| 加速比 | 3.5x |
真实数据的加速比小于合成数据,分别为3.5倍和18.0倍,因为实际平均每秒大约有两次上车,合并连接需要在重复键组中进行更多回退,这正是上文提到的取舍。
这个基准的代码也在附录中。
结语
排序合并连接的核心是:两侧都有序时,连接可以转化成一次线性扫描,而不是建立和探测大型哈希表。重复键会增加复杂性;mark 通过把右侧匹配段变成可复用范围来处理它。
在 Polars 中,只有流式引擎知道连接键已排序,这个方案才成为实际可用路径。当计划含有有序性信息,就可以在物理图中确认结果,其中会直接显示 merge-join。
有序性不只是业务领域或数据的逻辑属性;引擎和优化器还能利用它选择不同算法。当键已排序,或者查询中其他地方需要顺序时,Polars 可将这一点转化为更低成本的连接。
附录A:微基准代码
下面的脚本创建两份适合排序合并连接的最佳情况数据,并分别测量哈希连接与合并连接:
import timeit

import numpy as np
import polars as pl

n_rows = 100_000_000

pl.Config.set_engine_affinity("streaming")

key = np.arange(n_rows, dtype=np.uint32)
left_payload = (key % 97).astype(np.uint16)
right_payload = (key % 89).astype(np.uint16)

left = pl.LazyFrame(
    {
        "key": key,
        "left_payload": left_payload,
    }
)
right = pl.LazyFrame(
    {
        "key": key,
        "right_payload": right_payload,
    }
)

hash_query = left.join(right, on="key", how="inner")
merge_query = left.set_sorted("key").join(
    right.set_sorted("key"),
    on="key",
    how="inner",
)


hash_time = timeit.timeit(lambda: hash_query.collect(), number=1)
merge_time = timeit.timeit(lambda: merge_query.collect(), number=1)
speedup = hash_time / merge_time

print(f"hash join:  {hash_time:.3f}s")
print(f"merge join: {merge_time:.3f}s")
print(f"speedup:           {speedup:.2f}x")
按下面方式运行:
uv run --isolated --with polars,numpy python benchmark.py在更大的机器上,如果希望基准运行更久,可以增大 n_rows。请确保有足够内存存放两侧输入列和连接输出。
附录B:纽约出租车基准代码
下载 2023年黄色出租车 Parquet 文件,用下面的命令放到专门创建的 taxi 目录中:
mkdir -p taxi && cd taxi
for m in $(seq -w 1 12); do
  curl -O "https://d37ci6vzurychx.cloudfront.net/trip-data/yellow_tripdata_2023-${m}.parquet"
done
然后在该目录运行下列基准脚本。它先对数据预处理,按区域奇偶拆分并排序,写成两个 Parquet 文件,再在这些预排序表上比较哈希连接和合并连接:
import timeit
import polars as pl

pl.Config.set_engine_affinity("streaming")


def prepare() -> None:
    """Sort trips by pickup timestamp and write two zone-split tables."""
    all_trips = (
        pl.scan_parquet(
            "yellow_tripdata_2023-*.parquet",
            # PULocationID changed from Int32 to Int64 across monthly files
            cast_options=pl.ScanCastOptions(integer_cast="upcast"),
            # Airport_fee column was added mid-year and is absent in earlier files
            extra_columns="ignore",
        )
        .filter(pl.col("tpep_pickup_datetime").dt.year() == 2023)
        .with_columns(
            pl.col("tpep_pickup_datetime").dt.truncate("1s").alias("pickup_ts"),
        )
        .select(["pickup_ts", "PULocationID", "fare_amount", "trip_distance"])
        .sort("pickup_ts")
        .collect()
    )
    all_trips.filter(pl.col("PULocationID") % 2 == 0).write_parquet("yellow_even.parquet")
    all_trips.filter(pl.col("PULocationID") % 2 == 1).write_parquet("yellow_odd.parquet")


prepare()

even = pl.scan_parquet("yellow_even.parquet")
odd = pl.scan_parquet("yellow_odd.parquet")

hash_query = even.join(odd, on="pickup_ts", how="inner", suffix="_odd")
merge_query = even.set_sorted("pickup_ts").join(
    odd.set_sorted("pickup_ts"),
    on="pickup_ts",
    how="inner",
    suffix="_odd",
)


hash_time = timeit.timeit(lambda: hash_query.collect(), number=1)
merge_time = timeit.timeit(lambda: merge_query.collect(), number=1)
speedup = hash_time / merge_time

print(f"hash join:  {hash_time:.3f}s")
print(f"merge join: {merge_time:.3f}s")
print(f"speedup:    {speedup:.1f}x")
运行方式如下:
uv run --isolated --with polars python taxi_benchmark.py










暂无评论内容