


原作者 Bryan Boreham 虽然是 Prometheus 维护者,也经常阅读 Prometheus 代码,但仍觉得 Prometheus 查询语言 PromQL 的许多细节不够清晰。他常常查资料或深入源码才弄明白某项行为,下个月却又忘了。
为了不辜负 Grafana Labs 杰出工程师这一职位,Bryan 决定写一份明确的指南:执行 PromQL 查询时,究竟发生了什么?
上个月的 PromCon 2024,原作者在“Inside a PromQL Query: Understanding the Mechanics”演讲中向 Prometheus 社区分享了这些发现。(《深入 PromQL 查询:理解内部机制》)
本文回顾并扩展演讲中的要点,希望让你了解 Prometheus 的内部工作,理解数据如何从来源流向 API 输出,并提供进一步探索这一广泛主题的资源。
版本范围:这里描述的是 Prometheus 2.54 与3.0 beta 的 PromQL 实现。细节可能随时间变化。
PromQL 概览
深入查询机制之前,先重温几个基础概念。
PromQL 查询用于表达:要使用哪些指标,以及对这些指标执行什么操作,以计算结果。
这些查询通常用于填充仪表盘,主要有两类:
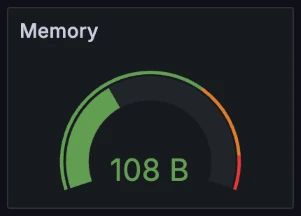
- 即时查询:观察单个时间点。
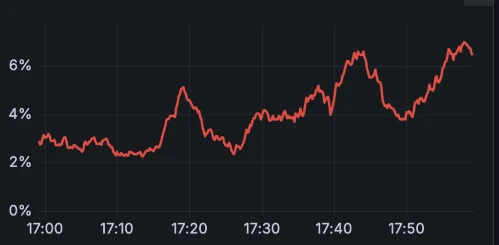
示例查询的内存指标面板 - 范围查询:观察一段时间内的变化。
示例查询的 CPU 使用率曲线
PromQL 文档已经给出详细定义,这里只简要介绍查询的组成:(查询文档)
- 选择器:指标名加标签匹配器,例如
http_requests_total{status="200"}。 - 函数:例如 abs 求绝对值,rate 计算每秒增长速率。
- 聚合:例如 sum、max,可以指定维度,如
sum by (status)。 - 运算符:例如 > 与 +。
一个查询例子是 sum by (status) (rate(http_requests_total[5m]) > 0)。
它先计算 HTTP 请求在5分钟窗口内的速率,筛选确实有请求的序列,再按 status 求和。
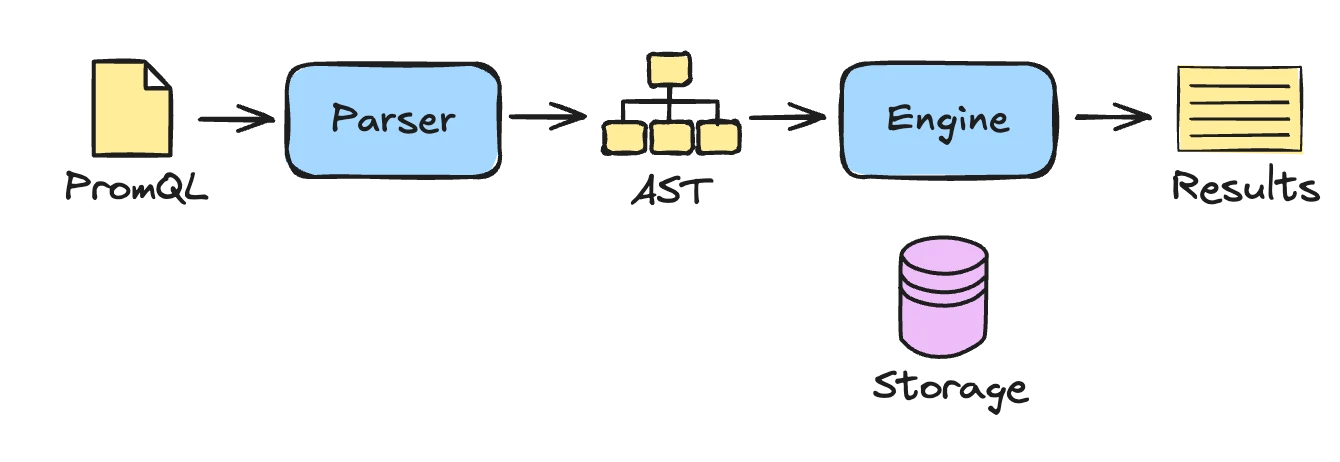
Prometheus 内部承担主要工作的模块称为引擎。解析器将 PromQL 转换为抽象语法树(AST),引擎执行这棵树,从存储拉取数据,最后输出结果。下文会进一步介绍 AST。(抽象语法树(AST))
解析
解析器把 PromQL 文本转换为驱动查询引擎的数据结构。例如以下查询:
rate(http_requests_total[5m]) > 0
解析器会把它转换为下图所示的树:
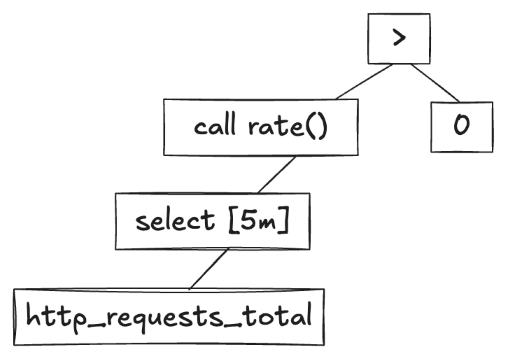
这在技术上称为抽象语法树。简单说,它用节点表示选择器、运算符、函数等结构。树只有一个根,位于图的顶部;计算机中的树向下生长。沿着链接遍历,就能找到原查询中的全部组成部分。
PromQL 执行
引擎首先遍历 AST,为每个选择器节点调用 Select()。这是一个接口,由 Prometheus 内置存储和配置的远程存储实现。下面重点介绍内置存储。
如何在索引中查找选择器
用一些示例数据说明时间序列查找。我们统计 HTTP 服务器请求,按方法与响应状态划分。除这些标签外,每个序列都有一个任意数字 ID。
| ID | 时间序列 |
|---|---|
| 13 | http_requests_total{method="GET",status="200"} |
| 42 | http_requests_total{method="GET",status="404"} |
| 23 | http_requests_total{method="PUT",status="200"} |
| 21 | http_requests_total{method="PUT",status="404"} |
| 73 | http_requests_total{method="PUT",status="500"} |
PromQL 选择器看起来像一个序列,但不必指定全部标签。例如 http_requests_total{status="200"} 应当取得具有该状态的两个序列。
索引先按标签名组织。每个标签名下列出所有取值,每个值又对应序列 ID 列表。数据库传统上把这种列表称为 postings,即倒排列表。
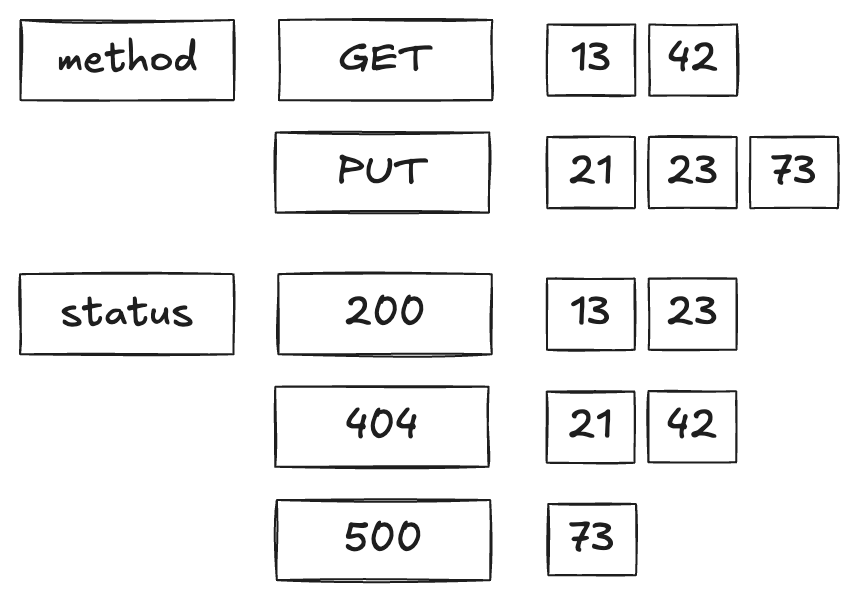
指标名也只是一个标签,其特殊名称为 __name__。

因此,http_requests_total{status="200"} 等价于 {__name__="http_requests_total",status="200"}。
查索引时,对每个条件找到匹配的倒排列表,再求交集,就得到同时满足选择器全部条件的序列。
选择器可以使用不等于条件,此时要移除匹配的序列。引擎先计算增加结果的选择器,再执行移除。
选择器可以用正则表达式匹配,例如 status=~".00"。正则表达式要对每个可能取值进行匹配,决定包含哪些序列。
Prometheus 对只能匹配固定字符串集合的正则表达式有特殊处理,例如 status=~"200|404"。此时直接在索引中查找这些字符串,避免扫描全部取值。
倒排索引在磁盘上的存储细节,可参阅 Ganesh Vernekar 的文章 TSDB: Persistent Block and its Index。(TSDB:持久化块及其索引)
这一节描述了引擎调用 Select() 获取序列的过程。接下来看看如何从序列取得单个数据点,也就是样本。
样本时间戳
为了说明序列与样本的概念,看看 Grafana 中展示的简单查询。
查询返回14个时间序列,分别来自不同数据源。每个样本都有数值,绘制在纵轴;还有时间戳,沿横轴排列。各序列使用不同颜色。时间戳根据 step 参数以规则间隔对齐;原作者示例 Grafana 选择了1分钟。比较数值或进行算术运算时,通常希望各点对齐。
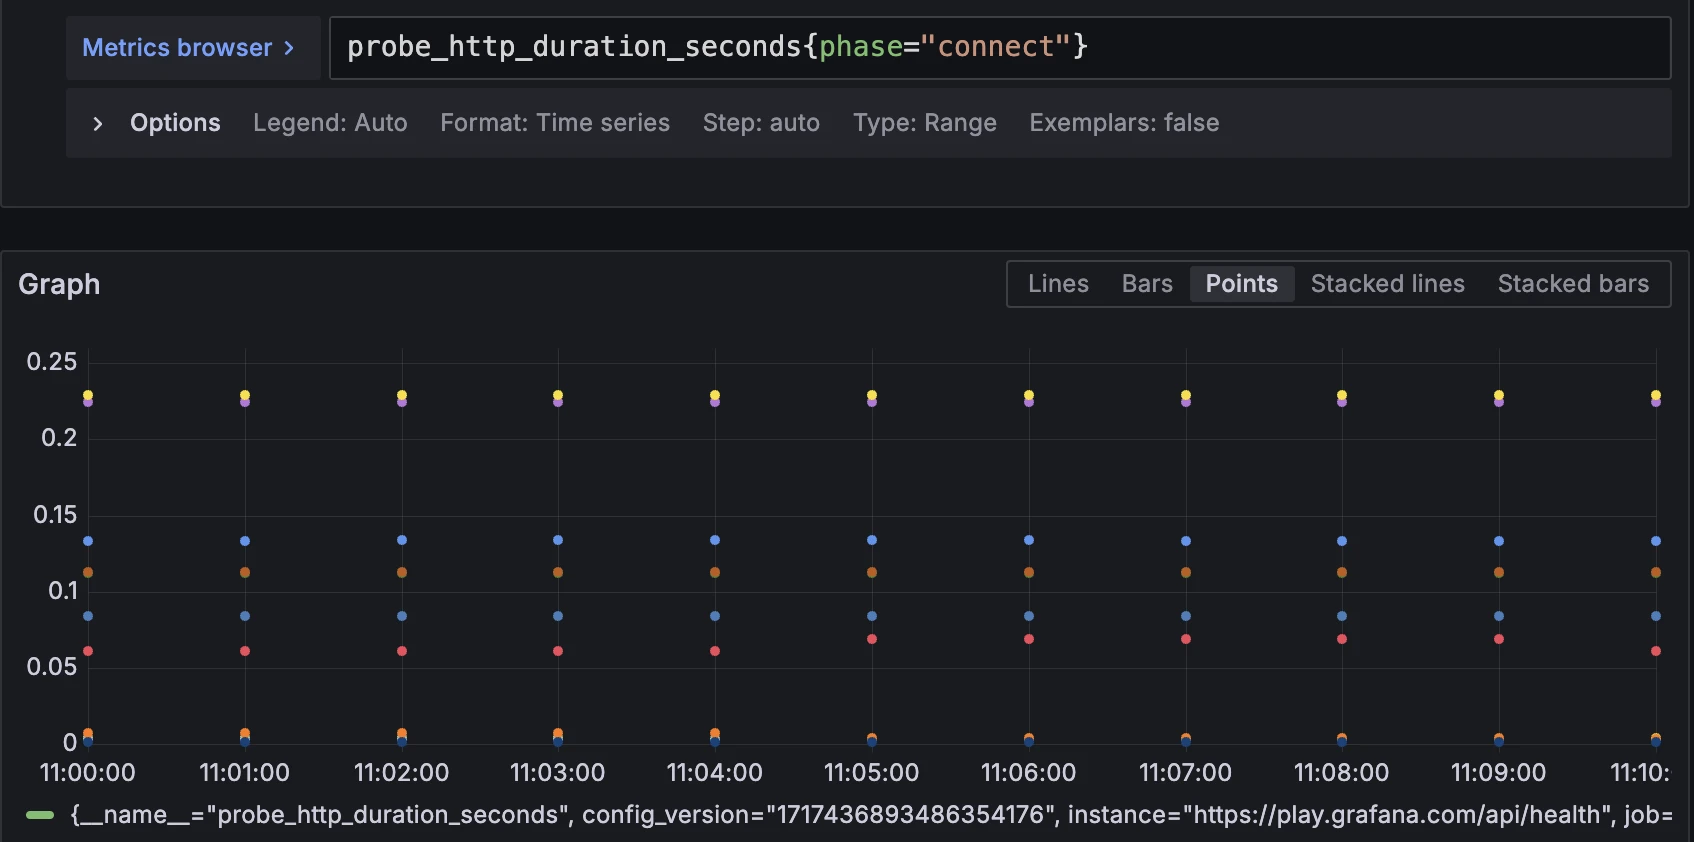
真实数据通常并不整齐。在 Grafana 中选择 Type: Instant,同时把整个仪表盘范围作为范围向量选择器 [$__range],就能看到底层数据点。理解 PromQL 计算输入时,这个小技巧非常有用。
原作者示例各数据源的采样时间偏移不同,因此所有点看起来散布在面板中。
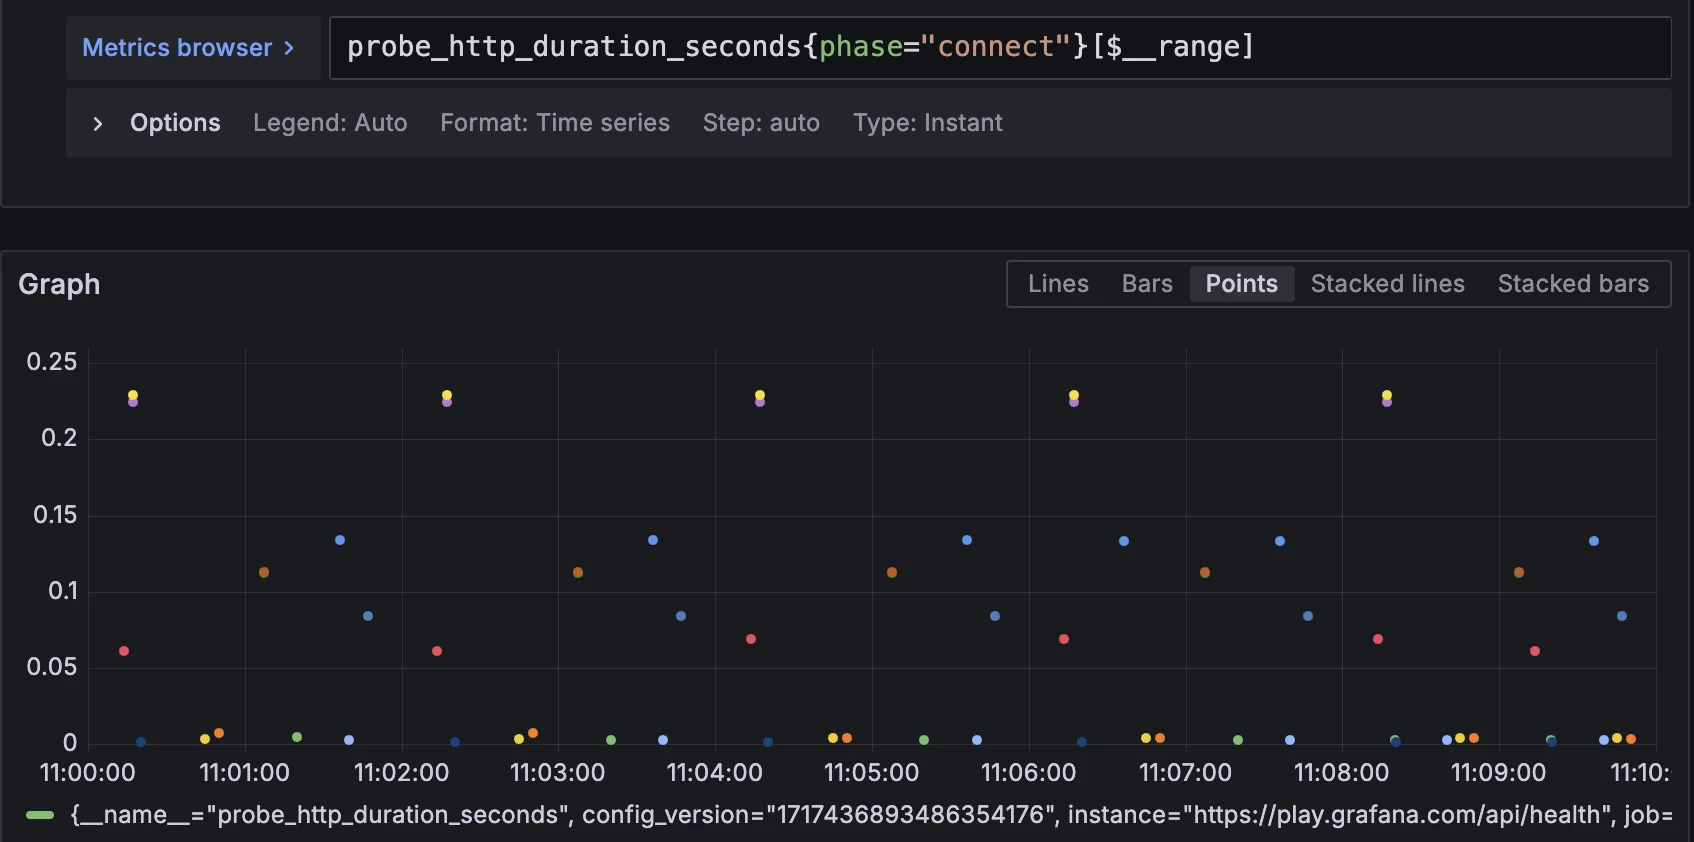
PromQL 在同一时间戳从各序列各取一个样本,称为即时向量。范围向量则包含一组时间序列,每个序列保留时间区间内的一组数据点。在 PromQL 中,范围向量用方括号内的时间长度指定,例如 [5m] 表示5分钟。
范围向量与范围查询不同。范围向量出现在 PromQL 表达式内部;范围查询则从开始到结束时间,按规则间隔反复执行完整表达式。
将序列展开为样本
在引擎代码中,Select() 返回迭代器抽象。访问每个选择器节点时,节点变为 Series 对象集合。需要数据点时,先定位到请求时间减去回看时间的位置,然后逐样本向前移动,直到到达请求时间。
样本可以是浮点数;如果启用了原文当时仍为实验性的原生直方图功能,也可以是完整直方图。(原生直方图功能)
PromQL 函数
原文版本约定义了75个函数,可按工作方式分组:(函数文档)
- 输入一个数据点、输出一个结果的简单函数,如 abs、sqrt。对于即时向量,它们遍历全部序列,计算结果,再输出即时向量。
- 行为类似但接受额外参数的函数,例如 clamp。
- 日期时间函数,例如 month、year、timestamp。它们或按上述方式工作,或在没有参数时作用于 PromQL 当前计算的时间。
- 只处理原生直方图样本的直方图函数。
- 处理范围向量的函数,如 rate、max_over_time、resets。它们对各序列在时间窗口内的整组数据点计算结果。
- label_join 与 label_replace 操作序列而非样本,因此需要特殊处理。
- 接收即时向量、按值或标签排序的函数。
多数函数的输出序列与输入一一对应,但会移除序列名 __name__ 标签,因为 f(foo) 不再是 foo。例外是 last_over_time,它的值与原序列完全相同,只是在时间上移动了。
PromQL 聚合
聚合看起来像函数,工作方式却明显不同。例如下式先计算 rate,再按 status 求和:
sum by (status) (rate(http_requests_total[5m]))
聚合有三种形式:
- sum、avg、count、stdvar、stddev、quantile:为表达式指定的每组生成一个输出序列,只保留 by(…) 指定的标签。
topk、bottomk、limitk保留输入标签,并按第一个参数k限定每组的序列数量。limit_ratio(r, v)也保留输入标签,但按比例r抽样,而不是选择固定的k个序列;具体语义参见 官方聚合运算符说明。- count_values:输出包含 by(…) 标签,再增加一个表示所统计值的标签。
每种情况都会为各输出序列构建对象,遍历输入,累积所需结果。
PromQL 运算符
作为一门丰富的语言,PromQL 提供多种运算符:
- 算术二元运算符:+、-、*、/、%、^。
- 比较二元运算符:==、!=、>、<、>=、<=。
- 逻辑或集合二元运算符:and、or、unless。
在两个即时向量之间使用二元运算符时,PromQL 会匹配标签。下面的基本例子按两侧标签一一匹配:
mem_total_mb - mem_free_mb
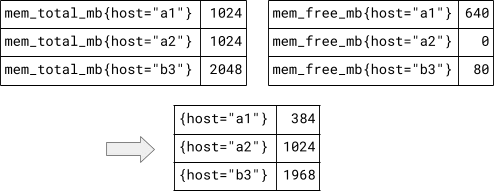
与前面讨论的算术运算一样,这个例子的输出不包含 __name__ 标签。
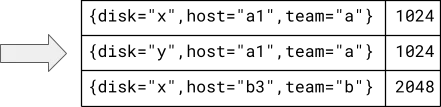
一个常见模式是将含有数值的序列,与提供更多标签、且每个值均为1的 info 序列连接。例如:
disk_mb * on (host) group_left(team) host_info
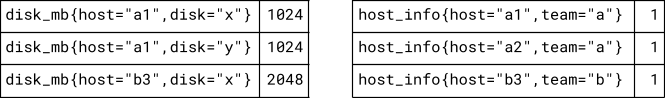
on 指定参与匹配的标签列表;group_left 表示左侧为“多”侧,多个左侧序列可以匹配右侧同一个序列。括号中列出的额外标签将从另一侧添加。
引擎先从每个序列中提取仅包含 on 标签的签名,在“一”侧建立签名映射(哈希表),然后遍历“多”侧寻找匹配。
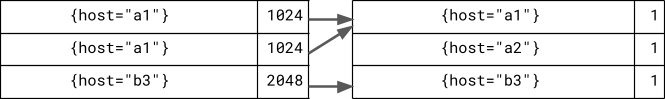
最后组装结果序列,取“多”侧全部标签(除 __name__ 外),再从“一”侧加入 group_left 指定的额外标签。
二元运算可能是 PromQL 中计算开销最大的部分之一,因为每个时间步都要重新构建哈希表并查找匹配,防止上个时间步之后有序列开始或停止。
排序
即时查询默认以任意顺序返回数据,除非用 sort、sort_by_label 等函数要求特定顺序。范围查询则在全部处理结束后,按标签的字母顺序排列输出;因此在范围查询表达式中再用排序函数,并不会改变最终结果顺序。
输出
PromQL 查询通常通过 Prometheus 的 HTTP API 发送,结果以 JSON 返回。JSON 转换由引擎之外的 web/api 包完成。(HTTP API)
查询执行失败时,不会返回数据,而是返回错误字符串和用于分类的 errorType,例如 bad_data 或 timeout。引擎内部通过 Go 的 panic 报告错误,类似 Java 或 C++ 的异常,避免沿执行路径每一步都检查错误。
查询成功时,除了请求的数据,也可能返回 infos 和 warnings。info 程度较轻,例如计数器名未以 _total 结尾;warning 更严重,通常表示查询存在问题,例如 quantile 参数超出0到1的范围。
在查询 URL 中添加 &stats=1,可以取得执行统计。JSON 末尾会增加时间与数据量信息,例如 queryPreparationTime、execTotalTime。这些测量也被汇总到 summary 类型指标 prometheus_engine_query_duration_seconds 中。
如何观察内部执行
如果需要比指标或查询统计更详细的信息,可以通过追踪与性能剖析观察查询。
追踪
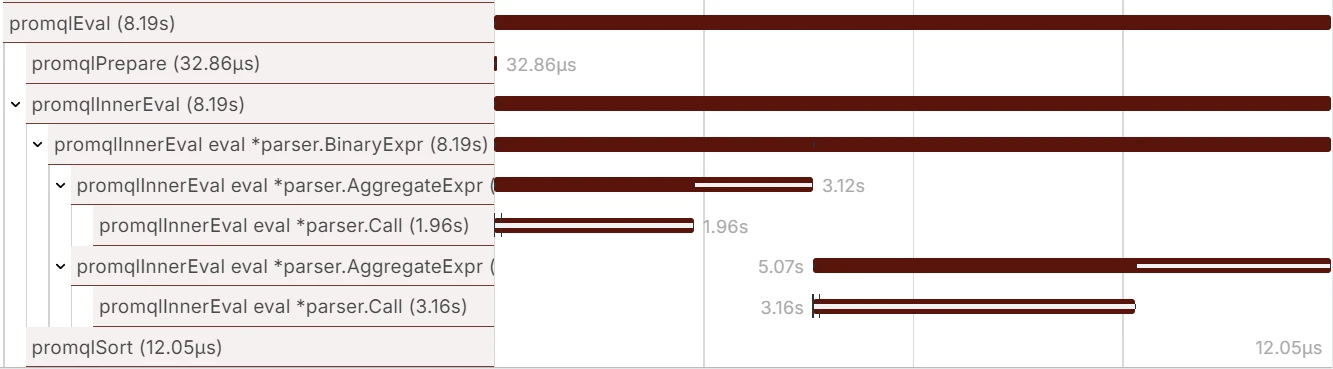
Prometheus 集成了 OpenTelemetry 追踪。如果有 Jaeger 或 Grafana Tempo 等分布式追踪系统,可以查看单个查询以及它们如何执行。(Jaeger · Grafana Tempo)
示例查询为 sum by(job, mode) (rate(node_cpu_seconds_total[1m])) / on(job) group_left sum by(job)(rate(node_cpu_seconds_total[1m]))。
追踪由 span 组成,每个都有开始与结束时间。查看器中,时间从左向右,调用流从上向下。span 的缩进显示引擎执行 AST 各节点的方式。本例 BinaryExpr 调用两个 AggregateExpr;它们各调用一个表示 rate() 的 Call 节点。范围向量选择器的数据获取显示在各 Call span 内。
性能剖析
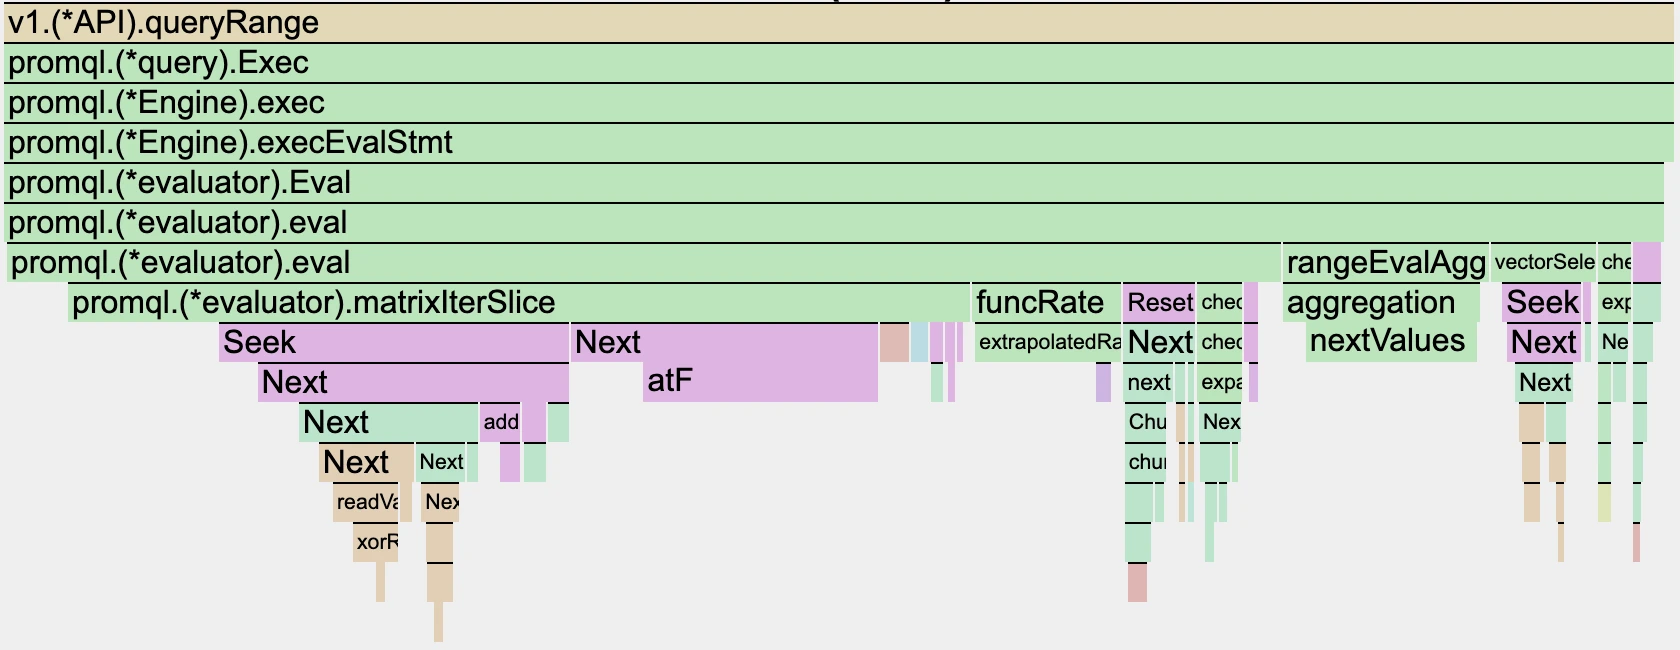
借助 Go 运行时,Prometheus 也支持 CPU 与内存性能剖析,因此可以观察 CPU 使用。原作者的下图展示30秒内混合查询的执行,不能直接映射到某一个查询,但仍能看到调用分布。这是一幅火焰图:函数调用从上到下,条形宽度表示采样时间中有多少花在该函数上。(火焰图视图)
进一步学习
正如 PromCon 2024 演讲提到的,查询执行与提高查询效率涉及大量内容。本文与演讲可作为起点;原文还提到完整幻灯片(3.4MB),这一主题仍能深入很多。
学习 PromQL 时,Grafana Prometheus 查询编辑器的构建器模式有助于理解表达式如何组合,也方便查看可用操作。独立工具 PromLens 更进一步,帮助构建、理解和优化查询。Prometheus 文档是最终参考,而链接中的 PromQL 速查表可能更容易理解。(构建器模式 · PromLens · Prometheus 文档 · PromQL 速查表)
还可以在 Grafana Community Slack 和多个 Prometheus 社区频道寻求建议、交流技巧。作者期待在那里与你相遇。(Grafana Community Slack · Prometheus 社区频道)










暂无评论内容