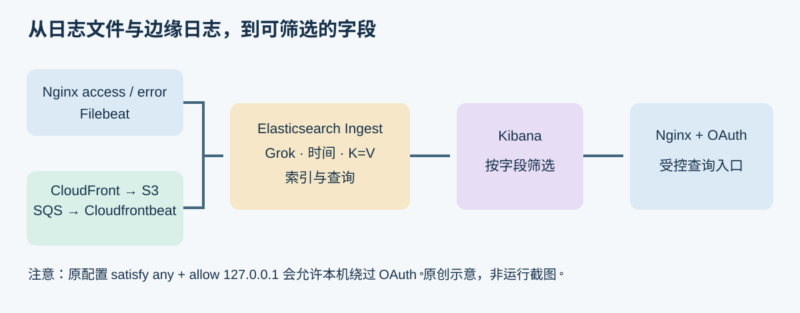



原作者:Zhuoyun Wei(wzyboy);原文发表于 2017 年 12 月 21 日,来源:wzyboy’s blog。原文为中文,本文按授权完整整理转载,保留技术内容,并将版本说明、完整配置核对与编者审核单独标出。
有个段子说,创业公司招人时自称做“大数据”,意思其实是会把日志收集上来,却从来不看。段子归段子,近些年微服务、容器化的发展,的确促进了日志收集技术的进步。ELK,即 Elasticsearch、Logstash、Kibana,也不再是日志收集与展示系统唯一的三件套。本文介绍用 Filebeat 代替 Logstash Shipper、用 Elasticsearch Ingest Node 代替 Logstash Indexer,构建更轻量的日志收集与展示系统。这里的轻量是原文针对其部署方式作出的架构判断,不是本文提供的性能实测。
一、Beats:把数据运到处理端
Beats 和 Logstash 一样出自 Elastic,但 Beats 的职责是 data shipper,即数据采集与传送。Beats 家族共享 libbeat 库,各产品针对不同数据来源实现采集。原文列出的官方成员包括:
- Filebeat:文件。
- Metricbeat:系统和应用指标。
- Packetbeat:网络抓包分析,例如 SQL、DNS。
- Winlogbeat:Windows 系统日志。
- Auditbeat:审计数据。
- Heartbeat:ICMP、TCP、HTTP 监控。
当时还有数十个社区实现。Beats 使用 Go 编写,可以以单文件方式部署,减少语言运行时依赖,很适合分布在不同发行版和版本上的服务器集群。与每台机器安装 Logstash Shipper 及 JRuby 运行时相比,这种部署对小内存机器和容器更加友好。具体资源占用仍取决于所采集的数据、缓冲与输出配置。
Filebeat 采集 Nginx 日志
Filebeat 从文件里读取日志,可以把它理解为面向日志管道的 tail -f。下面是原文的简易 Nginx 日志配置;完整配置和模板放在文末链接的 Ansible Playbook 中:
# 日志源
filebeat.prospectors:
  - type: log
    paths:
      - /var/log/nginx/access.log
      - /var/log/nginx/*.access.log
    fields:
      type: nginx.access

  - type: log
    paths:
      - /var/log/nginx/error.log
    fields:
      type: nginx.error

# 检测到 AWS、GCE、DigitalOcean 等平台时添加机器信息
processors:
  - add_cloud_metadata:

# 作者使用自定义模板,因此不加载默认模板
setup.template.enabled: false

# 输出到 Elasticsearch
output.elasticsearch:
  hosts: ["http://localhost:9200/"]
  pipelines:
    - pipeline: nginx.access
      when.equals:
        fields.type: nginx.access
    - pipeline: nginx.error
      when.equals:
        fields.type: nginx.error
两组输入用 fields.type 区分访问日志与错误日志,输出端再按该字段选择 nginx.access 或 nginx.error pipeline。关闭默认模板的前提是已经准备好作者采用的自定义索引模板;不能把这一行孤立复制到没有模板的部署里。
编者补充:filebeat.prospectors 是旧配置语法。例子把 ES 设为本机 HTTP 地址,不含 TLS 或认证;只有明确的隔离与访问控制边界才能承载这种历史演示。不要把它改成公网地址后照常使用。add_cloud_metadata 会探测云元数据环境,日志里的请求 URL、IP、用户代理和自定义字段也可能含个人信息或令牌;应在采集和索引前明确保留、脱敏与访问权限。
Cloudfrontbeat 补充边缘节点日志
除了 Filebeat,原文还介绍了社区实现 Cloudfrontbeat。原作者博客前置 CloudFront 加速与缓存,Nginx 日志因此不能覆盖所有发生在边缘节点的访问。Cloudfrontbeat 可以解析并上传 CloudFront 的边缘日志。
它的处理过程是:
- CloudFront 把边缘节点日志写入 S3。
- S3 把
ObjectCreate事件发布到 SQS 消息队列。 - Cloudfrontbeat 订阅 SQS,得知产生新日志后,从 S3 取出日志文件,解析并写入 Elasticsearch。
Cloudfrontbeat 还提供 backfill 模式,可以遍历 S3 中指定日期范围的已有日志,把相关信息送入 SQS,再切换回普通 worker 模式,把历史日志也灌入 ES。原作者指出,Cloudfrontbeat 作者还提供了 CloudFormation 模板,帮助配置 S3 与 SQS。这里保留这些原文功能描述,不保证该社区项目及模板在当前 AWS 环境仍可直接使用;S3、SQS 权限和重放的去重、成本条件需要另行核对。
二、Elasticsearch Ingest Node:把预处理放进 Elasticsearch
Ingest Node 从 Elasticsearch 5.0 开始提供。此前常见做法是在 ES 前面放一个 Logstash Indexer,对数据进行预处理。Ingest Node 提供了 grok、geoip 等熟悉的处理器,可以承接不少原本放在 Logstash Indexer 中完成的工作。对于数据量较小的部署,省去独立 Logstash 进程可以减少开销;较大部署则可以像 Master Node、Data Node 那样,把 ingest 角色放到独立节点并扩展。
编者补充:原文认为这种设计“不用担心性能瓶颈”,这里保留其可扩展性的技术意图,但不把它扩展成无条件的性能保证。正则、脚本、批量大小、磁盘、网络和集群负载仍可能形成瓶颈。
原文写作时,Ingest Node 已有数十种处理器,其中 script 处理器最灵活。与位于 /_template 下的模板 API 类似,Ingest API 位于 /_ingest 下。用户提交 pipeline 定义以后,便可以在 Beats 中指定相应的 pipeline。按原文所用版本,新安装的单节点 ES 默认已经具备 ingest 角色,可以直接使用。
用 Grok 解析标准日志,再扩展 K=V 字段
原文的 nginx.access pipeline 使用自定义 Grok pattern:先识别 Nginx combined 格式,再允许日志末尾附加一组用双引号包围的 K=V 字段。随后由 kv 处理器按竖线拆分字段、按等号拆分键和值,并放入 nginx.access 对象。
正文勘误:原网页 Grok 节选中用户代理字段出现断行缺损,无法直接当成有效 JSON 使用。以下改用文章明确链接的 完整 nginx.access.pipeline.json 核对并重排缩进,保留该文件的处理器顺序和配置值;不是凭网页残片补猜的配置。
{
  "description": "Pipeline for parsing Nginx access logs.",
  "processors": [
    {
      "grok": {
        "field": "message",
        "patterns": [
          "%{IP:nginx.access.remote_addr} - %{DATA:nginx.access.remote_user} \\[%{HTTPDATE:nginx.access.time_local}\\] \"%{DATA:nginx.access.request}\" %{NUMBER:nginx.access.status} %{NUMBER:nginx.access.bytes_sent} \"%{DATA:nginx.access.http_referrer}\" \"%{DATA:nginx.access.http_user_agent}\"( \"%{DATA:nginx.access._kvs}\")?"
        ],
        "ignore_missing": true
      }
    },
    {
      "remove": {
        "field": "message"
      }
    },
    {
      "rename": {
        "field": "@timestamp",
        "target_field": "read_timestamp"
      }
    },
    {
      "date": {
        "field": "nginx.access.time_local",
        "target_field": "@timestamp",
        "formats": [
          "dd/MMM/YYYY:H:m:s Z"
        ]
      }
    },
    {
      "kv": {
        "field": "nginx.access._kvs",
        "field_split": "\\|",
        "value_split": "=",
        "target_field": "nginx.access",
        "ignore_missing": true,
        "ignore_failure": true
      }
    },
    {
      "remove": {
        "field": "nginx.access._kvs",
        "ignore_failure": true
      }
    }
  ],
  "on_failure": [
    {
      "set": {
        "field": "error.message",
        "value": "{{ _ingest.on_failure_message }}"
      }
    }
  ]
}
完整文件还有几个网页节选没有展开的步骤:解析后删除原始 message;把采集时的 @timestamp 重命名为 read_timestamp;从日志中的 nginx.access.time_local 解析新的事件时间;处理完 K=V 后删除临时字段 nginx.access._kvs。如果 pipeline 发生未忽略的失败,顶层 on_failure 把失败信息写入 error.message。
kv 处理器设有 ignore_failure: true,意味着它自身的失败可能被跳过,并不一定进入顶层失败处理。删除 message 后发生后续错误时,也可能失去原始行的排查依据。上线前应结合真实日志测试异常路径、字段冲突和原始日志保留策略。时间格式 dd/MMM/YYYY:H:m:s Z 保留了旧文件写法,升级 Elasticsearch 或日期解析库时需要按所用版本验证,不能把它视为跨版本保证。
原作者使用的 Nginx 日志格式如下。前半部分是 combined 格式,末尾附加需要记录的字段:
log_format main
  '$remote_addr - $remote_user [$time_local] '
  '"$request" $status $body_bytes_sent '
  '"$http_referer" "$http_user_agent" '
  '"'
  'host=$host|'
  'request_time=$request_time|'
  'http_x_forwarded_for=$http_x_forwarded_for|'
  'http_cloudfront_viewer_country=$http_cloudfront_viewer_country|'
  'upstream_addr=$upstream_addr|'
  'upstream_status=$upstream_status|'
  'upstream_response_time=$upstream_response_time'
  '"'
;
末尾按 "k1=v1|k2=v2|k3=v3" 组织,便能把默认格式没有的主机、处理时间、代理链、CloudFront 国家字段和上游信息纳入索引。这个模板的“任意 K=V”有格式前提:值里出现分隔符、等号、转义字符或者意外日志格式时,解析可能不再符合预期。外部传入的头字段也不能当成可信身份信息;应控制字段集合、映射和敏感信息,避免索引字段无边界增长。
三、Kibana:按字段过滤和查看日志
Kibana 是 Elasticsearch 的展示前端,使用 Node.js 构建。原文建议使用当时的最新版 6.x,至少使用 5.5,因为 Kibana 5.5 增加了方便的 filter UI,可以直接按字段过滤,不必每次手写 Lucene 或 Elasticsearch Query DSL。本文保留这段功能与版本沿革;它不是让现在的读者安装 5.5 或 6.x。
用 oauth2_proxy 为入口补充认证
这一部分严格说不属于 Kibana 功能本身。原文所处版本的 Kibana 默认没有认证,因此作者推荐在前面加 oauth2_proxy。顾名思义,它能让 HTTP 服务在无需修改自身代码的情况下接入 OAuth2 认证。它可以与后端串联,也可以配合 Nginx 的 auth_request 模块进行旁路认证。原配置如下:
location /oauth2/ {
  proxy_pass http://127.0.0.1:4180;
  proxy_set_header Host                    $host;
  proxy_set_header X-Real-IP               $remote_addr;
  proxy_set_header X-Scheme                $scheme;
  proxy_set_header X-Auth-Request-Redirect  $request_uri;
}

location /kibana/ {
  satisfy any;
  auth_request /oauth2/auth;
  error_page 401 = /oauth2/sign_in;

  allow 127.0.0.1;
  deny all;

  proxy_pass http://127.0.0.1:5601/;
}编者静态审核:satisfy any 表示访问控制和认证条件满足其中一项即可。因此,来源为 127.0.0.1 的请求会因 allow 规则直接获准,不必通过 OAuth。若前面还有本机反向代理,Nginx 看见的连接来源可能都是本机;必须结合真实代理拓扑、可信代理设置与客户端地址处理核对,不能声称这段配置无条件保护了入口。
如果业务要求所有访问都必须通过 OAuth,可在经过环境验证的修订中移除这组本机免认证条件,并明确后端 5601/9200 不能被客户端绕过入口直接访问。OAuth 客户端密钥、cookie 密钥、回调 URL、HTTPS 和授权范围需独立安全配置,不能把示例配置当成完整身份系统。本文未伪造密钥,也未执行任何账户连接。现代 Elastic 安全能力和 oauth2_proxy 项目状态需按实际版本另查,不能沿用 2017 年的默认值结论。
四、Ansible Playbook 懒人包
原作者提供了一个简单的 Elasticsearch Ansible Playbook,用于安装、配置 Filebeat、Elasticsearch、Kibana,并额外提供 oauth2_proxy 角色来为 Kibana 加入认证。
所链接 README 明确写明:该 Playbook 当时只支持 deb 系发行版。其使用步骤是把 hosts.example 复制为 hosts 并编辑目标主机;按需修改 site.yaml 变量,也可以通过 -e key=value 覆盖;最后运行:
ansible-playbook -i hosts site.yaml这条命令会修改 inventory 中的目标机器,不是只读检查。应先审查角色任务、软件源、版本与服务暴露范围,在隔离环境验证并准备回退。本文只读取原文、完整 pipeline 和 README,没有审计仓库中每个 role 的所有任务,也没有运行 Playbook。
作者原文邀请读者在博客评论,评论前阅读其隐私声明。原文版权 © Zhuoyun Wei,采用 CC BY-NC-SA 4.0。本文保留作者署名、原文链接与许可,并标示勘误及新增审核内容。示意图由未完纪编辑原创,新增整理内容沿用相同的署名、非商业性使用、相同方式共享条件。











暂无评论内容