



Meta 的推荐平台每天处理数十亿次用户交互,产生丰富的时间信号,反映用户在产品、广告和内容上的偏好与意图。在2024年关于广告推荐序列学习的文章中,我们展示了对用户行为的顺序和时间进行建模,相比依赖静态、人工构造的稀疏特征,如何得到更丰富、能够感知序列的用户兴趣与广告偏好表征。
本文进一步介绍两项架构突破,让序列学习从基础创新扩展为具有可预测、类似大语言模型扩展规律的生产平台:一是将重型离线用户建模与轻量在线排序解耦的多阶段序列模型;二是基于稠密标记化和目标感知注意力的学习技术,直接从数据中高效学习特征交互。
这些进展与我们更广泛的模型创新共同带来了累积提升:Instagram 转化量提升6%,Facebook 转化量提升3%,Facebook 广告点击量提升3.5%。这一统一序列建模平台是 Meta 生成式广告推荐模型(GEM)的核心组成部分,利用这一学习范式对用户行为的全面理解,为广告主创造更大收益。
序列建模历来的挑战
广告推荐系统必须在毫秒内召回并排序数千条广告,每秒处理数百万个候选。为应对这一规模,一些序列模型采用混合配置:由一个专门模型处理用户事件序列,另一个模型处理稀疏特征交互。
这种混合方法能满足生产需求,但也可能存在以下权衡:
- 组件间的知识传递存在损失。
- 仍然依赖人工特征工程。
- 排序模型与序列模型组件的相互干扰,限制扩展上限。
当时间序列长度及处理序列的 Transformer 模型同时扩大时,这些权衡可能成为瓶颈,限制用户广告体验和广告主投放效果的改善空间。
我们在序列学习中实现了两项根本性的架构突破,解决模型复杂度与服务效率之间的核心矛盾:多阶段序列模型将离线用户建模与在线排序解耦;稠密标记化结合目标感知注意力形成新的学习范式。两者共同提供灵活的生产策略,帮助序列模型泛化,并建立类似 LLM 的扩展规律,可预测地平衡模型表现与计算量。
多阶段序列模型
为提高扩展效率,我们开发了多阶段模型,使基于 Transformer 的序列模型可以高效扩展。把序列模型拆成两个互补阶段——上游离线用户建模和下游在线排序——可以扩大模型容量,使性能持续提高,而不必按同样比例增加在线服务资源。
图1左侧是离线用户模型:异步处理较长的用户历史,生成并缓存捕捉深层行为模式的嵌入。右侧是在线排序模型:将缓存表征与实时广告候选信号结合,产生最终排序。两个阶段之间的箭头表示用户特征嵌入从离线模型传入在线排序模型。
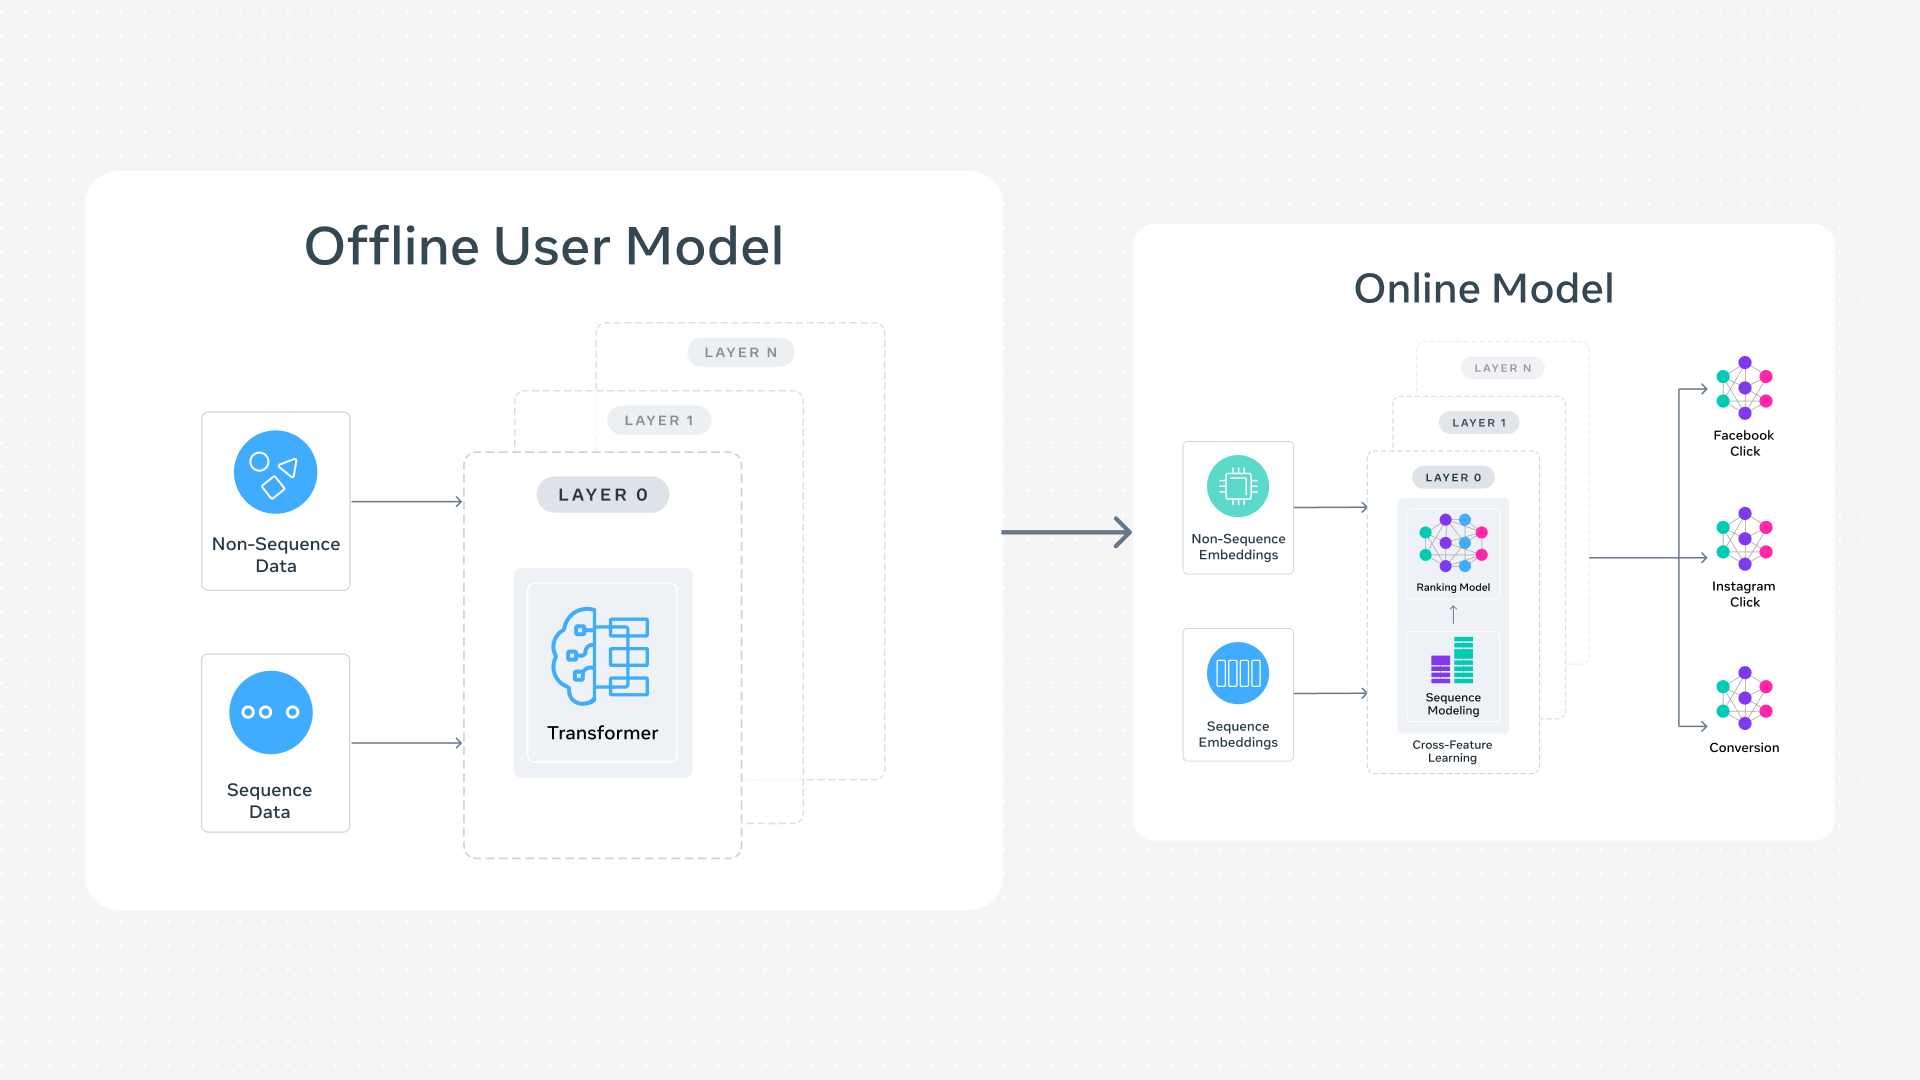
模型的两个关键阶段
第一阶段:离线用户模型
用户侧特征由深层上游 Transformer 模型异步处理。这些模型具有多层 Transformer,序列长度可达数千,生成的嵌入按用户预计算并缓存。上游模型严格分离用户特征与广告、上下文特征,确保用户嵌入不依赖任何特定广告候选。
第二阶段:在线排序模型
在线排序模型利用最新的用户信号与广告候选信息,为离线用户表征补充实时排序能力。该阶段针对速度优化,在利用离线深层表征的同时满足严格的延迟预算。
把序列建模系统分为两个不同而互补的阶段,就能沿离线用户模型的扩展曲线增加复杂度,而不使在线排序模型的服务成本激增。
序列模型架构创新
稠密标记化
这一标记化方法把稀疏特征与序列行为数据整合到一个稠密词表中,使注意力机制可以自行发现交互关系。传统推荐系统依赖人工设计的表征捕捉稀疏跨特征交互;该方法则让模型直接从数据中学习这些交互。
目标感知多头注意力
标记化后的稀疏特征和广告候选信息与用户行为序列融合,然后由一种内存高效的多头注意力处理。每一层都能针对当前评分的特定广告权衡用户的历史行为。通过堆叠多个对齐、注意力分布稳定的注意力块,每一层捕捉目标广告与用户历史行为之间更高阶的交互,逐步将长序列提炼为紧凑表征。
可预测的扩展曲线
类似 LLM 的扩展规律
在真实广告流量中,多阶段序列模型展现出可预测的广告推荐扩展规律,与大语言模型中的规律相似。性能改进相对于计算量呈对数线性关系,扩展效率明显优于其他基于 Transformer 的序列模型。图2展示多个维度下计算量(FLOPs)与模型性能(以归一化熵 NE 衡量)的关系,包括模型深度、内容/语义增强、模型宽度与序列长度。
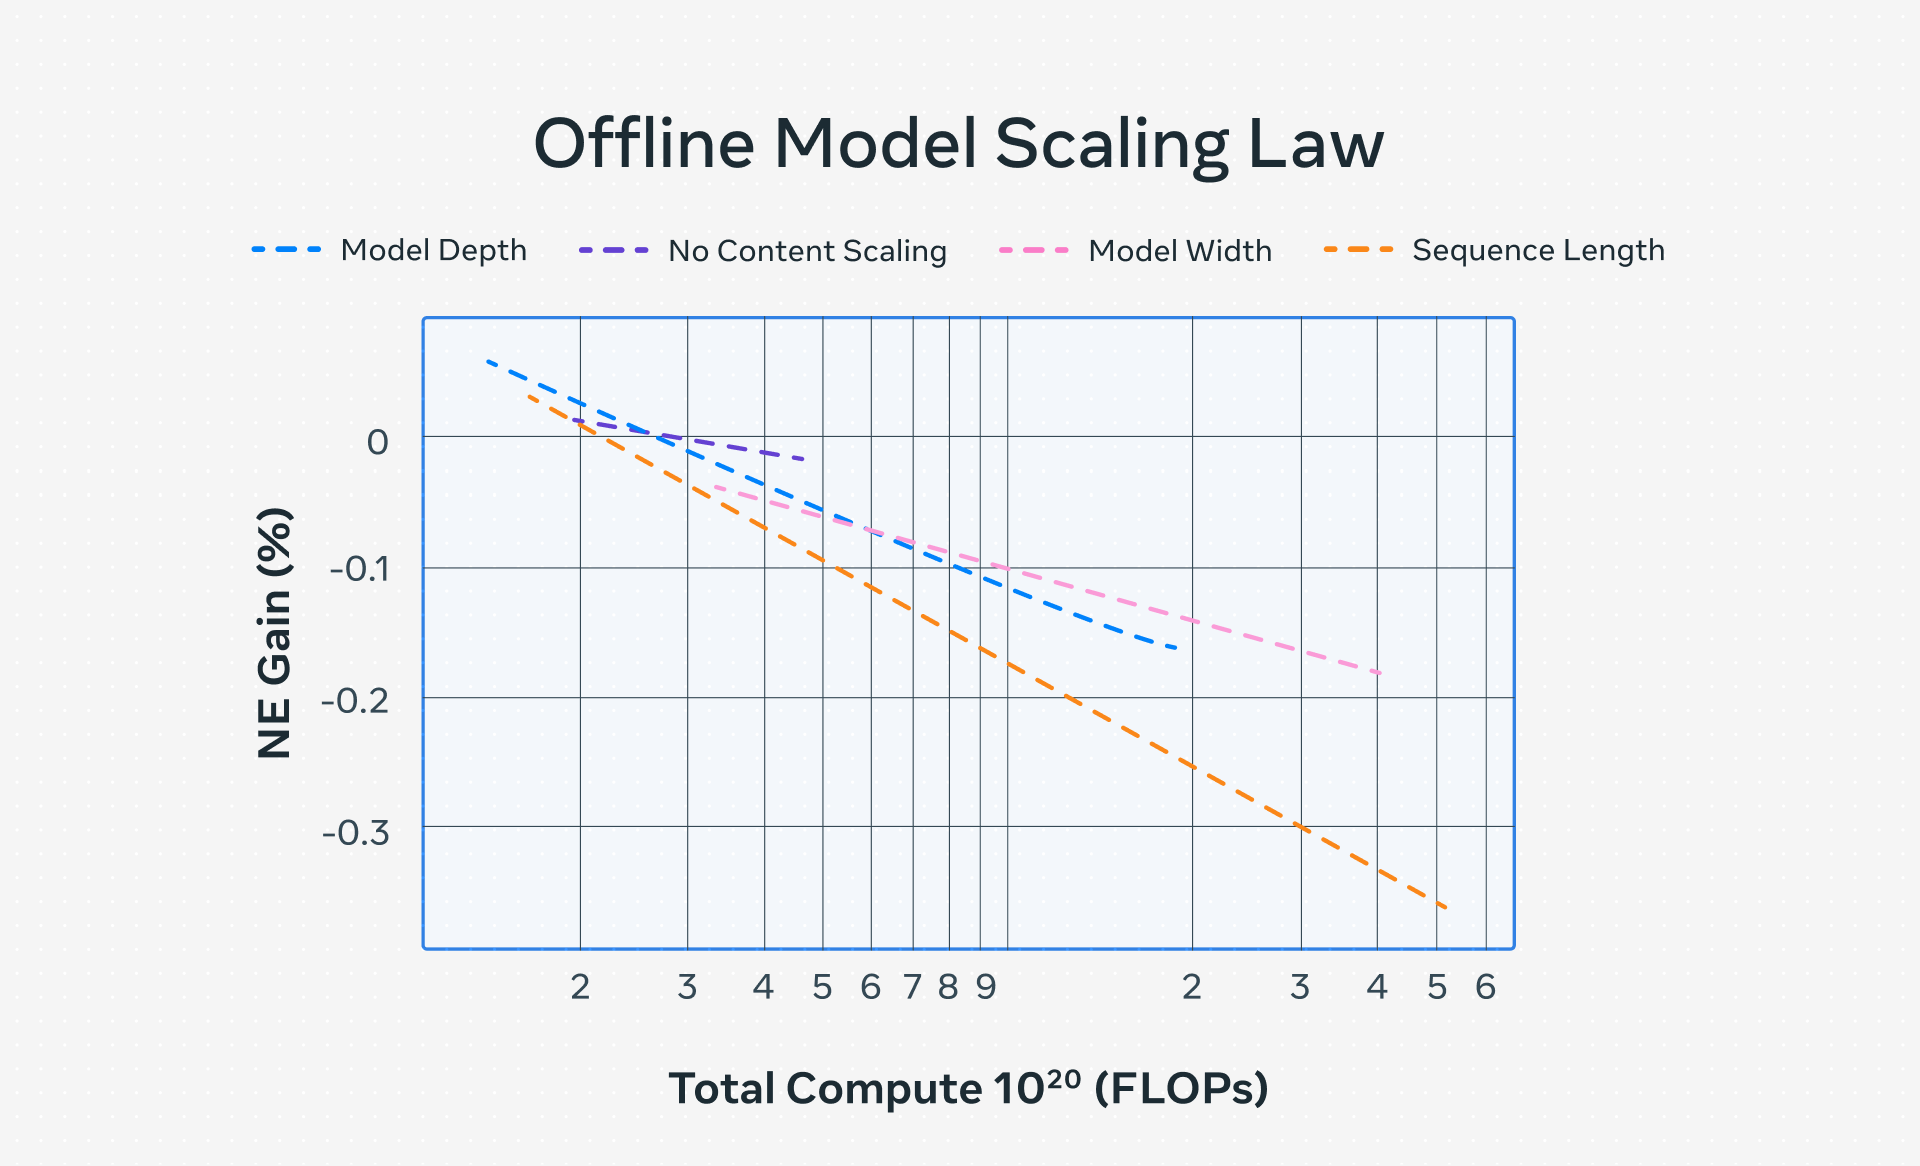
读图提示:图2的纵轴是 NE Gain(归一化熵变化),不是广告转化量或点击量的提升;紫色曲线 No Content Scaling 表示未扩展内容特征的对照。不能把这张模型指标曲线与前述 6%、3%、3.5% 的累积业务收益直接等同。
扩展的调节杠杆
LLM 处理稠密、连续的文本,而广告推荐系统必须将稀疏 ID 特征与时间上的用户序列整合。尽管结构不同,仍然出现了类似 LLM 的扩展规律,这有力表明该架构适合进一步的序列学习应用。
我们发现四个可能推动扩展规律前沿的调节杠杆:
1. 平衡的模型形状
最佳性能要求模型深度、宽度与序列长度均衡增长。如果只沿一个轴扩展,其他轴很可能成为性能瓶颈,导致收益递减。这与 LLM 扩展规律研究的发现相呼应,我们称之为“扩展协同原则”。
2. 多阶段可调性
多阶段架构可以分别扩大或缩小离线模型与在线模型。扩大在线排序模型,每单位计算量带来的性能提升更陡峭,但受在线服务与请求时间约束。扩大离线模型(见图2)遵循更平缓的曲线,但异步推理不受延迟约束,扩展速度可以不受这一限制。
这里的“离线扩展不受延迟约束”是指避开在线请求的直接服务时限,并不表示离线计算成本、更新频率或用户表征新鲜度没有约束。
3. 序列组成
序列越长,性能仍会改善;但一个重要发现是,序列多样性优于同质性。行为类型的均衡组合,例如浏览、点击和转化,比只包含单一行为类型的序列更好。这表明,多样化的互动类型和更广的时间覆盖,比孤立使用同质的高信号行为序列,能产生更丰富的用户行为表征。
4. 语义特征表征
基础模型产生的语义内容特征,补充了传统协同过滤信号,即哪些用户与哪些项目交互。这些特征尤其有助于冷启动,例如新广告或历史互动数据有限的广告主。解决推荐系统这一长期难题,可以改善基础稀疏问题中的整体信号覆盖。
多阶段序列建模的影响
这一架构在三个维度产生了效果:
更深层的用户表征
通过对数千项用户事件序列建模,例如点击、浏览与购买,离线模型生成高度细致的用户表征。这种深层行为理解提高了 Meta 应用家族中的广告相关性和转化率。它与更广泛的模型创新共同实现累积提升:Instagram 转化量6%,Facebook 转化量3%,Facebook 广告点击量3.5%。
扩展效率
与混合方法相比,两阶段设计以更高的计算效率改善性能。初步评估提高了广告排序质量,对在线服务资源影响很小,证实模型复杂度与生产效率可以共同扩展。
平台集成
作为 GEM 的核心部分,这一序列学习架构以泛化为目标设计。同一个多阶段骨干及其扩展特性可以通过很少的适配和开销,延伸到任何广告排序任务。
当前工作:继续扩展
序列模型的扩展规律尚未显示饱和迹象。在获得架构层面的对等性后,可以借助 LLM 领域已验证的技术扩大模型复杂度,例如混合专家、跨用户计算共享和先进注意力机制,有望继续以最优的性能/效率权衡扩展。
阅读论文
模型架构及扩展特性的详细技术内容,见论文 《LLaTTE:大规模广告推荐中多阶段序列建模的扩展规律》。









暂无评论内容