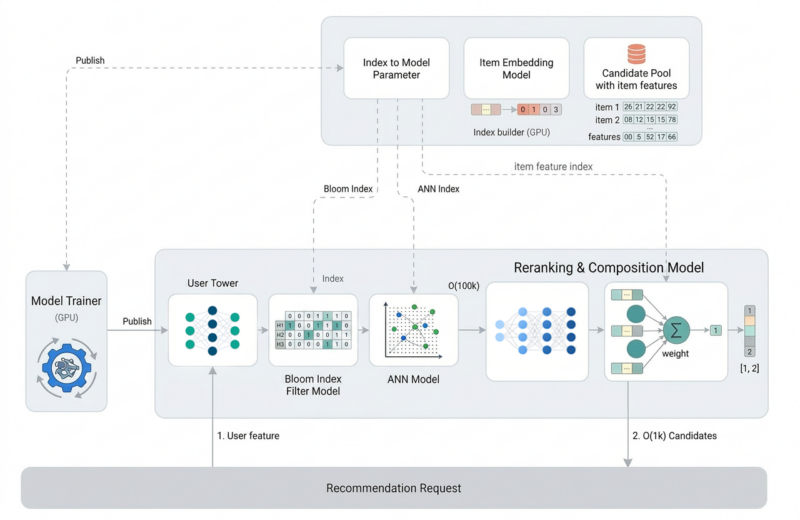



Meta 推出 SilverTorch,将用户生成内容推荐中的全部检索组件统一到同一架构。相较于先进方法,它的吞吐最高达到对照方案的23.7倍;相较于基于 CPU 的方案,计算成本效率为基线的20.9倍,同时改善准确率。完整技术细节见已被 SIGIR 2026 完整论文轨道接收的研究论文 SilverTorch: A Unified Model-based System to Democratize Large-Scale Recommendation on GPUs。
工业推荐系统的检索部分长期由多个微服务拼接而成,神经网络的集成方式也不一致。Meta 的推荐需要跨多个平台服务用户:检索必须在不到100毫秒内,将数百万条内容,例如 reels 和照片,缩小到数千条,再交给排序系统。然而,微服务设计对模型复杂度和评估候选数量存在硬性约束,最终限制了用户看到的推荐质量。
为突破这一上限,团队将整个检索生态重新构建为统一的模型系统 SilverTorch,采用称为 Index as Model(索引即模型)的新范式。检索系统成为一个神经网络,原来的微服务则表示为网络内的模型模块;用于检索的条目索引成为模型内的张量。
用户打开应用后,一个请求流经 SilverTorch 模型,完成全部关键检索功能:搜索符合用户兴趣的条目,按资格条件过滤,重排,以及针对多个互动行为预测参与概率,最后返回高质量内容候选供排序。新设计允许增加建模复杂度和评估候选数量,同时仍满足低于100毫秒的延迟限制。
SilverTorch 大幅提高检索效率,能够大规模运行,并改善推荐:
- 更高吞吐、更低总拥有成本(TCO):在8000万条目的端到端评估中,对比采用相同模型架构的强传统多服务基线,每秒请求数达到基线的23.7倍,估算 TCO 效率为基线的20.9倍。
- 规模已获验证:结果表明,SilverTorch 能跨多个应用扩展,成为信息流与视频内容的主要检索系统。
- 更好的推荐:在紧张延迟预算内实施神经重排与多任务评分,使过去微服务架构难以实现的检索质量提升变得可行。
从微服务网络转向一个集成神经网络
被替换的微服务范式
传统推荐检索是一组微服务构成的网络。用户打开社交平台时,请求先到编排器,再分发到用户塔模型服务——计算表示用户兴趣的向量,即 user embedding;组合检索服务——按与用户向量的相似度,以及语言、地理等资格规则寻找并过滤候选;评分服务——对剩下的候选排序。编排器合并结果,传给下游。
每个服务有独立代码库,往往使用不同语言,也有独立部署生命周期。在 CPU 时代这很有效,但检索规模与复杂度增加后,三个问题累积成单组件优化无法解决的结构性限制:
- 数据搬运消耗延迟:每次服务间跳转都增加网络往返与序列化开销,侵占本应用于实际计算的不到100毫秒预算。过滤、搜索和评分独立设计,也无法联合优化。
- 版本不一致:用户塔模型、条目索引和过滤规则各自更新。用户模型到了 v2,但索引仍为 v1 时,系统就用 v2 用户表示查询 v1 embedding,造成下游排序也无法弥补的质量缺口。
- 开发环境分裂:机器学习工程师写 PyTorch,基础设施工程师写 C++;发布周期、测试环境和理解方式都不同。每次改进都需要在两个环境之间转译想法,一轮可能要数周或数月。
Faiss-GPU 等组件优化能加快单个微服务,却无法消除底层结构限制:系统仍然由服务组成,产物仍在服务之间传递。
转变:所有组件都成为模型模块
SilverTorch 从根本上改变出发点:先有神经网络,再向外设计,而不是先设计微服务系统再插入网络。条目索引、资格过滤器、评分层、用户塔,全部成为单个 PyTorch 模型内的张量或算子。于是只需部署一个产物、执行一次前向传播,并以同一模型作为系统内容的唯一依据。
模型内部
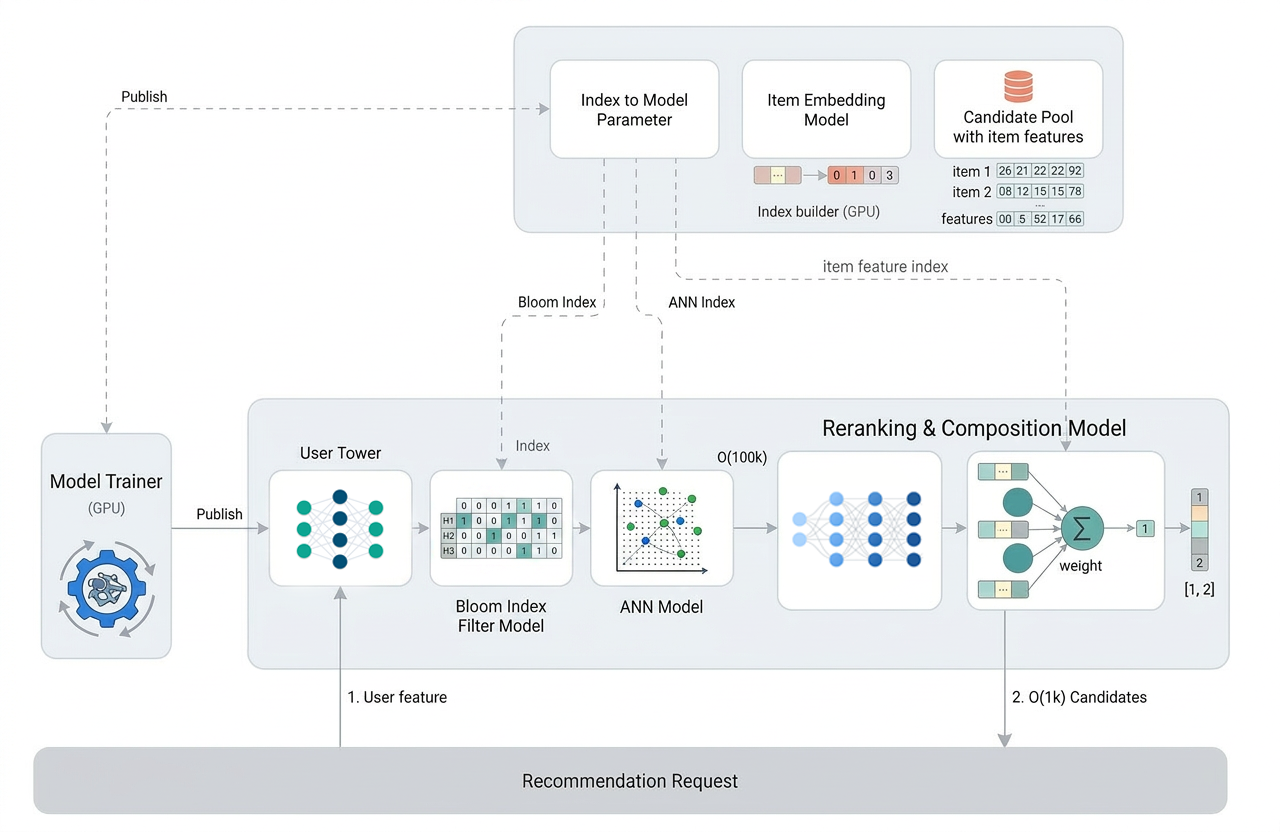
单个网络的不同区域负责不同工作。近似最近邻(ANN)搜索区域寻找最符合用户兴趣的条目,不必检查目录中每个条目,就像整理好图书的图书管理员不必遍历所有书架。资格过滤区域检查候选能否展示:语言、国家和内容政策是否符合要求。多任务重排区域同时预测点赞、分享、评论等多个互动行为的概率,再合成一个分数。
部分区域由工程师手写,其他区域通过反向传播端到端训练。从运行时看,它们全部都是 PyTorch 标准构件 nn.Module,没有区别。
重新设计:每个阶段都使用纯 PyTorch 模块
之前各组件如何工作
在 SilverTorch 之前,生产检索流水线的 ANN 搜索、资格过滤、神经重排和综合评分,都有经典实现,多数是独立的 C++ 服务:
| 模块 | 经典实现 | 运行位置 |
|---|---|---|
| ANN 搜索 | FAISS | CPU 和 GPU 版本 |
| 资格过滤 | 倒排索引 | CPU 和 GPU 版本 |
| 神经重排 | 独立的早期排序服务 | CPU 和 GPU 版本 |
| 综合评分 | 基于规则的聚合 | 仅 CPU |
这些实现成熟且经过实战检验,但各自拥有独立的数据结构、内存和执行模型。可以将它们串接,例如先 ANN,再把输出交给过滤;却很难实现跨模块优化,例如“先挑最有希望的簇,只在这些簇内过滤,再只给剩余候选评分”。这种协同设计需要共享内存、执行图和编译步骤。
采用纯 PyTorch 的决定
为实现协同设计,团队决定将所有模块重新实现为纯 PyTorch:
- 所有数据表示为张量。
- 所有逻辑都输入张量、输出张量。
- 每个模块都是符合 PyTorch 标准接口的
nn.Module。
执行时,ANN 与 Bloom 索引过滤模块,和训练得到的机器学习重排器没有区别:都接收并输出张量。机器学习工程与基础设施工程因此处于同一层,可以在单个 PyTorch 训练脚本中自由组合、联合优化。
整个系统归结为一个模型,也能受益于 AI 行业对 PyTorch 性能的持续优化,例如 torch.compile 自动将模型改写为更高效的 GPU kernel。生态的进步都会改善 SilverTorch 的服务性能。
纯 PyTorch 不意味着把 CPU 时代组件简单包进 nn.Module。它迫使团队按 GPU 执行和模型图的原生形式重新思考检索原语。Bloom 索引过滤器和融合 Int8 ANN 搜索是两个例子:收益来自围绕 GPU 内存行为、张量布局和同一次前向传播重新设计算法,而非仅仅移植旧服务。组件进入同一个模型后,协同设计才成为可能,也正是它释放了收益。
Bloom 索引过滤器:传统过滤常使用倒排索引,在 CPU 上有效,却很难在 GPU 上高效执行。推荐过滤往往同时检查语言、位置、资格等很多属性;不同属性与查询的 posting list 长度差异很大,造成 warp 内负载不均衡和分歧。短列表线程提前空闲,整个 warp 却要等最长列表对应的 lane 完成。
SilverTorch 改为将 Bloom 索引直接存入模型。每个条目发布时获得紧凑签名,服务时用简单位运算快速检查它是否匹配请求。这将过滤变成 GPU 擅长的密集并行工作;结果已经在模型内,可以直接进入 ANN 搜索,无需单独服务调用。
融合 Int8 ANN 搜索:通用 ANN 库用于寻找附近条目,但推荐系统需要的不只是少量近邻,往往要返回更大候选池,让后续阶段判断相关性。SilverTorch 将 ANN 重建为模型的一部分,使用紧凑 Int8 存储条目 embedding,相较常见16位格式,内存约减半,再以融合 GPU kernel 搜索。这减少数据搬运,使检索能以更低成本返回更多候选,为下游寻找最佳推荐留出空间。
原文团队发现,Int8 量化 ANN 与暴力搜索相比质量损失有限,却显著提高服务性能,为更多条目、更复杂层的排序释放余量,改善端到端检索准确率。算法支持较大的 top-k 和 probe 数;实际观察中,64个 probe、top-2048 时没有检索召回损失。
系统外部可见的收益
SilverTorch 在计算成本效率、推荐质量和工程速度三个方面产生具体影响。
计算成本效率
将 ANN、资格过滤和综合评分搬到 GPU,并通过协同设计组合,同一台机器每秒服务更多请求。同一负载所需机器更少,每请求计算成本也更低。下面是在8000万条目生产检索工作负载下,将真实生产流量在同一延迟预算下回放的比较:
| 指标 | FAISS-CPU | FAISS-GPU | SilverTorch |
|---|---|---|---|
| 相对 CPU 基线的计算成本效率 | 基线 | 5.9倍 | 20.9倍;带重排时13.35倍 |
| 最大 top-k | 无限制,但慢 | 2048 | 数十万 |
| 神经重排 | 不支持 | 不支持 | 支持 |
| 多任务评分 | 不支持 | 不支持 | 支持 |
比较口径:20.9 倍与加入重排后的 13.35 倍分别对应原文不同设置,不能混作同一个结果;论文摘要突出的是包含更复杂模型、改善准确率时的 13.35 倍。下面不同模块的加速比也各有对照,不能直接相乘推算整个系统的端到端加速。前文“Int8 内存约减半”以 16 位嵌入存储为对照,不是对整个服务进程内存占用的承诺。
13.35倍的每请求成本优势由多个来源叠加:融合 Int8 ANN kernel 比 Faiss-GPU 快2.2至14.7倍,Bloom 索引比 CPU 倒排索引快291至523倍,先探测再过滤的协同设计又将过滤计算量减少30倍。模型图内的 Int8 量化相较全精度基线将内存减半,并利用 GPU 的 dp4a 指令,未测得召回损失。
推荐质量
SilverTorch 将检索变成候选更广、表达能力更强的预排序阶段。传统服务系统通常限制在较窄的 ANN 结果集,主要用简单 embedding 相似度评分,更丰富的相关性建模留到后期排序。
ANN、过滤、评分留在同一模型后,漏斗可以显著扩大:比起只向下游提交少量候选,可以让多一个到两个数量级的候选先经过学习得到的相关性层,再进入最终排序。检索因此能真正改善推荐质量,而不只是快速剪枝。
神经重排:基于神经网络的重排层超越点积相似度,对更大候选集进行丰富的用户与条目交互建模。这些层可以是多层感知机、堆叠自注意力,或 mixture of logits 等更结构化的交互模型。条目表示和交叉特征留在 GPU 内存中,并在同一模型执行,因此这些复杂排序层能更早应用于远多于传统检索系统的候选。
多任务评分:检索也原生支持多目标。评分层将不同用户动作的预测合成一个综合分数,不再只围绕粗糙的相似度信号优化,而是在后期排序之前,根据更丰富的参与行为概念评估大候选池。
结果是更宽、更智能的漏斗:更多候选通过早期检索,并在最终排序之前接受更复杂的多目标评分筛选。
工程速度
整个流水线位于同一个 PyTorch 代码库,工程师实现新检索想法时只需写 PyTorch,不再需要将研究 notebook 的算法翻译成 C++ 服务、协调独立基础设施团队,或经历数周集成周期。构建并发布新创新所需时间从数周缩短到数天。
面向规模与新鲜度的工程设计
SilverTorch 考虑了可扩展性与索引新鲜度,以支持大规模推荐,并近实时分发新内容。
纵向与横向扩展
策略是先纵向扩展:仔细安排片上 SRAM、GPU HBM、主机 DRAM、远端 DRAM 的内存层级,让数据接近计算位置,充分利用单个高性能 GPU。
单 GPU 用尽后,再在主机内部横向扩展,利用同机 GPU 卡之间的高带宽互连。当神经网络超过单主机容量时,使用文档分片,将视频、帖子、照片等条目目录分散到多台主机,就像把图书目录拆到不同分馆。
对于模型内很大的稀疏网络,即将每个条目和用户特征映射为学习向量的 embedding 表,使用 PyTorch 的稀疏表分片库 TorchRec。它将表分布于 HBM、GPU 主机 DRAM,甚至远端 CPU 主机 DRAM,使稀疏数据搬运与计算解耦。
索引新鲜度
索引成为模型模块后,维护新鲜度就等同于在生产规模下更新神经网络权重,同时不让模型下线。
SilverTorch 通过流式更新,将新鲜度与完整模型发布周期解耦。模型参数根据最新训练更新后,团队周期性发布完整快照。两次发布之间,连续的流服务读取新条目、更新后的互动特征、变化的资格等实时信号,在内存模型中特定张量上进行原地、定向更新。更新不打断服务,也无需重新部署模型。
收益体现在推荐内容的新近程度:与先前系统相比,当天发布的帖子如今在社交平台推荐中占据显著比例。
SilverTorch 的演进与下一步
SilverTorch 经历了从附加神经网络的微服务系统,到完整模型化推荐检索的转变。回顾起来有两点突出:
- 完整模型化检索在生产规模下可行且高效,基础设施与建模之间的墙被打破,成为统一实践。
- 它改善用户体验,让先前系统无法在延迟预算内运行的多任务评分、神经重排等能力成为可能。
技术工作分为三个阶段:
- 在 PyTorch 中复现 ANN、过滤、评分等每个基线模块。仅这一步,就从高速 GPU 内存和减少数据搬运中获益。
- 以 PyTorch 原生、GPU 原生方式重构每个模块。融合 Int8 ANN 与 Bloom 索引过滤器由此产生,设计目标是可组合,而非独立运行。
- 为部分手写模块启用反向传播,使它们与模型其他部分联合训练。
展望
Index as Model 是团队认为适合下一代推荐系统的范式,已在 Meta 多个应用中广泛采用。推荐系统越来越多地引入 LLM 理解用户意图和内容语义,SilverTorch 提供了自然的集成位置:
- LLM 可作为另一个模块插入,系统与其他组件同样对待它。
- 基于 LLM 的条目生成与 SilverTorch 过滤使用相同 GPU 并行模式。
- 条目知识可通过同一流式基础设施实时更新。
- LLM 与传统评分共享 GPU 内存,无需在服务之间搬运数据。
因此,LLM 能力可以直接进入检索模型,而不是成为旁边需要单独编排的服务。更紧密的结合,提高了 LLM 推荐在生产规模下的能力上限。
阅读论文
更多技术细节见 SIGIR 2026 接收的完整研究论文:SilverTorch: A Unified Model-based System to Democratize Large-Scale Recommendation on GPUs。
致谢
团队感谢以下人员及 Meta 合作团队,共同使系统落地:
Ryan Chang、Yijie Deng、Fei Ding、Eric Dong、Fan Duo、Zheng Fang、Pawel Garbacki、Hui Geng、Kevin Greer、Max Gu、Ke Huang、Chirag Jain、Anna Jung、Eric Kim、Da Kuang、Xialu Li、Sam Lin、Ziqi Liu、Yiming Ma、Lei Mao、Xiaoheng Mao、Peter Park、Lanbo She、Fangcheng Sun、Jin Sun、Shuo Tang、Harry Tran、Alex Wang、Byron Wang、Jiazhou Wang、Liang Wang、Wenting Wang、Zhen Wang、Zheng Wei、Hong Wu、Peng Xia、Judy Xiang、Bi Xue、Lan Xue、Chao Yang、Shuguang Ye、Hongzhang Yin、Min Yu、Keke Zhai、Qianqian Zhang、Rui Zhang、Yingjiao Zhao。
Rui Li、Qifan Wang、Shengzhi Wang、Yubo Wang、Yueming Wang、Jiaqi Zhai、Erheng Zhong,以及 RecSys Modeling 团队。
Xinyao Hu、Yanzun Huang、Rui Jian、Min Ni、Qunshu Zhang、Yuting Zhang、Yanli Zhao,以及 RecSys Foundation 团队。
Bruce Deng、Congle Zhang、Luyi Guo、Min Li、Yang Liu、Kai Ren、Guoqiang Jerry Chen、Yimin Tan、Honghao Wei、Li Yu、Lu Zheng,以及 Facebook 团队。
Lihan Bin、Xianjie Chen、Mingze Gao、Abhishek Kumar、Zhengyu Su、Haotian Wu,以及 Instagram 团队。
Shujian Bu、Chenglin Lu、Rui Wang,以及 Threads 团队。
Shiyan Deng、Lu Fang、Hongyi Jia、Xudong Ma、Lujia Zhang,以及 AI Infrastructure 团队。
Rongrong Hu、Shuyi Zheng,以及 Meta AI 团队。









暂无评论内容