



原作者:王东、王伟;原载美团技术团队,2020 年 8 月 6 日。本文在完整核对原文后整理,原案例、测量数字和经验归原作者所有;文中“团队”均指当时的美团 Zeus 团队。本次未运行 JVM 参数、压测或诊断命令,也未复现性能结果。
版本说明:原文讨论 JDK 11 的早期、非分代 ZGC,包含当年的实验性开关、根扫描实现、参数和部署条件。它是一篇历史实践,不是新 JDK 的配置单。Oracle JDK 24 官方指南已明确说明 ZGC 为分代收集器,ZGenerational 选项也已移除。新版本的机制、支持平台和调优策略应另查安装版本文档。
业务要解决的,是 GC 对尾延迟的影响
ZGC 在 JDK 11 中推出时,设计目标包括暂停不超过 10 ms、暂停时间不随堆或活跃对象规模增加,以及支持 8 MB 到 4 TB 的堆并继续扩展。这些是原文介绍的设计目标,不是任何业务在任何负载下的延迟保证。
美团风控服务的部分上游要求在 65 ms 内得到结果,并达到 99.99% 可用性。当时采用 CMS,单次 Young GC 约 40 ms,每分钟 10 次,而接口平均响应时间约 30 ms。即便平均耗时看起来尚可,GC 的 Stop The World(STW,暂停应用线程)仍会影响尾部请求。
原作者用简化时间窗口估算:每次 GC 前后约 40 + 30 ms 的请求可能被暂停影响,按每分钟 10 次计算,覆盖比例约为 70 × 10 / 60000 ≈ 1.17%;其中约 30 × 10 / 60000 = 0.5% 的窗口对应可能完整承受 40 ms 暂停的请求。整理订正:原文第一式写成 1.12%,算术应约为 1.17%。这只是建立直觉的估算,实际超时率还取决于到达分布、并发、排队和服务时长分布,不能当成压测结果。
团队先尝试减少单次 GC 时间、降低 GC 频率,也测试过 G1,但没有达到当时的业务目标。因此,转向 ZGC 的出发点是已经观察到 GC 瓶颈,而不是认为更新的收集器对所有服务都更好。
CMS、G1 与早期 ZGC 的暂停差在哪里
原文从标记—复制算法解释差异:标记从 GC Roots 出发寻找活对象,转移把活对象复制到新位置,重定位修正指向旧地址的引用。CMS 默认的新生代收集器 ParNew,以及 G1 的 Young/Mixed 回收都涉及这种复制过程,但“CMS 整体”和“CMS 的新生代”不能混为一谈。
在原文的 G1 混合回收简化描述中,初始标记、再标记、清理和复制各有暂停。并发标记可以与应用线程一起执行,而存活对象的转移需要 STW;要复制的活对象越多、对象处理越复杂,转移阶段就越可能成为暂停瓶颈。G1 Young GC 与 ParNew Young GC 的对象处理在这一语境下属于 STW 工作。这个说明用于比较原案例所用实现,不应据此抹去 G1 在其他阶段的并发机制或后续版本改进。
JDK 11 ZGC 也基于标记与转移,但将昂贵的大部分标记、转移、重定位工作移到并发阶段。原文列出三个主要 GC 暂停:Pause Mark Start、Pause Mark End 和 Pause Relocate Start。初始标记与初始转移需要处理 GC Roots,耗时与根集合相关;当年的再标记实现会在工作超过短时间预算后继续并发标记。因而“暂停不随堆线性增长”并不等于根集合再大也无影响,更不代表应用不会因分配阻塞而停顿。
着色指针与读屏障怎样支持并发转移
并发转移的难点是:GC 正在移动对象时,应用仍在读取它。若引用还保存旧地址,应用必须能找到新位置。早期 ZGC 把元数据放进对象引用的部分位中,称为着色指针;应用从堆中加载对象引用时,JVM 插入读屏障,检查引用是否需要标记或重映射,必要时取得正确的新地址。
原文以当时 64 位实现的虚拟地址布局说明:对象偏移使用低位,部分高位用于标记和重映射信息,M0、M1 与 Remapped 是同一物理内存的不同虚拟地址视图。图文描述的范围包括 0–4 TB 堆偏移、4–8 TB 的 M0、8–12 TB 的 M1、12–16 TB 预留以及 16–20 TB 的 Remapped。多个虚拟映射并不意味着每个对象占用三份物理内存。
这些位段和地址范围是原文的历史实现示意,不能推广到所有架构和 JDK 版本。原文把存活信息“写入指针位”作为快速路径直觉;实际回收仍涉及对象遍历、位图、转发表和内存访问,不能理解成只改几个寄存器位就完成了标记。
// 机制示意,并非可直接编译的 Java 源文件。
Object o = obj.fieldA;  // 从堆中加载对象引用:对应读屏障介入点
// <load barrier>
Object p = o;           // 这里只复制已有局部引用
o.doSomething();
int i = obj.fieldB;     // 读取基本类型字段,不是加载对象引用
按原文的视图切换模型,初始化时使用 Remapped;第一轮并发标记切到 M0,标记结束后并发转移回到 Remapped;下一轮标记使用 M1,以区分上一轮与当前轮。读屏障参与标记和转移过程,使应用在并发修改引用的情况下仍获得正确的对象访问。这个模型说明并发性如何实现,不是分析某个任意引用是否存活的手工判定工具。
调优首先要留出“回收期间继续分配”的余量
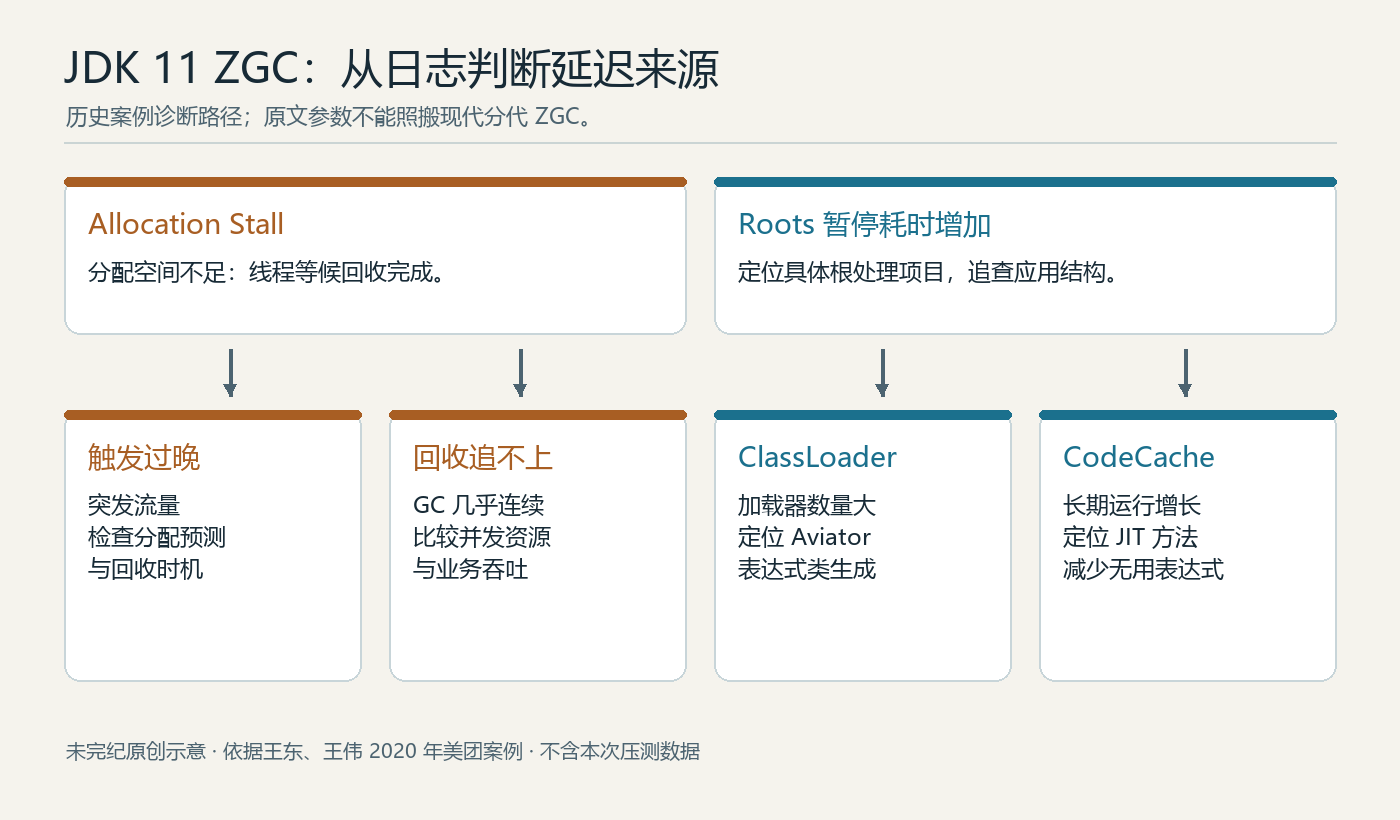
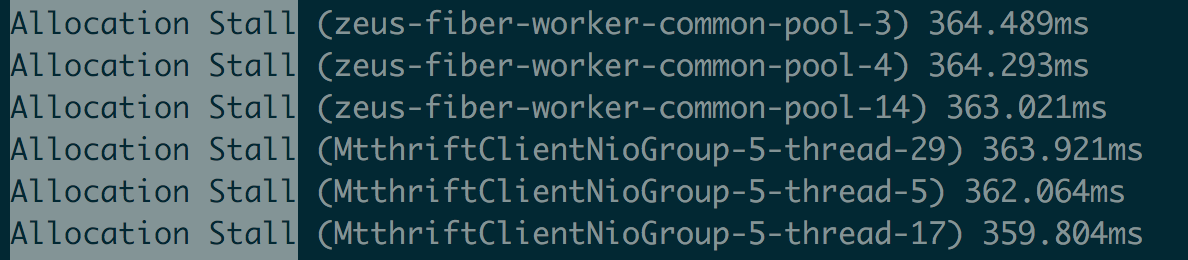
并发回收期间,应用还在分配新对象。若在 GC 释放空间之前堆就被占满,线程会等候内存,日志中出现 Allocation Stall。这个停顿可能远大于几个 GC STW 阶段的时间,原团队遇到过秒级情况。只盯着 Pause 日志的最大值,会漏掉真正影响用户的阻塞。
原文列出的生产参数如下,仅作为 JDK 11 历史配置保留,不能复制到新版本或其他机器后宣称完成优化:
-Xms10G -Xmx10G
-XX:ReservedCodeCacheSize=256m -XX:InitialCodeCacheSize=256m
-XX:+UnlockExperimentalVMOptions -XX:+UseZGC
-XX:ConcGCThreads=2 -XX:ParallelGCThreads=6
-XX:ZCollectionInterval=120 -XX:ZAllocationSpikeTolerance=5
-XX:+UnlockDiagnosticVMOptions -XX:-ZProactive
-Xlog:safepoint,classhisto*=trace,age*,gc*=info:file=/opt/logs/logs/gc-%t.log:time,tid,tags:filecount=5,filesize=50m-Xms与-Xmx分别设置初始/最小堆约束和最大堆;原配置都为 10 GB。应用总内存还包括元空间、线程栈、代码缓存等,不能按堆大小当成进程上限。ReservedCodeCacheSize与InitialCodeCacheSize控制存放 JIT 编译代码的 CodeCache。原服务因表达式生成代码较多设置为 256 MB,不能照搬其容量。UnlockExperimentalVMOptions与UseZGC是该历史版本启用实验性 ZGC 的组合。新 JDK 不应盲目保留旧实验参数。ConcGCThreads是并发回收线程数。原文所用实现默认约为 CPU 核数的 1/8;增加会加快 GC,却与应用争用 CPU。ParallelGCThreads对应暂停阶段的并行线程,原文给出的默认比例约为核数的 60%,属于其版本背景。ZAllocationSpikeTolerance调整当时的分配尖峰容忍系数,原文默认 2,团队设为 5,以更早触发回收。ZCollectionInterval是定时回收触发的时间间隔。语义订正:原文称其为“最小时间间隔”容易让人误以为禁止更早 GC;它不阻止分配压力等其他原因提前触发回收。OpenJDK 11u 的参数定义说明其单位为秒,用于定时间隔触发。-ZProactive在原配置里关闭主动回收策略;团队已有定时触发,所以作此取舍。其他负载不能据此默认关闭。-Xlog配置日志内容、时间、线程、标签和轮转。路径应由部署环境管理,限制访问并控制磁盘占用;诊断输出可能暴露类名、业务结构与运行信息。
从触发原因和日志定位问题
原团队把 GC 触发原因分为以下几类:
| 日志关键字 | 原文中的解释与判断 |
|---|---|
| Allocation Stall | 没有足够空间满足分配,线程被迫等待;属于应重点避免的症状。 |
| Allocation Rate | 根据近期分配速率和 GC 耗时预测触发时间,是当时主要的自适应机制。 |
| Timer | 定时间隔触发,原团队用它应对流量突增时预测滞后。 |
| Proactive | 收集器主动判断需要回收,时间并非固定。 |
| Warmup | 服务启动阶段的预热触发。 |
| System.gc() | 来自应用显式请求。 |
| Metadata GC Threshold | 元数据分配压力相关触发。 |
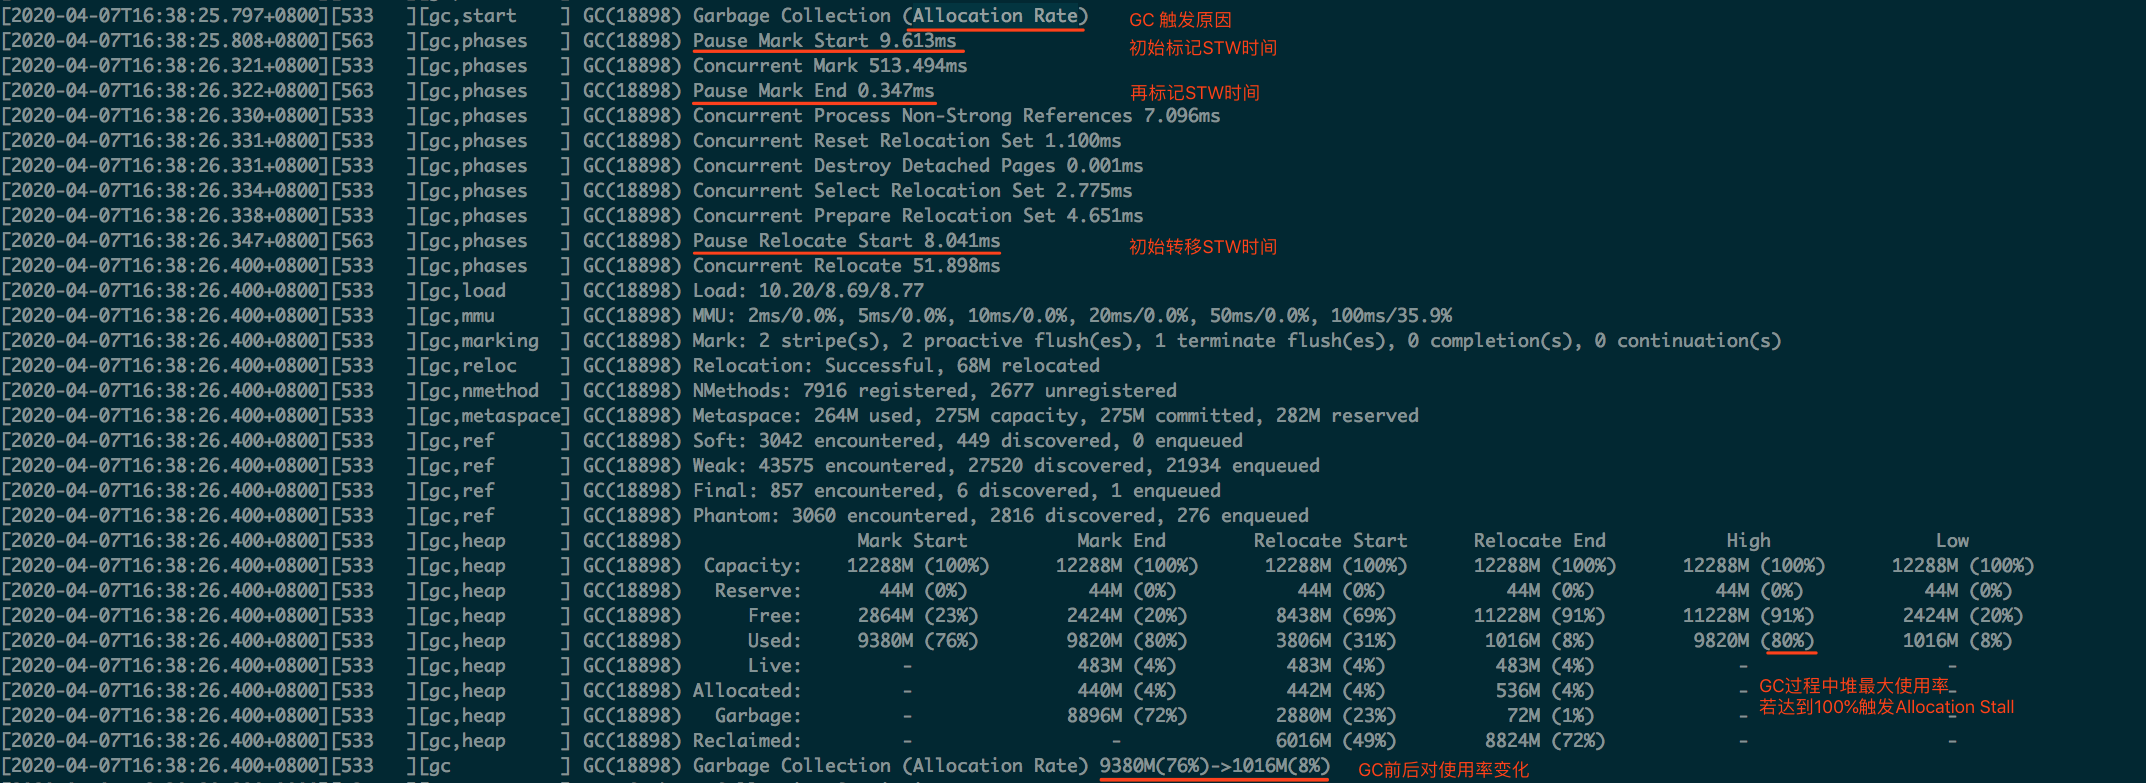
一次 GC 的 Start 记录会给出触发原因;Phase/Pause 记录展示具体阶段。Heap 表里的 Mark、Relocate 前后值,以及 High/Low,可以帮助判断回收期间用量是否逼近上限。原文把 High 中 Used 达到 100% 视为重要警报;实际判断仍应结合分配阻塞、时间线和具体日志语义,不能只凭四舍五入的单个百分比定案。
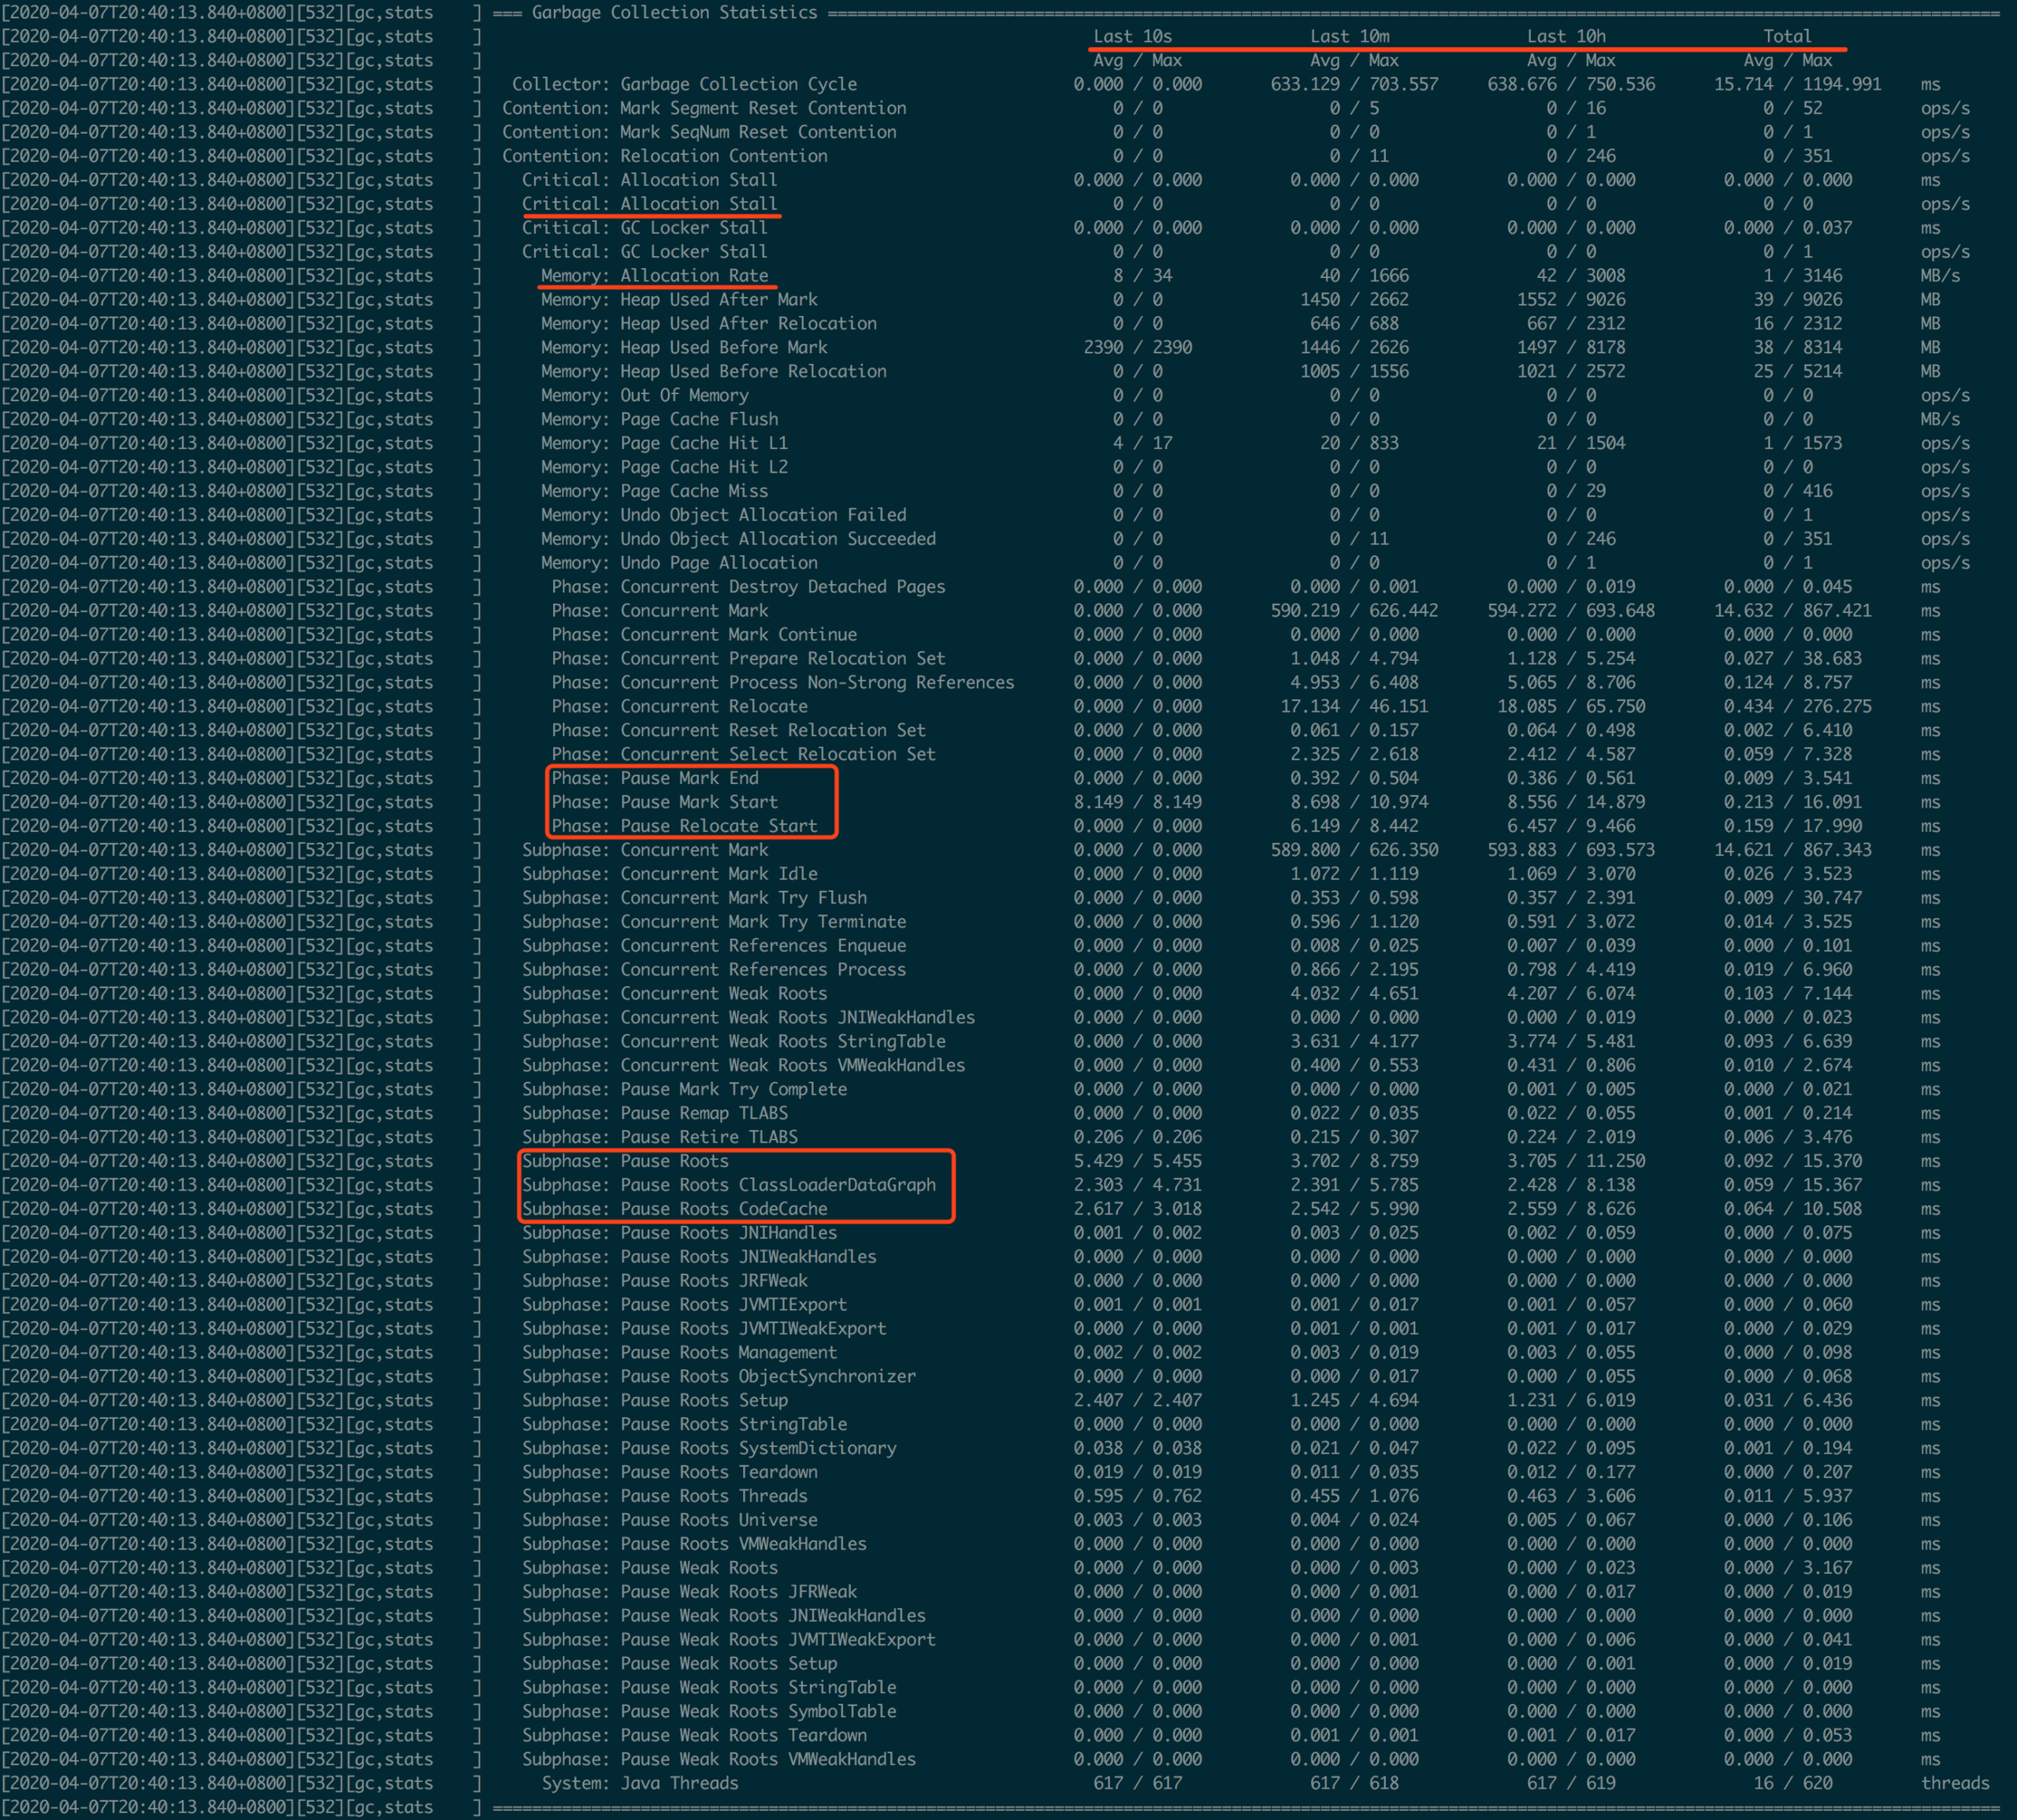
定期 GC 统计可比较最近 10 秒、10 分钟、10 小时与启动以来的情况。除此之外,还要看进入安全点的耗时:先到安全点的线程会等其他线程到齐。线程和堆转储也可能扰动应用,因此“所有延迟都是 GC 算法的问题”同样不成立。原文涉及 jstack、jmap 的观察,但没有把它们当成无成本监控;堆转储还可能包含令牌、个人数据或请求内容,必须按敏感文件管理。


案例一:流量突增,回收开始得太晚
Zeus 是用于风控规则管理的规则平台,通过开源 Aviator 表达式引擎执行规则。Aviator 会把表达式转成 Java 类。原服务有上万条规则,每台机器每天处理数百万请求;这使分配速率、类加载器和 JIT 代码规模都成为值得关注的变量。
秒杀活动开始时,GC 日志与业务日志在相同时间出现性能毛刺,并伴随大量 Allocation Stall。原因不是单次 Pause 特别长,而是自适应算法依据此前平稳流量计算的回收间隔过长,突发分配先用完了堆。
原团队采用两项措施:开启更短的定时回收间隔,例如把 ZCollectionInterval 调至 5 秒或更短;把 ZAllocationSpikeTolerance 从默认 2 提高到 5,让预测机制提前触发。这些是原环境中的处理方式。更早回收会增加工作量,需要与 CPU、吞吐、存活集和内存余量一起衡量,而不是把 5 秒和系数 5 当成通用最佳值。
案例二:GC 已经很频繁,但回收速度不足
另一轮压测中,流量逐渐增长,日志显示约每秒一次 GC,两次回收几乎没有间隙。此时继续提前触发并不能解决问题:回收本身追不上分配速度。
团队提高 ConcGCThreads,加快并发标记与回收。它会消耗更多 CPU,影响业务吞吐,所以原文不建议在两次 GC 之间仍有较大空隙时随意调高。部署前需要同时比较请求吞吐、各百分位延迟、GC 周期、CPU 限额和堆余量;在容器里,还要按进程可用 CPU 资源理解线程配置。
案例三:ClassLoader 数量让根扫描变慢
团队还遇到单次暂停约 30 ms,明显高于当时 10 ms 左右的预期。统计中 Pause Roots ClassLoaderDataGraph 较长,堆分析发现上万个 ClassLoader 实例。
继续追查类名和 Aviator 源码发现,旧版本每生成一个表达式类就创建一个 ClassLoader。与其先猜 JVM 参数,团队升级了已经修正该行为的 Aviator 版本,避免为每个表达式创建额外加载器。这个案例说明应用和库的对象组织方式可以扩大 GC 根相关工作量,收集器无法凭空消除它。
原文没有给出可跨所有 Aviator 使用方式保证正确的升级版本号,因此本文也不补造版本。升级仍应核对依赖变更与表达式语义兼容性。
案例四:运行越久,CodeCache 扫描越慢
另一个现象是服务运行时间越长,单次 GC 越慢,重启后暂时恢复。日志中 Pause Roots CodeCache 持续增长。团队用 -XX:+PrintCodeCacheOnCompilation 观察编译信息,发现大量 Aviator 表达式的方法随着调用次数增加进入 CodeCache。
因为一个表达式对应一个类中的方法,长期运行让更多方法成为热点并触发 JIT。团队评估了编译条件相关参数,但最终通过业务优化删除不再需要执行的表达式,减少不必要代码进入缓存。重点是减少实际无用工作,而不是简单压缩 CodeCache 容量;后者可能造成新的编译和性能问题。
收益与代价应放在同一张表里
原团队并不是等所有问题解决后才上线。按其报告,即使初期仍存在毛刺,ZGC 对可用性的影响已经小于原先 CMS。准备到全量部署约两周,之后又在三个月中逐项优化。
在 Zeus 不同集群里,原文报告低延迟场景(TP999 小于 200 ms)的收益较明显:TP999 降低 12–142 ms,降幅 18%–74%;TP99 降低 5–28 ms,降幅 10%–47%。TP999 表示覆盖 99.9% 请求的响应时间分位点,TP99 对应 99%。这些区间是原案例结果,本次没有复测。
原文还报告 TP999 小于 20 ms 的超低延迟服务,以及超过 200 ms 的高延迟服务,收益不明显,因为这些服务主要受外部依赖影响。这不是某个延迟区间天然不适合 ZGC,而是它们当时的主要瓶颈不在 GC。
一个离线集群从 CMS 改用早期 ZGC 后吞吐明显下降。原作者归因于当时 ZGC 非分代、每轮处理对象较多,以及读屏障带来计算成本。这里的“非分代”必须保留历史限定;不能用它评价已改为分代的现代 ZGC。选型时也不能只报延迟下降、不报吞吐和内存成本。
升级经验:把风险转成可验证的问题
原文附录建议先判断新技术是否解决了已有瓶颈,再估计收益、人力成本和风险。风险分为三类:依赖能否在新 JDK 上启动的兼容性风险,组件行为是否变化的功能风险,以及持续运行的性能风险。单测、集成测试、回归与压力测试分别提供证据;这些措施减少不确定性,但不能把有限测试说成“风险已经完全消除”。
美团当时从 JDK 7 升到 JDK 11,项目约二十多万行代码,报告用两天解决主要兼容性问题。编译阶段根据报错修改构建配置,替换已经不可用的内部 API,例如以 java.util.Base64 代替 sun.misc.BASE64Encoder;更新不兼容依赖后,再检查运行时问题。
原文列出的依赖改动在此作为历史记录保留,不作为今天的安装建议:
| groupId:artifactId | 原文版本 |
|---|---|
| javax.annotation:javax.annotation-api | 1.3.2 |
| javax.validation:validation-api | 2.0.1.Final |
| org.projectlombok:lombok | 1.18.4 |
| org.hibernate.validator:hibernate-validator-parent | 6.0.16.Final |
| com.sankuai.inf:patriot-sdk | 1.2.1(美团内部依赖) |
| org.apache.commons:commons-lang3 | 3.9 |
| commons-lang:commons-lang | 2.6 |
| io.netty:netty-all | 4.1.39.Final |
| junit:junit | 4.12 |
这些是旧版本,并未在本次做漏洞数据库或依赖供应链核查。hibernate-validator-parent 是原文给出的父项目坐标,不能未经项目核对就当成应用所需的运行库依赖;本文因此用表格保留记录,没有输出可直接粘贴的整套 POM。内部组件若不兼容,原文建议推动维护者升级;短期无法完成时可评估拆分相关功能,但这会引入新的部署和通信成本。
部署准备覆盖编译、打包、发布、运行、监控和性能诊断全链路。当时团队讨论了新建已装 JDK 11 的虚拟机、为存量机器写安装脚本和在容器镜像中安装 JDK 三种路径,倾向通过镜像管理运行环境。监控由 CAT 支持 ZGC 指标,性能分析使用内部 Scalpel,并提到商业工具 JProfiler。本文保留工具归属,不声称读者现有版本已经支持相同能力。
原文关于 JDK 11 在 macOS 上不支持 ZGC、Oracle/OpenJDK 的维护期限与免费范围,都属于 2020 年的产品条件。当前部署应查具体发行商、更新版本、平台和许可,不再照抄当年的下载与付费判断。回滚方案也要同时覆盖 JDK、依赖、配置和部署镜像。
作者、参考资料与整理说明
原文署名:王东(当时为美团信息安全资深工程师)、王伟(当时为美团信息安全技术专家)。参考资料包括 OpenJDK ZGC 项目,彭成寒《新一代垃圾回收器 ZGC 设计与实现》(机械工业出版社,2019),以及原文链接的《从实际案例聊聊 Java 应用的 GC 优化》《Java Hotspot G1 GC 的一些关键技术》。
本文版权归属与原作者署名保留,经授权整理。未将美团文章宣称为开放许可。整理改动包括章节重组、历史版本提示、算术订正、参数语义澄清、敏感转储和性能结论边界;诊断路径图为未完纪原创,五张日志图来自原文并保留作者归属与原始内容。对示例做了静态检查,未发现硬编码秘密或代码注入入口,但这不等于对相关 JVM、依赖或生产系统作出无漏洞保证。









暂无评论内容