


原作:Litestream 官方文档贡献者,Directory Watcher。本文根据 2026 年 10 月 5 日读取的完整指南译编。目录监视功能要求 Litestream 0.5.4 或更新版本,并依赖平台的 fsnotify 支持;本次未安装 Litestream、访问对象存储或运行恢复命令。
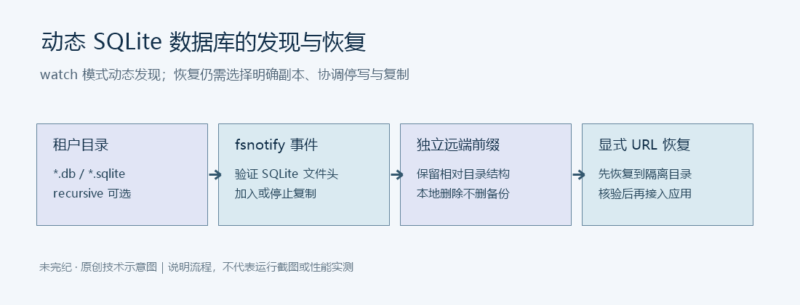
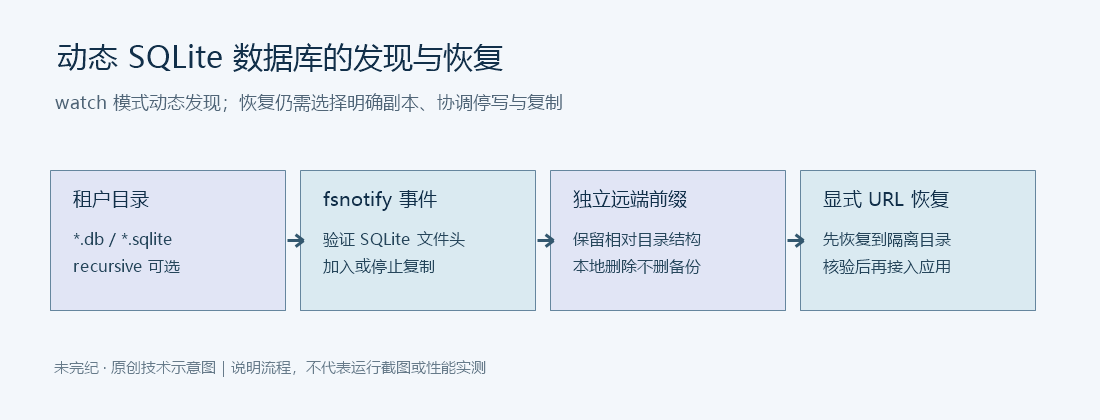
多租户应用经常为每个租户创建一个 SQLite 数据库。租户随时加入或退出时,逐库修改复制配置容易遗漏。Litestream 提供两种目录模式:静态目录复制只在启动时扫描,新数据库需要重启才能被纳入;目录监视器持续观察文件系统事件,在匹配的新数据库出现后自动启动复制,也能停止已删除数据库的复制任务。
这种机制适合每租户一库的 SaaS、按需创建数据库的服务,以及短时间内大量创建数据库的场景。自动发现减少配置维护工作,但并不替代权限隔离、备份保留策略或恢复演练。
开启目录监视
在目录配置中加入 watch: true:
dbs:
  - dir: /var/lib/app/tenants
    pattern: "*.db"
    watch: true
    replica:
      type: s3
      bucket: my-backup-bucket
      path: tenants
| 字段 | 含义 | 默认值 |
|---|---|---|
| dir | 要监视的目录 | 必填 |
| pattern | 数据库文件的 glob 模式 | 必填 |
| recursive | 是否监视子目录 | false |
| watch | 是否启用实时发现 | false |
pattern 使用 glob,而不是正则表达式。*.db 匹配 .db 结尾的文件,*.sqlite 匹配 .sqlite 结尾的文件;tenant-*.db 可匹配 tenant-001.db、tenant-abc.db。字段可匹配文件名,并不意味着匹配到的每个文件都会被无条件当成数据库。
平面目录、嵌套租户与多种规则
全部数据库放在同一目录
dbs:
  - dir: /var/lib/app/databases
    pattern: "*.db"
    watch: true
    replica:
      url: s3://mybucket/databases
本地目录形如:
/var/lib/app/databases/
├── tenant-001.db
├── tenant-002.db
└── tenant-003.db
每个数据库得到独立副本前缀:
s3://mybucket/databases/
├── tenant-001.db/
├── tenant-002.db/
└── tenant-003.db/
每个租户有自己的子目录
将 recursive 设置为 true:
dbs:
  - dir: /var/lib/app/tenants
    pattern: "*.db"
    recursive: true
    watch: true
    replica:
      url: s3://mybucket/tenants
本地结构:
/var/lib/app/tenants/
├── acme-corp/
│   └── data.db
├── globex/
│   └── data.db
└── initech/
    └── data.db
远端保留相对于监视根目录的路径,因此不同租户的 data.db 不会仅因同名而合并:
s3://mybucket/tenants/
├── acme-corp/data.db/
├── globex/data.db/
└── initech/data.db/
多种数据库或不同复制频率
为不同目录和后缀分别建立条目,可各自配置副本目标与同步间隔:
dbs:
  - dir: /var/lib/app/tenants
    pattern: "*.db"
    watch: true
    replica:
      url: s3://mybucket/primary
      sync-interval: 1s

  - dir: /var/lib/app/analytics
    pattern: "*.sqlite"
    watch: true
    replica:
      url: s3://mybucket/analytics
      sync-interval: 10s
这里主业务数据库使用 1 秒同步间隔,分析库使用 10 秒。配置示例中的 bucket 和路径必须换成自己的目标;同步间隔也不能直接当作端到端恢复点目标,因为网络、存储、调度和失败重试都会影响实际进度。
新建、删除与重启时会发生什么
新文件创建后,监视器先检查是否匹配 pattern,再验证 SQLite 数据库标头;通过后通常在数秒内开始复制,并在日志和指标中出现。不合法的文件被忽略,避免把普通文件误当成数据库。文件头验证不是数据库全量一致性检查。
删除本地数据库时,监视器停止该库复制并释放资源,远端副本仍然保留。递归模式下删除整个子目录,也只会停止其中各库并清理监视,不删除远端数据。应结合对象存储生命周期规则安排过期清理;租户注销、合规删除和恢复保留策略要明确区分。
Litestream 重启后会先扫描已有数据库,为匹配项启动复制,然后重新进入目录监视。曾经复制过但本地已不存在的数据库,不会在重启时被自动从对象存储清理。
按明确副本 URL 恢复
watch 模式没有在配置文件中逐一声明每个数据库,因此通常的 litestream restore <db-path> 无法按该本地路径找到对应定义。恢复时直接提供远端副本 URL:
litestream restore -o /path/to/database.sqlite s3://mybucket/databases/database.sqlite
若副本需要访问凭据,原文展示以下环境变量配置。其中 your-access-key 和 your-secret-key 只是示意占位值,不是真实凭据;切勿把实际密钥写进文章、源码或可留存的 shell 历史。部署时通过受控的凭据注入方式提供,并使用所需存储范围内的最小权限。
export LITESTREAM_ACCESS_KEY_ID=your-access-key
export LITESTREAM_SECRET_ACCESS_KEY=your-secret-key

litestream restore -o /var/lib/app/databases/tenant-001.db \
  s3://mybucket/databases/tenant-001.db
| 布局 | 本地数据库 | 对应副本 URL |
|---|---|---|
| 平面,url=s3://mybucket/databases | /var/lib/app/databases/tenant-001.db | s3://mybucket/databases/tenant-001.db |
| 递归,url=s3://mybucket/tenants | /var/lib/app/tenants/acme/data.db | s3://mybucket/tenants/acme/data.db |
编辑补充:原命令直接把结果写入应用监视目录。实际恢复先安排应用停写与复制协调,选一个不被 watch 的临时恢复目录,验证目标路径不存在或已按流程备份,恢复并校验后再切换。这样可减少尚未完成的恢复文件被监视器自动发现的风险。这里给出的是操作边界,未代替读者执行生产切换。
先列出可用的远端库
原文分别给出 S3、GCS 和 Azure 的列表命令:
# For S3
aws s3 ls s3://mybucket/databases/

# For GCS
gsutil ls gs://mybucket/databases/

# For Azure Blob Storage
az storage blob list --container-name mycontainer --prefix databases/
批量恢复:原脚本的限制
Litestream 没有一个内建命令能恢复目录内所有库。原文用 shell 遍历副本目录:
#!/bin/bash
export LITESTREAM_ACCESS_KEY_ID=your-access-key
export LITESTREAM_SECRET_ACCESS_KEY=your-secret-key

# List and restore all databases from S3
for db in $(aws s3 ls s3://mybucket/databases/ | awk '{print $2}' | sed 's/\/$//'); do
  echo "Restoring $db..."
  litestream restore -o "/var/lib/app/databases/$db" "s3://mybucket/databases/$db"
done
静态审核发现:for db in $(...) 依赖 shell 按空白拆词,awk 又假设固定列。它只适用于经过控制的简单平面名称,不能可靠处理含空格的键、嵌套租户目录或特殊字符。它还会直接写入监视目录,没有逐项验证输出路径与覆盖条件。代码中的访问密钥示意也不应替换成硬编码生产秘密。
不要把这个简短循环直接作为通用批量恢复器。修订方向是使用提供方结构化 JSON 列表、正确遍历分页与相对路径、拒绝绝对路径和 .. 路径穿越,解析规范化后的目标必须仍在隔离恢复根目录内;每项恢复前检查目标冲突,分别记录成功和失败,再安排切换。本文保留原文示例以说明机制,没有伪造一份经过测试的修复脚本。
恢复到指定时间点
同样使用明确副本 URL,并给出 timestamp:
litestream restore \
  -timestamp 2026-01-01T12:00:00Z \
  -o /var/lib/app/databases/tenant-001.db \
  s3://mybucket/databases/tenant-001.db
时间采用示例中的 UTC 格式。可恢复时间范围取决于远端实际保留的数据与可用恢复链,写一个时间戳并不保证那个时间点存在。
静态复制与监视模式对比
| 行为 | watch: false | watch: true |
|---|---|---|
| 发现新库 | 需要重启 | 自动 |
| 发现删除 | 需要重启 | 自动 |
| 启动时目录为空 | 报错 | 允许 |
| 资源消耗 | 较低 | 略高 |
| 适用场景 | 固定数据库集合 | 动态创建数据库 |
排查未发现的数据库
日志可出现如下消息;这是原文示例,不是本次环境日志:
INFO added database to replication path=/var/lib/app/tenants/tenant-001.db
若没有出现,依次检查:后缀与 glob 是否匹配;dir 是否正确且可访问;嵌套布局是否开启 recursive;文件是否是具有合法 SQLite 标头的数据库,而不是空文件或损坏文件。Permission denied 要核对运行账户的目录与数据库访问权限,不应通过对整个目录开放写权限来掩盖问题。
性能和平台限制
监视器使用 fsnotify 事件而非轮询,只校验符合模式的文件,并只读取文件头做 SQLite 识别,因此原文认为额外开销较小。作者称测试过超过 20 个并发创建数据库的场景;这只是原文测试范围,不是容量上限,也不是本次复测结果。
watch 必须与 dir 一起使用,不能加到单库 path 配置上;pattern 不是正则表达式;并非每个平台都提供需要的 fsnotify 支持。继续阅读可参考 目录复制、配置参考及故障排查,实际入口以原页链接为准。
来源与归属:Litestream 官方文档贡献者;中文译编:未完纪编辑部。阅读原文。全文翻译、转载及配图按权利人授权使用;原作者及项目归属保留。











暂无评论内容