


本文译自 Confluent Developer 的 How to join on a foreign key in Kafka Streams。原文无个人署名,作者归于 Confluent Developer 文档贡献者。本文保留云端与 Docker 两条完整操作路线,并以编者注说明源码与页面之间的差异。
为什么需要外键关联
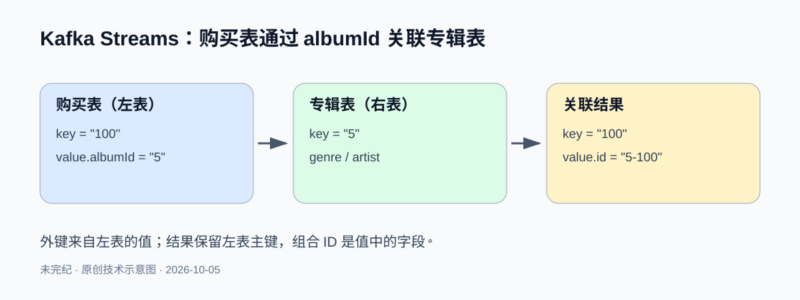
假设你经营一个在线音乐流媒体服务,既销售整张专辑,也销售单首歌曲。为了分析听众偏好的变化,你希望把歌曲购买记录与专辑表关联起来。购买记录的键并不对应专辑表的主键,但购买记录的值中包含专辑 ID。提取这个 ID,就能用它与专辑表进行外键关联。
final KTable<String, Album> albums = builder.table(ALBUM_TOPIC, Consumed.with(stringSerde, albumSerde));

final KTable<String, TrackPurchase> trackPurchases = builder.table(USER_TRACK_PURCHASE_TOPIC, Consumed.with(stringSerde, trackPurchaseSerde));

final MusicInterestJoiner trackJoiner = new MusicInterestJoiner();

final KTable<String, MusicInterest> musicInterestTable = trackPurchases.join(albums,
                                                                           TrackPurchase::albumId,
                                                                           trackJoiner);
这里使用的是接收外键提取函数的 KTable.join 重载。trackPurchases 是左表,albums 是右表;TrackPurchase::albumId 从左表购买记录的值中取出专辑 ID,再与右表的键匹配。MusicInterestJoiner 负责组合匹配到的值。完整 API 见 KTable 文档。
编者修正:原网页片段写的是 KTable<Long, ...> 和 longSerde,但终端示例发送的是字符串键。核对 配套工程源码 后,本文统一为实际工程使用的 String 与 stringSerde;外键取自左表而不是右表。上面是拓扑片段,需放在完整工程提供的 builder、Serde 和领域类型上下文中使用。
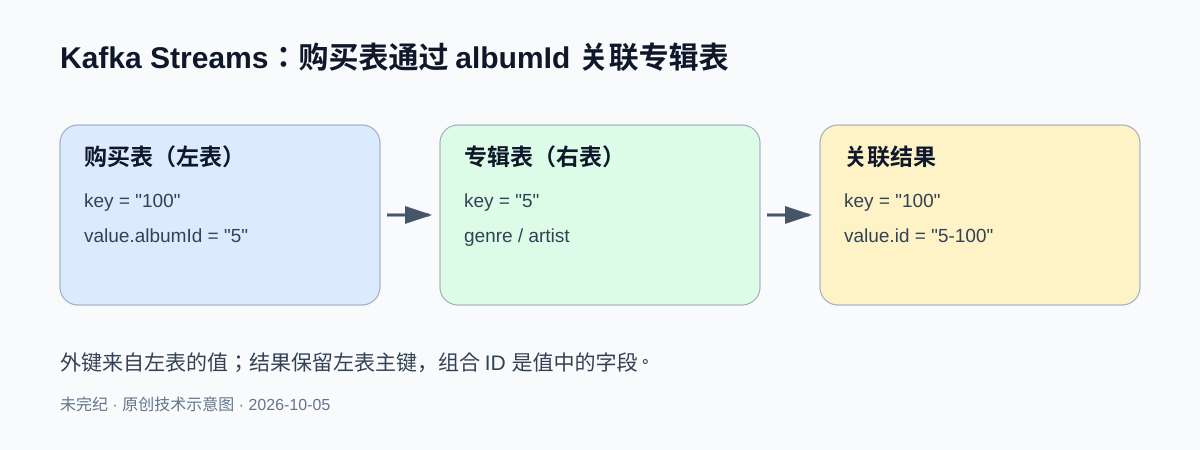
适用边界:KTable 表示每个键的最新状态,不是保留全部事件历史的无限追加表,也不是按时间窗口匹配两个事件流。示例把购买 ID 作为左表键。若业务需要处理外键变更、墓碑删除、未匹配记录或重复事件,应针对自己的语义另行测试,并保留需要的状态目录和 Kafka 内部主题。
路线一:在 Confluent Cloud 运行
准备环境
- 一个 Confluent Cloud 账户。
- 本机已安装 Confluent CLI。
- 按原文准备 Apache Kafka 或 Confluent Platform,它们均包含 Kafka Streams 应用重置工具。
- 克隆 confluentinc/tutorials 仓库,进入其顶层目录。
git clone git@github.com:confluentinc/tutorials.git
cd tutorials版本与工程说明:截至本次核验,配套 fk-joins/kstreams/build.gradle 要求 Java 17,依赖 Kafka Streams / Kafka clients 4.3.1,并使用 Shadow 插件 8.1.1。仓库是滚动更新的;应保存自己使用的 commit,并使用工程自带 Gradle Wrapper,避免混用其他版本的片段。以下多行命令按原文使用 POSIX shell 语法。SSH 克隆需要已配置 GitHub SSH 访问;也可从同一官方仓库使用 HTTPS 克隆。
创建云端资源
登录 Confluent Cloud:
confluent login --prompt --save安装用于简化资源创建的 CLI 插件:
confluent plugin install confluent-quickstart在 tutorials 仓库顶层运行插件,创建本教程所需的资源。可改选 gcp 或 azure 等云提供商及相应地域;用 confluent kafka region list --cloud <CLOUD> 查看指定提供商支持的地域。
confluent quickstart \
  --environment-name kafka-streams-table-table-join-env \
  --kafka-cluster-name kafka-streams-table-table-join-cluster \
  --create-kafka-key \
  --kafka-java-properties-file ./fk-joins/kstreams/src/main/resources/cloud.properties
原文预计该插件在一分钟以内完成;这只是教程中的耗时预期,不是性能或可用性保证。命令会创建云资源和 Kafka API 密钥,可能产生费用。生成的 cloud.properties 包含客户端访问配置,应作为凭据保护,避免提交到公开仓库。
创建主题并写入数据
为应用创建两个输入主题和一个输出主题:
confluent kafka topic create album-input
confluent kafka topic create track-purchase
confluent kafka topic create music-interest
启动专辑主题的控制台生产者。冒号左边是消息键,右边是 JSON 值:
confluent kafka topic produce album-input --parse-key --delimiter :逐行输入以下专辑数据:
5:{"id":"5", "title":"Physical Graffiti", "genre":"Rock", "artist":"Led Zeppelin"}
6:{"id":"6", "title":"Highway to Hell", "genre":"Rock", "artist":"AC/DC"}
7:{"id":"7", "title":"Radio", "genre":"Hip hop", "artist":"LL Cool J"}
8:{"id":"8", "title":"King of Rock", "genre":"Rap rock", "artist":"Run-D.M.C"}
按 Ctrl+C 退出该生产者。接着为歌曲购买记录启动另一个生产者:
confluent kafka topic produce track-purchase --parse-key --delimiter :逐行输入以下购买记录:
100:{"id":"100", "songTitle":"Houses Of The Holy", "albumId":"5", "price":0.99}
101:{"id":"101", "songTitle":"King Of Rock", "albumId":"8", "price":0.99}
102:{"id":"102", "songTitle":"Shot Down In Flames", "albumId":"6", "price":0.99}
103:{"id":"103", "songTitle":"Rock The Bells", "albumId":"7", "price":0.99}
104:{"id":"104", "songTitle":"Can You Rock It Like This", "albumId":"8", "price":0.99}
105:{"id":"105", "songTitle":"Highway To Hell", "albumId":"6", "price":0.99}
输入完毕后按 Ctrl+C 退出。
编译、启动和检查结果
从 tutorials 仓库顶层编译应用:
./gradlew fk-joins:kstreams:shadowJar进入应用目录:
cd fk-joins/kstreams启动应用,传入此前创建云资源时生成的 Kafka 客户端配置文件:
java -cp ./build/libs/fkjoins-standalone.jar \
    io.confluent.developer.FkJoinTableToTable \
    ./src/main/resources/cloud.properties
消费 music-interest 主题,检查是否出现关联后的记录:
confluent kafka topic consume music-interest -b原文给出的预期输出如下;记录的显示顺序不应视为跨分区排序保证。这里的 id 是结果值里的组合 ID,而不是 Kafka 消息的键。
{"id":"5-100","genre":"Rock","artist":"Led Zeppelin"}
{"id":"8-101","genre":"Rap rock","artist":"Run-D.M.C"}
{"id":"6-102","genre":"Rock","artist":"AC/DC"}
{"id":"7-103","genre":"Hip hop","artist":"LL Cool J"}
{"id":"8-104","genre":"Rap rock","artist":"Run-D.M.C"}
{"id":"6-105","genre":"Rock","artist":"AC/DC"}
清理云端实验资源
完成实验后,先列出环境并找出 kafka-streams-table-table-join-env 对应的 env-123456 形式的环境 ID:
confluent environment list删除操作:下列命令会删除该环境及其中的全部资源。仅在核对环境 ID、确认这是本教程专用实验环境后执行;不要把共享或生产环境的 ID 填入占位符。
confluent environment delete <ENVIRONMENT ID>路线二:在本地 Docker 运行
准备环境
- 已运行 Docker Desktop 或 Docker Engine。
- 已安装 Docker Compose,且
docker compose version能成功返回。 - 本机具备上述 Java 17 与工程构建条件。
- 克隆官方仓库并进入顶层目录;已经克隆过则复用同一份工程。
git clone git@github.com:confluentinc/tutorials.git
cd tutorials
启动 Kafka
从 tutorials 仓库顶层执行:
docker compose -f ./docker/docker-compose-kafka.yml up -d打开 broker 容器中的 shell:
docker exec -it broker /bin/bash创建主题并写入专辑和购买记录
在 broker 容器中创建输入、输出主题:
kafka-topics --bootstrap-server localhost:9092 --create --topic album-input
kafka-topics --bootstrap-server localhost:9092 --create --topic track-purchase
kafka-topics --bootstrap-server localhost:9092 --create --topic music-interest
启动专辑控制台生产者,显式启用键解析并把冒号作为分隔符:
kafka-console-producer --bootstrap-server localhost:9092 --topic album-input \
    --reader-property "parse.key=true" --reader-property "key.separator=:"
逐行输入以下数据:
5:{"id":"5", "title":"Physical Graffiti", "genre":"Rock", "artist":"Led Zeppelin"}
6:{"id":"6", "title":"Highway to Hell", "genre":"Rock", "artist":"AC/DC"}
7:{"id":"7", "title":"Radio", "genre":"Hip hop", "artist":"LL Cool J"}
8:{"id":"8", "title":"King of Rock", "genre":"Rap rock", "artist":"Run-D.M.C"}
按 Ctrl+C 退出。再启动购买主题的生产者:
kafka-console-producer --bootstrap-server localhost:9092 --topic track-purchase \
    --reader-property "parse.key=true" --reader-property "key.separator=:"
逐行输入购买记录:
100:{"id":"100", "songTitle":"Houses Of The Holy", "albumId":"5", "price":0.99}
101:{"id":"101", "songTitle":"King Of Rock", "albumId":"8", "price":0.99}
102:{"id":"102", "songTitle":"Shot Down In Flames", "albumId":"6", "price":0.99}
103:{"id":"103", "songTitle":"Rock The Bells", "albumId":"7", "price":0.99}
104:{"id":"104", "songTitle":"Can You Rock It Like This", "albumId":"8", "price":0.99}
105:{"id":"105", "songTitle":"Highway To Hell", "albumId":"6", "price":0.99}
按 Ctrl+C 退出。
编译、启动和检查结果
回到本机终端,在 tutorials 顶层编译应用:
./gradlew fk-joins:kstreams:shadowJar进入应用目录:
cd fk-joins/kstreams启动应用并传入 local.properties。该 Kafka 客户端配置指向本地 broker 的 localhost:9092 bootstrap servers 端点:
java -cp ./build/libs/fkjoins-standalone.jar \
    io.confluent.developer.FkJoinTableToTable \
    ./src/main/resources/local.properties
在 broker 容器的 shell 中消费输出主题:
kafka-console-consumer --bootstrap-server localhost:9092 --topic music-interest --from-beginning原文给出的预期输出是:
{"id":"5-100","genre":"Rock","artist":"Led Zeppelin"}
{"id":"8-101","genre":"Rap rock","artist":"Run-D.M.C"}
{"id":"6-102","genre":"Rock","artist":"AC/DC"}
{"id":"7-103","genre":"Hip hop","artist":"LL Cool J"}
{"id":"8-104","genre":"Rap rock","artist":"Run-D.M.C"}
{"id":"6-105","genre":"Rock","artist":"AC/DC"}
停止本地实验
在本机终端从仓库顶层停止 broker 容器:
docker compose -f ./docker/docker-compose-kafka.yml down该命令停止并移除此 Compose 工程的容器和相关网络;它不是生产环境的数据保留方案。需要留存的实验数据应按实际 Compose 卷配置另行确认。
投入实际项目之前
编者静态审查:完整工程在启动前调用 kafkaStreams.cleanUp(),源码注释明确只供本地演示,因为它会清空本地状态。不要原样移入生产启动流程。源码还用日志打印关联键和值,若替换成真实购买或用户数据,应调整日志内容、访问权限和保留策略。云凭据文件、主题权限及内部状态主题需要按部署环境管理。
本稿核对了完整教程、配套 Java 拓扑和构建文件,但没有运行 Docker、Gradle、Kafka 或任何云命令。所有结果块都来自原文,未被标记为本次实测;外键更新、删除、恢复、重平衡和故障语义仍需要业务测试。
对原教程有问题或建议,可前往其链接的 Confluent 社区 Slack 的 #developer-confluent-io 频道参与讨论。
来源及版权:Copyright © Confluent, Inc. 2014–2026。本文经授权译编,技术修正及原创示意图已注明。Apache、Apache Kafka、Kafka、Apache Flink、Flink、Apache Iceberg 等项目名称为 Apache Software Foundation 的商标;未把网页或示例代码另行宣称为某种未经确认的开放许可证。











暂无评论内容