


本文译编自 Apache Druid 官方教程 Approximations with Theta sketches。原页未署个人作者,维护与发布方为 Apache Software Foundation;文末明确说明教程改编自社区成员 Hellmar Becker 的文章,本文保留该致谢、全部示例及原图。
为什么去重计数不能直接相加
Apache Druid 可以支持点击流数据的实时采集、流式处理和交互式可视化。点击流分析常见的一类问题,是统计不重复的访客或会话。通常需要扫描明细数据,因为随着聚合层级变化,去重数量不能简单相加。
假设你想知道一部电视剧的观看人数:某一天有 1000 名不同观众看了第一集,有 800 名不同观众看了第二集。接着可能还想问:
- 多少人两集都看了?
- 多少人至少看过其中一集?
- 多少人只看了第一集,没有看第二集?
仅凭 1000 和 800 两个聚合结果,无法回答这些问题。你得回到明细逐行扫描。当数据量足够大时,这可能耗时很长,使交互式探索变得困难。去重计数与预聚合 rollup 配合也不直接:理想情况下,每个 15 分钟时间段、节目、集数只保留一行,而你关心的是去重数量,并不需要在这张分析表里保留每个用户 ID。有没有办法既不反复处理全部明细,又能使用 rollup?Theta sketch 就是一个选择。
用 Theta sketch 进行快速近似集合分析
Theta sketch 是一种概率数据结构,可以快速估计构建摘要时所使用值的去重数量,并具有已知的误差分布。Druid 的实现依赖 Apache DataSketches。
- 可合并:可以先处理 rollup 后的数据,再把不同时间段的摘要合并,从而利用 Druid 的预聚合能力。
- 支持集合运算:对于两个数据子集的 Theta sketch,可以计算并集、交集和差集。这能回答哪些观众看过某种节目组合、哪些人群彼此重叠等问题。
本教程将完成两件事:在入库时从输入数据构建 Theta sketch;再对这些摘要执行去重计数和集合运算查询,回答前面的问题。
准备环境
先按照 Druid 单机快速入门 下载并在本机启动 Druid。本教程不要求预先向集群装入数据;先完成“加载文件”和“查询数据”教程会更容易跟上。
编者补充:需要可执行 SQL 入库任务的本地环境。按 Theta 扩展说明 确认扩展加载列表包含 druid-datasketches;若已有其他扩展,不要用只含一个扩展的示例覆盖整个列表。本文以读取时的 latest 文档为准,没有在本机启动 Druid 或核验特定安装的配置。
示例数据
数据有四列:date 是时间戳(示例只用日期,实际业务往往需要更细粒度);uid 是用户 ID;show 是节目名称;episode 是集数标识。以下保留原文完整的 19 条数据和表头,其中重复观看记录也是示例的一部分。
date,uid,show,episode
2022-05-19,alice,Game of Thrones,S1E1
2022-05-19,alice,Game of Thrones,S1E2
2022-05-19,alice,Game of Thrones,S1E1
2022-05-19,bob,Bridgerton,S1E1
2022-05-20,alice,Game of Thrones,S1E1
2022-05-20,carol,Bridgerton,S1E2
2022-05-20,dan,Bridgerton,S1E1
2022-05-21,alice,Game of Thrones,S1E1
2022-05-21,carol,Bridgerton,S1E1
2022-05-21,erin,Game of Thrones,S1E1
2022-05-21,alice,Bridgerton,S1E1
2022-05-22,bob,Game of Thrones,S1E1
2022-05-22,bob,Bridgerton,S1E1
2022-05-22,carol,Bridgerton,S1E2
2022-05-22,bob,Bridgerton,S1E1
2022-05-22,erin,Game of Thrones,S1E1
2022-05-22,erin,Bridgerton,S1E2
2022-05-23,erin,Game of Thrones,S1E1
2022-05-23,alice,Game of Thrones,S1E1
在入库时构建 Theta sketch
在 Druid Web 控制台进入 Query 视图,使用 INSERT INTO 与 EXTERN 将上述 CSV 作为内联数据导入:
INSERT INTO "ts_tutorial"
WITH "source" AS (SELECT * FROM TABLE(
  EXTERN(
    '{"type":"inline","data":"date,uid,show,episode\n2022-05-19,alice,Game of Thrones,S1E1\n2022-05-19,alice,Game of Thrones,S1E2\n2022-05-19,alice,Game of Thrones,S1E1\n2022-05-19,bob,Bridgerton,S1E1\n2022-05-20,alice,Game of Thrones,S1E1\n2022-05-20,carol,Bridgerton,S1E2\n2022-05-20,dan,Bridgerton,S1E1\n2022-05-21,alice,Game of Thrones,S1E1\n2022-05-21,carol,Bridgerton,S1E1\n2022-05-21,erin,Game of Thrones,S1E1\n2022-05-21,alice,Bridgerton,S1E1\n2022-05-22,bob,Game of Thrones,S1E1\n2022-05-22,bob,Bridgerton,S1E1\n2022-05-22,carol,Bridgerton,S1E2\n2022-05-22,bob,Bridgerton,S1E1\n2022-05-22,erin,Game of Thrones,S1E1\n2022-05-22,erin,Bridgerton,S1E2\n2022-05-23,erin,Game of Thrones,S1E1\n2022-05-23,alice,Game of Thrones,S1E1"}',
    '{"type":"csv","findColumnsFromHeader":true}'
  )
) EXTEND ("date" VARCHAR, "show" VARCHAR, "episode" VARCHAR, "uid" VARCHAR))
SELECT
  TIME_FLOOR(TIME_PARSE("date"), 'P1D') AS "__time",
  "show",
  "episode",
  COUNT(*) AS "count",
  DS_THETA("uid") AS "theta_uid"
FROM "source"
GROUP BY 1, 2, 3
PARTITIONED BY DAY
SELECT 中的 DS_THETA("uid") AS "theta_uid" 在入库时对 uid 建立 thetaSketch 聚合。这个分析场景关心的是不重复的人数,因此输出里不再保留单个 uid,而是保留它们的摘要。DS_THETA 还有一个可选的第二参数,用于控制摘要的大小和精度。
GROUP BY 1, 2, 3 把同一天、同一节目、同一集的观看记录聚合起来;TIME_FLOOR(..., 'P1D') 形成按日的时间桶,PARTITIONED BY DAY 则声明按日分区。count 保存记录数,theta_uid 保存用户集合的摘要,这两者不是同一种计数。
编者说明:这条 SQL 会向 ts_tutorial 写入数据,是入库操作而非只读查询。请使用教程专用数据源;重复执行 INSERT INTO 会追加数据,不能把它当成自动覆盖或幂等初始化。重复值可能在 sketch 的去重计算中合并,但 count 等指标仍可能受重复导入影响。
查询 Theta sketch 列
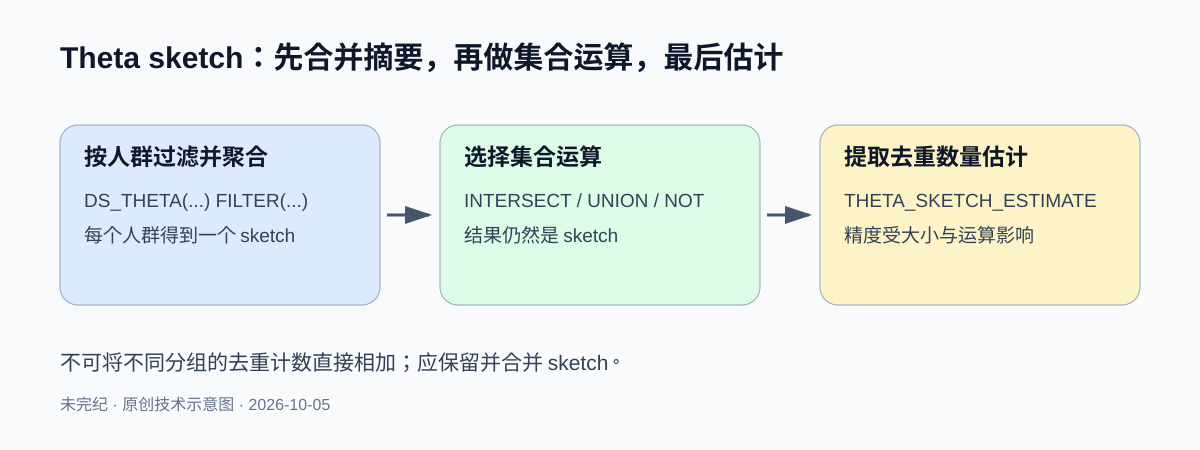
从一列 Theta sketch 求去重数量估计,通常分两步:先用 Druid SQL 聚合函数 DS_THETA 合并相关行的摘要,再用 THETA_SKETCH_ESTIMATE 取得合并后摘要的估计值。后面要介绍的集合函数,放在这两步之间。
基本计数
先在查询编辑器查看表的内容:
SELECT * FROM ts_tutorial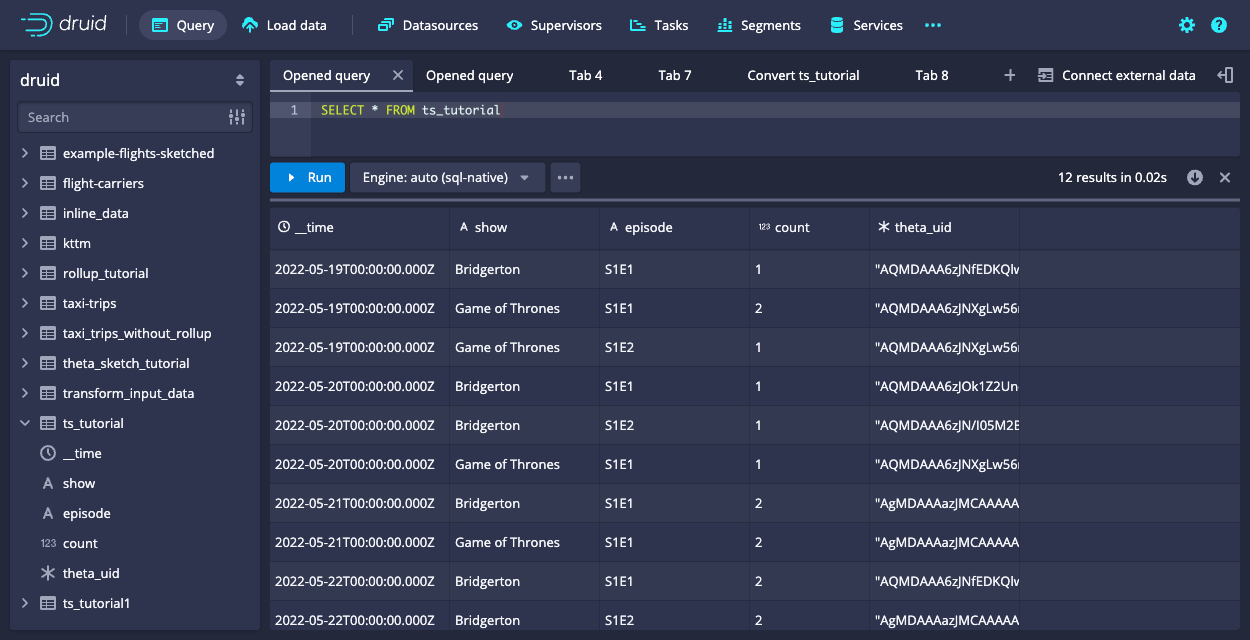
theta_uid 在界面上显示为 Base64 编码字符串。原文把其背后的表示称作“bitmap”;使用时更准确的理解是序列化的 Theta sketch 对象,而不是原始用户列表,也不应假定它是能无损恢复所有用户 ID 的普通位图。
下列查询把每一行已存的 sketch 转成该行对应日期、节目和集数的用户数量估计:
SELECT
  __time,
  "show",
  "episode",
  THETA_SKETCH_ESTIMATE(theta_uid) AS users
FROM ts_tutorial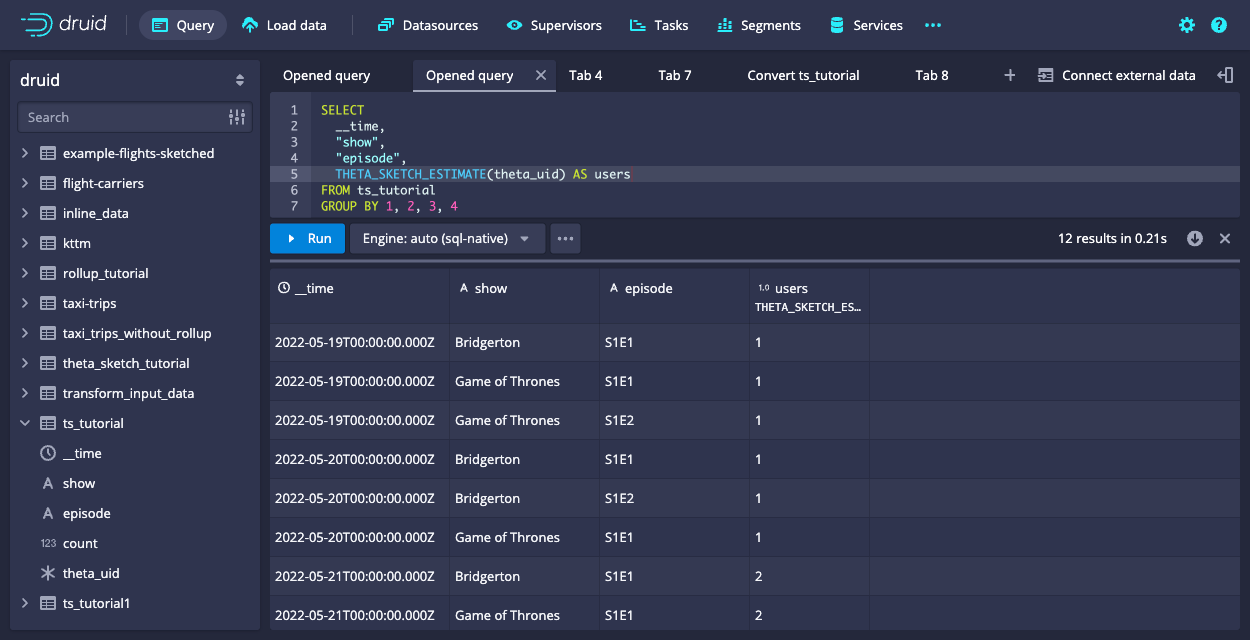
编者澄清:上方网页代码本身没有 GROUP BY,也没有跨行的 DS_THETA 聚合;它直接估计每一行的摘要。官方截图额外按所选表达式分组,也不能被理解为使用 DS_THETA 合并了跨时间的摘要。若要跨日期或跨分组汇总,应像下面的查询那样先合并摘要,不能把这些行的去重数相加。
给聚合添加过滤条件
Druid 支持过滤指标,即在 SELECT 中为聚合附加 FILTER(WHERE ...)。对于 Theta sketch,过滤应放在聚合器与最终估计器之间。以下查询统计看过 Bridgerton 的全部不同观众:
SELECT APPROX_COUNT_DISTINCT_DS_THETA(theta_uid) FILTER(WHERE "show" = 'Bridgerton') AS users
FROM ts_tutorial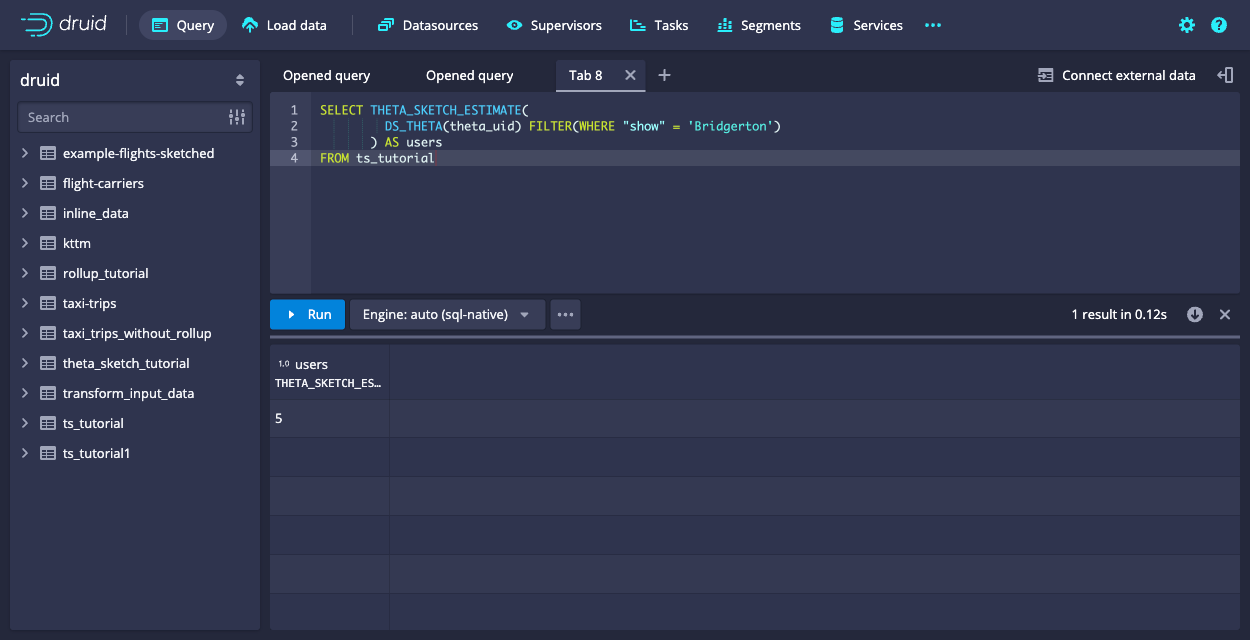
APPROX_COUNT_DISTINCT_DS_THETA 相当于先调用 DS_THETA,再调用 THETA_SKETCH_ESTIMATE:
SELECT THETA_SKETCH_ESTIMATE(
         DS_THETA(theta_uid) FILTER(WHERE "show" = 'Bridgerton')
       ) AS users
FROM ts_tutorialDS_THETA:合并 theta_uid 这一列中选定行的摘要,得到一个新的 Theta sketch。THETA_SKETCH_ESTIMATE:计算合并结果的去重数量估计。
过滤子句只让满足条件的行参与相应聚合。原文解释中的 THETA_SKETCH_ESIMATE 少了字母 T;本文统一采用示例 SQL 中正确的 THETA_SKETCH_ESTIMATE 拼写。
求交集:两集都看过的人
把聚合过滤与集合运算组合起来,就能回答开头的问题。用 THETA_SKETCH_INTERSECT 计算两个或多个子集的交集,再估计看过 Bridgerton 两集的不同用户数:
SELECT THETA_SKETCH_ESTIMATE(
         THETA_SKETCH_INTERSECT(
           DS_THETA(theta_uid) FILTER(WHERE "show" = 'Bridgerton' AND "episode" = 'S1E1'),
           DS_THETA(theta_uid) FILTER(WHERE "show" = 'Bridgerton' AND "episode" = 'S1E2')
         )
       ) AS users
FROM ts_tutorial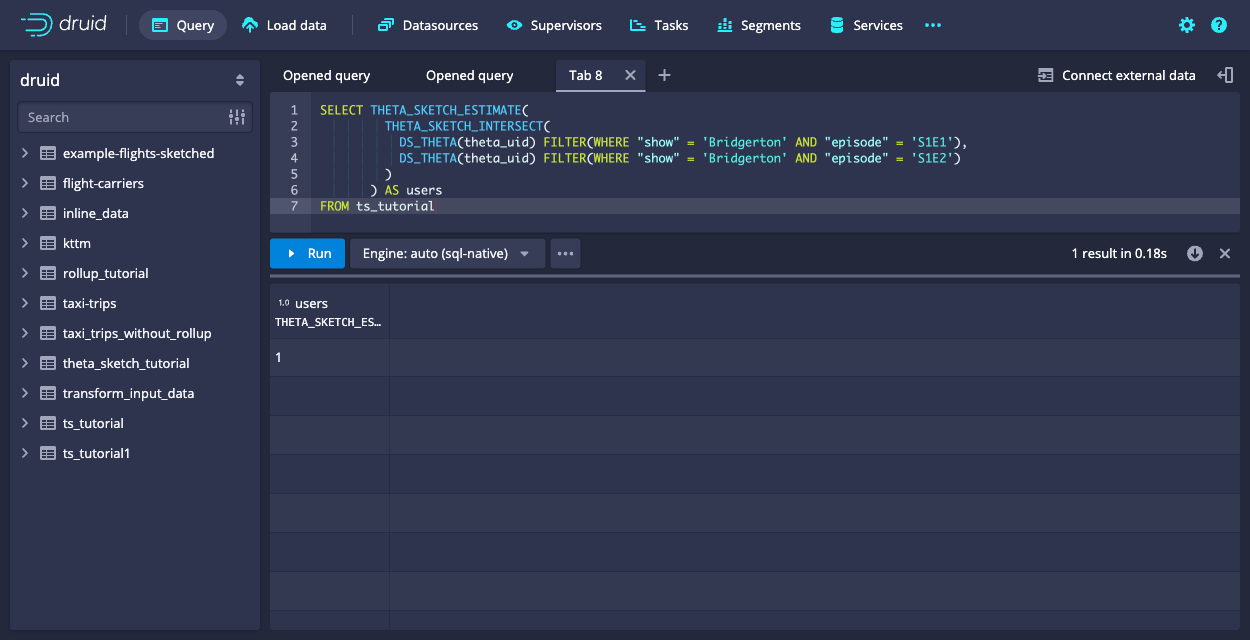
集合函数位于聚合器和估计器之间:先分别得到两集的观众摘要,再求交集,最后取数量估计。
求并集:至少看过其中一集的人
使用 THETA_SKETCH_UNION 合并两个集合,得到至少看过其中一集的不同用户数量估计:
SELECT THETA_SKETCH_ESTIMATE(
         THETA_SKETCH_UNION(
           DS_THETA(theta_uid) FILTER(WHERE "show" = 'Bridgerton' AND "episode" = 'S1E1'),
           DS_THETA(theta_uid) FILTER(WHERE "show" = 'Bridgerton' AND "episode" = 'S1E2')
         )
       ) AS users
FROM ts_tutorial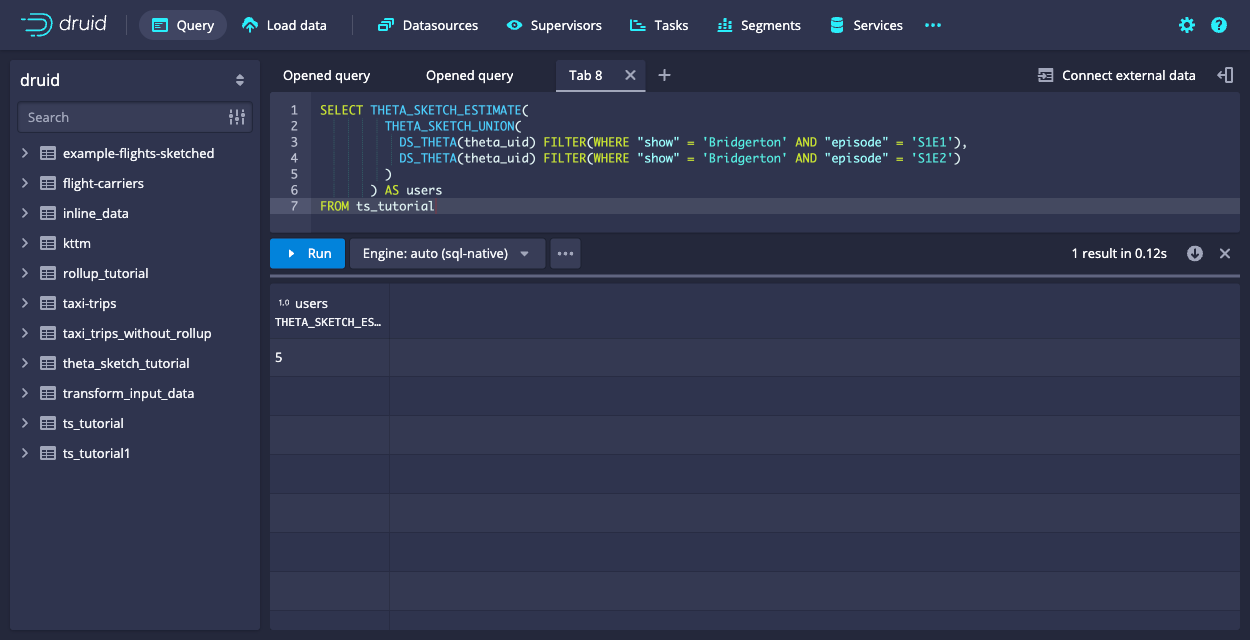
求差集:看过第一集但没看第二集的人
THETA_SKETCH_NOT 计算有顺序的集合差。这里从第一集观众集合中排除第二集观众,结果回答“看过第一集,但没看第二集”的人数:
SELECT THETA_SKETCH_ESTIMATE(
         THETA_SKETCH_NOT(
           DS_THETA(theta_uid) FILTER(WHERE "show" = 'Bridgerton' AND "episode" = 'S1E1'),
           DS_THETA(theta_uid) FILTER(WHERE "show" = 'Bridgerton' AND "episode" = 'S1E2')
         )
       ) AS users
FROM ts_tutorial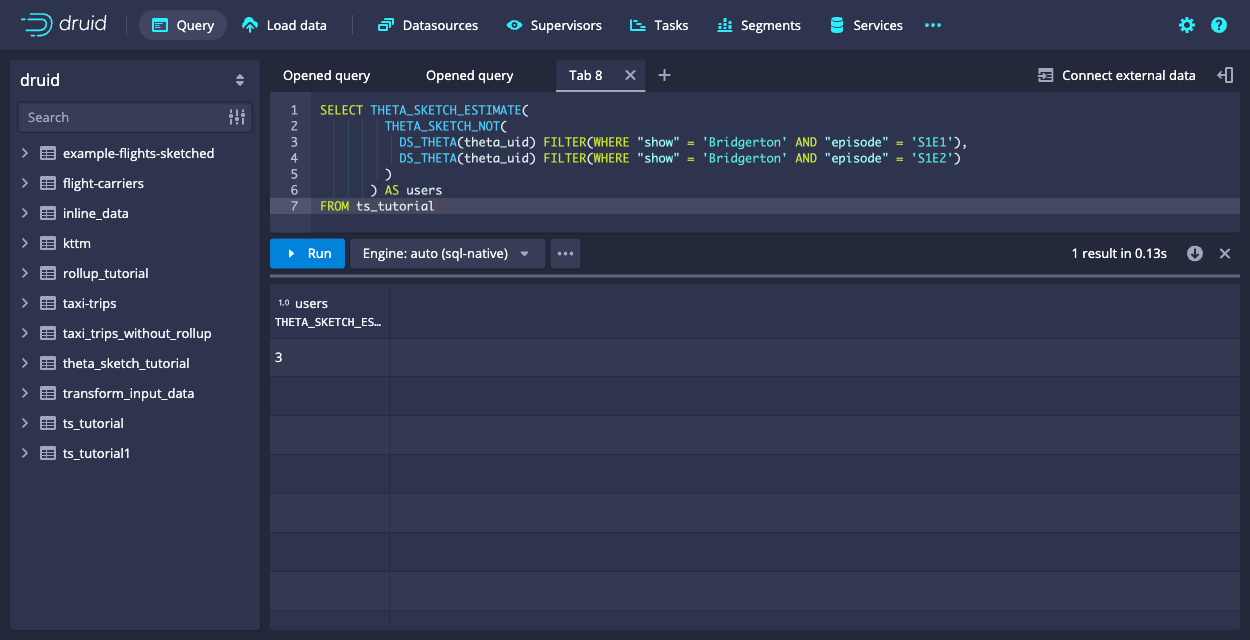
编者提示:差集不能随意交换两个输入。图中的 1、5、3 来自原文官方截图,结合这份小数据可以理解其含义,但不能因此把 Theta sketch 对任意规模数据都描述为精确计数。
本教程得到的结论
- 在 Apache Druid 中,可以用 Theta sketch 对大型数据集做去重数量分析。
- 摘要允许配合 rollup:可以舍弃分析表中的单个原始值,仅保留用于统计近似的摘要。
- 交集、并集和差集有助于分析人群关联,例如哪些细分人群相关、彼此重叠多少。
查询精度由 Theta sketch 的大小 k 以及执行的运算共同决定。减小或增大摘要不是免费的精度开关:要结合空间成本、误差需求和集合运算评估。统计上可合并的是摘要,不能把不同时段或人群的去重计数直接相加。
继续阅读
- Theta sketch 模块:Druid 中的入库和原生查询参考。
- Theta sketch 标量函数 与 聚合函数:Druid SQL 的相关函数。
- 高基数字段的 sketch:涉及摘要的 schema 设计。
- DataSketches 扩展:扩展及其他可用 sketch。
- Apache DataSketches 精度说明:大小 k 和集合运算对误差的影响。
为什么开头举的是 15 分钟,而不是一小时
原文脚注指出,不同时区的偏移不一定是整数小时。例如印度使用半小时偏移,尼泊尔使用 45 分钟偏移。15 分钟粒度更容易组合成这些时区各自的小时桶,因此比只保留整点小时桶更灵活。涉及用户去重时,这里的“组合”仍应使用摘要合并,而不是直接相加每个桶的去重人数。
致谢、版权与核验范围
官方教程注明改编自社区成员 Hellmar Becker 的 Druid Data Cookbook: Counting Unique Visitors for Overlapping Segments(2022 年 6 月 5 日)。本文以当前 Druid 官方教程为翻译对象,没有将原博文中的第三方封面素材另行搬入。
Copyright © 2026 Apache Software Foundation。除另有说明,原教程采用 CC BY-SA 4.0。本中文译编保留署名、来源及相同许可;翻译、术语澄清、静态审查补充和原创示意图为本次修改。Druid 软件另有其软件许可证;不要把文档许可和软件许可混同。Apache Druid、Druid 及 Druid 标志是 Apache Software Foundation 在美国及其他国家的商标或注册商标。
本稿只静态检查数据、SQL 和技术说明,没有执行入库或查询,没有启动服务;截图全部为官方原图。未把概率估计宣传为精确结果,也未据此声称任何吞吐量、延迟或安全保证。











暂无评论内容