


原作者:Brendan Gregg。原文:Linux Load Averages: Solving the Mystery,2017 年 8 月 8 日。本文经授权译写,保留历史调查、计算案例及诊断方法。文中的实验与生产服务器观测属于原作者;未完纪没有重新运行这些命令,也没有复现结果。涉及“现在”的内核比较,均指作者写作时的 2017 年环境。
负载均值是重要的运维指标。作者所在公司曾结合它和其他信号决定云实例扩容,涉及大量成本。但 Linux 的负载均值有一个容易让人困惑的特点:除了可运行任务,还统计处于不可中断睡眠的任务。为什么这样设计?作者沿着源码、老版本压缩包和邮件存档追溯,终于找到了 1993 年的解释。
三个数字首先表达的是需求
Linux 的负载均值可以理解为“系统负载均值”:以任务或线程数量表示正在工作和等待工作的需求。需求可能大于系统当前能够处理的工作量。uptime、top 和 /proc/loadavg 通常展示三个值,习惯上称为 1、5、15 分钟负载。
$ uptime
 16:48:24 up  4:11,  1 user,  load average: 25.25, 23.40, 23.46

top - 16:48:42 up  4:12,  1 user,  load average: 25.25, 23.14, 23.37

$ cat /proc/loadavg
25.72 23.19 23.35 42/3411 43603
以上是原文示例。三个平均值为零通常表示系统在这个指标下空闲;短期值高于长期值提示需求在上升,低于长期值则提示需求在下降。负载高于 CPU 数量可能意味着性能问题,但还要看工作负载及负载来源。单看“23–25”没有足够信息;如果知道 CPU 数量,而且确定是 CPU 密集工作,才更容易解释。
三个值最直接的用处是看趋势,以及提供一个扩容策略所需的需求信号。真正排障时,作者通常很快转向更具体的 CPU、磁盘或等待指标,而不是一直试图解释这个混合数值。
历史:最初度量的是 CPU 需求
早期负载均值只考虑正在运行、以及准备好但等待 CPU 的进程。1973 年 8 月的 RFC 546:TENEX Load Averages给出直观解释:单 CPU 系统一小时的平均负载为 10,表示通常可理解为一个进程在运行,另有九个可运行、并非阻塞于 I/O 的进程等待 CPU。文档还附有 1973 年 7 月手绘的负载曲线,说明人们监控这一指标已有很长历史。
早期操作系统源码也能看到今天熟悉的做法。TENEX 的 SCHED.MAC 声明维护三个负载值,计算活动进程数的指数平均,每次处理约 5000 毫秒,并为一分钟、五分钟和十五分钟使用不同衰减因子。原文引用的 DEC 宏汇编节选如下:
NRJAVS==3               ;维护的负载均值数量
GS RJAV,NRJAVS          ;活动进程数量的指数平均
[...]
;更新可运行作业平均值
DORJAV: MOVEI 2,^D5000
        MOVEM 2,RJATIM
        MOVE 4,RJTSUM
        SUBM 4,RJAVS1
        EXCH 4,RJAVS1
        FSC 4,233
        FDVR 4,[5000.0]
[...]
;T = 5 秒时的 EXP(-T/C) 表
EXPFF:  EXP 0.920043902 ;C = 1 分钟
        EXP 0.983471344 ;C = 5 分钟
        EXP 0.994459811 ;C = 15 分钟
作者在 2017 年引用的 Linux include/linux/sched/loadavg.h 同样把这些常数写在源码中:
#define EXP_1  1884  /* 1/exp(5sec/1min),定点数 */
#define EXP_5  2014  /* 1/exp(5sec/5min) */
#define EXP_15 2037  /* 1/exp(5sec/15min) */
Multics 等更早的系统也有类似指标,例如调度队列的指数平均。这里的汇编与内核代码用于解释历史,不是要求读者编译或应用补丁。
“一分钟平均”并不是最近一分钟的普通算术平均
1、5、15 分钟是指数衰减公式里的时间常数,并不是把窗口外的历史全部清空。原文把它描述为对约五秒采样形成的平均进行指数衰减的移动和。因此,十五分钟前的活动仍可能对“十五分钟负载”有贡献。
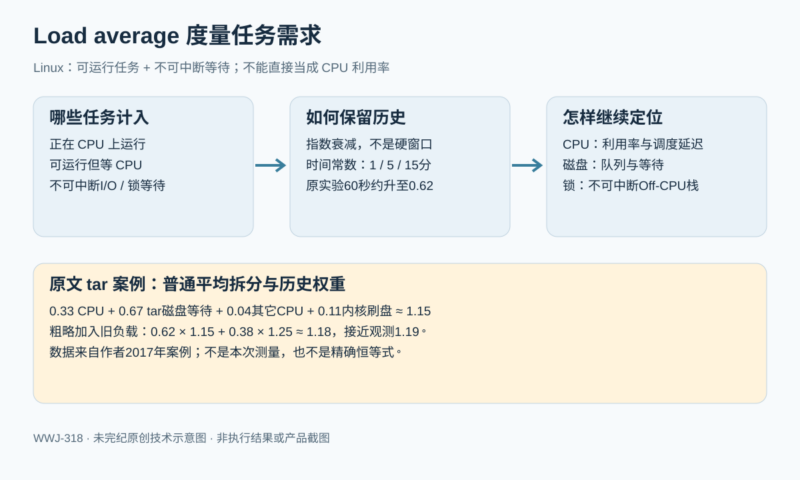
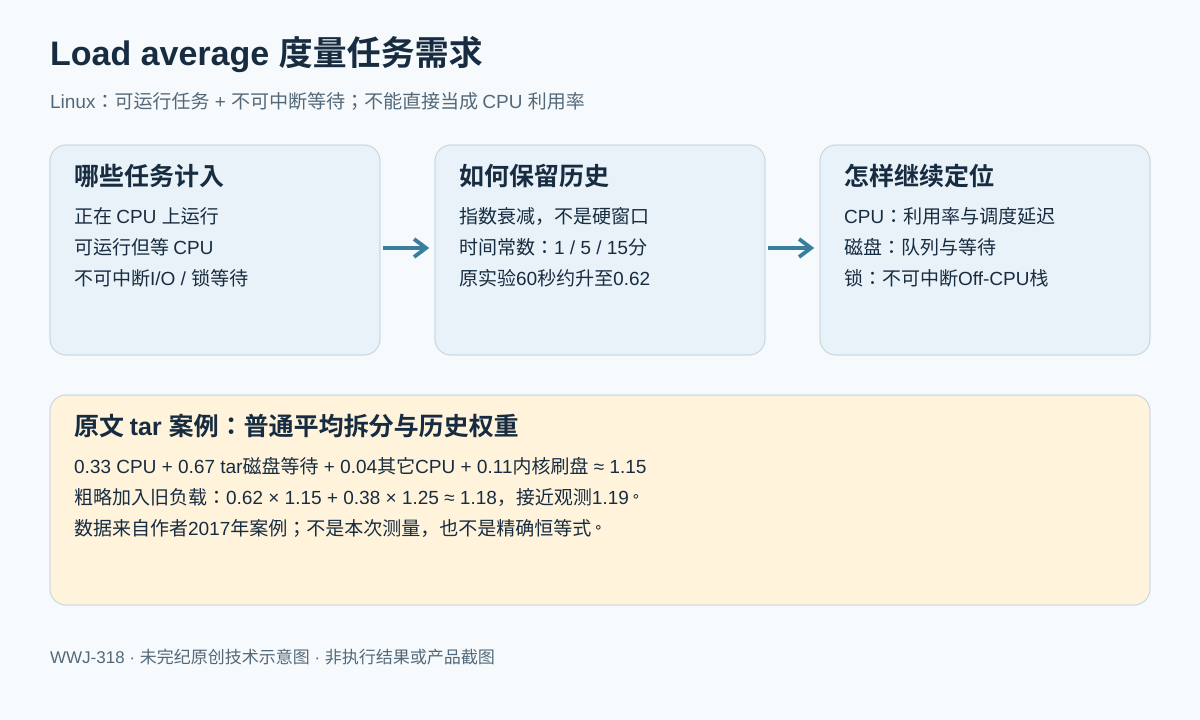
作者做过这样一个实验:让原本空闲的系统开始运行一个持续占用 CPU 的单线程循环。一分钟后,“一分钟平均”仅上升到约 0.62,而不是普通平均直觉下的 1.0。旧值不会立刻消失,新值也不会一步到位。进一步的数学说明可见 Neil Gunther 的负载均值文章,以及 Linux loadavg.c 中的注释。本文没有运行负载发生器,也不把原曲线伪装为本次测试。
Linux 为什么把 D 状态算进来
Linux 刚引入负载均值时同样只统计 CPU 需求,后来增加了不可中断状态,也就是 TASK_UNINTERRUPTIBLE、相关计数 nr_uninterruptible。这类状态用于不希望被信号打断的等待路径,常见于磁盘 I/O,也可用于某些锁等待。在 ps 或 top 中,它通常显示为 D;ps 手册把它解释为不可中断睡眠,通常与 I/O 有关。
加入它以后,磁盘或 NFS I/O 工作负载也能抬高 Linux 的负载均值,而不只是 CPU 需求。对于习惯其他系统“CPU 负载”的人,这很容易造成误读。作者最初猜想,这种设计是为了更广义地表示系统资源需求,但仍想找到当初的明确理由。
寻找一个比 Git 历史更古老的补丁
从 Git 提交记录查变更动机,本来是常规办法。作者先查 loadavg.c,但相关逻辑比这个文件本身还早;继续追踪原来的文件,发现代码多次搬迁。他把整个 Linux Git 仓库的 git log -p 导出成约 4 GB 文本,倒着查找,仍然走进死胡同:常用仓库最早记录是 Linus 在 2005 年导入的 Linux 2.6.12-rc2,而目标变更比这早得多。
历史仓库也没有留下相应说明。作者开始比较 kernel.org 的旧压缩包,发现 0.99.15 已改变、0.99.13 尚未改变,但中间的 0.99.14 包缺失。他从其他地方找到该版本,最终将改动定位到 1993 年 11 月的 Linux 0.99 patchlevel 14。
该版发布说明仍没有答案。Linus 说,从 p13 以来改动多得难以列举或记住,只提了一些大项,没有提负载均值。公开内核邮件归档最早又只到 1995 年 6 月,管理员当时解释自己在调整存档规模时误删了现有归档。
作者继续搜索从旧备份中恢复的 linux-devel 邮件摘要:超过 6000 份摘要、98000 封邮件,其中 30000 封来自 1993 年,仍未找到目标。他一度以为原始说明已经永久丢失。
1993 年的答案:慢交换盘不该让负载看起来更低
最后,作者在 oldlinux.org 的 1993 年压缩邮箱中找到了 Matthias Urlichs 的邮件。邮件日期为 1993 年 10 月 29 日,主题为“Load average broken ?”。其核心意思是:
内核计算负载均值时只统计可运行进程,这并不合适。正在交换,或等待快速、不可中断 I/O 的进程同样消耗资源。如果把快速交换盘换成慢盘,系统明明变慢,负载均值反而下降,就很不直观。把这些状态计入,负载会更接近人感受到的系统速度,而什么事都不做时仍然为零。
补丁的含义是把原来只看 TASK_RUNNING 的条件扩展为也看 TASK_UNINTERRUPTIBLE 和当时的 TASK_SWAPPING,再按 FIXED_1 增加计数。原文邮件摘录里的括号有排版异常;为避免读者把它当可用补丁,下面仅保留逻辑说明,不声称这是逐字可应用的 diff:
旧逻辑:存在任务,且状态为 TASK_RUNNING → 计数
新意图:存在任务,且状态属于以下任一状态 → 计数
        TASK_RUNNING
        TASK_UNINTERRUPTIBLE
        TASK_SWAPPING(历史状态,后已移除)
这个理由解释了为什么 Linux 的“CPU 负载均值”变成了“系统负载均值”。如果慢交换盘使任务等待更久,系统需求理应增加;只看运行状态会把等待遗漏,反而可能看到更低的负载。
不可中断状态的含义也在扩展
作者比较发现,Linux 0.99.14 中直接设置不可中断或交换状态的路径有 13 处;到 2017 年的 Linux 4.12,直接设置 TASK_UNINTERRUPTIBLE 的路径接近 400 处,包含某些锁原语。于是,一个看起来过高、不能全用磁盘 I/O 解释的负载,可能来自新增的软件资源等待。
作者写信询问 Matthias。对方一小时内回复,仍认为负载均值应表达人在使用系统时感受到的忙碌程度:一个严重受磁盘限制、操作非常迟缓的系统,如果 TASK_RUNNING 的均值只有 0.1,这个值并不能帮助理解体验。
调度器维护者 Peter Zijlstra 提出过值得探索的方向:用 task_struct->in_iowait 代替全部不可中断状态,以更接近磁盘需求。但这又回到了指标目标:究竟要度量线程对整个系统的需求,还是只度量物理资源需求?如果前者才是目标,等待不可中断锁的线程仍在完成工作,并非空闲,计入它们就有道理。原文是在讨论设计取舍,没有说该替代方案已成为当前内核行为。
用 Off-CPU 栈看见不可中断等待
作者从生产服务器采集了 60 秒,仅保留不可中断状态的内核栈,绘制 Off-CPU 火焰图。横向宽度表示阻塞在 CPU 之外的时间,纵向叠起来的是调用栈;左右排序不表示时间先后。原图用蓝色表示 Off-CPU 路径,颜色深浅随机变化以区分帧。它不是传统时间轴。
原文使用 bcc 的 offcputime 与 FlameGraph,当时所需 eBPF 功能来自 Linux 4.8 及以上。下面保留原命令用途,但纠正原网页输出文件末尾的排版残留,将其统一为 out.offcpu.svg:
# 2017 年历史命令,执行前核对目标内核、bcc版本、权限与参数
./bcc/tools/offcputime.py -K --state 2 -f 60 > out.stacks
awk '{ print $1, $2 / 1000 }' out.stacks \
  | ./FlameGraph/flamegraph.pl --color=io --countname=ms > out.offcpu.svg
-K 只显示内核栈,-f 输出折叠栈,--state 2 在作者使用的内核语境下匹配 TASK_UNINTERRUPTIBLE;awk 将微秒换成毫秒。作者说明该状态过滤选项是为文章刚加入的,也提到 Facebook 的 Josef Bacik 早先在 kernelscope 中用过类似方法。工具还支持用户栈,但本例只看内核。
这些跟踪命令不是无影响的通用检查:需要匹配目标版本和权限,可能采集进程或栈信息,增加开销,并覆盖同名输出文件。应预先限定对象、时长与保存目录,避免在没有批准时采集整台生产机。本文没有执行 eBPF 或内核探针;不能把“最低版本 4.8”当作任意新内核环境都能直接运行的保证。
第一张原图在 60 秒内只累计约 926 毫秒不可中断睡眠,折算平均约 0.015 个阻塞任务,主要是 cgroup 路径,磁盘活动不多。第二次作者取 10 秒样本,看到 systemd-journal 读取 /proc/PID/cmdline 时进入 proc_pid_cmdline_read() 并阻塞,约贡献 0.07;另一条较宽的缺页路径进入 rwsem_down_read_failed(),约贡献 0.23。这是普通时间占比的近似解释,实际负载均值还有指数衰减。
原文引用的锁等待代码显示了为什么 D 状态并不只代表磁盘:
/* 等待获得锁:历史内核代码节选 */
while (true) {
    set_task_state(tsk, TASK_UNINTERRUPTIBLE);
    if (!waiter.task)
        break;
    schedule();
}
Linux 提供可中断和不可中断的锁获取版本,例如 mutex_lock() 与 mutex_lock_interruptible(),以及信号量的 down() 与 down_interruptible()。可中断版本允许任务在获得锁之前因信号醒来处理;不可中断锁等待也会影响负载。原例两条锁路径合计约 0.30。如果这个贡献很大,就值得检查争用,作者会先调查 journal 与 cmdline 读取。减少争用可同时改善性能、降低负载,但不能反过来只为降低数字而改指标。
一个 tar 案例:把 1.19 拆开看
作者在空闲的 8 CPU 系统上运行 tar 归档尚未缓存的文件。进程几分钟里大多等待磁盘读取,三个终端分别运行以下观察命令:
pidstat -p `pgrep -x tar` 60
iostat -x 60
uptime
pgrep 可能匹配多个 tar 进程;复用这个例子前应明确目标 PID 和当前 pidstat 的参数格式。本文没有创建归档或增加磁盘负载。原文环境为 Linux 4.9.0-rc5-virtual,采样得到 tar 的用户态 2.85%、系统态 29.77%,合计 CPU 32.62%。iostat 的整机 user 为 0.54%、system 4.03%、iowait 8.24%、idle 87.10%,还有 nice 0、steal 0.09%。
原磁盘表中,xvdap1 的平均队列 0.06、await 1.84 ms、利用率 1.21%;xvdb 的平均队列 3.97、await 1.56 ms、利用率 60.47%;xvdc 分别为 4.21、1.65 ms、61.65%。md0 为聚合设备,其部分字段显示为零。这些旧版 iostat 字段仅用于保留案例背景,不能将 svctm、%util 等字段跨版本、跨设备架构直接等同为统一瓶颈判断。
uptime 先显示 1.25, 1.19, 1.05,随后为 1.19, 1.17, 1.06。作者还采集了只包含不可中断状态的 Off-CPU 图,试着解释最终的一分钟负载 1.19:
| 组成 | 约当任务数 | 证据或推断 |
|---|---|---|
| tar 消耗 CPU | 0.33 | pidstat 的 32.62% 约为一个 CPU 的三分之一 |
| tar 不可中断磁盘读取 | 0.67 | 由剩余时间推断;Off-CPU 图约为 0.69,采样窗口略不同 |
| 其他 CPU 使用者 | 0.04 | 整机 user + system,换算到 8 CPU 后减去 tar |
| 内核工作线程刷盘等待 | 0.11 | Off-CPU 图左侧两条路径 |
| 合计 | 1.15 | 普通时间平均的近似拆分 |
与观测的 1.19 仍差 0.04。部分可能来自四舍五入和采样窗口偏移,更重要的是 pidstat、iostat 使用普通平均,而负载均值保留了历史权重。用此前 1.25 和一分钟约 62% 的新权重粗略估计:
0.62 × 1.15 + 0.38 × 1.25 ≈ 1.18结果与 1.19 接近。这不是一个精确恒等式,而是说明该数字有可解释的来源:tar 一个线程加少量内核工作线程在工作,CPU 和磁盘等待共同构成约一个多线程的需求。若只统计 CPU,作者推算约为 0.37;它对 CPU 来说没有错,却遗漏了等待磁盘的工作需求。
“好负载”与“坏负载”没有统一阈值
作者把两类指标区分开:CPU 负载均值只算运行与等待 CPU 的线程,便于讨论 CPU 需求;Linux 的系统负载均值还包括磁盘及不可中断锁等等待,覆盖资源更广,但解释也更复杂。还可以设想只含 CPU、磁盘等物理资源的负载,或分别提供磁盘、网络负载指标,但那是设计选项,不是本文证实已有的统一接口。
一些运维团队知道自己系统“负载超过 X,客户就会感到延迟”,这种经验可以用作本系统的基线,却不是通用定律。即使是纯 CPU 负载,除以 CPU 数量大于 1 也只提示可能饱和;一分钟内是否突发、延迟目标是什么,都能改变结果。原作者曾管理一台双 CPU 邮件服务器,白天 CPU 负载在 11–16,延迟仍能接受;他同时指出这很极端,多数系统在比值约 2 时已经有困难。
对混合资源的 Linux 负载,更不能简单除以 CPU 数量下结论。若熟悉的系统在负载 20 时工作正常,如今到了 40,这个相对变化值得调查,但具体问题仍要靠其他指标确认。
转向更能回答问题的指标
负载上升只说明更多线程需要 CPU、磁盘或某些锁。作者建议使用以下信号把问题拆开:
| 问题 | 示例工具或接口 | 含义 |
|---|---|---|
| 每个 CPU 忙不忙 | mpstat -P ALL 1 |
利用率,可能发现单核热点 |
| 谁在用 CPU | top、pidstat 1 |
进程利用率 |
| 线程等 CPU 等了多久 | /proc/PID/schedstat、delay accounting、perf sched |
调度等待延迟,衡量饱和影响 |
| 系统运行队列延迟 | /proc/schedstat、perf sched、bcc runqlat |
等待运行的时间分布 |
| 运行队列有多长 | vmstat 1 的 r 列、bcc runqlen |
排队数量,提示是否存在争用 |
前两类是利用率,后三类更接近饱和度。利用率帮助描述工作负载,而调度延迟能量化性能问题:一个线程有多大比例的时间已经准备好,却仍在等待 CPU?只知道队列长度较难估计它受到多少影响。
原文说 Linux 4.6 将 schedstats 做成 kernel.sched_schedstats 控制的可调项,默认关闭;也讨论通过 delay accounting、cpustat 或 htop 更方便地展示延迟。这些是历史环境与当时的建议,今天应按目标内核的配置与权限核对。原文列表把单进程路径写为 /proc/PID/schedstats,本文依据内核官方文档更正为单数 schedstat。
作者还给出从当时未文档化的 /proc/sched_debug 抽取任务表的 awk 命令:
awk 'NF > 7 { if ($1 == "task") { if (h == 0) { print; h=1 } } else { print } }' /proc/sched_debug原表字段包含 task、PID、tree-key、switches、prio、wait-time、sum-exec、sum-sleep,并列出 systemd、内核工作线程和多个 dockerd 线程。该解析依赖列格式和内核接口,不能视为稳定跨版本 API;累计计数也应取两个时间点的差值,而不是把累计值当瞬时速率。
除 CPU 外,还应检查磁盘设备的利用率、饱和与错误。作者的 USE 方法及 Linux 检查表给出了按资源调查的思路。
负载均值仍有它的价值
更具体的指标并不意味着负载均值无用。它结合其他信号,可以帮助微服务扩容同时响应 CPU 和磁盘压力。作者描述的策略宁愿先多扩一些、之后再排查成本,也不愿因没有扩容损失客户;这是其业务取舍,不是适合所有团队的扩容规则。
作者最常用的价值之一是历史线索:登录一台曾经缓慢的实例时,如果一分钟负载已经远低于十五分钟值,说明问题可能已过去,自己来晚了。这值得几秒钟注意,随后仍要转到更具体的观测。
1993 年的几行修改,让 Linux 负载从 CPU 需求转为系统需求。此后不可中断等待扩展到更多路径,只要目标是统计正在工作、等待工作的线程,它们就仍有解释。用 Off-CPU 栈和时间可以找出等待来源;用 CPU、磁盘和调度延迟,可以知道它是否真正伤害了服务。
原文最后引用 Peter Zijlstra 在 loadavg.c 顶部的带玩笑意味注释:这个文件包含计算全局 loadavg 所需的“魔法”;数字本身很粗糙,人们却很重视,因此内核为让它在大机器和无周期时钟中工作付出了许多努力。理解其定义与局限,比把一个混合数字当作性能裁决更有帮助。
参考、署名与核验说明
- 历史参考:Saltzer 与 Gintell 的 The Instrumentation of Multics(CACM,1970 年 8 月);Multics system_performance_graph 文档;TENEX 源码;RFC 546;Bobrow 等人的 TENEX: A Paged Time Sharing System for the PDP-10(CACM,1972 年 3 月)。
- 计算参考:Neil Gunther 的 UNIX Load Average Part 1: How It Works;Linux loadavg.c 与 loadavg.h。
- 历史邮件与版本:oldlinux.org 的 alan-old-funet-lists/kernel.1993.gz;Linux 0.99.13/0.99.14 的 sched.c;kernel.org 历史版本。完整原始线索可在原文参考区查阅。
- 诊断工具:bcc 与 FlameGraph。当前 offcputime 文件保留 ©2016 Netflix, Inc. 和 Apache-2.0 声明;Linux 内核代码归原项目及其适用 GPL-2.0 许可,本文短节选不另行改许可证,也不打包工具分发。
原作者感谢 Deirdre Straughan 协助编辑,本文一并保留。文字原作者为 Brendan Gregg,原站版权归属继续有效;原创图仅用于说明,未复制带交互脚本的火焰图作为文章执行内容。审核覆盖原文完整章节与代码片段;所有运行、时间、CPU 和 I/O 数据均为原文案例,没有本次实测结论。











暂无评论内容