


订单写入数据库后,还要通知另一个系统。若先写订单,进程可能在发消息前退出;若先发消息,数据库写入又可能失败。两次普通调用之间的故障窗口,会让数据库状态与外部系统不一致。事务性发件箱(transactional outbox)解决的是这类“本地变更已经发生,后续工作却可能丢失”的问题。
本文经授权翻译整理自 DBOS 官方指南 Transactional Outbox,并核对它链接的两份完整 Python 示例、README、依赖文件和前端。原页未署个人作者,维护方为 DBOS, Inc.,核验日期为 2026 年 10 月 5 日。所有代码仅做静态审查,没有运行应用或验证故障恢复。
传统 outbox 将什么放进同一个事务
传统做法是在业务数据库里增加一张 outbox 表。一个数据库事务同时更新业务记录,并把待发送消息写入 outbox。事务要么整体提交,要么整体回滚,因此不会出现“订单已经提交,但发送意图没有留下”的情况。后台进程再轮询 outbox,把消息送往其他系统。
这里的原子性覆盖数据库里的两项写入。真正的网络发送发生在之后,可能因崩溃或通信结果不明确而重试。若发送已被对方接受,但发送端尚未保存完成状态就退出,恢复后仍可能再次发送;消息接收方或调用接口必须能够去重。
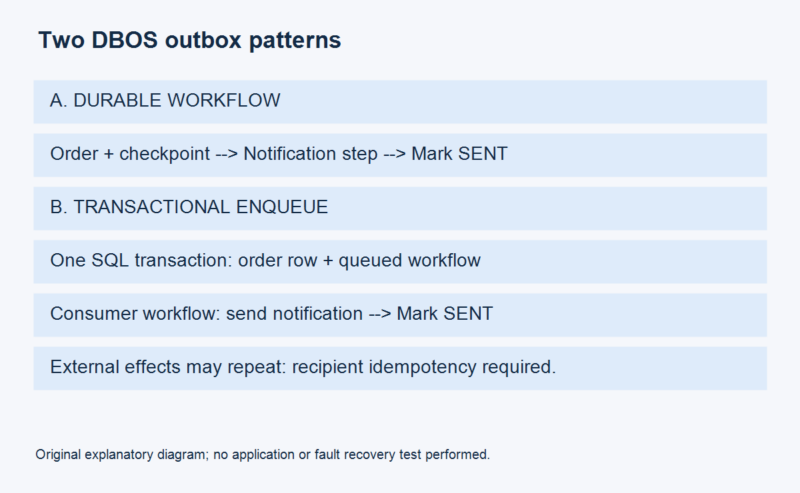
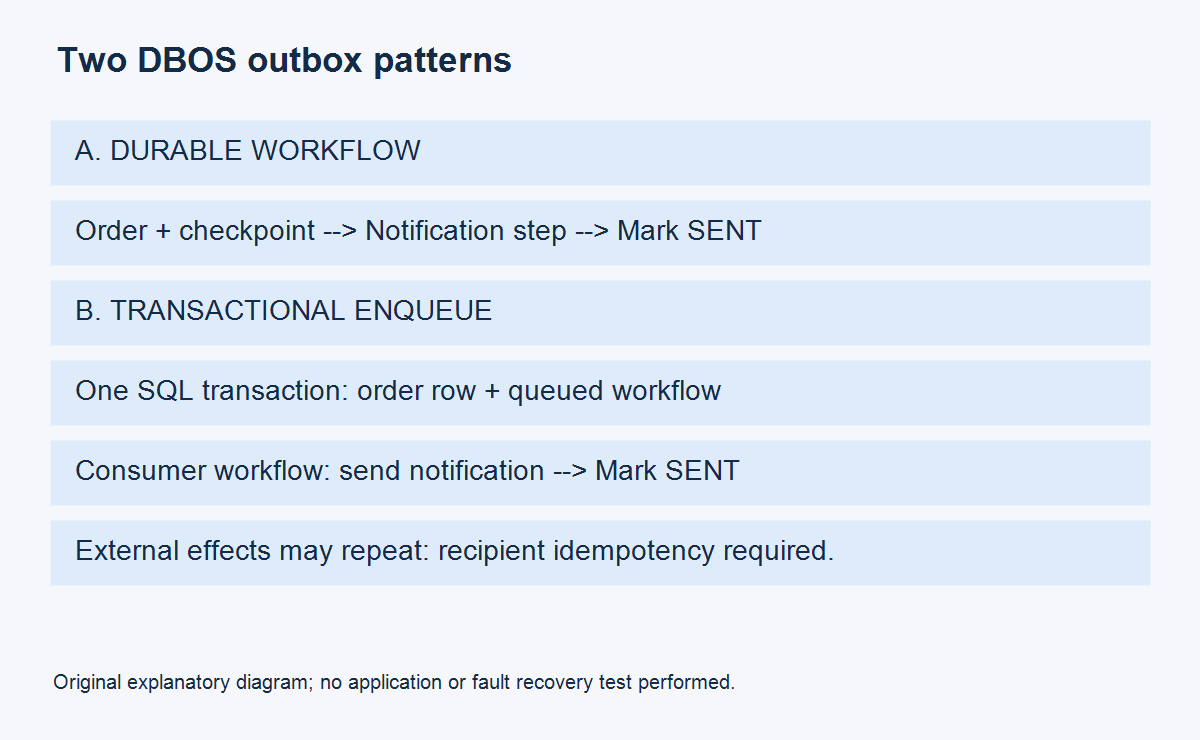
DBOS 官方示例给出两种组织方式:用一个持久工作流串起订单与通知,或者在订单事务内把通知工作流加入队列。前者把流程恢复交给工作流,后者让事务提交边界更接近传统 outbox。
示例前提与订单结构
项目的 pyproject.toml 要求 Python 3.13 或更高,固定依赖 dbos==3.2.0,并使用 FastAPI。README 假定已经有可用的本地 PostgreSQL,并给出名为 transactional_outbox 的数据库连接。它没有提供 PostgreSQL 安装和账号配置的完整流程,不能把设置一个环境变量当成数据库已就绪。
两个程序都通过 DBOS_DATABASE_URL 创建 SQLAlchemyDatasource,并将同一连接用于 DBOS 系统数据库。订单表包括自增主键、客户、商品、数量、通知状态与创建时间:
metadata = sa.MetaData()
orders = sa.Table(
    "orders",
    metadata,
    sa.Column("order_id", sa.Integer, primary_key=True, autoincrement=True),
    sa.Column("customer", sa.Text, nullable=False),
    sa.Column("item", sa.Text, nullable=False),
    sa.Column("quantity", sa.Integer, nullable=False),
    sa.Column("notification_status", sa.Text, nullable=False, server_default="PENDING"),
    sa.Column("created_at", sa.DateTime, server_default=sa.func.now()),
)

@ds.transaction()
def create_orders_table() -> None:
    metadata.create_all(ds.sql_session().connection())
这段是完整应用中的表定义摘录,依赖已导入的 sqlalchemy as sa 与已初始化的 ds,不是独立脚本。状态默认 PENDING,模拟通知完成后改为 SENT。
方式一:用持久工作流串起订单与通知
订单插入使用 @ds.transaction()。DBOS 将该步骤的数据库操作与工作流检查点放在同一事务里,因此不会留下“业务写入已提交,而完成检查点未提交”的缝隙。恢复时,已经完成的事务步骤可以复用其结果,避免重新插入同一工作流步骤的订单。
@ds.transaction()
def insert_order(customer: str, item: str, quantity: int) -> int:
    result = ds.sql_session().execute(
        orders.insert().values(customer=customer, item=item, quantity=quantity)
    )
    order_id: int = result.inserted_primary_key[0]
    DBOS.logger.info(f"Inserted order {order_id}: {quantity}x {item} for {customer}")
    return order_id
通知函数是一个普通 DBOS step。原文用日志和三秒等待模拟网络延迟,没有连接邮件、Kafka 或 webhook:
@DBOS.step()
def send_order_notification(order_id: int, customer: str, item: str) -> None:
    DBOS.logger.info(
        f"Sending notification for order {order_id}: {item} for {customer}"
    )
    time.sleep(3)  # 仅模拟网络延迟
    DBOS.logger.info(f"Notification sent for order {order_id}: {item} for {customer}")
完整应用还包含状态更新和订单 ID 事件。下面依据 atomic_workflow.py 整理,省略原文长注释;同时把工作流的返回注解由 int 改为 None,因为源码没有 return,API 实际通过事件取得订单 ID。这是本文明确作出的类型标注修正,不改变流程。
@ds.transaction()
def update_notification_status(order_id: int, status: str) -> None:
    ds.sql_session().execute(
        orders.update()
        .where(orders.c.order_id == order_id)
        .values(notification_status=status)
    )

ORDER_ID_EVENT = "order_id_event"

@DBOS.workflow()
def place_order_workflow(customer: str, item: str, quantity: int) -> None:
    order_id = insert_order(customer, item, quantity)
    DBOS.set_event(ORDER_ID_EVENT, order_id)
    send_order_notification(order_id, customer, item)
    update_notification_status(order_id, "SENT")
POST /orders 使用 DBOS.start_workflow 启动流程,再通过 DBOS.get_event(handle.workflow_id, ORDER_ID_EVENT) 获取订单 ID 并返回。响应拿到订单 ID,不表示通知已完成。GET /orders 查询表并按 order_id 倒序返回,页面由此展示 PENDING 到 SENT 的变化。
若进程在订单事务完成之后、通知完成之前退出,持久工作流可在重启后从已保存的步骤状态继续。这里的“原子”应理解为通过持久化推进整个流程的完成,而不是远端消息发送与 PostgreSQL 的同一个 ACID 事务。订单提交之后,外部通知仍可能暂时没有完成;若最终永远无法发送,还需要错误处理或人工介入。
方式二:在订单事务内把通知工作流入队
若业务更希望订单请求只负责“写入并可靠安排后续工作”,可以把通知流程当作消费者。在插入订单的同一个 SQL 事务中调用 PostgreSQL 函数 dbos.enqueue_workflow。订单记录和入队记录要么一起提交,要么一起回滚;只有提交的订单才留下通知工作流。
NOTIFICATION_QUEUE = "notification_queue"

@ds.transaction()
def insert_order(customer: str, item: str, quantity: int) -> int:
    session = ds.sql_session()
    result = session.execute(
        orders.insert().values(customer=customer, item=item, quantity=quantity)
    )
    order_id: int = result.inserted_primary_key[0]

    session.execute(
        sa.text("""
            SELECT dbos.enqueue_workflow(
                workflow_name => :workflow_name,
                queue_name => :queue_name,
                positional_args => ARRAY[
                    CAST(:arg_order_id AS json),
                    CAST(:arg_customer AS json),
                    CAST(:arg_item AS json)
                ]
            )
        """),
        {
            "workflow_name": "send_notification_workflow",
            "queue_name": NOTIFICATION_QUEUE,
            "arg_order_id": json.dumps(order_id),
            "arg_customer": json.dumps(customer),
            "arg_item": json.dumps(item),
        },
    )
    DBOS.logger.info(f"Inserted order {order_id}: {quantity}x {item} for {customer}")
    return order_id

@DBOS.workflow()
def send_notification_workflow(order_id: int, customer: str, item: str) -> None:
    send_order_notification(order_id, customer, item)
    update_notification_status(order_id, "SENT")
SQL 的值通过绑定参数传递,没有把客户或商品内容拼进 SQL 字符串。每个位置参数都先由 json.dumps 序列化;源码说明,显式 CAST(... AS json) 是为了处理 psycopg 将绑定参数作为未确定类型的值传入的情况。不要把 JSON 序列化误当作可替代 SQL 参数化的安全机制,两者承担不同职责。
应用初始化 DBOS 并调用 DBOS.launch() 后,还会执行 DBOS.register_queue(NOTIFICATION_QUEUE),然后创建订单表并启动服务。POST /orders 直接调用上述事务函数,拿到订单 ID 后返回;消费者随后执行模拟通知,再更新 SENT。队列在这里承担传统 outbox 表与轮询消费者的组织工作,不需要应用自己再造一张 outbox 表。
“恰好一次”究竟适用于哪一层
官方将事务步骤的数据库写入描述为 exactly-once,因为业务写入与步骤检查点同事务完成;并将每个已提交订单对应的通知工作流描述为持久、可恢复的单个工作流。但这不意味着工作流内调用外部系统的每一次网络副作用只会发生一次。原页也明确提醒其他操作可能至少执行一次,需要幂等。
例如通知已被远端接受,而进程在 DBOS 保存该步骤结果前退出,恢复时仍可能再次调用通知接口。实际接入时,应让接收端接受稳定的业务去重键,如订单 ID 与通知类型的组合,重复调用返回同一业务结果。仅在本地先查看 SENT,并不能消除“远端成功、本地尚未记录”的窗口。
另一处容易误读的是“重试直到成功”。本示例的 @DBOS.step() 没有显式配置异常重试。当前官方 Workflows & Steps 参考 说明 retries_allowed 默认为 False,启用后也受 max_attempts 等配置约束。因此进程崩溃后的恢复与函数抛异常后的自动重试必须区分;不能据本例承诺所有网络异常都会无限重试。生产实现需要明确重试条件、次数、退避和最终失败处理。
此外,POST /orders 本身没有业务请求幂等键。同一个 HTTP 请求被客户端重复提交,会启动新的工作流或新的订单事务,可能产生多个订单。工作流步骤的 exactly-once 不会自动合并两个独立业务请求。这一点与通知接口的去重应分别设计。
如何在隔离的本地环境查看示例
原文给出的入口是克隆官方示例仓库,然后选择一种模式启动。以下是原文步骤的整理,仅供读者在已有可用 PostgreSQL 的本地开发环境执行,本文未执行:
git clone https://github.com/dbos-inc/dbos-demo-apps.git
cd dbos-demo-apps/python/transactional-outbox
uv sync

export DBOS_DATABASE_URL="postgresql+psycopg://postgres@localhost:5432/transactional_outbox"

# 二选一,避免争用同一端口:
uv run atomic_workflow.py
# 或:
uv run transactional_enqueue.py
该连接字符串是 README 的本地开发示例,没有包含密码,也不代表任何 PostgreSQL 默认允许无密码访问。真实数据库应采用适当账号权限和认证方式,含凭据的连接字符串不要进入代码仓库或公开日志。示例原本用 host="0.0.0.0" 启动 Uvicorn,会监听所有网络接口;源码未配置接口身份认证,不应直接暴露公网。仅本机演示时,可明确编辑两份源码末尾为 host="127.0.0.1",这是一项本文建议的配置收紧,而非声称已修改或运行了上游程序。
服务启动后访问 http://localhost:8000。前端提交客户、商品与数量,每两秒刷新订单列表。三个观察点分别是订单是否存在、notification_status 是否从 PENDING 变为 SENT、日志是否出现模拟通知记录。SENT 只代表该演示函数完成,并不能证明真实邮件已送达。
若演练恢复,应使用一次性开发数据库与没有外部副作用的模拟通知,保留 DBOS 数据库状态,重启同一个应用后观察未完成订单。本文没有执行中断或恢复实验,不提供虚构的控制台结果,也不把这一观察过程称为故障测试已经通过。
源码审查中还应留意的边界
订单插入、状态更新和查询都使用 SQLAlchemy 表达式,入队 SQL 使用绑定参数;未发现这里有将请求内容直接拼接成 SQL 的路径。前端对客户、商品和通知状态使用基于 textContent 的转义函数,再组装表格。但这只是针对读到的路径进行静态检查,不构成完整的安全审计。
请求模型只声明数量为 int,没有后端正数或上限约束;浏览器的 min=1 可以被绕过。客户名、商品名也没有长度或非空规则,日志会记录这些业务值。若要承接真实订单,必须补充服务端校验、身份认证、访问权限、日志最小化和请求幂等。原示例 GET /orders 会返回所有订单,没有分页或用户隔离,同样适合演示而非直接作为生产接口。
选择方式一时,订单与后续操作由一个工作流自然串联;选择方式二时,订单事务只承诺同时留下可靠的后续任务,发送由队列消费者承担。两种方式都能减少自建 outbox 轮询与恢复逻辑,但真实外部副作用的去重、异常策略与业务请求幂等仍属于应用设计的一部分。
配套源码:DBOS transactional-outbox 示例目录。本文核对的是 2026 年 10 月 5 日可读取的 main 分支文件与其中固定的 DBOS 3.2.0 依赖,并未将滚动分支视为不可变发行快照。











暂无评论内容