


作者:Fang Xing · 原文发表于 2026 年 8 月 7 日 · 中文翻译整理。原文链接
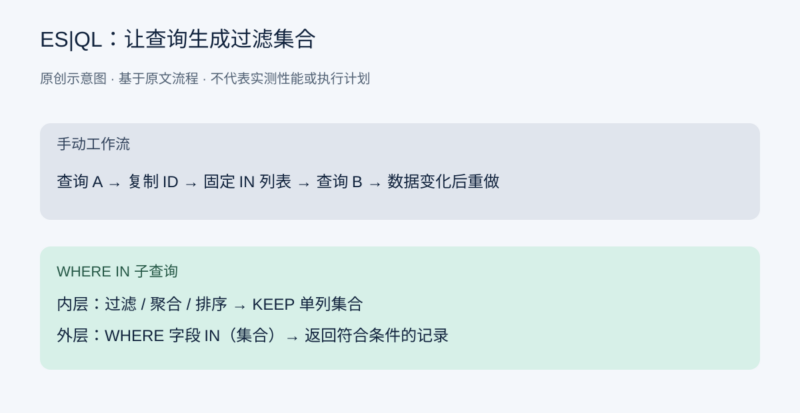
调查日志时,我们常常先查出可疑用户或故障服务,再复制标识符,粘贴到第二次查询里。现在,Elasticsearch Query Language(ES|QL)的 WHERE 可以直接使用另一次查询的结果作为过滤集合。只需一条语句,子查询就会根据当前数据生成名单;每次运行,名单都会重新计算。
版本边界:原文介绍的是 Elasticsearch 9.5 的技术预览功能,支持嵌套、NOT IN 以及 AND/OR 组合。技术预览可能在后续版本修改或移除,不适用正式 GA 功能的支持服务等级协议(SLA)。下列代码仅做静态审查,未在 Elasticsearch 实例上执行。
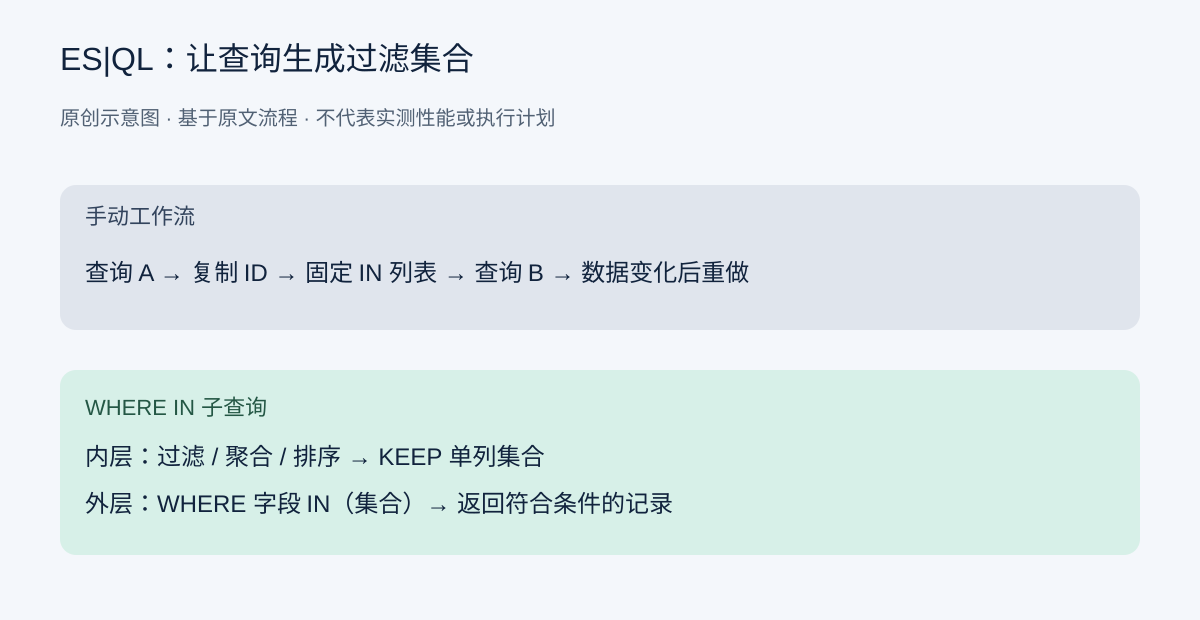
静态名单与动态过滤的区别
| 静态 ID 名单 | WHERE IN 子查询 |
|---|---|
| 运行查询 A,找到关心的 ID | 外层查询提出主要问题 |
| 手动复制返回值 | 子查询从当前数据生成名单 |
| 粘贴到固定的 WHERE IN 列表 | WHERE 字段 IN(子查询)直接过滤 |
| 运行使用硬编码名单的查询 B | 每次执行都随数据重新计算 |
| 数据变化后重复上述过程 | 无需维护复制出来的名单 |
如果列表很小,而且内容固定,传统的 IN 仍然很好用:
FROM logs-*
| WHERE status_code IN (401, 403, 429)
真实调查的起点却往往不是一份整齐的名单,而是一个问题:哪些用户可疑?哪些主机产生了大量噪声?哪些服务在失败?哪些账户超过了阈值?这时,与其手动填写列表,不如让 ES|QL 生成它。
先找出可疑用户,再查看他们的日志
FROM logs-*
| WHERE user.name IN (
    FROM auth-logs-*
    | WHERE event.action == "login_failed"
    | STATS failed_attempts = COUNT(*) BY user.name
    | WHERE failed_attempts >= 10
    | KEEP user.name
  )
这段查询可以读成:显示那些登录失败至少十次的用户所对应的日志事件。外层查询负责回答主要问题,内层查询负责生成过滤名单,因而不必手动搬运结果。内外两层可以使用不同的索引或索引模式。
这里的“至少十次”是示例条件。原示例没有时间过滤,它统计的是所匹配数据范围中的失败次数;实际调查应按业务需要限定时间与数据范围。
从“先查五个服务”到一条动态查询
假设我们想查看失败次数最多的服务。传统流程先执行:
FROM service-logs-*
| WHERE status_code >= 500
| STATS failures = COUNT(*) BY service.name
| SORT failures DESC
| LIMIT 5
然后复制五个服务名,再粘贴到另一条查询:
FROM service-logs-*
| WHERE service.name IN ("checkout", "payments", "search", "profile", "orders")
偶尔做一次没什么问题,但若前五名每小时都在变化,这份名单就会很快过时。可以把这个流程写成一条查询:
FROM service-logs-*
| WHERE service.name IN (
    FROM service-logs-*
    | WHERE status_code >= 500
      AND @timestamp >= now() - 2 days
    | STATS failures = COUNT(*) BY service.name
    | SORT failures DESC
    | LIMIT 5
    | KEEP service.name
  )
  AND status_code >= 500
  AND @timestamp >= now() - 2 days
| KEEP @timestamp, service.name, status_code, message
子查询找出过去两天失败次数最多的五个服务;外层查询返回这些服务在同一时间范围内、状态码至少为 500 的日志。内外层都保留时间和状态条件,确保“选择哪些服务”和“返回哪些事件”的范围一致。
用 NOT IN 排除已知集合
有时我们关心的是“不在名单里”的对象:
FROM access-logs-*
| WHERE user.name NOT IN (
    FROM known-users
    | WHERE user.name IS NOT NULL
    | KEEP user.name
  )
这适合做排除检查、缺口分析,或查找批准集合、预期集合之外的对象。示例显式排除了子查询中的空用户名。不要未经核对就把它当作涵盖所有空值情形的规则;涉及外层空值或多值字段时,还应结合目标版本语义验证。
把多级查找写成嵌套子查询
IN 子查询把原来的字面量列表替换成括号中的查询。概念上,内层先产生一个单列集合,外层再据此筛选。因为内层本身是一条完整管道,它还可以包含自己的 IN 子查询,把原本需要三次查询、两轮复制粘贴的过程串起来:
FROM orders
| WHERE customer_id IN (
    FROM customers
    | WHERE region_id IN (
        FROM regions
        | WHERE tier == "priority"
        | KEEP region_id
      )
    | KEEP customer_id
  )
| STATS revenue = SUM(amount) BY customer_id
从内向外读:最内层找出优先区域,中间层找出这些区域里的客户,最外层计算这些客户的订单金额总和。每一层都是普通的 ES|QL 管道,可以先过滤、聚合或排序,再把明确的一列传给上层。
用 AND 和 OR 组合多个集合条件
IN 子查询的结果是布尔条件,因此可以像其他谓词一样参与组合。例如,同时要求订单属于 VIP 客户,且商品即将停产:
FROM orders
| WHERE customer_id IN (FROM vip_customers | KEEP customer_id)
  AND product_id IN (FROM discontinued_products | KEEP product_id)
| KEEP order_id, customer_id, product_id, amount
把 AND 改成 OR,就会保留满足任一条件的订单。两个子查询各自运行管道,独立计算集合,再由布尔运算符组合条件。
把多个索引合成一个过滤集合
IN 中的查询是一条完整管道,因此它的 FROM 可以引用多个子查询。各分支独立处理数据,随后合并行,再用 KEEP host_id 选出外层过滤需要的唯一一列。要过滤的值分散在不同结构的索引中时,这种写法尤其有用。
FROM alerts
| WHERE host_id IN (
    FROM
      (FROM prod_hosts    | WHERE region == "us-east"),
      (FROM staging_hosts | WHERE region == "us-east"),
      (FROM edge_hosts    | WHERE region == "us-east")
    | KEEP host_id
  )
| STATS alert_count = COUNT(*) BY host_id
这里把生产、预发布和边缘主机索引中符合条件的主机 ID 合成名单,外层再按主机统计告警数量。增加第四个来源时,只需添加一个分支,外层查询无需变化。关于不同索引结构的处理,可继续阅读原文链接的 FROM 子查询相关文章;该扩展链接仅供参考,本篇没有把未核验的扩展内容并入正文。
也可以在每个 FROM 分支里动态过滤
反过来,每个 FROM 子查询分支都可以拥有自己的 WHERE,其中同样能使用 IN 子查询。这允许我们在结构不同的多个索引上使用相同的动态过滤规则:
FROM
  (FROM orders  | WHERE customer_id IN (FROM vip_customers | KEEP customer_id)),
  (FROM refunds | WHERE customer_id IN (FROM vip_customers | KEEP customer_id))
| STATS total_events = COUNT(*) BY customer_id
订单和退款分支先各自筛选出 VIP 客户的记录,再合并数据,最后统计每个客户的事件总数。COUNT(*) 统计的是合并后的事件行,不是净订单金额,也不是唯一客户数。
什么时候适合使用
- 调查从识别风险用户、主机、账户或服务开始。
- 运维仪表盘关注的实体会随时间变化。
- 需要对 Top-N 结果继续查询,例如查看噪声最多的五个服务的事件。
- 需要比较集合,尤其是使用
NOT IN的排除检查。 - 原本需要写胶水代码,只为把上一步查询结果传给下一步。
约束与常见问题
IN子查询必须恰好返回一列,建议在末尾使用KEEP明确比较字段。- 外层字段与子查询返回字段的数据类型必须兼容。
- 子查询使用
SORT时,需要显式提供LIMIT;原文说明该版本尚不支持无界排序。 - 这是集合成员关系过滤。如果结果中需要同时返回两侧的列,应考虑适当的
JOIN。
换句话说,WHERE IN 适合回答“保留外层记录中,其字段属于另一条查询返回集合的那些行”;NOT IN 则表达相应的排除条件。它不是把两张表的所有字段拼接到一起的工具。
这项功能把人工步骤变成了声明式查询:一条查询直接在 WHERE 中构造另一条查询所需的过滤集合,无需复制名单后再担心它是否已经过时。
编辑说明:保留原文所有主要段落、十个查询代码块及 FAQ 的技术内容,增加时间范围和统计口径提示。本文不是性能基准、安全审计或生产部署指南。原作者及 Elastic 保留原文权利;











暂无评论内容