


本文编译自 《R for Data Science》第二版第 12 章 Logical vectors,作者为 Hadley Wickham、Mine Çetinkaya-Rundel 和 Garrett Grolemund。依据 2026 年 10 月 05 日读取的在线完整章节整理,原页未列首次发表日期。本稿没有运行 R;标注的结果来自原文展示或代码含义分析。
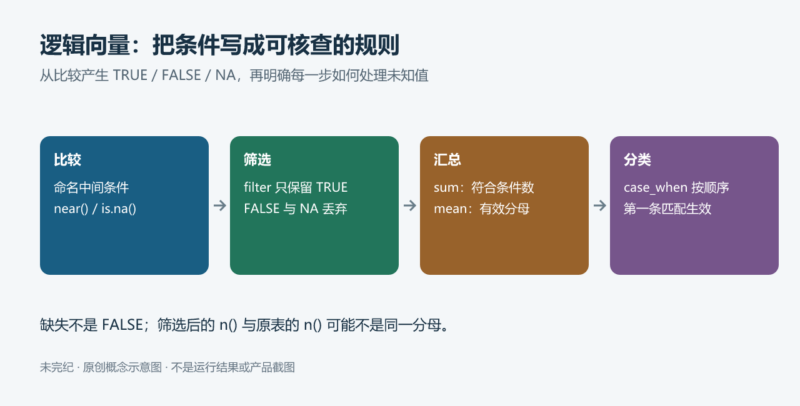
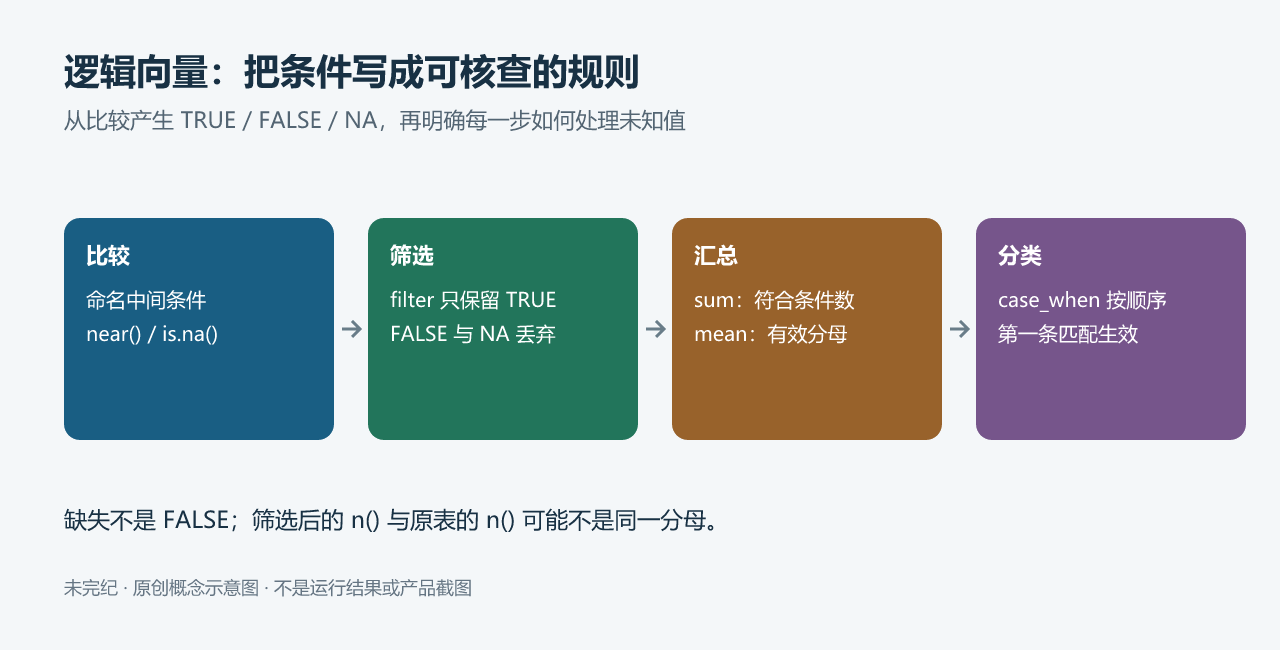
逻辑向量的元素只有三种可能:TRUE、FALSE 和 NA。原始数据中未必经常直接出现逻辑列,但筛选、计数、比例和条件分类几乎都会产生它们。写得可靠的条件代码,应该让人能检查每一步含义,而不是只看到最后筛出了多少行。
准备环境,把小向量和数据框联系起来
比较和布尔运算大多来自 base R。本章仍载入 tidyverse,以便使用 mutate()、filter() 等函数,并使用 nycflights13::flights 演示航班数据:
library(tidyverse)
library(nycflights13)

x <- c(1, 2, 3, 5, 7, 11, 13)
x * 2

df <- tibble(x)
df |>
  mutate(y = x * 2)
原文第一项运算显示 2 4 6 10 14 22 26。直接对向量做的操作,通常也能放进 mutate(),应用于数据框的一列。小向量易于看清函数行为,完整航班例则依赖指定数据包。本文使用原书的 R 管道 |> 和 dplyr 接口;旧环境需先核对 R 与包版本是否支持这些语法。
先生成逻辑列,再决定怎样筛选
数字比较 <、<=、>、>=、!=、== 都能产生逻辑向量。原文用下面的条件找出白天起飞、到达时间大致准点的航班:
flights |>
  filter(dep_time > 600 & dep_time < 2000 & abs(arr_delay) < 20)
这里的起飞时刻使用数据中的时分编码,条件严格排除了 600 和 2000;到达延误取绝对值小于 20 分钟。原文显示 172,286 行,不能把这一结果套用于其他数据或其他边界。把中间条件命名,可以更容易检查:
flights |>
  mutate(
    daytime = dep_time > 600 & dep_time < 2000,
    approx_ontime = abs(arr_delay) < 20,
    .keep = "used"
  )
.keep = "used" 便于只查看参与计算的原列与新增列。若要筛选,可保留完整表再接上:
flights |>
  mutate(
    daytime = dep_time > 600 & dep_time < 2000,
    approx_ontime = abs(arr_delay) < 20
  ) |>
  filter(daytime & approx_ontime)
这与原来的条件含义相同,但可以逐步检查 daytime 与 approx_ontime。尤其当规则变长时,有意义的中间列比一个巨大表达式容易核查。
浮点数:打印相同,不等于精确相等
x <- c(1 / 49 * 49, sqrt(2)^2)
x
# 原文显示:1 2

x == c(1, 2)
# 原文显示:FALSE FALSE

print(x, digits = 16)
# 原文显示:0.9999999999999999 2.0000000000000004

dplyr::near(x, c(1, 2))
# 原文显示:TRUE TRUE浮点表示只有有限精度,运算可能引入非常小的误差;默认打印又会四舍五入。near() 可以在给定容差下比较,忽略很小的差别。对测量值、计算值和业务阈值,应先想清楚需要精确相等还是容差相等,不能把任何差异一律抹去。
NA 表示未知,不能用等号找到它
NA > 5、10 == NA 和 NA == NA 的结果都是 NA。如果 Mary 和 John 的年龄都未知,不能因为两个人都“未知”就说他们同龄。这也是下面这个反例失败的原因:
# 反例:每行比较结果都是 NA,filter 不会保留它们
flights |>
  filter(dep_time == NA)
filter() 只保留条件为 TRUE 的行,FALSE 和 NA 都会被丢弃。应使用专门的缺失检测函数:
is.na(c(TRUE, NA, FALSE))
is.na(c(1, NA, 3))
is.na(c("a", NA, "b"))
# 原文三个结果均为:FALSE TRUE FALSE

flights |>
  filter(is.na(dep_time))
原文显示,起飞时刻缺失的航班有 8,255 行。is.na() 还可以帮助排序。arrange() 默认把缺失值排在末尾;若想先观察它们,可以先对缺失标记降序排序,再按实际值排序:
flights |>
  filter(month == 1, day == 1) |>
  arrange(dep_time)

flights |>
  filter(month == 1, day == 1) |>
  arrange(desc(is.na(dep_time)), dep_time)
用布尔运算组合条件
& 表示“且”,| 表示“或”,! 表示“非”,xor() 表示两者中恰好一个成立。例如,filter(!is.na(x)) 保留非缺失值,filter(x < -10 | x > 0) 保留小于 −10 或大于 0 的值。
不要在 dplyr 的逐行条件中把 &、| 改成短路运算符 &&、||。后者用于程序控制中的单个逻辑判断,不是这里需要的逐元素向量运算。
df <- tibble(x = c(TRUE, FALSE, NA))
df |>
mutate(and = x & NA, or = x | NA)| x | x & NA | x | NA |
|---|---|---|
| TRUE | NA | TRUE |
| FALSE | FALSE | NA |
| NA | NA | NA |
看起来不一致的结果,其实都在回答“未知值无论最终是什么,是否已经足以确定答案”。NA | TRUE 必为真;NA & FALSE 必为假。相反,NA | FALSE 和 NA & TRUE 都还取决于那个未知值。
“11 月或 12 月”必须是两个完整条件
# 正确
flights |>
  filter(month == 11 | month == 12)

# 反例:不是“11月或12月”
flights |>
  filter(month == 11 | 12)
第二种写法不一定报错,却会把所有行选出来。R 先计算 month == 11,再把这个逻辑向量与数字 12 做“或”运算。逻辑运算会把非零数转换为 TRUE,所以最终变成“某条件或真”,每一行都为真。原文用下面的中间列暴露这一错误:
flights |>
  mutate(
    nov = month == 11,
    final = nov | 12,
    .keep = "used"
  )
成员关系运算符 %in% 可以让多值比较更直接:
1:12 %in% c(1, 5, 11)
letters[1:10] %in% c("a", "e", "i", "o", "u")

flights |>
  filter(month %in% c(11, 12))
x %in% y 的结果长度与 x 相同,逐个判断 x 的值是否出现在 y 中。它对缺失值的处理与 == 不同:
c(1, 2, NA) == NA
# 原文:NA NA NA
c(1, 2, NA) %in% NA
# 原文:FALSE FALSE TRUE

flights |>
  filter(dep_time %in% c(NA, 0800))
最后一例选择起飞时刻缺失或等于 800 的航班,原文显示 8,803 行。这里的 0800 是例子中的数值写法,不是独立的时间类型。
any 与 all:是否存在,是否全部
any(x) 检查是否至少有一个真值,all(x) 检查是否所有值都为真。与许多汇总函数一样,可以用 na.rm = TRUE 排除缺失。原文按日检查出发延误是否全部不超过一小时,以及是否有到达延误至少五小时的航班。下面只把结果列名改成更准确的含义,计算条件与原文相同:
flights |>
  group_by(year, month, day) |>
  summarize(
    all_within_one_hour = all(dep_delay <= 60, na.rm = TRUE),
    any_long_delay = any(arr_delay >= 300, na.rm = TRUE),
    .groups = "drop"
  )
原文把第一列叫作 all_delayed,但 dep_delay <= 60 也包含提前和准点出发,不能读成“全部发生延误”。本稿的列名修改是编辑澄清。单个真假值往往仍太粗,继续数出符合条件的数量和比例更有信息。
sum 与 mean:数量和比例从哪里来
在数值运算里,TRUE 变为 1,FALSE 变为 0。因此 sum() 可计算真值数量,mean() 可计算真值比例。对应前面的条件:
flights |>
  group_by(year, month, day) |>
  summarize(
    proportion_within_one_hour = mean(dep_delay <= 60, na.rm = TRUE),
    count_long_delay = sum(arr_delay >= 300, na.rm = TRUE),
    .groups = "drop"
  )
原文 2013 年 1 月 1 日的输出为约 0.939 和 3,这里仍只调整了第一列名称。na.rm = TRUE 的分母是该条件中非缺失的观测数,不是当天所有航班数。
编辑补充:把分母与缺失数量一并保存,更容易复核结果:
flights |>
  group_by(year, month, day) |>
  summarize(
    n_all = n(),
    n_known_dep_delay = sum(!is.na(dep_delay)),
    n_missing_dep_delay = sum(is.na(dep_delay)),
    n_within_one_hour = sum(dep_delay <= 60, na.rm = TRUE),
    proportion_within_one_hour = mean(dep_delay <= 60, na.rm = TRUE),
    .groups = "drop"
  )
若一组数据全部缺失,排除后已经没有有效观测:均值可能得到 NaN,而空逻辑向量的 all() 为真、any() 为假。不能把这些计算约定当作“所有真实航班都满足条件”的证据;报告有效观测数可以暴露这种情况。这是本稿额外提醒的边界。
在汇总中使用逻辑索引
若只关心真正晚到的航班,可以先过滤再算均值:
flights |>
  filter(arr_delay > 0) |>
  group_by(year, month, day) |>
  summarize(
    behind = mean(arr_delay),
    n = n(),
    .groups = "drop"
  )
但如果还要计算提前到达的平均值,就得另外过滤再合并。base R 的 [ 索引可以在一个汇总表达式内选择子集:
flights |>
  group_by(year, month, day) |>
  summarize(
    behind = mean(arr_delay[arr_delay > 0], na.rm = TRUE),
    ahead = mean(arr_delay[arr_delay < 0], na.rm = TRUE),
    n = n(),
    .groups = "drop"
  )
注意两段中的 n() 已经不是同一个分母:先过滤的版本统计晚到航班数;内部索引的版本统计当天全部航班数。原文 1 月 1 日对应 461 与 842,晚到均值约 32.5 分钟,提前均值约 −12.5 分钟。逻辑索引可能保留由未知条件带来的缺失元素,因此这里仍需要 na.rm = TRUE。
if_else:条件为真、为假、为未知时分别做什么
dplyr::if_else(condition, true, false) 根据逻辑向量选择结果,还可以用第四个参数 missing 指定条件为 NA 时的输出。先看原文故意简化的正负标签例子:
x <- c(-3:3, NA)
if_else(x > 0, "+ve", "-ve")
# 原文:"-ve" "-ve" "-ve" "-ve" "+ve" "+ve" "+ve" NA

if_else(x > 0, "+ve", "-ve", "???")
# 缺失条件对应 "???",零仍被误标为 "-ve"这只是说明接口的中间步骤。零既非正数也非负数,不能把它当作正确的最终分类。true 和 false 也可以是向量,例如实现一个简版绝对值,以及用另一个向量补缺失:
if_else(x < 0, -x, x)
# 原文:3 2 1 0 1 2 3 NA

x1 <- c(NA, 1, 2, NA)
y1 <- c(3, NA, 4, 6)
if_else(is.na(x1), y1, x1)
# 原文:3 1 2 6
如果继续使用 if_else(),可加上零值分支:
if_else(x == 0, "0", if_else(x < 0, "-ve", "+ve"), "???")这时正、负、零和未知都有了位置,但嵌套表达式已经开始难读。条件更多时,改用 case_when()。原书脚注也说明,dplyr 的 if_else() 相比 base R 的 ifelse(),能更明确处理缺失,并更可能对不兼容的输出类型给出有意义的错误。
case_when:把规则排成清楚的顺序
case_when() 受 SQL 的 CASE 启发,每条规则写成 condition ~ output。条件必须是逻辑向量;为真的位置采用对应输出:
x <- c(-3:3, NA)
case_when(
  x == 0   ~ "0",
  x < 0    ~ "-ve",
  x > 0    ~ "+ve",
  is.na(x) ~ "???"
)
没有规则匹配的位置默认得到 NA。可以用 .default 显式接住剩余情况:
case_when(
  x < 0 ~ "-ve",
  x > 0 ~ "+ve"
)
# 零和缺失都没有匹配,输出 NA

case_when(
  x < 0 ~ "-ve",
  x > 0 ~ "+ve",
  .default = "???"
)
如果多条条件同时成立,只使用第一条匹配规则。例如下面的 x > 2 永远没有机会把正数标为 big,因为前面的 x > 0 已经命中:
# 反例:更宽的条件抢先,big 分支不会生效
case_when(
  x > 0 ~ "+ve",
  x > 2 ~ "big"
)
原文用到达延误演示一组可读标签。各条件按从提前到延误的方向排列,后面的规则只需要处理尚未匹配的位置:
flights |>
  mutate(
    status = case_when(
      is.na(arr_delay)     ~ "cancelled",
      arr_delay < -30      ~ "very early",
      arr_delay < -15      ~ "early",
      abs(arr_delay) <= 15 ~ "on time",
      arr_delay < 60       ~ "late",
      arr_delay < Inf      ~ "very late"
    ),
    .keep = "used"
  )
需要检查恰好位于 −30、−15、15、60 这些边界的值,也要注意原代码最后一条 arr_delay < Inf 不覆盖正无穷。原作者提醒,混用大小方向时容易制造重叠条件。编辑补充:把到达延误缺失直接标作 cancelled 是教学标签,不是足以证明航班取消的业务判据;真实分析应核对取消或改降等字段与数据说明。
所有分支必须能够组成一种兼容的输出类型
if_else() 和 case_when() 不会任意把不同类型偷偷混在一起。以下是原文的错误示例,而不是可用的最终代码:
# 预期类型错误:字符与数字不兼容
if_else(TRUE, "a", 1)

# 预期类型错误:逻辑值与日期时间不兼容
case_when(
  x < -1 ~ TRUE,
  x > 0  ~ now()
)原书列出的常见兼容组合包括:数值与逻辑值,字符串与因子,日期与日期时间。NA 虽然本身通常是逻辑型缺失,但可以用于其他类型的缺失位置。这些规则贯穿 tidyverse;与其把每个错误用强制转换压下去,更应先决定结果列应该表达哪种数据。
把规则变成可以检查的练习
以下保留原章练习的任务内容,作为阅读后的核查路线;本稿没有执行练习,也没有把尚未核对的结果写成答案:
- 查看
near的函数定义,解释它如何判断近似相等,并判断sqrt(2)^2是否接近 2。 - 合用
mutate()、is.na()和count(),说明dep_time、sched_dep_time、dep_delay的缺失模式如何关联。 - 找出
arr_delay缺失而dep_delay不缺失的航班;再找出arr_time与sched_arr_time都不缺失、但arr_delay缺失的航班。 - 统计
dep_time缺失的行数,检查这些行的其他缺失列。若暂时假设它意味着取消,研究每日数量、取消比例与未取消航班平均延误的关系;报告必须保留这项假设。 - 解释
sum(is.na(x))与mean(is.na(x))各返回什么;查阅并比较逻辑向量上的prod()、min()与逻辑汇总函数。 - 利用
x %% 2 == 0和if_else(),给 0 到 20 标记奇偶;为c("Monday", "Saturday", "Wednesday")标记工作日/周末;再实现向量绝对值。 - 利用航班表的
month和day标记元旦、美国独立日、感恩节、圣诞节等日期:先生成逻辑列,再生成节日名称或NA。感恩节等日期依年份而变,不能只凭月份猜测。
逻辑向量的定义很简单,但它把比较、筛选、汇总和分类连接到一起。以后遇到字符串模式检测和日期比较,得到的也常常是同样的三值向量。先给条件命名、明确缺失处理,再检查分母和边界,可以让这些操作更容易解释和复核。
来源、许可与审阅边界
原书:R for Data Science (2e);作者 Hadley Wickham、Mine Çetinkaya-Rundel、Garrett Grolemund。原书网站公开许可为 CC BY-NC-ND 3.0。保留原作者与来源,不把免费阅读或公开许可自动当作翻译授权。
本稿压缩了重复的数据框打印,并明确标注列名修改、分母检查和业务边界等编辑补充。代码只做静态审阅,未安装 R 包、下载外部数据或执行示例;所示片段未包含系统命令、外部写入、硬编码秘密或动态执行输入。没有发现这些问题不代表代码已通过安全或业务正确性测试。原创示意图:未完纪。











暂无评论内容