


原文:Thijs Nieuwdorp,Orchestrating Polars Cloud Queries with Apache Airflow,Polars 官方博客,发表于 2026 年 2 月 17 日。本文为获授权的中文翻译整理,译编:未完纪;完整保留原文的编排模式,并对版本、异步状态和清理逻辑增加静态审查说明。
数据团队常需要定期运行 Polars 查询:聚合业务数据、保存分析结果,或计算仪表盘指标。Apache Airflow 负责以代码定义、调度和监控工作流,Polars Cloud 则负责远程计算。把二者结合,可以让 Airflow 实例保持轻量,把大部分数据处理交给按需启动的计算集群。
Polars Cloud 是托管的数据平台,可以在你的云环境中执行 Polars 查询,并管理基础设施和扩缩容。原文介绍了横向、纵向及组合扩展策略,以及基于开源流式引擎的执行方式;这是架构说明,不是对所有查询、硬件或云费用作出的性能保证。本文依次讨论单查询、等待结果、上下文管理、命名集群、认证装饰器、并行、多阶段和关停。
环境与成本:需要 Polars Cloud 账户、服务账户凭据、云资源及存储权限;读取示例数据、启动集群和写入对象存储都可能计费。代码使用 airflow.sdk,应按 Airflow 3 的 SDK 接口核对依赖,并匹配所部署的 polars、polars-cloud 版本。核对日期为 2026 年 10 月 5 日;本次没有认证云账户、创建集群或执行查询。
把服务账户保存为 Airflow Connection
首先在 Polars Cloud 中创建服务账户,取得 Client ID 和 Client Secret。创建方式可参见原文链接的 Polars Cloud 用户指南。
随后在 Airflow 中配置 Connection。原文使用 UI:进入 Admin > Connections,点击 + Add Connection,将 Connection ID 设为 polars_cloud,Connection Type 设为 HTTP,把 Client ID 填入 Login,把 Client Secret 填入 Password。
通过这种 UI 方式保存,秘密会进入 Airflow 数据库。如果这不符合组织的安全要求,应使用 Airflow 支持的 Secrets Backend 管理连接信息。不要把服务账户秘密直接写进 DAG 文件、提交到版本库或打印到任务日志。
Airflow 执行环境还需要安装 polars 与 polars-cloud:前者构建并操作查询,后者管理与 Polars Cloud 的连接。安装应遵循所用 Airflow 版本的依赖约束和部署方式;本文没有为未知环境给出未经核验的整套版本锁定文件。
先从提交一个查询开始
下面的 DAG 展示原文的“提交后返回”(fire-and-forget)模式。任务完成表示查询已经提交,不保证远程查询已经成功完成。保留这一差别,才能正确理解后续的等待与清理模式。
from datetime import datetime

import polars as pl
import polars_cloud as pc

from airflow.sdk import BaseHook, dag, task


@dag(start_date=datetime(2026, 1, 1), schedule="@daily")
def fire_and_forget_dag():
    @task()
    def aggregate_daily_sales():
        conn = BaseHook.get_connection("polars_cloud")
        pc.authenticate(client_id=conn.login, client_secret=conn.password)
        ctx = pc.ComputeContext(
            workspace="playground", cpus=8, memory=16, cluster_size=1
        )

        (
            pl.scan_parquet(
                "s3://polars-cloud-samples-us-east-2-prd/pdsh/sf100/lineitem/*.parquet",
                storage_options={"request_payer": "true"},
            )
            .group_by("l_linestatus")
            .agg(pl.len().alias("count"))
            .remote(ctx)
            .sink_parquet("s3://your-bucket/result-location/")
        )

    aggregate_daily_sales()


fire_and_forget_dag()版本修订:原文这里使用无参数 pl.count()。当前 Polars count 文档已把无参数用法标为弃用,建议用 pl.len() 统计上下文行数。本稿改为 pl.len().alias("count"),保留原来的输出列名。带列名的 pl.count("column") 统计非空值,不应把两者混为一谈。
@dag 把函数定义成有向无环图,函数名默认成为 DAG ID;@task() 把内部函数定义成任务。示例声明按天调度,start_date 使用 2026 年 1 月 1 日。编辑澄清:start_date 表示第一个数据区间的起点,不保证在该时刻立刻执行;定时 DAG 通常在数据区间结束后调度,具体参见 Airflow 数据区间说明。本段保留原文未显式设置 catchup 的形式,部署时需核对回填设置和时区。
任务开始后,BaseHook.get_connection("polars_cloud") 读取连接信息,pc.authenticate() 完成 SDK 认证。ComputeContext 描述查询运行的硬件环境:这里选择 playground workspace、8 个 vCPU、16 GB 内存和 1 个节点;也可以按实际需要指定实例类型和集群规模。
查询使用 Lazy API:scan_parquet() 建立对 PDS-H 示例数据的扫描计划,按 l_linestatus 分组计数。此时构建的是查询图。不要直接调用本地 collect() 把重计算拉到 Airflow worker;remote(ctx) 将其交给指定的远程计算环境,随后决定结果如何执行或保存。
静态审查提醒:示例的 S3 输入启用了请求者付费选项;输出 s3://your-bucket/result-location/ 是需替换的示例路径。按天调度的函数名并不会自动添加日期过滤,本段查询实际上扫描该通配路径下的全部输入。重试、回填或多次运行还可能重复计算并向相同结果前缀写入;真实作业应按数据区间规划输入、唯一输出前缀和幂等策略。
remote() 后面的操作决定等待方式
原文列出几种常用组合:
| 调用 | 作用与等待行为 |
|---|---|
.sink_parquet(path) |
将查询结果写入指定目录,使用分片 Parquet,避免分布式运行时把所有数据汇总成一个文件。提交后返回,不等待查询结束。 |
.show() |
执行并等待完成,把结果开头的行展示在日志中,适合调试,但可能暴露业务数据。 |
.execute() |
按计算环境的执行模式返回 DirectQuery 或 ProxyQuery。原文说明默认模式为 direct;返回对象可查询状态、剖析信息或等待结果。 |
.execute().await_result() |
等待完成并返回 QueryResult,其中包含状态、结果前若干行(原文为前 10 行)及完成后的结果存储位置等信息。 |
.execute().get_status() |
取得当前 QueryStatus,例如排队、已调度、运行中、成功、失败或取消。 |
fire-and-forget 释放 Airflow worker 很快,但 Airflow 只能确认提交步骤的状态。原文说明,查询结束后集群会等到空闲超时再关闭:当时默认值为 1 小时,可以在 ComputeContext 中设置 idle_timeout_mins=10,当时最小值为 10 分钟。这里保留原文的时效性描述,实际限制以所用 SDK 与服务配置为准。
在 DAG 函数内调用任务函数,会建立任务节点;最后在文件外层调用 DAG 函数,完成 DAG 定义。后面的多任务例子会通过返回值和依赖运算符把这些节点连接起来。
等待远程终态,让失败反映到 Airflow
如果必须知道查询是否成功,就保存提交返回的查询对象,在任务返回之前等待,并检查状态。下面是接在已创建的 query 对象后的原文核心逻辑:
query.await_result()
if query.get_status() != pc.QueryStatus.SUCCESS:
    raise ValueError("Query failed")
await_result() 会阻塞当前线程并轮询远程集群。查询不成功时抛出异常,可让 Airflow 把任务标为失败。等待模式适合需要失败可见性和下游依赖的任务,但会占用 worker 的执行资源;原文没有实现可延后的传感器或异步运营器,本稿也不把同步等待描述成已经节省了 worker 槽位。
用上下文管理器及时关闭专用集群
已经等待查询完成时,可以把 ComputeContext 用作上下文管理器:
with pc.ComputeContext(
    workspace="playground", cpus=8, memory=16, cluster_size=1
) as ctx:
    query = (
        pl.LazyFrame({"value": [1, 2, 3]})
        .select(pl.col("value").sum())
        .remote(ctx)
        .execute()
    )
    query.await_result()
    if query.get_status() != pc.QueryStatus.SUCCESS:
        raise ValueError("Query failed")
这是对原文上下文片段的说明性改写:为了使片段不包含省略号查询,改用三行内存数据求和,并通过 execute() 提交;进入前仍需完成认证。它没有在本次环境运行。
上下文进入时启动计算环境,离开时关闭。关键边界是:关闭动作不会因为还有查询运行而自动等待。若只提交 execute() 就立即离开作用域,查询可能尚未完成就失去计算资源。异常退出也可能触发关闭,因此这个模式应只用于由当前任务拥有的专用集群,并事先确定中断策略。
用 manifest 复用命名集群
前面的集群都是临时指定配置、按查询创建的。Polars Cloud 也可以保存预先定义的命名集群配置,称为 manifest。它把 CPU、内存或实例类型等配置集中起来,使用方只需指定 workspace 和名字;当多人或多个任务连续查询同一个仍在运行的集群时,还可以减少反复启动和关闭的开销。
在计算面板进入 Manifests 标签,点击 + Add new manifest,可以设置集群规模、实例类型、Python 版本和 worker 需要的额外依赖。也可以用代码登记一个配置:
pc.ComputeContext(
    workspace="playground", cpus=8, memory=16, cluster_size=3
).register("airflow-big")
之后通过名字创建或重新连接计算环境:
pc.ComputeContext(workspace="playground", name="airflow-big")manifest 必须已经存在,否则查询不能运行。复用集群有利于提高资源利用,但也意味着不能随意调用 stop():如果同一个 manifest 对应的集群仍有其他用户、DAG 或运行实例使用,关停会影响他们。共享计算与自动关停之间需要明确的所有权约定。
把认证封装成任务装饰器
Airflow 任务通常分别在各自进程中执行,不能假设一个任务的 SDK 认证状态会自动出现在另一个任务。可以把读取 Connection 和认证的逻辑封装为装饰器:
from functools import wraps


def authenticate(fn):
    """运行任务函数前,先向 Polars Cloud 认证。"""
    @wraps(fn)
    def authenticated_fn(*args, **kwargs):
        conn = BaseHook.get_connection("polars_cloud")
        pc.authenticate(client_id=conn.login, client_secret=conn.password)
        return fn(*args, **kwargs)

    return authenticated_fn
任务函数上先写外层 @task(),再写内层 @authenticate。这样 Airflow 定义的是一个在执行时先认证、再运行查询的任务;wraps() 保留被包装函数的名称和元数据。此处依赖前面已经导入的 BaseHook 和 pc。
在同一个多节点集群上并行查询
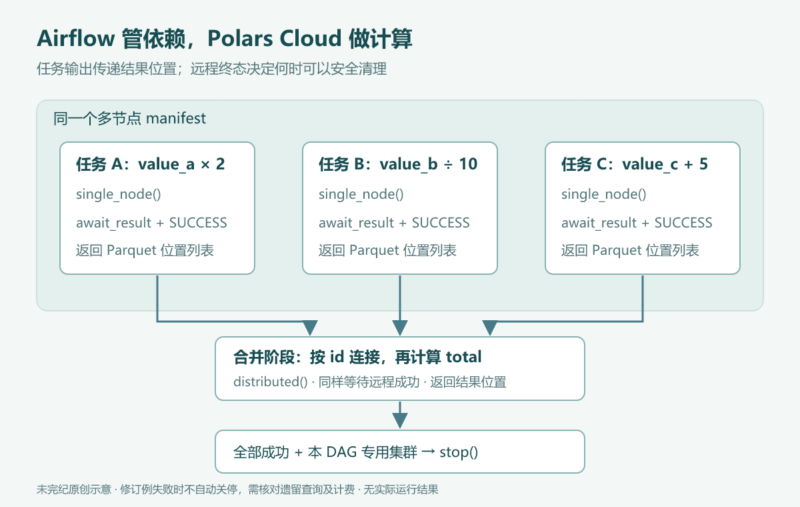
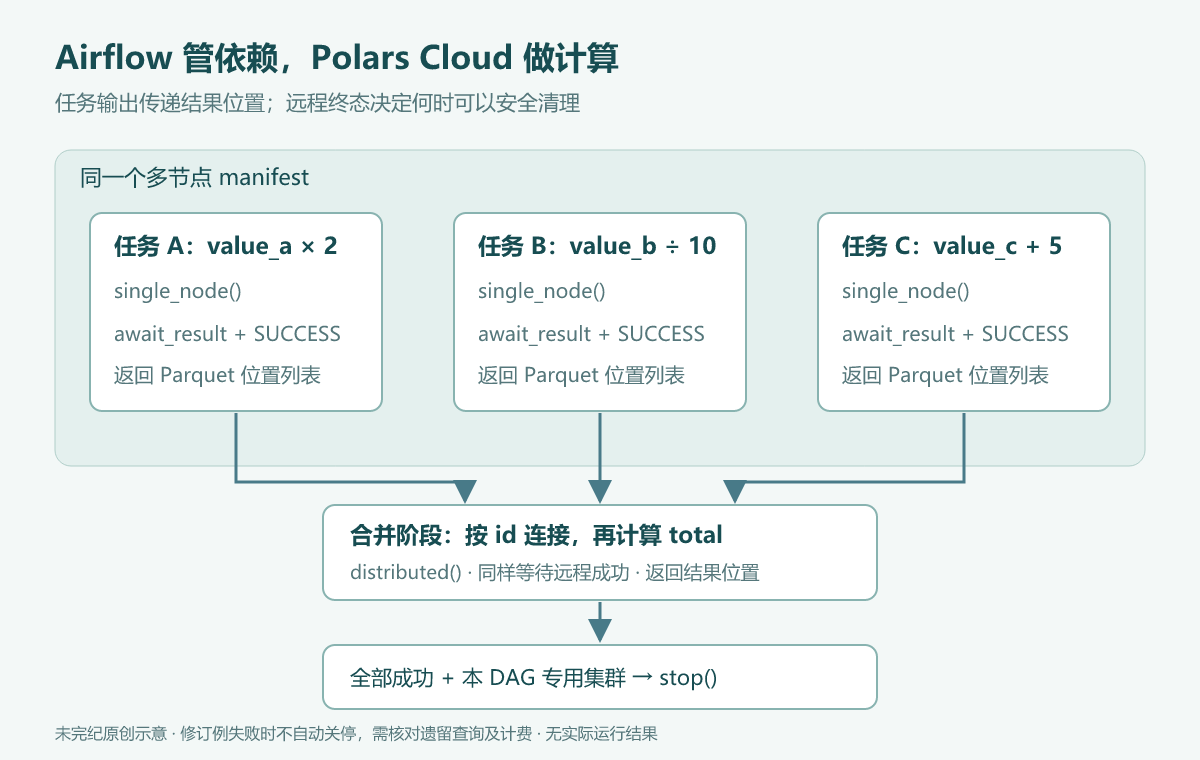
原文中的三个查询任务使用同一个 WORKSPACE 和 MANIFEST_NAME,没有相互依赖,因此 Airflow 可以并行调度。远程查询还需要在 remote(ctx) 后调用 single_node(),告诉 Polars Cloud 每个查询只需要一个 worker:
query = (
    pl.LazyFrame({"id": [1, 2, 3], "value": [10, 20, 30]})
    .with_columns(pl.col("value") * 2)
    .remote(ctx)
    .single_node()
    .execute()
)
query.await_result()
这个片段以具体的小数据替换原文的 my_query 占位符,并增加等待以便后续依赖确认完成;具体远程计算上下文仍由前文提供。原文默认使用 distributed() 让一个查询占用整个集群,这类查询会使其他分布式查询排队。single_node() 为多个独立查询共享多节点集群提供了并发条件,但实际能否同时运行还取决于 worker 数量、资源占用与调度限制。
多阶段任务之间传递结果位置
任务间传递的数据需要能够序列化,因此不宜把运行中的查询对象直接从一个任务交给另一个任务。原文使用 Polars Cloud 的临时结果存储:第一阶段等待查询结束,返回 QueryResult.location 中的 Parquet 文件位置列表;第二阶段用 pl.scan_parquet(result_locations) 建立新的 LazyFrame,再继续远程计算。
query_result = query.await_result()
if query_result.location is None:
    raise ValueError("Query result location is None")
return query_result.location
上面是任务函数中的返回片段。返回的 list[str] 能被 Airflow 序列化,并通过任务输出建立下游依赖,例如 stage_2(stage_1())。第二阶段可在扫描后调用 with_columns() 等操作,最后再 remote(ctx),原文用 show() 展示该阶段结果。
原文说临时结果只保留数小时,这不是持久存储承诺,也不应当作今天的固定 SLA。下游重试、长时间排队或延后重跑,可能遇到临时结果已经过期。需要跨较长时间保留结果时,应把数据写到自己管理的持久对象存储,并设计保留与清理规则。结果位置本身也可能带有访问能力或暴露数据路径,不能无差别写进公开日志。
手动关停:先确认远程终态,再讨论 trigger rule
原文通过一个设置 TriggerRule.ALL_DONE 的清理任务调用 ctx.stop(),并把上游任务连接到它。这表示直接上游任务无论成功或失败,只要进入结束状态,就允许执行清理。原文的简化片段是:
@task(trigger_rule=TriggerRule.ALL_DONE)
@authenticate
def cluster_shutdown():
    ctx = pc.ComputeContext(workspace=WORKSPACE, name=MANIFEST_NAME)
    ctx.stop()

# task1、task2、task3 表示实际创建的上游任务。
[task1, task2, task3] >> cluster_shutdown()
这是一段解释原文策略的片段,不可脱离上游定义直接运行。静态审查发现三个需要明确的边界:
- Airflow 任务结束不等于远程查询结束。fire-and-forget 任务提交后就返回,若把它直接接到关停任务,会过早中断查询。
- 只把最终合并任务接到清理任务不够稳妥。原文的完整示例使用
final >> cluster_shutdown()。如果合并任务因上游失败而提早进入upstream_failed,不能仅据此推断其他并行分支的远程查询已经结束。 - 清理成功可能遮住业务失败。Airflow 文档说明,DAG run 状态按叶节点确定;若唯一叶节点是
all_done清理任务,它成功后可能使中间有失败的 DAG run 仍显示成功。
如果确实要求失败后也立即回收,应记录并核对每个已提交远程查询的 ID 和终态,区分“查询已失败”与“监控连接失败但查询还在运行”,并明确取消及计费策略。仅增加一个 ALL_DONE 依赖,不能完成这些保证。共享集群更不能用当前 DAG 的结束状态决定整体关停。
整合示例:并行计算、合并结果、成功后清理
原文把乘法、除法和加法三个小查询并行执行,再按 id 连接,计算 total。下面保留这条数据路径,并给出经过静态审阅、尚未运行的编辑修订版。使用前必须创建名为 airflow-big、仅供此 DAG 使用的 manifest,并配置正确的 Connection。
与原文相比,这个版本显式等待并检查每个查询的成功状态;增加 catchup=False 与 max_active_runs=1;将清理改为 ALL_SUCCESS,且直接依赖全部计算任务;将最终的 print(...show()) 改为返回结果位置,避免把数据行写进日志。失败时不会自动调用 stop(),需依据预先配置的空闲超时和受控运维流程回收,可能因此产生额外费用。这个取舍是有意改变原文行为,不是声称已经实现完整的失败清理系统。
from datetime import datetime
from functools import wraps

import polars as pl
import polars_cloud as pc

from airflow.sdk import BaseHook, TriggerRule, dag, task


def authenticate(fn):
    @wraps(fn)
    def authenticated_fn(*args, **kwargs):
        conn = BaseHook.get_connection("polars_cloud")
        pc.authenticate(client_id=conn.login, client_secret=conn.password)
        return fn(*args, **kwargs)
    return authenticated_fn


def await_locations(query) -> list[str]:
    result = query.await_result()
    if query.get_status() != pc.QueryStatus.SUCCESS:
        raise RuntimeError("Remote query did not succeed")
    if result.location is None:
        raise ValueError("Query result location is None")
    return result.location


WORKSPACE = "playground"
# 必须是当前 DAG 专用的 manifest;不得指向他人共享集群。
MANIFEST_NAME = "airflow-big"

multiplication_query = pl.LazyFrame({"id": [1, 2, 3], "value_a": [10, 20, 30]})
division_query = pl.LazyFrame({"id": [1, 2, 3], "value_b": [100, 200, 300]})
addition_query = pl.LazyFrame({"id": [1, 2, 3], "value_c": [5, 15, 25]})


@dag(
    schedule="@daily",
    start_date=datetime(2026, 1, 1),
    catchup=False,
    max_active_runs=1,
)
def multistage_pipeline():
    @task()
    @authenticate
    def multiplication() -> list[str]:
        ctx = pc.ComputeContext(workspace=WORKSPACE, name=MANIFEST_NAME)
        query = (
            multiplication_query.with_columns(pl.col("value_a") * 2)
            .remote(ctx)
            .single_node()
            .execute()
        )
        return await_locations(query)

    @task()
    @authenticate
    def division() -> list[str]:
        ctx = pc.ComputeContext(workspace=WORKSPACE, name=MANIFEST_NAME)
        query = (
            division_query.with_columns(pl.col("value_b") / 10)
            .remote(ctx)
            .single_node()
            .execute()
        )
        return await_locations(query)

    @task()
    @authenticate
    def addition() -> list[str]:
        ctx = pc.ComputeContext(workspace=WORKSPACE, name=MANIFEST_NAME)
        query = (
            addition_query.with_columns(pl.col("value_c") + 5)
            .remote(ctx)
            .single_node()
            .execute()
        )
        return await_locations(query)

    @task()
    @authenticate
    def combine_results(
        result_locations_query_1: list[str],
        result_locations_query_2: list[str],
        result_locations_query_3: list[str],
    ) -> list[str]:
        lf_1 = pl.scan_parquet(result_locations_query_1)
        lf_2 = pl.scan_parquet(result_locations_query_2)
        lf_3 = pl.scan_parquet(result_locations_query_3)
        ctx = pc.ComputeContext(workspace=WORKSPACE, name=MANIFEST_NAME)
        query = (
            lf_1.join(lf_2, on="id")
            .join(lf_3, on="id")
            .with_columns(
                (pl.col("value_a") + pl.col("value_b") + pl.col("value_c"))
                .alias("total")
            )
            .remote(ctx)
            .distributed()
            .execute()
        )
        return await_locations(query)

    @task(trigger_rule=TriggerRule.ALL_SUCCESS)
    @authenticate
    def cluster_shutdown():
        ctx = pc.ComputeContext(workspace=WORKSPACE, name=MANIFEST_NAME)
        ctx.stop()

    multiplication_results = multiplication()
    division_results = division()
    addition_results = addition()
    final = combine_results(
        multiplication_results, division_results, addition_results
    )
    [multiplication_results, division_results, addition_results, final] >> cluster_shutdown()


multistage_pipeline()
三个上游任务返回结果位置列表;合并任务扫描它们,按 id 进行两次连接,再计算三列之和。这里沿用原文默认连接语义;真实数据若有重复键或缺失键,结果行数与保留范围会与小型示例不同,需要单独验证。
max_active_runs=1 只约束当前 DAG 的运行实例,不阻止其他 DAG 或用户使用同一个 manifest,也不能阻止失败后遗留的远程查询与后一次运行重叠。因此专用集群、失败后的远程状态核对、结果持久化以及重试幂等性仍是部署前提。最终返回的位置仍然属于临时结果存储,不能当成永久归档。
查看查询状态,不把演示当作基准测试
原文说明,任务日志中会出现计算面板的链接,可据此在 Polars Cloud 界面查看查询状态。其演示截图中的资源使用率较低,是因为输入只有少量示例数据,不能据此估算真实生产集群的利用率或成本。
原文在 2026 年 2 月预告过后续会提供更深入的实时查询剖析。本稿保留这一点作为文章当时的产品背景,不把“即将推出”改写为今天的功能承诺;当前功能应以 Polars Cloud 文档和实际账户界面为准。
这些模式可以按工作负载组合:不需由 Airflow 监控的查询可以只负责提交;需要失败可见性的查询要等待终态;多阶段查询传递可序列化的结果位置;并行任务以 single-node 查询共享多节点资源;关停必须建立在查询状态和集群所有权清楚的基础上。Airflow 负责依赖和调度,实际数据计算由 Polars Cloud 完成。
核验结论:已读源文全文并逐段核对代码;没有执行查询、访问对象存储、使用凭据或触发关停。静态审查识别了无参数 pl.count() 弃用、异步提交和远程完成的差别、共享集群关停、ALL_DONE 叶节点掩盖失败、日志数据暴露及临时结果过期等问题。上文修订版明确列出了与原文的差异;没有发现其他问题,不等于不存在漏洞,也不代表 SDK、Airflow 或云权限组合已经测试通过。
版权与许可:原文作者为 Thijs Nieuwdorp,来源为 Polars 官方博客,发表日期为 2026 年 2 月 17 日;保留原文链接与作者归属。源页未明确列出文章专用开放许可,不把 Polars 软件的开源许可自动套用于博客正文。本文增加了中文翻译、时效及静态审查说明,并标明代码修订;配图为未完纪原创。











暂无评论内容