


原作者:Michela Paganini。原文:PyTorch 官方《Pruning Tutorial》。未完纪中文翻译整理,保留 BSD 3-Clause 许可。LeNet 模型归属原文引用的 LeCun 等人(1998)。
读取日期:2026-10-05。源站构建标识为 PyTorch Tutorials 2.14.0+cu130;教程创建于 2019-07-22,最后更新 2023-11-02,页面记录最后核验为 2024-11-05。下文是机制示例,未训练模型,也未在本次执行代码、测量精度或测速。
先分清“剪掉连接”和“让部署更快”
过度参数化模型往往难以放进存储、能耗和算力受限的设备。剪枝尝试减少有效连接,为模型压缩与稀疏计算创造条件,也可用于研究网络学习动力学、稀疏子网络和“彩票假说”中的初始化作用。原文引用 The Lottery Ticket Hypothesis 作为相关研究背景。
本教程的目标更具体:用 torch.nn.utils.prune 把参数中的一些元素置零,观察 PyTorch 怎样保存原参数、应用掩码,再自己写一个剪枝规则。它没有训练或评估分类准确率,也没有把网络改造成更小的算子。因此,置零比例、文件大小、显存占用和真实推理速度是不同指标,不能互相替代。
原页最低要求写为 torch>=1.4.0a0+8e8a5e0,这是教程诞生时期的历史下界,不是现在应安装的版本。本稿保留这一背景;实际复现应使用项目已锁定、与目标设备适配的 PyTorch 版本并检查 API。下面所有输出若有数字,均明确来自原文或由张量结构推导,不是本次运行结果。
建立用于观察的 LeNet
import torch
from torch import nn
import torch.nn.utils.prune as prune
import torch.nn.functional as F

device = torch.device("cuda" if torch.cuda.is_available() else "cpu")

class LeNet(nn.Module):
    def __init__(self):
        super().__init__()
        self.conv1 = nn.Conv2d(1, 6, 5)
        self.conv2 = nn.Conv2d(6, 16, 5)
        self.fc1 = nn.Linear(16 * 5 * 5, 120)
        self.fc2 = nn.Linear(120, 84)
        self.fc3 = nn.Linear(84, 10)

    def forward(self, x):
        x = F.max_pool2d(F.relu(self.conv1(x)), (2, 2))
        x = F.max_pool2d(F.relu(self.conv2(x)), 2)
        x = x.view(-1, int(x.nelement() / x.shape[0]))
        x = F.relu(self.fc1(x))
        x = F.relu(self.fc2(x))
        return self.fc3(x)

model = LeNet().to(device=device)
第一层接收 1 个通道,输出 6 个通道,卷积核为 5×5;随后是 16 通道卷积和 120、84、10 维全连接层。16 * 5 * 5 要求卷积池化后得到这一尺寸,例如该结构接收单通道 32×32 图像时可满足;任意尺寸输入不能保证成立。示例只创建随机初始化模型,不下载数据、不加载外部权重,也没有训练循环。
检查一个还没有剪枝的模块
module = model.conv1
print(list(module.named_parameters()))
print(list(module.named_buffers()))
此时参数包括 weight 与 bias,缓冲区列表为空。conv1.weight 的形状是 [6, 1, 5, 5],共有 150 个权重;bias 有 6 个元素。原文逐次打印完整随机张量,本稿省略重复大数组,保留各次检查命令、名称变化与重要输出解释。随机初始化、设备和执行顺序改变时,具体浮点数与剪枝位置会变化。
随机非结构化剪枝如何改变参数
选择一个剪枝方法,指定模块与参数名,再传入该方法需要的参数。amount 若为 0 到 1 之间的浮点数,表示比例;若为非负整数,表示要剪掉的元素个数。两种写法的含义不同:0.3 是 30%,3 是三个元素。
prune.random_unstructured(module, name="weight", amount=0.3)

print(list(module.named_parameters()))
print(list(module.named_buffers()))
print(module.weight)
print(module._forward_pre_hooks)
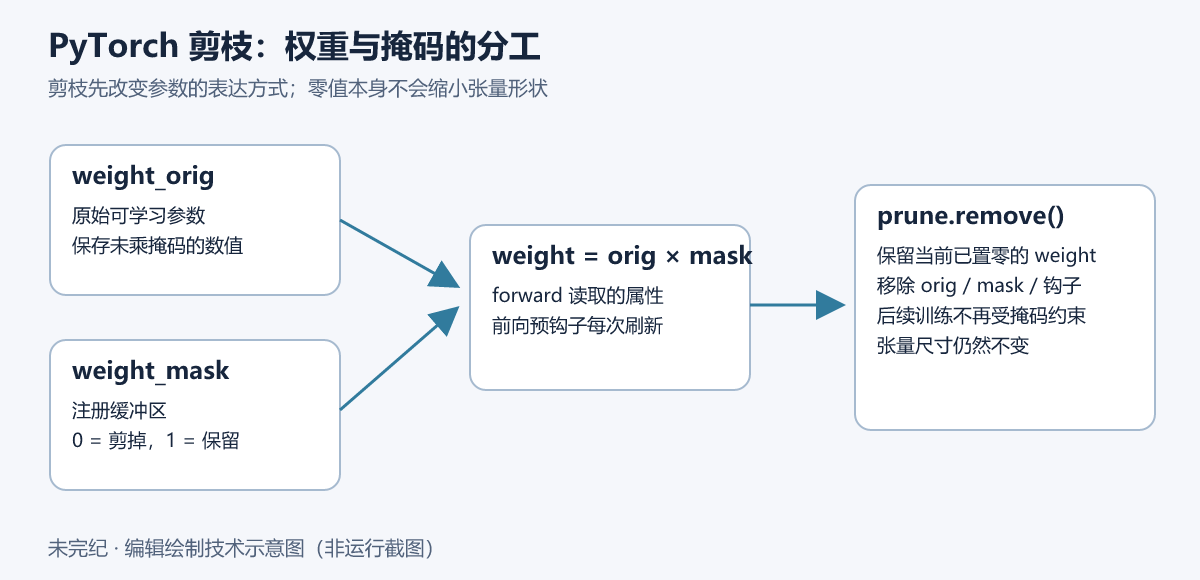
调用之后,原参数 weight 从参数列表中移走,改由 weight_orig 保存尚未施加掩码的原始参数。剪枝生成的二值掩码存成 weight_mask 缓冲区。模块仍有 weight 属性,供原来的 forward 使用,但此时它是由 weight_orig * weight_mask 得到的张量,不再是注册参数。
| 位置 | 随机剪枝前 | 随机剪枝后 |
|---|---|---|
| 注册参数 | weight、bias | weight_orig、bias |
| 缓冲区 | 无 | weight_mask |
| forward 读取的 weight | 注册参数 | 原参数与掩码逐元素相乘的属性 |
| 前向预钩子 | 无剪枝钩子 | 一个 RandomUnstructured 钩子 |
每次前向传播之前,forward_pre_hook 会重新计算被剪枝属性,使修改后的原参数仍按掩码参与运算。示例读取 _forward_pre_hooks 是为了观察内部实现,以下划线开头的内部属性不应成为应用长期依赖的稳定接口。掩码中的 0 将相应连接的当前输出权重变成 0,1 则保留它。
再对偏置按幅值剪枝
prune.l1_unstructured(module, name="bias", amount=3)
print(list(module.named_parameters()))
print(list(module.named_buffers()))
print(module.bias)
print(module._forward_pre_hooks)
L1 非结构化剪枝选出绝对值最小的 3 个偏置。现在参数是 weight_orig 与 bias_orig,缓冲区有 weight_mask 与 bias_mask,weight、bias 则都是带掩码的属性,并各有一个前向预钩子。原页的 bias_mask 为 [1, 1, 1, 0, 0, 0],对应偏置中的后三项被置零;这只描述源页那一次随机模型。
迭代剪枝会合并掩码
同一个参数可以被多次剪枝。新一次规则作用于尚未剪掉的部分,PruningContainer 负责结合旧掩码与新掩码,已经被剪掉的连接不会因为下一次剪枝自动恢复。下面沿 weight 的第 0 维按通道 L2 范数剪枝:
prune.ln_structured(
    module, name="weight", amount=0.5, n=2, dim=0
)
print(module.weight)

for hook in module._forward_pre_hooks.values():
    if hook._tensor_name == "weight":
        print(list(hook))
对 conv1 而言,第 0 维是 6 个输出通道;amount=0.5 在这个例子里把 3 个通道的整片权重置零,同时保留之前随机掩码的效果。n=2 选择 L2 范数,dim=0 指定结构方向。注意,这里只是掩码为整通道的零,没有自动改写 Conv2d 的输出通道数,也没有把相邻层改成更小的网络。
weight 对应的钩子变成 PruningContainer,其中保存 RandomUnstructured 与 LnStructured 的应用历史。bias 的剪枝是另一个参数自己的处理链。
保存状态与移除重参数化
剪枝所需的原参数和掩码都会进入 state_dict,可以随模型状态保存。此阶段原文展示的键包括:
conv1.weight_orig
conv1.bias_orig
conv1.weight_mask
conv1.bias_mask
conv2.weight
conv2.bias
fc1.weight
fc1.bias
fc2.weight
fc2.bias
fc3.weight
fc3.bias
查看方式是 print(model.state_dict().keys())。编辑补充:这些键与从未应用剪枝的 LeNet 不同,不能想当然地把它当作普通 weight/bias 状态直接加载;恢复前需要让目标模型的重参数化结构与键匹配,或者先按下述方式移除重参数化后保存。加载外部模型文件还涉及独立的反序列化信任问题,本文没有加载任何外部文件。
prune.remove(module, 'weight')
print(list(module.named_parameters()))
print(list(module.named_buffers()))
remove() 的含义不是撤销剪枝。它把当前已经乘过掩码、包含零值的结果重新注册为 weight 参数,移除 weight_orig、weight_mask 和该参数的前向预钩子。由于这里只 remove weight,bias_orig 与 bias_mask 仍保留。
原文称这一步把剪枝“固定下来”,需要准确理解:零值被写入普通参数,但已没有掩码持续约束它。若之后继续训练,梯度与优化器状态可能使这些位置再次出现非零值。需要永久保留稀疏模式时,要在训练和部署设计中继续维护相应约束,而不能只凭一次 remove() 推断。
对多个层分别设置比例
遍历 named_modules() 可以按层类型应用不同策略。以下使用一份新的模型,避免与前面的演示状态混在一起:
new_model = LeNet()
for name, module in new_model.named_modules():
    if isinstance(module, nn.Conv2d):
        prune.l1_unstructured(module, name='weight', amount=0.2)
    elif isinstance(module, nn.Linear):
        prune.l1_unstructured(module, name='weight', amount=0.4)

print(dict(new_model.named_buffers()).keys())
这会给两个卷积层分别剪掉 20% 权重,给三个全连接层分别剪掉 40% 权重。检查缓冲区时,应能看到 conv1.weight_mask、conv2.weight_mask、fc1.weight_mask、fc2.weight_mask、fc3.weight_mask。比例按每个张量分别计算,bias 没有包含在本轮规则里。
全局剪枝:让各层竞争同一个预算
局部剪枝在每个张量内部比较重要性;全局剪枝把指定的一组参数一起比较。例如全局 L1 剪枝去掉所有被选权重中幅值最小的 20%,各层最终比例通常不同。这里的“全局”由你传入的参数列表定义,并不自动包含模型全部参数。
model = LeNet()
parameters_to_prune = (
    (model.conv1, 'weight'),
    (model.conv2, 'weight'),
    (model.fc1, 'weight'),
    (model.fc2, 'weight'),
    (model.fc3, 'weight'),
)

prune.global_unstructured(
    parameters_to_prune,
    pruning_method=prune.L1Unstructured,
    amount=0.2,
)

# 编辑整理:等价地循环统计所选权重,而非重复五段打印代码。
zero_count = 0
element_count = 0
for layer, name in parameters_to_prune:
    value = getattr(layer, name)
    zeros = int((value == 0).sum().item())
    total = value.numel()
    print(f'{type(layer).__name__}.{name}: {100 * zeros / total:.2f}%')
    zero_count += zeros
    element_count += total
print(f'Global sparsity: {100 * zero_count / element_count:.2f}%')
源页的一次输出为 conv1 8.00%、conv2 14.33%、fc1 22.03%、fc2 12.82%、fc3 8.33%,合计 20.00%。这些是原文记录,不是本次复现或普遍目标比例。不同初始化会改变各层结果;比例转成整数元素数量还存在取整效应。若原权重本来就有零,按值统计的零比例也未必等于本次新剪掉的比例。
实现自己的剪枝方法
扩展 BasePruningMethod 时,常见情况下只需提供 compute_mask(),有可配置参数时再写 __init__(),并设置 PRUNING_TYPE。基类已经处理 __call__、apply_mask、apply、prune 和 remove,不必重复实现。
PRUNING_TYPE 可以是 unstructured、structured 或 global。这个标记不是装饰信息:迭代剪枝时,PruningContainer 要靠它判断应把尚未剪枝的哪一部分交给新方法。逐连接剪枝用 unstructured,按整单元或通道处理用 structured,跨参数处理则属于 global。
原文的教学规则是“每隔一个元素剪掉一个”。若参数之前已经剪过,规则会作用于容器选出的剩余部分:
class FooBarPruningMethod(prune.BasePruningMethod):
    """每隔一个元素剪掉一个;用于展示扩展接口。"""
    PRUNING_TYPE = 'unstructured'

    def compute_mask(self, t, default_mask):
        mask = default_mask.clone()
        mask.view(-1)[::2] = 0
        return mask

def foobar_unstructured(module, name):
    FooBarPruningMethod.apply(module, name)
    return module

model = LeNet()
foobar_unstructured(model.fc3, name='bias')
print(model.fc3.bias_mask)
这个函数原位修改传入模块,同时返回它;它像内置方法一样登记 name + “_mask”,把原参数保存为 name + “_orig”,并生成剪枝后的属性。fc3.bias 有 10 个元素,原文掩码输出为:
tensor([0., 1., 0., 1., 0., 1., 0., 1., 0., 1.])这只是说明接口的机械规则,不是有精度依据的剪枝算法。view(-1) 还要求张量布局可直接展平;这里的一维新偏置示例符合这一意图,但推广到非连续布局时需要专门处理并验证,不能随便把 view 换成可能返回拷贝的 reshape 后就假定原掩码会被修改。
把机制验证和部署验证分开
本教程说明了剪枝状态的组织方式:原参数、缓冲区掩码、被前向读取的属性与预钩子各有职责。部署前仍要用任务数据评估精度,决定是否微调,检查目标运行时是否支持所需稀疏结构,最后测量端到端延迟、吞吐、内存与产物大小。源页记录的脚本总耗时 0.547 秒属于其文档构建环境,不能用作本文或读者设备的性能结论。
静态审核未在展示代码中发现真实密钥、命令注入或破坏性操作,但这不代表相关依赖和完整训练部署流程不存在漏洞。本文未运行代码,未验证 CUDA,未测试任何速度或准确率声明。
许可证
以下保留 PyTorch Tutorials 仓库许可证的版权、条件与免责声明;中文表述、示例注释和排版已经编辑整理。
BSD 3-Clause License

Copyright (c) 2017-2022, Pytorch contributors
All rights reserved.

Redistribution and use in source and binary forms, with or without
modification, are permitted provided that the following conditions are met:

* Redistributions of source code must retain the above copyright notice, this
  list of conditions and the following disclaimer.
* Redistributions in binary form must reproduce the above copyright notice,
  this list of conditions and the following disclaimer in the documentation
  and/or other materials provided with the distribution.
* Neither the name of the copyright holder nor the names of its
  contributors may be used to endorse or promote products derived from
  this software without specific prior written permission.

THIS SOFTWARE IS PROVIDED BY THE COPYRIGHT HOLDERS AND CONTRIBUTORS "AS IS"
AND ANY EXPRESS OR IMPLIED WARRANTIES, INCLUDING, BUT NOT LIMITED TO, THE
IMPLIED WARRANTIES OF MERCHANTABILITY AND FITNESS FOR A PARTICULAR PURPOSE ARE
DISCLAIMED. IN NO EVENT SHALL THE COPYRIGHT HOLDER OR CONTRIBUTORS BE LIABLE
FOR ANY DIRECT, INDIRECT, INCIDENTAL, SPECIAL, EXEMPLARY, OR CONSEQUENTIAL
DAMAGES (INCLUDING, BUT NOT LIMITED TO, PROCUREMENT OF SUBSTITUTE GOODS OR
SERVICES; LOSS OF USE, DATA, OR PROFITS; OR BUSINESS INTERRUPTION) HOWEVER
CAUSED AND ON ANY THEORY OF LIABILITY, WHETHER IN CONTRACT, STRICT LIABILITY,
OR TORT (INCLUDING NEGLIGENCE OR OTHERWISE) ARISING IN ANY WAY OUT OF THE USE
OF THIS SOFTWARE, EVEN IF ADVISED OF THE POSSIBILITY OF SUCH DAMAGE.










暂无评论内容