


原文:Ask Solem 与 Celery 文档贡献者,Canvas: Designing Work-flows。本稿根据 2026-10-05 核对的 Celery 5.6.3 文档翻译整理。Celery 文档采用 CC BY-SA 4.0,本中文改编按相同许可提供;项目代码采用 BSD 3-Clause。完整原始版权和许可声明见文末。中文整理与原创图:未完纪。
当一个任务的结果要交给下一个任务,或一组并行任务都完成后才能汇总,单独调用 delay() 就不够表达完整关系。Canvas 把一次任务调用包装成可组合的“签名”,再用 chain、group、chord 等原语把这些签名组成工作流。本文假定已经配置 Celery 应用、worker、broker 和适当的结果后端;所有示例仅做静态审查,没有启动 worker 或执行任务。
一、签名保存的是“一次调用”
signature() 保存任务名、位置参数、关键字参数和执行选项。它能作为函数参数传递,也能序列化后发给其他进程。下面假定已有 add(x, y) 任务:
from celery import signature

sig = signature("tasks.add", args=(2, 2), countdown=10)
sig = add.signature((2, 2), countdown=10)
sig = add.s(2, 2)

sig = add.signature((2, 2), {"debug": True}, countdown=10)
print(sig.args)     # (2, 2)
print(sig.kwargs)   # {"debug": True}
print(sig.options)  # {"countdown": 10}
debug=True 仅在任务定义接受该参数时才有效,不能给任意 add 函数加上未定义参数。.s() 适合构造任务参数;执行选项应通过 .set() 设置,避免把选项误当成任务关键字参数。
sig = add.s(2, 2).set(countdown=1)

# 单个普通签名直接调用会在当前进程同步执行。
value = add.s(2, 2)()

# delay/apply_async 提交给 Celery 调度。
result = add.s(2, 2).delay()
result = add.s(2, 2).apply_async(countdown=1)
原教程大量使用交互式 .get() 读取结果;本文保留必要的用法,但它们是调用端观察结果的演示,不是让 worker 任务内部阻塞等待其他任务的建议。~sig 是 sig.delay().get() 的交互式快捷写法,不宜放进生产逻辑。
部分签名:新增位置参数加到前面
对签名调用 delay() 或 apply_async() 时还能补充参数。新增位置参数会加到已有参数前面;新增关键字和执行选项则与原值合并,同名新值覆盖旧值。
# 假定 subtract(x, y) 返回 x - y。
partial = subtract.s(10)
partial.delay(30)             # 实际调用 subtract(30, 10),不是 subtract(10, 30)
partial.apply_async((30,))    # 相同的参数排列

sig = add.s(2, 2)
sig.apply_async(kwargs={"debug": True})

sig = add.signature((2, 2), countdown=10)
sig.apply_async(countdown=1)  # 此次调用使用 1 秒倒计时

base = add.s(2)
derived = base.clone(args=(4,), kwargs={"debug": True})
# derived 表示 add(4, 2, debug=True)加法满足交换律,容易掩盖参数顺序错误;用减法理解这一规则更直观。clone() 用于从已有签名派生新调用,避免为了复用而不断修改同一个对象。
不可变签名:拒绝上一任务注入参数
链或回调通常会把父任务的返回值作为下一个任务的第一个参数。如果下一个任务不需要这个值,可设置 immutable=True,或使用快捷方式 .si()。不可变签名仍能调整执行选项,但不会接受额外的部分位置或关键字参数。
add.apply_async((2, 2), link=reset_buffers.signature(immutable=True))
add.apply_async((2, 2), link=reset_buffers.si())
回调仅在父任务成功后调用
link 把成功回调挂到任务上。下面先计算 2 + 2,再把结果 4 放到回调已有参数 8 前面,调用 add(4, 8)。这些算术值是按代码语义说明的预期值,不是本次运行记录。
add.apply_async((2, 2), link=add.s(8))二、六种组合原语
| 原语 | 作用 | 容易混淆的地方 |
|---|---|---|
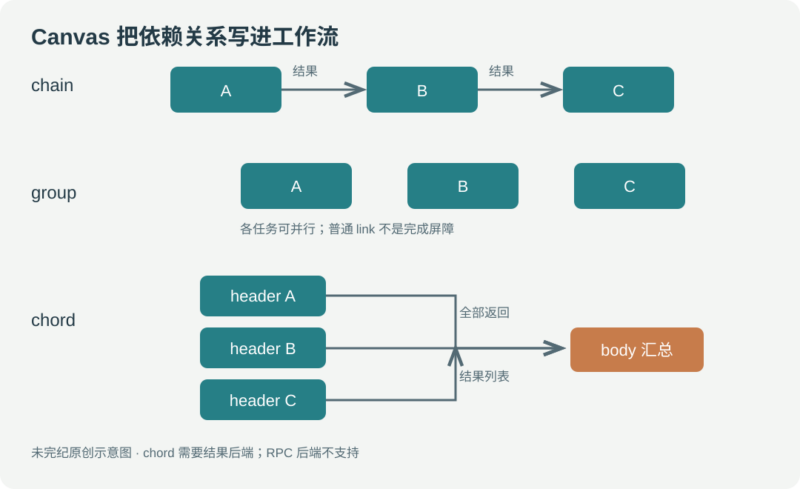
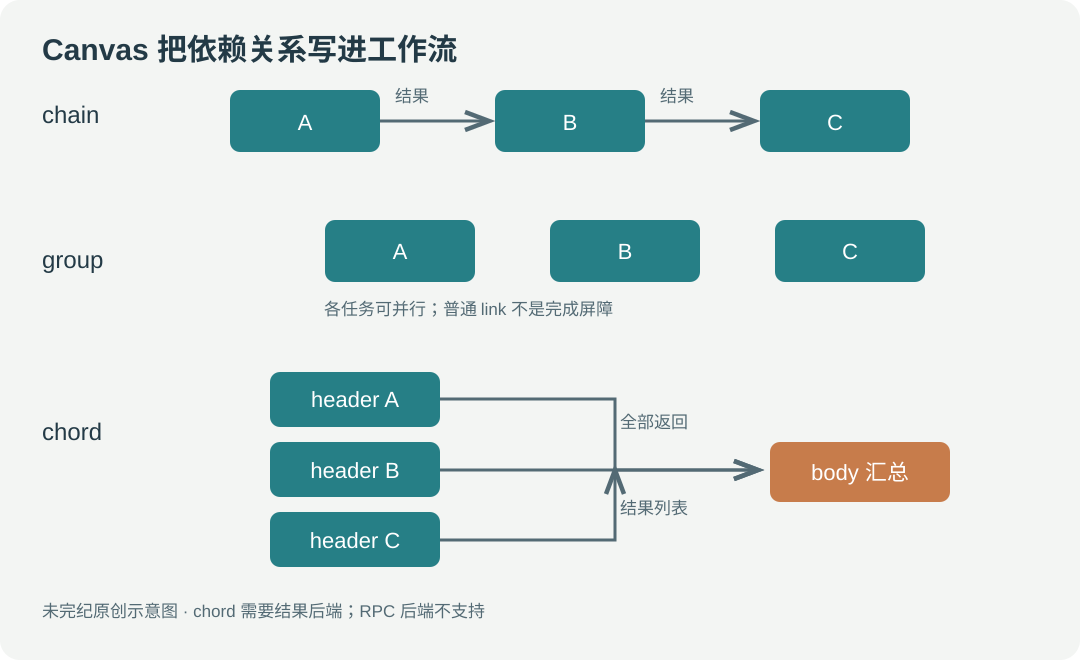
| chain | 按依赖顺序连接签名 | 默认把上一结果传给下一步 |
| group | 提交可并行执行的一组任务 | 普通 link 不是组完成屏障 |
| chord | 组内任务结束后执行汇总 body | 需要受支持的结果后端与结果保留 |
| map | 一个任务消息中,按顺序对每个元素调用任务函数 | 并不为每个元素分别发送消息 |
| starmap | 类似 map,但将每个元素解包为位置参数 | 内部仍是顺序执行 |
| chunks | 把大输入划分为多个任务块 | 块之间可并行,块内顺序处理 |
这些原语本身也是签名,所以可以继续组合、嵌套、补参数或设置执行选项。
from celery import chain, group, chord

pipeline = chain(add.s(2, 2), add.s(4), add.s(8))
result = pipeline.apply_async()
# 依次 add(2, 2) -> add(4, 4) -> add(8, 8),最终预期 16。

same_pipeline = add.s(2, 2) | add.s(4) | add.s(8)

independent = add.si(2, 2) | add.si(4, 4) | add.si(8, 8)
# 仍按顺序执行,但每步都使用自身参数,不接收上一结果。

parallel = group(add.s(i, i) for i in range(10))
parallel_result = parallel.apply_async()

summary = chord(
    [add.s(i, i) for i in range(10)],
    tsum.s(),
).apply_async()
最后一例假定 tsum(numbers) 返回 sum(numbers),它接收的是整个结果列表。若只需要在导入结束后发出通知,不想把列表作为参数,则把 body 写成 notify_complete.si(import_id)。
链也可以是不完整的。例如 add.s(4) | mul.s(8) 接收初始参数 16 后,会先加 4 再乘 8,预期得到 160。把已有链嵌入另一条链也可以,Canvas 会组合这些依赖。
partial_chain = add.s(4) | mul.s(8)
result = partial_chain.apply_async(args=(16,))

combined = add.s(4, 16) | mul.s(2) | (add.s(4) | mul.s(8))
result = combined.apply_async()

# group 后接一个汇总任务会升级为 chord。
result = (group(add.s(i, i) for i in range(10)) | tsum.s()).apply_async()
链的上一步结果也会分别转发给后面 group 里的各个可变签名。典型流程是先创建用户,再并行导入联系人与发送欢迎邮件:
workflow = create_user.s() | group(
    import_contacts.s(),
    send_welcome_email.s(),
)
# 假定 create_user 接受这些参数,并返回后续两任务所需的用户标识。
workflow.apply_async(kwargs={
    "username": "example_user",
    "first": "Example",
    "last": "User",
    "email": "user@example.com",
})

# 不希望把上一结果交给组内任务时,使用 si。
workflow = add.s(4, 4) | group(add.si(i, i) for i in range(10))原文风险提示的补充:文档指出复杂递归 Canvas 的 JSON 序列化可能显著放大消息体,并提到 pickle 可避免这一类膨胀。但 pickle 反序列化能执行任意代码,不能为了解决大小问题就接受不可信 pickle 消息。本文不把 pickle 当成通用修复方案;应先限制工作流规模、减少重复嵌套、隔离 broker 权限,并核对 Celery 的安全指南与序列化配置。
三、链:结果、错误回调与依赖图
链返回最终任务的结果对象,沿着 parent 可访问中间结果。Celery 5.4 起,链继承最后一个任务的任务 ID。普通链接任务还可从 children 查找后续结果。
result = (add.s(4, 4) | mul.s(8) | mul.s(10)).apply_async()

# 以下读取在客户端进行,并设置等待上限。
final_value = result.get(timeout=30)                # 预期 640
middle_value = result.parent.get(timeout=30)        # 预期 64
first_value = result.parent.parent.get(timeout=30)  # 预期 8

# 对具有结果子树的根结果对象,可迭代其依赖结果。
for task_result, value in root_result.collect(intermediate=True):
    print(task_result.id, value)
root_result 需要替换为实际工作流根任务的结果,不能把它当成前面自动定义的变量。collect() 把依赖结果视作图;默认遇到尚未形成完整结果的图会抛 IncompleteStream,intermediate=True 则允许中间状态。
用 on_error() 或 link_error 可以连接错误回调。worker 在文档所示 errback 路径中直接调用函数,以便传入原始 request、exception 与 traceback,而不是把这三者序列化成普通任务参数。
import logging
from proj.celery import app

logger = logging.getLogger(__name__)

@app.task
def log_error(request, exc, traceback):
    # 编者修订:不把 request.id 拼入文件路径,不直接输出 traceback 或业务参数。
    logger.error("Celery task failed: id=%r type=%s",
                 request.id, type(exc).__name__)

add.s(2, 2).on_error(log_error.s()).apply_async()
# 等价的连接方式:
add.apply_async((2, 2), link_error=log_error.s())
原例使用 open(os.path.join('/var/errors', request.id), 'a') 保存异常。若任务 ID 来源不可控,直接用作路径会扩大路径穿越或覆盖风险;异常和 traceback 还可能包含敏感信息。上面改为结构化日志式的最小字段输出,是安全改写,并不承诺日志系统天然具备访问控制、容量限制或去重。
结果中的 DependencyGraph 可以导出为 DOT,再由 Graphviz 绘图:
with open("graph.dot", "w", encoding="utf-8") as stream:
    result.parent.parent.graph.to_dot(stream)
dot -Tpng graph.dot -o graph.png这些命令仅展示导出方式,本稿配图是独立原创示意图,不声称已经导出了本次任务运行图。实际操作应选可写的临时目录,避免覆盖同名文件。
四、Group 的回调不是汇总屏障
group 可接收签名列表或生成器,返回 GroupResult,统一管理各个 AsyncResult。任务能否真正同时执行取决于 worker 并发与资源,并不是构造 group 就保证同时开始。
job = group(
    add.s(2, 2), add.s(4, 4), add.s(8, 8),
    add.s(16, 16), add.s(32, 32),
)
result = job.apply_async()
values = result.get(timeout=30)
# 预期列表:[4, 8, 16, 32, 64]
group 本身不是普通任务。给 group 加 link(),只是把连接传给它包含的签名:回调不会自动收到汇总结果列表,也不能保证只在全部成员完成后执行。原文故意给出的错误写法是:
# 反例,仅用于说明,不应作为汇总方案执行。
g = group(add.s(2, 2), add.s(4, 4))
g.link(add.s())
# add.s() 不会按预想接收到两个最终结果,因此会缺少参数。
同理,一个 group 的 link_error() 可能被多个失败成员分别调用。因此错误处理必须可重复执行,采用幂等写入或明确计数。需要“所有结果收齐后只执行一次汇总”的语义时,应使用 chord,同时核对所用后端的支持情况。
| GroupResult 方法 | 含义 |
|---|---|
| successful() | 所有子任务均成功 |
| failed() | 至少一个子任务失败 |
| waiting() | 至少一个子任务尚未就绪 |
| ready() | 所有子任务均已结束;不等同于全部成功 |
| completed_count() | 成功完成的任务数,失败不计入此数 |
| revoke() | 向全部子任务发送撤销请求;不能当作已执行副作用的回滚 |
| join() | 按任务在组内的顺序收集结果,而非完成先后顺序 |
单成员 group 会展开
在链中,只有一个签名的 group 会展开为该签名。因此下游可能收到标量,也可能在多成员组转成 chord 后收到列表,接口要事先设计清楚:
chain(add.s(2, 2), group(add.s(1)), add.s(1))
# 单成员展开:add(2, 2) | add(1) | add(1)

chain(add.s(2, 2), group(add.s(1), add.s(2)), consume_results.s())
# 多成员时,consume_results 应处理列表。
Celery 4.x 存在单成员组未正确展开、反而升级为 chord 的历史 bug,5.x 已修复。迁移旧工作流时不要假定两代版本的输入形状相同。上面将原文第二个示例的最终 add 替换为语义明确的列表消费者,是为避免暗示数值加法天然能接收列表。
五、Chord:并行 header 与汇总 body
chord 由 header 和 body 构成。header 的各任务可以在不同节点执行,全部返回后,结果按组的顺序组成列表传给 body。返回的任务 ID 是 body 的 ID,因此它的结果代表最终汇总完成。
from celery import chord
from proj.celery import app

@app.task(ignore_result=False)
def add(x, y):
    return x + y

@app.task(ignore_result=False)
def tsum(numbers):
    return sum(numbers)

header = [add.s(i, i) for i in range(100)]
callback = tsum.s()
result = chord(header)(callback)
# 客户端读取时,预期得到 9900:
value = result.get(timeout=30)
为了做 100 次整数加法而分发消息当然不划算;这个例子仅用于展示同步语义。真实系统需权衡消息和屏障开销。不要让一个 Celery 任务调用 .get() 阻塞等待另一个任务,这可能耗尽 worker 并发并造成死锁。
失败不会取消所有成员
header 中某个任务抛异常时,body 的结果会进入失败状态,携带 ChordError。错误信息包含失败任务 ID 和原始异常的字符串,原始 traceback 可通过结果对象查看。其他 header 任务仍可能继续执行;ChordError 通常只报告时间上首先失败的任务,不是 header 顺序中最前的任务,也不是完整失败清单。
@app.task
def on_chord_error(request, exc, traceback):
    logger.error("Chord failed: body=%r type=%s",
                 request.id, type(exc).__name__)

workflow = (
    group(add.s(i, i) for i in range(10))
    | tsum.s().on_error(on_chord_error.s())
)
workflow.apply_async()
chord 上的回调/错误回调会连接到 body。默认路径解决了普通 group 回调缺乏汇总屏障的问题;但启用 task_allow_error_cb_on_chord_header 后,失败 header 任务也会触发 body 的错误回调。因此不能不看配置就宣称错误通知一定只发生一次,副作用仍需幂等。
结果后端与同步机制
chord 必须启用 result_backend,header 和 body 都不能忽略结果。如果全局 task_ignore_result=True,参与的任务应显式设置 ignore_result=False,类式任务则设置同名属性。RPC result backend 不支持 chord。
多数后端通过周期任务检查组是否就绪,再触发回调。原文用如下简化代码解释机制,并非建议用户自行替换 Celery 内置实现:
from celery import maybe_signature

@app.task(bind=True)
def unlock_chord(self, group, callback, interval=1, max_retries=None):
    if group.ready():
        return maybe_signature(callback).delay(group.join())
    raise self.retry(countdown=interval, max_retries=max_retries)
这个内部同步示例中的 group.join() 不能推广为普通业务任务中等待子任务的写法。Redis、Memcached 与 DynamoDB 后端使用计数机制跟踪 header 完成,达到所需数量时触发 body。原文还保留 Redis 2.2 之前不支持相应行为的历史说明;这不是推荐使用已经非常陈旧的 Redis 2.2,部署应选当前受支持且与 Celery 匹配的版本。
使用 Redis 后端并覆盖 Task.after_return() 时,要调用父类方法,否则可能破坏 chord 回调触发:
def after_return(self, *args, **kwargs):
    do_something()
    super().after_return(*args, **kwargs)
六、Map、Starmap 与分块
map 和 starmap 都发送一个任务消息,在这个任务内顺序处理序列。map 每次传一个元素,starmap 把元素解包为 *args。这与每个元素独立发送消息的 group 有明显不同:
mapped = tsum.map([list(range(10)), list(range(100))])
mapped_result = mapped.apply_async()
# 一个任务内依次调用 tsum(range(10))、tsum(range(100));预期 [45, 4950]。

starred = add.starmap(zip(range(10), range(10)))
starred_result = starred.apply_async(countdown=10)
# 一个任务内依次 add(0,0)、add(1,1)…;预期 [0,2,4,...,18]。输入很多时,可以在细粒度并行与消息开销之间折中。chunks(items, 10) 每块放 10 组参数:100 个元素形成 10 个任务,每个任务在本块内顺序处理。结果是嵌套列表,一块对应一个子列表。忙碌集群中减少消息数量可能提高效率,但最合适的块大小仍需按任务耗时、重试代价和负载分布测量。
chunked = add.chunks(zip(range(100), range(100)), 10)

# 调用 chunks 对象时,在当前发送端展开并发送各块任务。
result = chunked()

# Celery 5.6.3:同样在当前调用端展开 group 并提交各块任务。
result = add.chunks(zip(range(100), range(100)), 10).apply_async()

# 也可以转换成 group 并为各块错开倒计时。
chunk_group = add.chunks(zip(range(100), range(100)), 10).group()
chunk_group.skew(start=1, stop=10).apply_async()
最后一例让首个任务的倒计时为 1 秒、下一个为 2 秒,依此错开。它表达的是调度延时,不是保证精确到秒的开始时间。
编者校订(Celery 5.6.3):原教程称 chunks.apply_async() 会先建立专门的分发任务,再由 worker 提交各块;同版本 官方 chunks 实现却显示 __call__ 直接委托 apply_async,而 apply_async 直接调用 self.group().apply_async。因此对这里的普通 chunks 对象,两种入口没有上述分发位置区别:均在当前调用端展开并提交分块任务。实际块内工作仍由任务执行环境处理;task_always_eager 等配置还会影响执行方式。此处按5.6.3源码静态校订,未运行任务,也不把结论推广到未经核查的历史版本。
七、Stamping:给展开后的任务留下上下文
Celery 5.3 引入 Stamping API,基于访问者模式遍历 Canvas,在签名、组、链及回调上写入调试元数据。嵌套组展开、链成员替换后,标记可帮助辨认任务原先所在的结构。若要在结果元数据中查看这些信息,需要启用 result_extended=True。
sig1 = add.si(2, 2)
sig1_result = sig1.freeze()  # 分配/固定身份;这里不代表已提交任务。
g = group(sig1, add.si(3, 3))
g.stamp(stamp="your_custom_stamp")
result = g.apply_async()

# 原教程交互式检查方式(私有方法,版本兼容性需留意):
# sig1_result._get_task_meta()["stamp"]
# 预期标记列表为 ["your_custom_stamp"]。
结果扩展元数据与 broker 消息可能被运维系统读取,因此不要把密码、访问令牌或未经处理的个人数据写进 stamp。stamp 用于关联和观测,不应代替服务端鉴权。
自定义访问者与嵌套组
原文的 InGroupVisitor 用布尔变量记录是否位于组内。对真正嵌套的 group,仅在内组结束时把布尔值设回 False,可能丢失仍处于外组的状态。以下改为深度计数,明确作为编者修订;返回的标签仍表达“当前是否位于至少一层 group”。
from celery.canvas import StampingVisitor

class InGroupVisitor(StampingVisitor):
    def __init__(self):
        self.depth = 0

    def _stamp(self):
        return {
            "in_group": [self.depth > 0],
            "stamped_headers": ["in_group"],
        }

    def on_group_start(self, group, **headers):
        self.depth += 1
        return self._stamp()

    def on_group_end(self, group, **headers):
        self.depth -= 1

    def on_chain_start(self, chain, **headers):
        return self._stamp()

    def on_signature(self, sig, **headers):
        return self._stamp()

g.stamp(visitor=InGroupVisitor())
要为每个任务分配外部监控标识,可在每次访问签名时生成 UUID:
from uuid import uuid4

class MonitoringIdStampingVisitor(StampingVisitor):
    def on_signature(self, sig, **headers):
        return {"monitoring_id": uuid4().hex}

workflow = chain(
    signature("t1"),
    group(signature("t2"), signature("t3")),
    signature("t4"),
)
workflow.stamp(visitor=MonitoringIdStampingVisitor())
此处 t1–t4 是演示任务名,执行前必须在实际应用中注册。上面每个签名获得不同 ID;如果需要一个工作流共享同一关联 ID,应在遍历之前生成一次,再由访问者复用,不能混淆两种语义。
访问者返回字典时,stamped_headers 是可选的。省略它,返回的全部键都视为 stamp;显式给出它,就只有列出的键会成为 stamp。例如:
def on_signature(self, sig, **headers):
    return {
        "monitoring_id": uuid4().hex,
        "other_data": "value",
        "stamped_headers": ["monitoring_id"],
    }
回调必须先连接,再盖章
Stamping 会隐式遍历已连接的成功和错误回调,因此顺序很重要:先 link() 与 link_error(),后 stamp()。
class CustomStampingVisitor(StampingVisitor):
    def on_signature(self, sig, **headers):
        return {"header": "value"}

    def on_callback(self, callback, **headers):
        return {"on_callback": True}

    def on_errback(self, errback, **headers):
        return {"on_errback": True}

c = chord([add.s(1, 1), add.s(2, 2)], tsum.s())
c.link(signature("sig_link"))
c.link_error(signature("sig_link_error"))
c.stamp(visitor=CustomStampingVisitor())
原文展示的结构中,chord、header 成员和 body 都获得 header=value;body 的成功回调还获得 on_callback=True,错误回调获得 on_errback=True,对应键进入 stamped_headers。这些是源文预期元数据示例,不是本文实际运行输出。
落到业务系统时的边界
Canvas 负责表达任务依赖,不会自动把跨任务副作用变成数据库事务,也不会让错误通知天然幂等。需要特别检查:broker 和结果后端权限、允许的序列化格式、任务签名来源、消息与结果体积、任务超时、重试和去重规则,以及失败后是否仍有成员继续执行。传入任务名和参数的外部请求必须经过白名单与业务授权,不能把用户构造的任意签名直接交给 worker。
本次 static_review 已识别并说明 pickle 反序列化风险、错误文件路径/敏感日志风险、组错误回调重复、单组展开差异和嵌套访问者状态问题;未执行源代码、破坏性示例或依赖服务测试。没有发现硬编码秘密不代表工作流没有其他漏洞。
保留原项目归属:2017–2026 Asif Saif Uddin、core team 与 contributors;2015–2016 Ask Solem 与 contributors;2012–2014 GoPivotal, Inc.;2009–2012 Ask Solem 与 individual contributors。本文为翻译与改编,包含已标明的安全补充,不代表原作者背书。
原始版权与许可
Copyright (c) 2017-2026 Asif Saif Uddin, core team & contributors. All rights reserved.
Copyright (c) 2015-2016 Ask Solem & contributors. All rights reserved.
Copyright (c) 2012-2014 GoPivotal, Inc.  All rights reserved.
Copyright (c) 2009, 2010, 2011, 2012 Ask Solem, and individual contributors. All rights reserved.

Celery is licensed under The BSD License (3 Clause, also known as
the new BSD license).  The license is an OSI approved Open Source
license and is GPL-compatible(1).

The license text can also be found here:
http://www.opensource.org/licenses/BSD-3-Clause

License
=======

Redistribution and use in source and binary forms, with or without
modification, are permitted provided that the following conditions are met:
    * Redistributions of source code must retain the above copyright
      notice, this list of conditions and the following disclaimer.
    * Redistributions in binary form must reproduce the above copyright
      notice, this list of conditions and the following disclaimer in the
      documentation and/or other materials provided with the distribution.
    * Neither the name of Ask Solem, nor the
      names of its contributors may be used to endorse or promote products
      derived from this software without specific prior written permission.

THIS SOFTWARE IS PROVIDED BY THE COPYRIGHT HOLDERS AND CONTRIBUTORS "AS IS"
AND ANY EXPRESS OR IMPLIED WARRANTIES, INCLUDING, BUT NOT LIMITED TO,
THE IMPLIED WARRANTIES OF MERCHANTABILITY AND FITNESS FOR A PARTICULAR
PURPOSE ARE DISCLAIMED. IN NO EVENT SHALL Ask Solem OR CONTRIBUTORS
BE LIABLE FOR ANY DIRECT, INDIRECT, INCIDENTAL, SPECIAL, EXEMPLARY, OR
CONSEQUENTIAL DAMAGES (INCLUDING, BUT NOT LIMITED TO, PROCUREMENT OF
SUBSTITUTE GOODS OR SERVICES; LOSS OF USE, DATA, OR PROFITS; OR BUSINESS
INTERRUPTION) HOWEVER CAUSED AND ON ANY THEORY OF LIABILITY, WHETHER IN
CONTRACT, STRICT LIABILITY, OR TORT (INCLUDING NEGLIGENCE OR OTHERWISE)
ARISING IN ANY WAY OUT OF THE USE OF THIS SOFTWARE, EVEN IF ADVISED OF THE
POSSIBILITY OF SUCH DAMAGE.

Documentation License
=====================

The documentation portion of Celery (the rendered contents of the
"docs" directory of a software distribution or checkout) is supplied
under the "Creative Commons Attribution-ShareAlike 4.0
International" (CC BY-SA 4.0) License as described by
https://creativecommons.org/licenses/by-sa/4.0/

Footnotes
=========
(1) A GPL-compatible license makes it possible to
    combine Celery with other software that is released
    under the GPL, it does not mean that we're distributing
    Celery under the GPL license.  The BSD license, unlike the GPL,
    let you distribute a modified version without making your
    changes open source.











暂无评论内容