


原文:HA monitoring setup in Kubernetes via VictoriaMetrics Cluster。作者/维护方:VictoriaMetrics 文档贡献者。本文按 2026-10-05 读取的公开指南完整翻译,另以编校注明确安全和技术边界。
版本与执行说明:原例使用 GKE Kubernetes v1.35;列表显示集群 Chart 0.35.0、Agent Chart 0.32.0、VictoriaMetrics v1.136.0。未锁版本的 Helm 命令会使用执行时仓库版本。命令面向 Bash/POSIX 风格终端。下列安装输出、Pod 名称、时间戳和查询结果均来自原文,不是本次实测。
本指南介绍如何在 Kubernetes 上以高可用模式部署 VictoriaMetrics 集群。读完后,你将了解怎样用 Helm 安装和配置集群版、VictoriaMetrics 的高可用模式如何工作,以及怎样利用服务发现抓取 Kubernetes 组件的指标。
工作原理
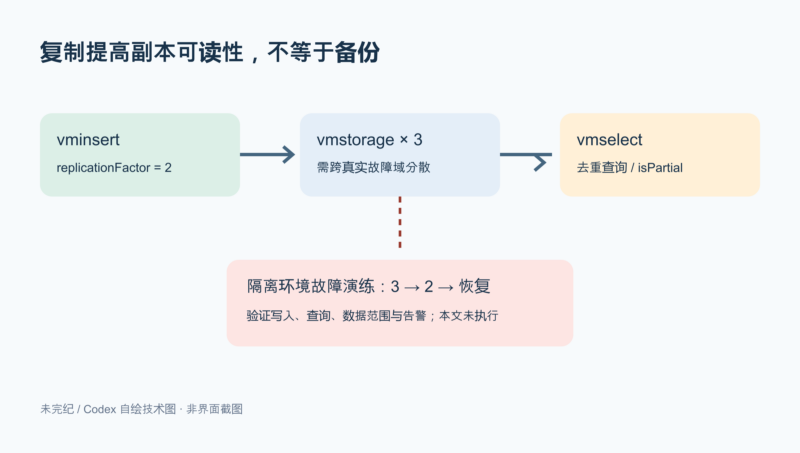
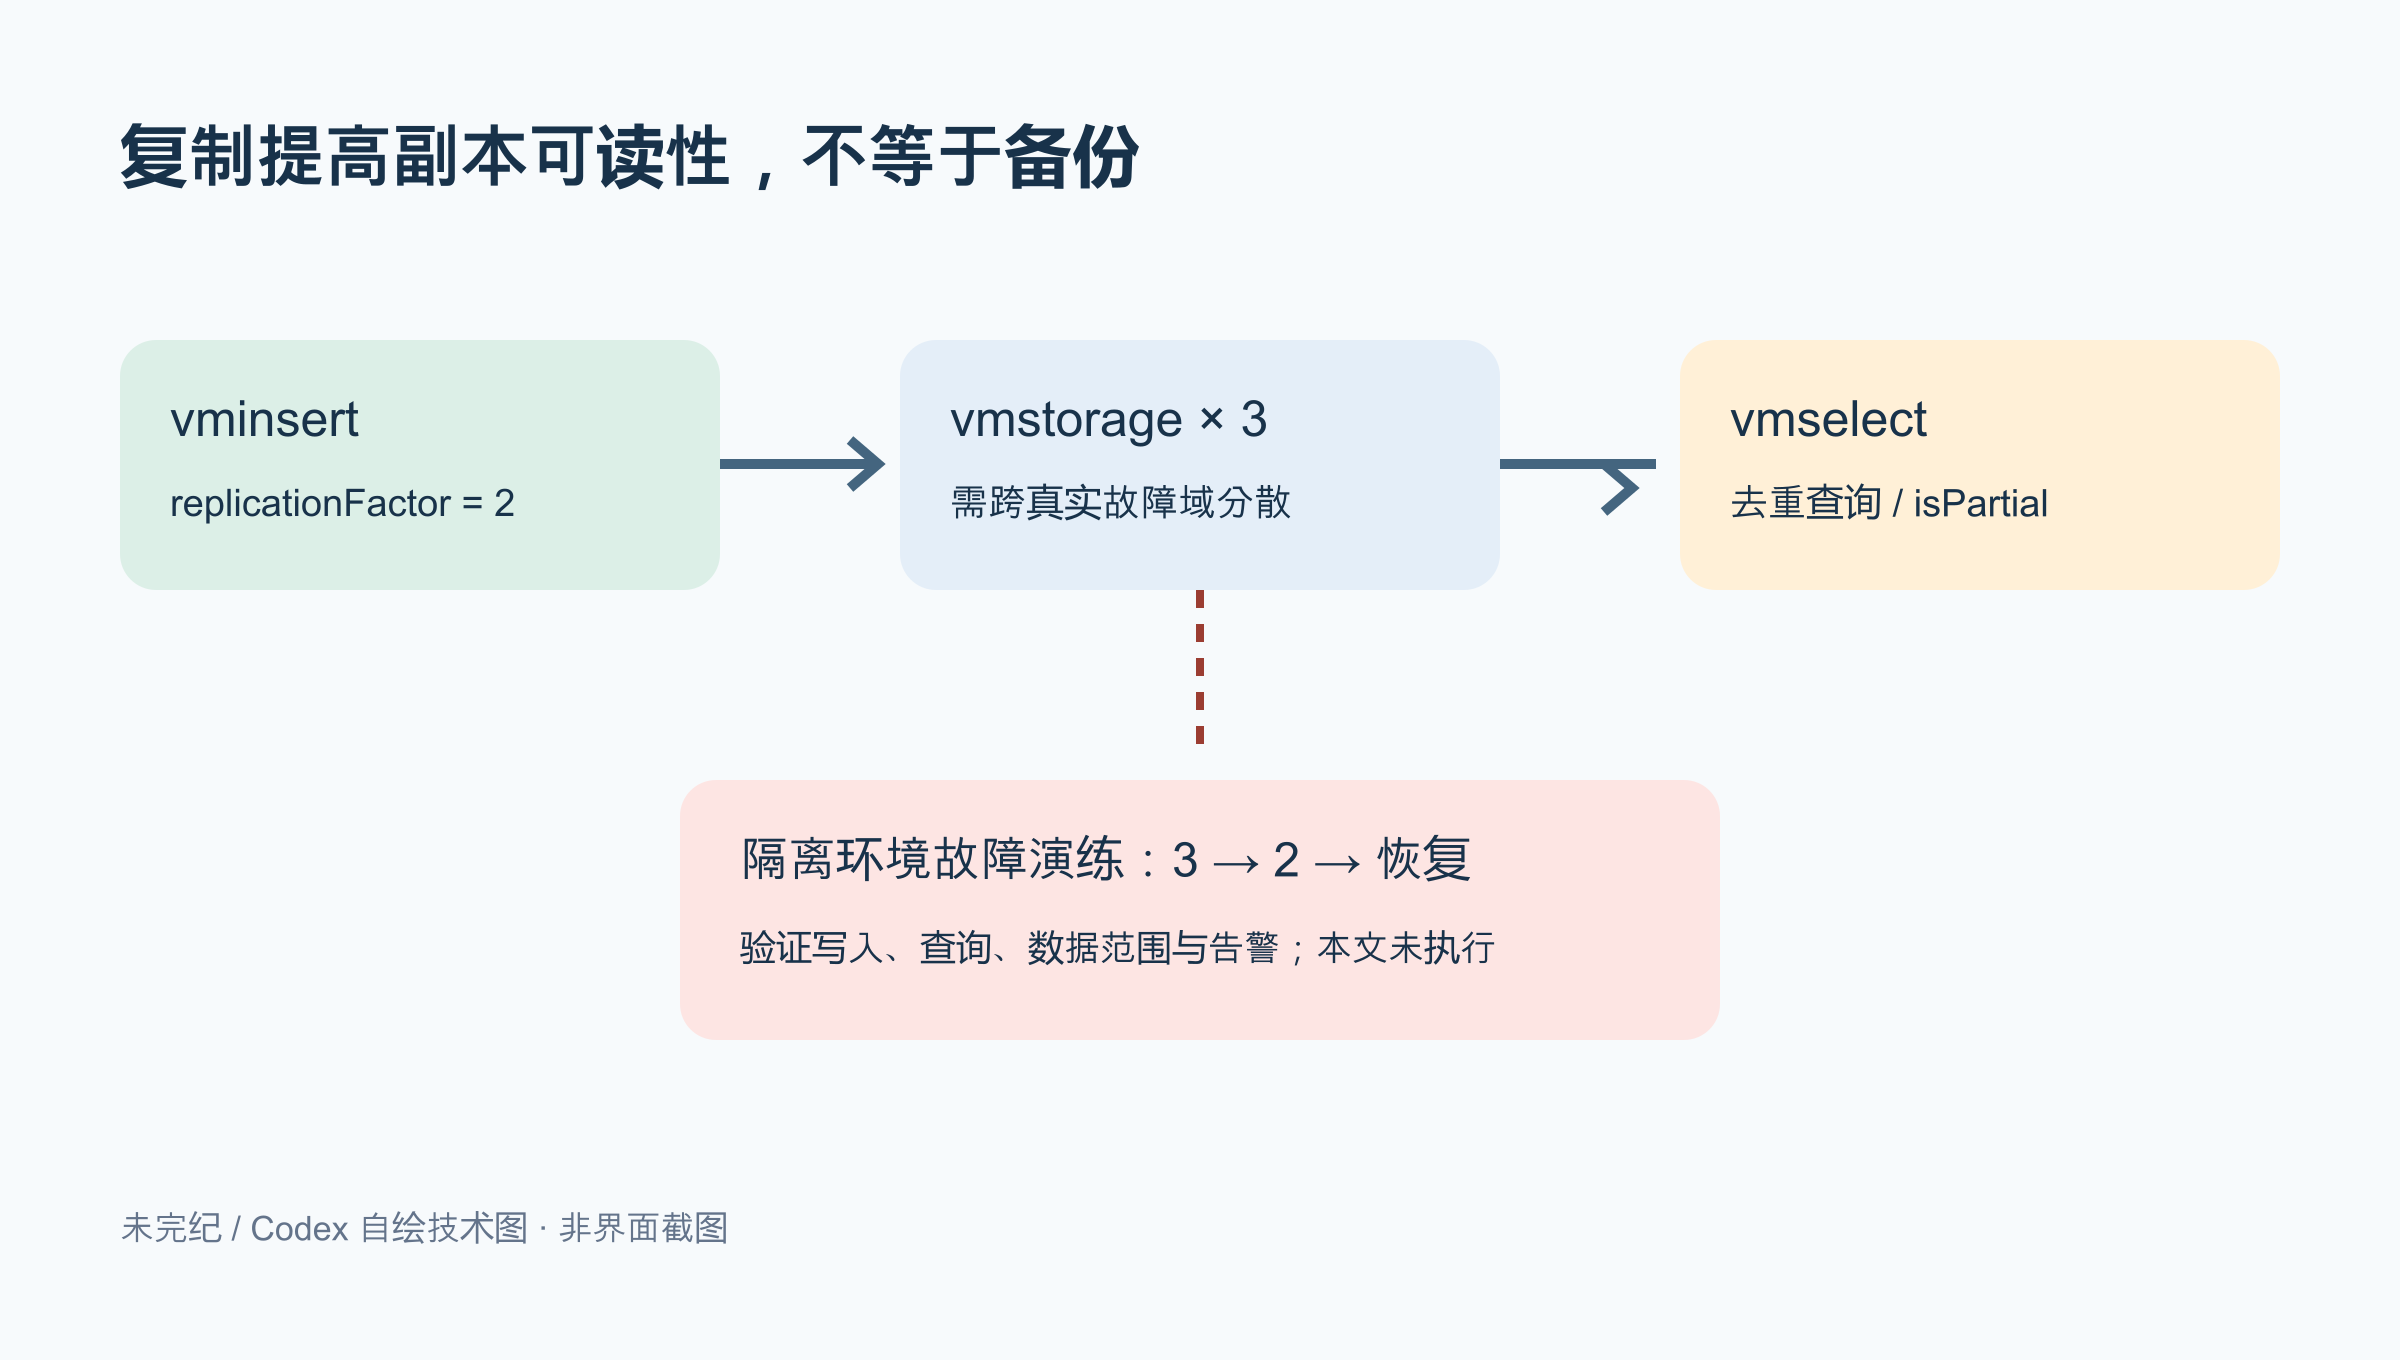
本例把 vminsert 的复制因子设为 2:每个传入的数据点都会写入两个不同的 vmstorage Pod。只要某条时间序列至少还有一份副本可达,其数据就仍然可供查询。由于每次写入分发到两个存储 Pod,相比不复制的集群,这种部署约需两倍的数据存储空间。
查询端会读到样本的多个副本。原文以 sum、count 等聚合作为重复计数的例子,因此要求在 vmselect 上开启去重,将副本样本折叠为单个样本。
编校注:本例使用 dedup.minScrapeInterval=1ms 来处理复制样本,不能把它当作实际抓取周期。重复样本对具体表达式的影响取决于查询语义,并非所有 sum、count 都必然翻倍。复制不是备份,不能自动找回已经丢失的历史数据。
准备条件
原文使用 GCP 的 GKE v1.35 集群,相同思路也适用于 Amazon EKS 或本地 Kubernetes。需要准备 Kubernetes 集群、Helm、kubectl 和 jq。
1. 添加 VictoriaMetrics Helm 仓库
添加仓库并更新索引:
helm repo add vm https://victoriametrics.github.io/helm-charts/
helm repo update
检查可用 Chart:
helm search repo vm/原文给出的列表如下,后续还有其他条目:
NAME                                    CHART VERSION   APP VERSION     DESCRIPTION
vm/victoria-metrics-cluster             0.35.0          v1.136.0        VictoriaMetrics Cluster version - high-performa...
vm/victoria-metrics-agent               0.32.0          v1.136.0        VictoriaMetrics Agent - collects metrics from v...
vm/victoria-metrics-common              0.0.46                          VictoriaMetrics Common - contains shared templa...
...(list continues)...
2. 安装并配置 VictoriaMetrics 集群
集群包含三类服务:
vminsert接收指标,并按指标名称和标签做一致性哈希,把数据分配给 vmstorage。vmstorage保存原始数据,响应按时间范围和标签筛选的数据查询。vmselect从所有配置的 vmstorage 节点读取数据并执行查询。
创建高可用配置文件:
cat <<EOF > victoria-metrics-cluster-values.yml
vmselect:
  extraArgs:
    dedup.minScrapeInterval: 1ms
    replicationFactor: 2
  podAnnotations:
    prometheus.io/scrape: "true"
    prometheus.io/port: "8481"
  replicaCount: 3

vminsert:
  extraArgs:
    replicationFactor: 2
  podAnnotations:
    prometheus.io/scrape: "true"
    prometheus.io/port: "8480"
  replicaCount: 3

vmstorage:
  podAnnotations:
    prometheus.io/scrape: "true"
    prometheus.io/port: "8482"
  replicaCount: 3
EOF
这些参数承担以下职责:
- 三处
replicaCount: 3分别创建 3 个 vmselect、3 个 vminsert 和 3 个 vmstorage。 - vminsert 的
replicationFactor: 2将每个样本复制成两份,写到不同的存储 Pod。 - vmselect 的相同参数告诉查询端应预期多少副本,以及何时把返回标记为部分结果。
- vmselect 的
dedup.minScrapeInterval: 1ms消除读取到的重复样本。 prometheus.io/scrape: "true"注解配合抓取配置启用组件指标采集;prometheus.io/port指定端口。
编校注:三个 Pod 须分散到真实故障域,并为剩余节点预留 CPU、内存、磁盘与写入余量。三个副本若落在同一节点,并不能抵御该节点故障。这个 values 片段没有展示反亲和、拓扑分散、持久卷策略、访问认证与网络隔离,应结合实际集群补齐。
下面的安装命令会实际改变集群状态,在 default 命名空间创建集群:
helm install vmcluster vm/victoria-metrics-cluster -f victoria-metrics-cluster-values.yml原文的 Helm 输出如下。其中列出了写入端口 8480、查询端口 8481、集群内 DNS、端口转发方式,以及 Prometheus remote_write 和 Grafana 数据源 URL:
NAME: vmcluster
LAST DEPLOYED: Mon Mar  2 12:50:25 2026
NAMESPACE: default
STATUS: deployed
REVISION: 1
DESCRIPTION: Install complete
TEST SUITE: None
NOTES:
Write API:

The VictoriaMetrics write api can be accessed via port 8480 with the following DNS name from within your cluster:
vmcluster-victoria-metrics-cluster-vminsert.default.svc.cluster.local.

Get the Victoria Metrics insert service URL by running these commands in the same shell:
  export POD_NAME=$(kubectl get pods --namespace default -l "app=vminsert" -o jsonpath="{.items[0].metadata.name}")
  kubectl --namespace default port-forward $POD_NAME 8480

You need to update your Prometheus configuration file and add the following lines to it:

prometheus.yml

    remote_write:
      - url: "http://<insert-service>/insert/0/prometheus/"

for example -  inside the Kubernetes cluster:

    remote_write:
      - url: http://vmcluster-victoria-metrics-cluster-vminsert.default.svc.cluster.local:8480/insert/0/prometheus/
Read API:

The VictoriaMetrics read api can be accessed via port 8481 with the following DNS name from within your cluster:
vmcluster-victoria-metrics-cluster-vmselect.default.svc.cluster.local.

Get the VictoriaMetrics select service URL by running these commands in the same shell:
  export POD_NAME=$(kubectl get pods --namespace default -l "app=vmselect" -o jsonpath="{.items[0].metadata.name}")
  kubectl --namespace default port-forward $POD_NAME 8481

You need to specify the service URL in your Grafana:
 NOTE: you need to use the Prometheus Data Source

Input this URL field into Grafana

    http://<select-service>/select/0/prometheus/


for example - inside the Kubernetes cluster:

    http://vmcluster-victoria-metrics-cluster-vmselect.default.svc.cluster.local.:8481/select/0/prometheus/
Grafana 应选择 Prometheus 数据源,使用以 /select/0/prometheus/ 结尾的查询地址。安装输出里的 <insert-service>、<select-service> 都是待替换占位符。
检查 Pod 是否运行:
kubectl get pods -l app.kubernetes.io/instance=vmcluster原文预期三类组件各有三个运行中的 Pod:
NAME                                                           READY   STATUS    RESTARTS   AGE
vmcluster-victoria-metrics-cluster-vminsert-788c76b69b-lphnn   1/1     Running   0          106s
vmcluster-victoria-metrics-cluster-vminsert-788c76b69b-lxg2w   1/1     Running   0          106s
vmcluster-victoria-metrics-cluster-vminsert-788c76b69b-qmtkp   1/1     Running   0          106s
vmcluster-victoria-metrics-cluster-vmselect-65796bc88d-29cwm   1/1     Running   0          106s
vmcluster-victoria-metrics-cluster-vmselect-65796bc88d-lz58p   1/1     Running   0          106s
vmcluster-victoria-metrics-cluster-vmselect-65796bc88d-t42pr   1/1     Running   0          106s
vmcluster-victoria-metrics-cluster-vmstorage-0                 1/1     Running   0          106s
vmcluster-victoria-metrics-cluster-vmstorage-1                 1/1     Running   0          91s
vmcluster-victoria-metrics-cluster-vmstorage-2                 1/1     Running   0          76s
3. 安装 vmagent 并配置抓取
要采集 Kubernetes 指标并写入集群,还需要安装 vmagent。原文直接引用远程 values 文件:
helm install vmagent vm/victoria-metrics-agent -f https://docs.victoriametrics.com/guides/examples/guide-vmcluster-vmagent-values.yaml也可先下载一份配置以便审阅:
wget https://docs.victoriametrics.com/guides/examples/guide-vmcluster-vmagent-values.yaml编校注:远程 values 是可能变化的外部配置。先下载、审阅并固定版本或哈希,再应用到已授权的测试集群。下文保留原文所链接的完整配置快照;本次没有执行安装。
remoteWrite 定义接收 vmagent 遥测数据的 vminsert 端点,必须与第 2 步输出中的 remote_write URL 完全一致:
remoteWrite:
  - url: http://vmcluster-victoria-metrics-cluster-vminsert.default.svc.cluster.local:8480/insert/0/prometheus/
metric_relabel_configs 定义指标标签重写规则。它把 pod、container 分别复制到 pod_name、container_name,补上 name=k8s_stub,并从形如 /system.slice/某服务.service 的 id 标签中提取 systemd_service_name:
metric_relabel_configs:
        - action: replace
          source_labels: [pod]
          regex: '(.+)'
          target_label: pod_name
          replacement: '${1}'
        - action: replace
          source_labels: [container]
          regex: '(.+)'
          target_label: container_name
          replacement: '${1}'
        - action: replace
          target_label: name
          replacement: k8s_stub
        - action: replace
          source_labels: [id]
          regex: '^/system\.slice/(.+)\.service$'
          target_label: systemd_service_name
          replacement: '${1}'
为保留被链接配置的完整上下文,下面附上本次读取的完整官方 values。它还包含 API Server、节点、cAdvisor、Service 端点、慢速端点、黑盒探测服务及 Pod 的服务发现。黑盒配置引用 blackbox,不代表本示例已替你部署黑盒导出器。
真实安全问题:原例在 API Server、节点与 cAdvisor 三处设置
insecure_skip_verify: true,即使同时指定 ca_file,也会跳过证书校验。请求还携带服务账户令牌,因而存在中间人攻击与令牌泄漏风险。正式配置应使用可信 CA 与匹配的服务名/证书名称,并在核实兼容后删除该选项或设为 false。下面保留原例,不声称已修复或验证某个集群的证书。
原文所链接的 vmagent values 文件快照
原文从在线 URL 读取此文件。下方保留 2026-10-05 保存的全文;远端内容可变,部署时应固定版本并先审查差异。
remoteWrite:
  - url: http://vmcluster-victoria-metrics-cluster-vminsert.default.svc.cluster.local:8480/insert/0/prometheus/

config:
  global:
    scrape_interval: 10s

  scrape_configs:
    - job_name: vmagent
      static_configs:
        - targets: ["localhost:8429"]
    - job_name: "kubernetes-apiservers"
      kubernetes_sd_configs:
        - role: endpoints
      scheme: https
      tls_config:
        ca_file: /var/run/secrets/kubernetes.io/serviceaccount/ca.crt
        insecure_skip_verify: true
      bearer_token_file: /var/run/secrets/kubernetes.io/serviceaccount/token
      relabel_configs:
        - source_labels:
            [
              __meta_kubernetes_namespace,
              __meta_kubernetes_service_name,
              __meta_kubernetes_endpoint_port_name,
            ]
          action: keep
          regex: default;kubernetes;https
    - job_name: "kubernetes-nodes"
      scheme: https
      tls_config:
        ca_file: /var/run/secrets/kubernetes.io/serviceaccount/ca.crt
        insecure_skip_verify: true
      bearer_token_file: /var/run/secrets/kubernetes.io/serviceaccount/token
      kubernetes_sd_configs:
        - role: node
      relabel_configs:
        - action: labelmap
          regex: __meta_kubernetes_node_label_(.+)
    - job_name: "kubernetes-nodes-cadvisor"
      scheme: https
      tls_config:
        ca_file: /var/run/secrets/kubernetes.io/serviceaccount/ca.crt
        insecure_skip_verify: true
      bearer_token_file: /var/run/secrets/kubernetes.io/serviceaccount/token
      kubernetes_sd_configs:
        - role: node
      metrics_path: /metrics/cadvisor
      relabel_configs:
        - action: labelmap
          regex: __meta_kubernetes_node_label_(.+)
        - source_labels: [__metrics_path__]
          target_label: metrics_path
      metric_relabel_configs:
        - action: replace
          source_labels: [pod]
          regex: '(.+)'
          target_label: pod_name
          replacement: '${1}'
        - action: replace
          source_labels: [container]
          regex: '(.+)'
          target_label: container_name
          replacement: '${1}'
        - action: replace
          target_label: name
          replacement: k8s_stub
        - action: replace
          source_labels: [id]
          regex: '^/system\.slice/(.+)\.service$'
          target_label: systemd_service_name
          replacement: '${1}'
    - job_name: "kubernetes-service-endpoints"
      kubernetes_sd_configs:
        - role: endpoints
      relabel_configs:
        - action: drop
          source_labels: [__meta_kubernetes_pod_container_init]
          regex: true
        - action: keep_if_equal
          source_labels: [__meta_kubernetes_pod_annotation_prometheus_io_port, __meta_kubernetes_pod_container_port_number]
        - source_labels:
            [__meta_kubernetes_service_annotation_prometheus_io_scrape]
          action: keep
          regex: true
        - source_labels:
            [__meta_kubernetes_service_annotation_prometheus_io_scheme]
          action: replace
          target_label: __scheme__
          regex: (https?)
        - source_labels:
            [__meta_kubernetes_service_annotation_prometheus_io_path]
          action: replace
          target_label: __metrics_path__
          regex: (.+)
        - source_labels:
            [
              __address__,
              __meta_kubernetes_service_annotation_prometheus_io_port,
            ]
          action: replace
          target_label: __address__
          regex: ([^:]+)(?::\d+)?;(\d+)
          replacement: $1:$2
        - action: labelmap
          regex: __meta_kubernetes_service_label_(.+)
        - source_labels: [__meta_kubernetes_namespace]
          action: replace
          target_label: kubernetes_namespace
        - source_labels: [__meta_kubernetes_service_name]
          action: replace
          target_label: kubernetes_name
        - source_labels: [__meta_kubernetes_pod_node_name]
          action: replace
          target_label: kubernetes_node
    - job_name: "kubernetes-service-endpoints-slow"
      scrape_interval: 5m
      scrape_timeout: 30s
      kubernetes_sd_configs:
        - role: endpoints
      relabel_configs:
        - action: drop
          source_labels: [__meta_kubernetes_pod_container_init]
          regex: true
        - action: keep_if_equal
          source_labels: [__meta_kubernetes_pod_annotation_prometheus_io_port, __meta_kubernetes_pod_container_port_number]
        - source_labels:
            [__meta_kubernetes_service_annotation_prometheus_io_scrape_slow]
          action: keep
          regex: true
        - source_labels:
            [__meta_kubernetes_service_annotation_prometheus_io_scheme]
          action: replace
          target_label: __scheme__
          regex: (https?)
        - source_labels:
            [__meta_kubernetes_service_annotation_prometheus_io_path]
          action: replace
          target_label: __metrics_path__
          regex: (.+)
        - source_labels:
            [
              __address__,
              __meta_kubernetes_service_annotation_prometheus_io_port,
            ]
          action: replace
          target_label: __address__
          regex: ([^:]+)(?::\d+)?;(\d+)
          replacement: $1:$2
        - action: labelmap
          regex: __meta_kubernetes_service_label_(.+)
        - source_labels: [__meta_kubernetes_namespace]
          action: replace
          target_label: kubernetes_namespace
        - source_labels: [__meta_kubernetes_service_name]
          action: replace
          target_label: kubernetes_name
        - source_labels: [__meta_kubernetes_pod_node_name]
          action: replace
          target_label: kubernetes_node
    - job_name: "kubernetes-services"
      metrics_path: /probe
      params:
        module: [http_2xx]
      kubernetes_sd_configs:
        - role: service
      relabel_configs:
        - source_labels:
            [__meta_kubernetes_service_annotation_prometheus_io_probe]
          action: keep
          regex: true
        - source_labels: [__address__]
          target_label: __param_target
        - target_label: __address__
          replacement: blackbox
        - source_labels: [__param_target]
          target_label: instance
        - action: labelmap
          regex: __meta_kubernetes_service_label_(.+)
        - source_labels: [__meta_kubernetes_namespace]
          target_label: kubernetes_namespace
        - source_labels: [__meta_kubernetes_service_name]
          target_label: kubernetes_name
    - job_name: "kubernetes-pods"
      kubernetes_sd_configs:
        - role: pod
      relabel_configs:
        - action: drop
          source_labels: [__meta_kubernetes_pod_container_init]
          regex: true
        - action: keep_if_equal
          source_labels: [__meta_kubernetes_pod_annotation_prometheus_io_port, __meta_kubernetes_pod_container_port_number]
        - source_labels: [__meta_kubernetes_pod_annotation_prometheus_io_scrape]
          action: keep
          regex: true
        - source_labels: [__meta_kubernetes_pod_annotation_prometheus_io_path]
          action: replace
          target_label: __metrics_path__
          regex: (.+)
        - source_labels:
            [__address__, __meta_kubernetes_pod_annotation_prometheus_io_port]
          action: replace
          regex: ([^:]+)(?::\d+)?;(\d+)
          replacement: $1:$2
          target_label: __address__
        - action: labelmap
          regex: __meta_kubernetes_pod_label_(.+)
        - source_labels: [__meta_kubernetes_namespace]
          action: replace
          target_label: kubernetes_namespace
        - source_labels: [__meta_kubernetes_pod_name]
          action: replace
          target_label: kubernetes_pod_name
必须调整 TLS 校验
这份配置在 API Server、nodes 和 cAdvisor 三处设置 insecure_skip_verify: true。即便配置了 CA 文件,这项也会跳过服务端证书校验。以下是与原文不同的建议值,实际使用前要确认 CA 链和证书 SAN 与采集目标匹配:
tls_config:
  ca_file: /var/run/secrets/kubernetes.io/serviceaccount/ca.crt
  insecure_skip_verify: false
# 如需 server_name,必须匹配证书 SAN。差异说明:原文 true 改为 false。若节点证书不由该 CA 签发,应配置正确的 CA bundle,而不是重新开启跳过校验。
检查 vmagent Pod:
kubectl get pod -l app.kubernetes.io/instance=vmagent原文预期输出:
NAME                                              READY   STATUS    RESTARTS   AGE
vmagent-victoria-metrics-agent-6848c6b58d-87rf6 1/1 Running 0 32s编校注:这里仅展示一个 vmagent Pod。存储复制并不能消除采集器的单点;持久缓冲、采集器恢复与持续写入验证需要另行设计。
4. 验证服务与指标
先检查 Service:
kubectl get svc -l app.kubernetes.io/instance=vmcluster原文预期得到以下集群内部服务:
NAME                                           TYPE        CLUSTER-IP      EXTERNAL-IP   PORT(S)                      AGE
vmcluster-victoria-metrics-cluster-vminsert    ClusterIP   10.43.157.170   <none>        8480/TCP                     4m41s
vmcluster-victoria-metrics-cluster-vmselect    ClusterIP   10.43.222.181   <none>        8481/TCP                     4m41s
vmcluster-victoria-metrics-cluster-vmstorage   ClusterIP   None            <none>        8482/TCP,8401/TCP,8400/TCP   4m41s
将 vmselect 端口转发到本机,然后在另一个终端查询:
kubectl port-forward svc/vmcluster-victoria-metrics-cluster-vmselect 8481:8481curl -sg 'http://127.0.0.1:8481/select/0/prometheus/api/v1/query?query=count(up{kubernetes_pod_name=~".*vmselect.*"})' | jq这个请求访问 VictoriaMetrics 查询 API,表达式 count(up{kubernetes_pod_name=~".*vmselect.*"}) 对匹配 vmselect 的 up 序列计数,再将 JSON 交给 jq 格式化。原文结果如下:
{
  "status": "success",
  "isPartial": false,
  "data": {
    "resultType": "vector",
    "result": [
      {
        "metric": {},
        "value": [
          1773419630,
          "3"
        ]
      }
    ]
  },
  "stats": {
    "seriesFetched": "3",
    "executionTimeMsec": 3
  }
}
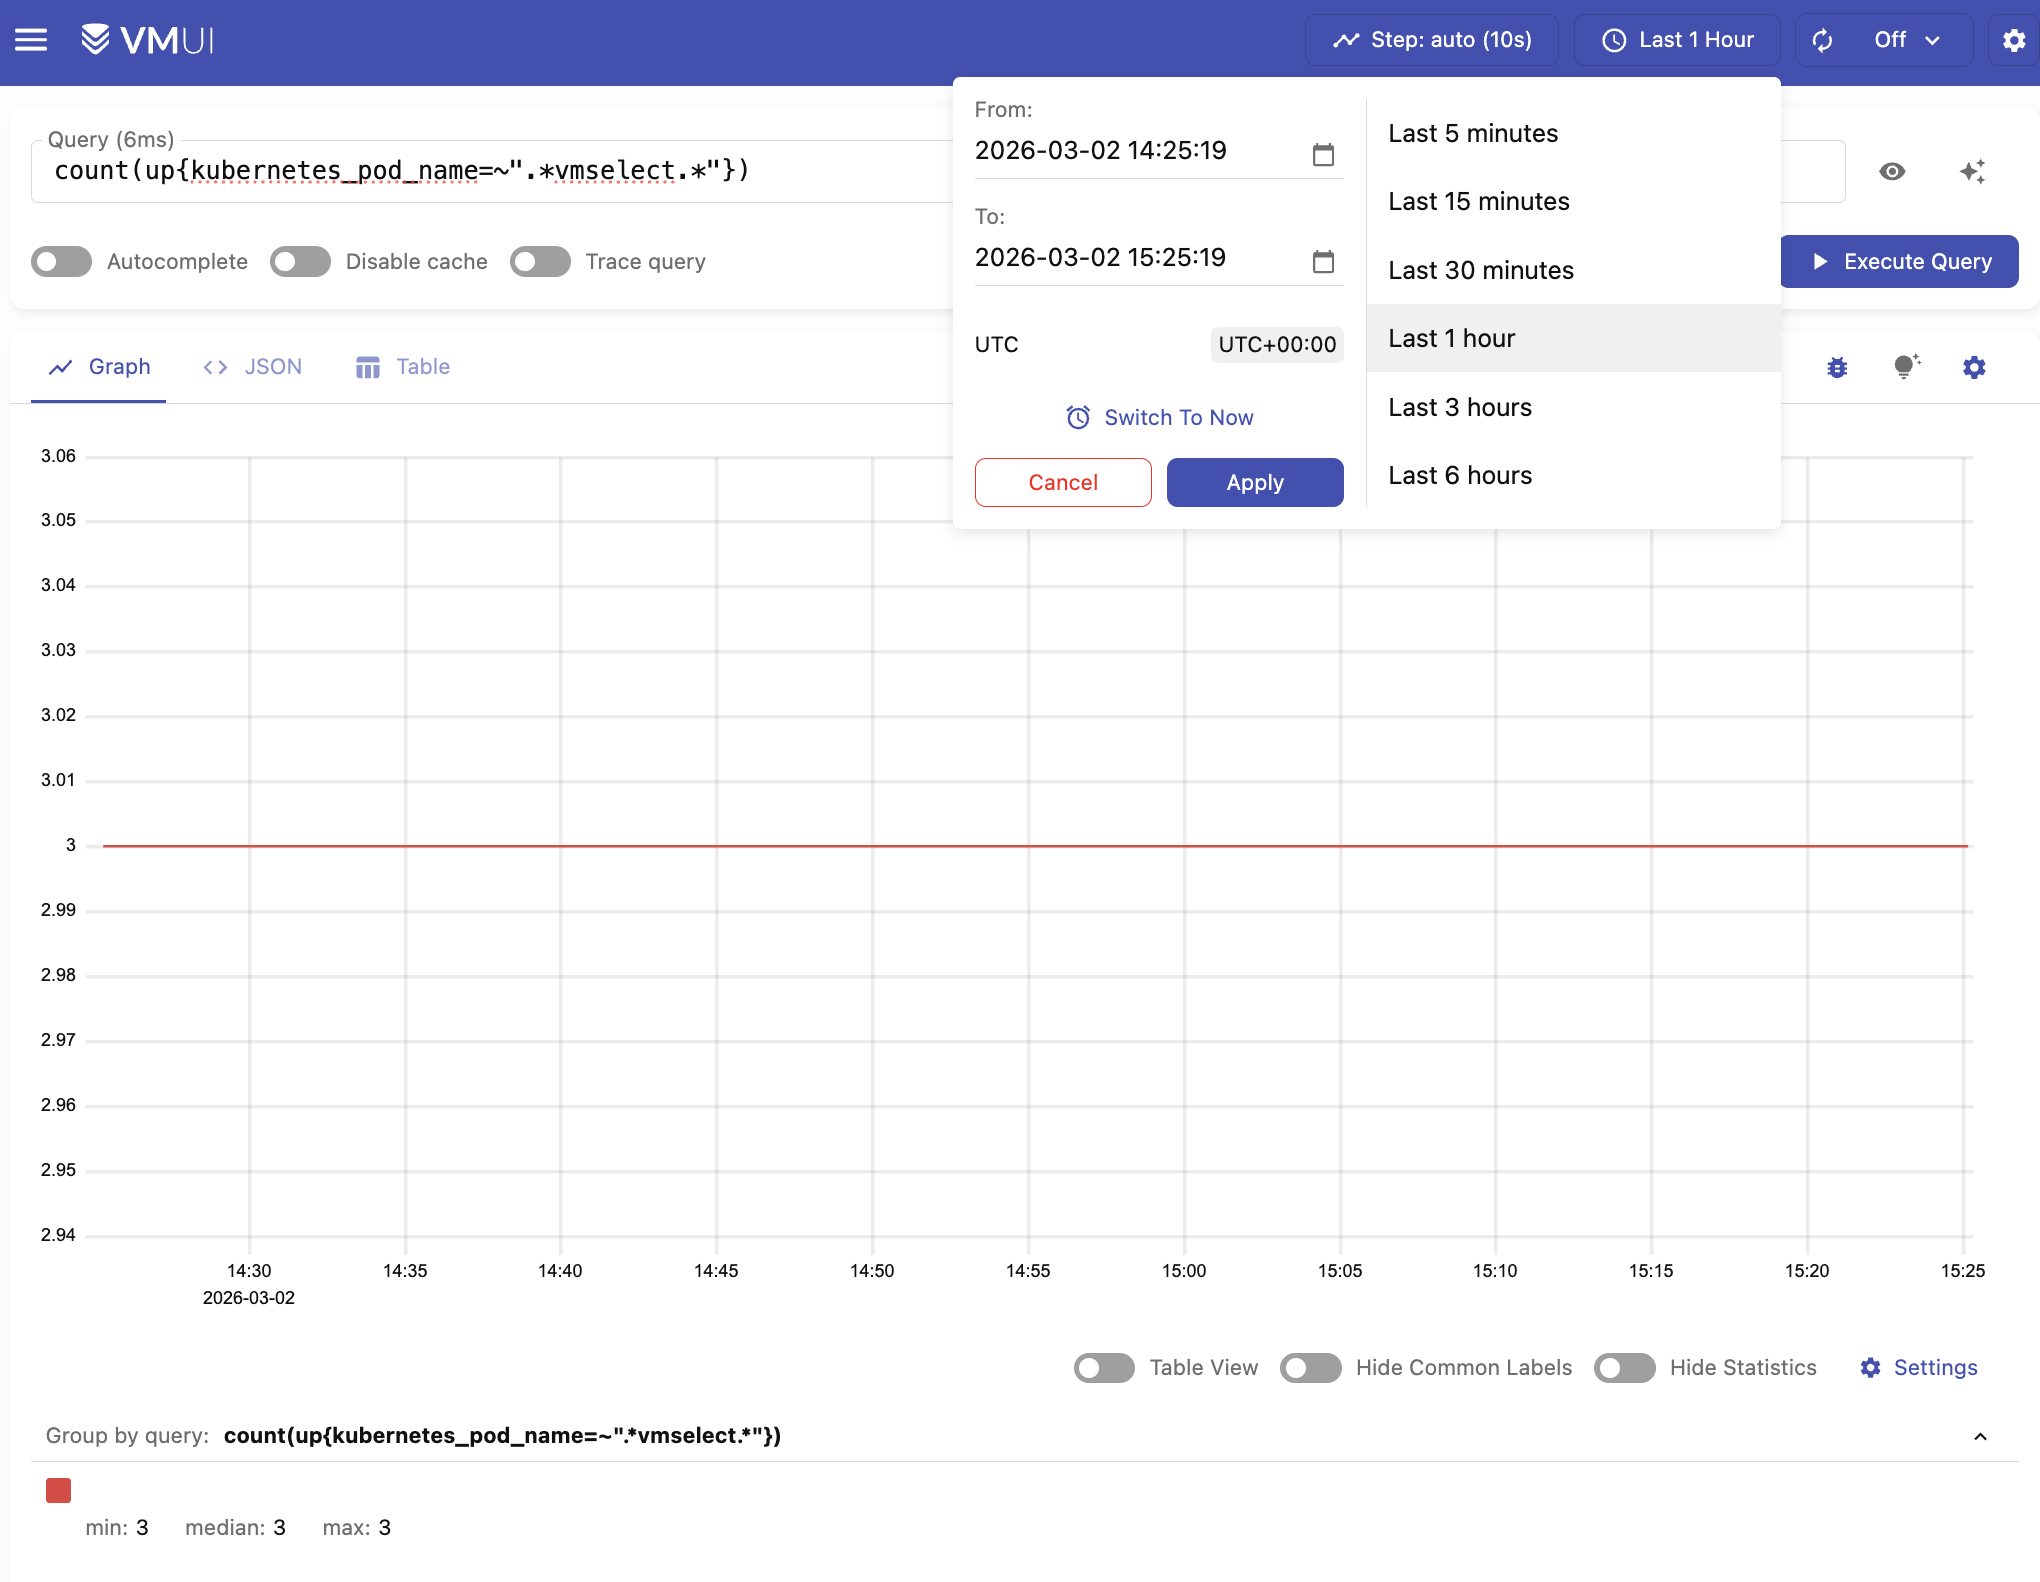
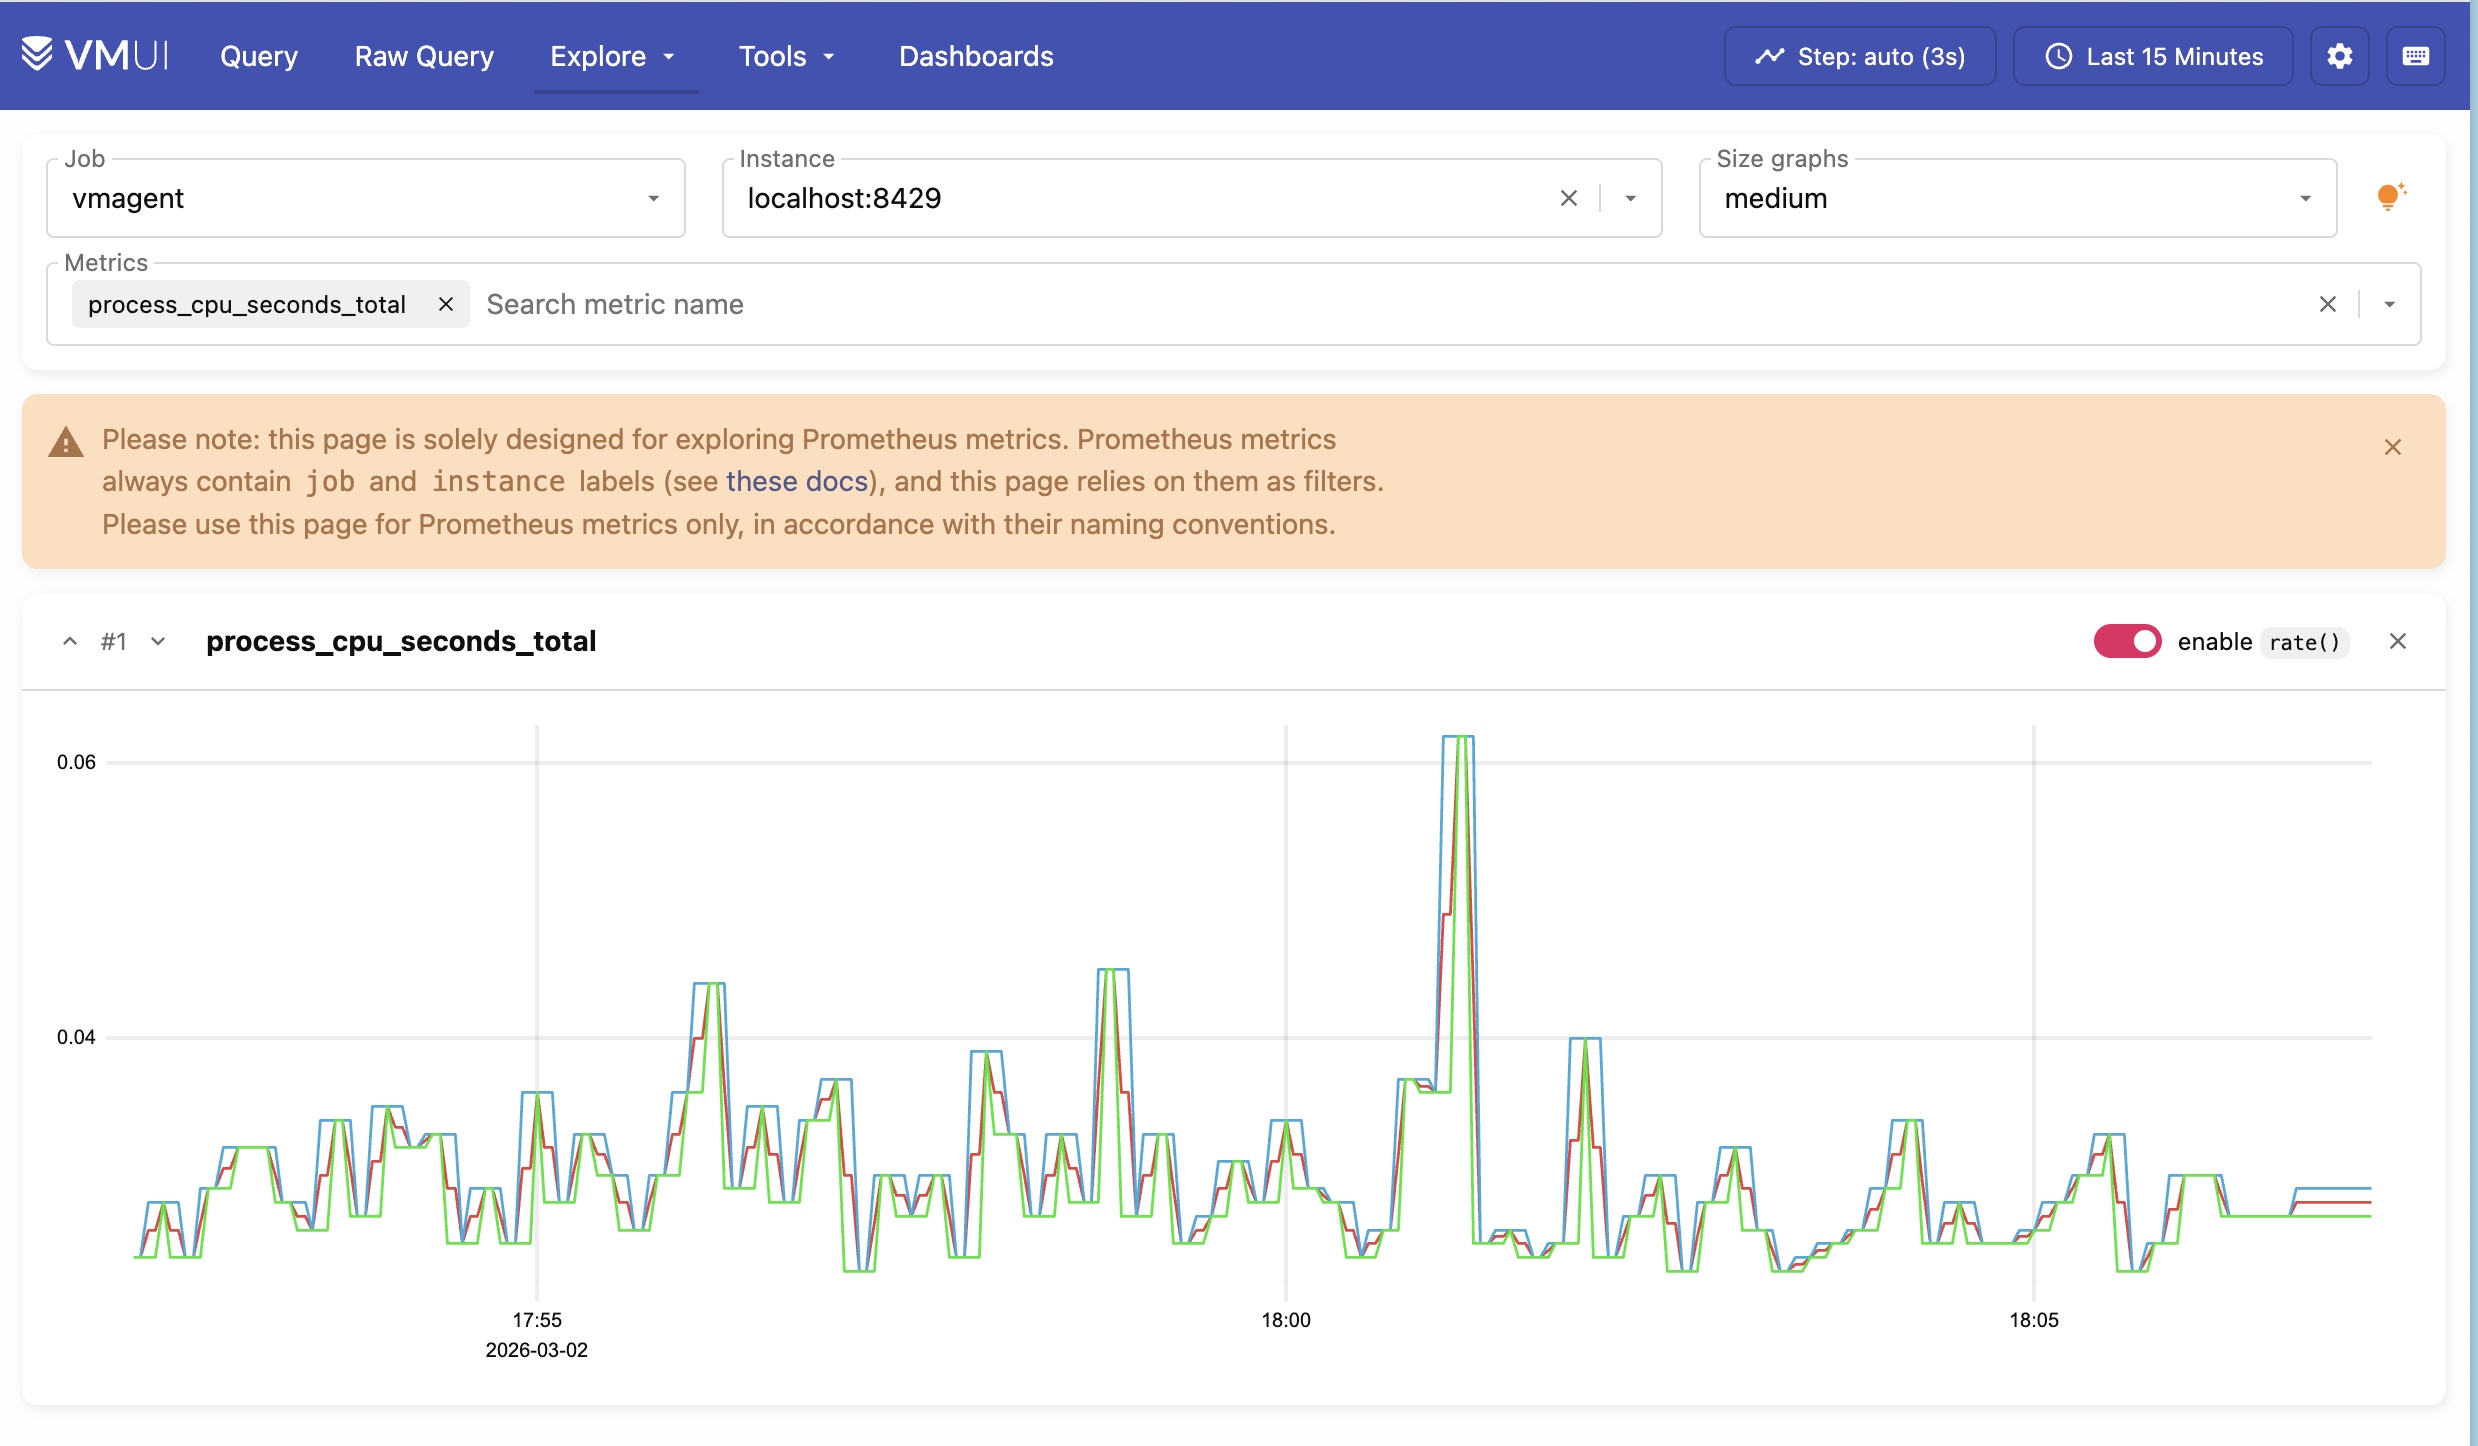
结果为 3,与配置的 vmselect 副本数一致。也可打开 http://localhost:8481/select/0/vmui/,其中 0 是默认租户 ID;输入同一表达式后执行查询。在 Explore → Prometheus metrics 中,还可以浏览从 Kubernetes 收集的指标。
编校注:
count(up)会计入值为 0、但仍然存在的序列,且受抓取时刻和陈旧标记影响,不等于即时健康 Pod 数。判断健康还需检查 up 的值、抓取目标、实际 Pod/节点状态与时间序列缺口。
5. 在隔离环境演练存储 Pod 故障
原文关闭一个 vmstorage Pod 来模拟故障,将 StatefulSet 副本数从 3 缩到 2:
危险操作:下面的 kubectl scale 会实际中断存储 Pod,只能在已授权、可恢复的隔离测试环境执行。先核对 kubeconfig 上下文与命名空间、持久卷保留策略、数据备份及恢复窗口。本次未实施缩容。
kubectl scale sts vmcluster-victoria-metrics-cluster-vmstorage --replicas=2检查当前剩下两个运行中的存储 Pod:
kubectl get pods -l app=vmstorageNAME READY STATUS RESTARTS AGE
vmcluster-victoria-metrics-cluster-vmstorage-0 1/1 Running 0 3h20m
vmcluster-victoria-metrics-cluster-vmstorage-1 1/1 Running 0 3h20m原文还使用以下查询观察存储组件的 up 序列:
curl -sg 'http://127.0.0.1:8481/select/0/prometheus/api/v1/query?query=count(up{kubernetes_pod_name=~".*vmstorage.*"})' | jq原例结果为 2:
{
  "status": "success",
  "isPartial": false,
  "data": {
    "resultType": "vector",
    "result": [
      {
        "metric": {},
        "value": [
          1773437033,
          "2"
        ]
      }
    ]
  },
  "stats": {
    "seriesFetched": "2",
    "executionTimeMsec": 5
  }
}
每个样本有两个存储副本,因此在复制数据及拓扑假设成立时,单个存储 Pod 丢失后仍可读取另一份副本。响应中的 isPartial 用于表示查询端是否将结果判断为部分结果:
false:按照已配置的 replicationFactor,有足够的存储副本响应,本次未被标记为部分结果。true:vmselect 未从 vmstorage 获取它预期的全部数据,返回的序列和值可能不完整或不正确。
继续查询 vmselect,原文预期仍然返回 3:
curl -sg 'http://127.0.0.1:8481/select/0/prometheus/api/v1/query?query=count(up{kubernetes_pod_name=~".*vmselect.*"})' | jq{
"status": "success",
"isPartial": false,
"data": {
"resultType": "vector",
"result": [
{
"metric": {},
"value": [
1773437137,
"3"
]
}
]
},
"stats": {
"seriesFetched": "3",
"executionTimeMsec": 5
}
}原文据此说明单个存储 Pod 的“故障”没有影响该演示中的查询与指标摄入。
编校注:单条即时查询成功或 isPartial=false 不能独立证明所有历史时间范围、持续写入和告警计算都没有缺口。该标记依赖已配置的存储拓扑与复制假设,不是无限的数据完整性保证。演练还需固定时间范围查询、持续写入和告警的独立验证;真实节点故障、网络分区与磁盘故障也应分别考察。
最后把存储副本恢复到 3:
kubectl scale sts vmcluster-victoria-metrics-cluster-vmstorage --replicas=3编校注:恢复数量后继续观察 Pod、持久卷、写入与查询是否恢复。副本数量恢复不自动表示历史缺失数据已经补齐。
6. 回顾与后续阅读
本指南配置了 Kubernetes 上的 VictoriaMetrics 高可用集群,采集运行服务的指标,并通过 replicationFactor=2 和查询端去重,演示关闭一个 vmstorage 后仍能读取指标。这里的“完成”与运行结果描述的是原文演示;本次只进行翻译与静态核验。
来源与权利说明
原文与官方配置归 VictoriaMetrics 及相应权利人所有,保留来源署名。项目代码开源许可不自动外推为文章、商标或全部配图的许可。技术示意图由编校自绘,VMUI 截图来自官方原文。











暂无评论内容