


Celery 的默认配置是在多种工作负载之间取得的折中。要改善吞吐、任务等待时间或内存占用,首先需要知道系统的瓶颈:任务来得太快、连接池争用、长任务占住预取消息,还是子进程留下了很高的内存水位。单独抄一个参数,通常解决不了这些不同的问题。
本文依据 Celery 5.6.3 官方文档 Optimizing 翻译整理,原作者为 Celery 文档贡献者。文档属于 5.6 稳定系列,核对日期为 2026 年 10 月 5 日。以下配置经过静态审查,未运行 worker、连接 broker 或开展压测;编辑补充会单独标明。
先算清楚处理能力,再监控队列
官方文档借用 Jon Bentley 在《Programming Pearls》中介绍的粗略估算方法,提醒读者:任何系统在一定时间内能够处理的数据量都有上限。例如,一项任务执行十分钟,而每分钟又进入十项新任务,有限的处理能力很容易让队列持续增长。
编辑补充:这个例子必须把并发算进去。假设每个执行槽一次处理一个任务,平均耗时为 T 分钟,并发槽数为 C,理想处理速率约为 C/T 项每分钟。十分钟任务若有一百个槽,理想上限才刚好是每分钟十项;它还没有给启动、I/O 抖动、重试和突发流量留余量。应测量实际服务时间与到达速率,而不是把文档的简化例子理解成任何并发下队列都必然增长。
持续监控队列长度,并为不可接受的积压设置告警。官方以 Munin 为例;关键在于及时发现队列失控,随后增加 worker 节点、调整流量或撤销不必要的任务。仅观察队列长度还不够,任务等待年龄、执行耗时、失败和重投情况能帮助判断是否真正恢复。
连接池:以实际使用连接的并发为依据
从 Celery 2.5 起,broker 连接池默认启用。broker_pool_limit 可以调整池大小,以减轻连接争用。设置时应考虑实际使用 broker 连接的活跃线程或 green thread 数量,不能简单等同于 prefork 子进程数,更不能因为队列积压就无限增大连接池。
连接数也受 broker 资源和连接限制约束。先区分“等待连接”和“任务本身慢”,再改变池大小,才有机会判断调整是否有效。
临时队列:只有允许任务丢失时才采用
Celery 默认创建可持久化队列。官方建议,对于允许丢弃的任务,可以使用临时队列减少磁盘持久化开销。原文配置如下:
from kombu import Exchange, Queue

task_queues = (
    Queue('celery', routing_key='celery'),
    Queue('transient', Exchange('transient', delivery_mode=1),
          routing_key='transient', durable=False),
)这里涉及两个不同维度:durable=False 控制队列本身的持久性;delivery_mode=1 表示非持久消息。默认值 2 表示消息可以持久化。不要把“队列存在于重启后”和“队列内每条消息都得到同等持久性保证”混为一谈,实际保证还与 broker 的实现和确认机制有关。
发送到上述队列可以显式指定队列名:
task.apply_async(args, queue='transient')也可以通过路由设置消息投递模式。下例保留了原文使用 celery 队列的写法,说明消息模式可以单独配置,并不表示这里创建了名为 transient 的队列:
task_routes = {
    'proj.tasks.add': {
        'queue': 'celery',
        'delivery_mode': 'transient',
    }
}
这是一项可靠性取舍。支付、订单、审计等不允许无声丢失的任务,不能为追求吞吐直接照搬。队列声明属性不一致也可能引起 broker 拒绝声明,变更已有队列需要单独规划。
预取额度与任务时长
“预取”来自 AMQP,表示 worker 提前为自己保留消息的行为。默认的预取额度等于 worker_prefetch_multiplier 乘以并发执行槽数;槽可以是进程、线程或 green thread,由并发池决定。
worker_prefetch_multiplier=0 不是关闭预取,而是不设该额度限制。worker 可能持续接收消息,既占用内存,也使其他节点难以及时分担。原文脚注补充:RabbitMQ 等 broker 对活跃消费者通常采用轮询投递;问题在集群重启、各节点启动时间不同等场景尤其明显,例如其他三台节点尚未上线时,唯一在线节点先接走了大量消息。
长任务通常适合较小倍率,例如 1,以减少消息被某个忙碌节点提前拿走。大量短任务则可能受益于较高预取:任务已经在内存中,不必每完成一个就等待下一次消息交付。文档举了 50、150、64、128 等试验值,它们只是可探索的数量级,不是通用推荐配置。
同时存在长任务和短任务时,官方建议为两类任务使用不同 worker,分别配置并通过任务路由分流。这样可以避免为了短任务吞吐而增大的预取额度,把长任务也大量留在同一节点。
“倍率一”为什么仍可能保留额外任务
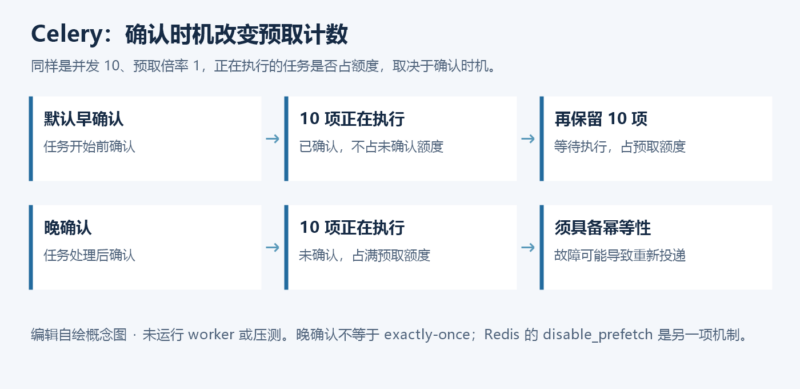
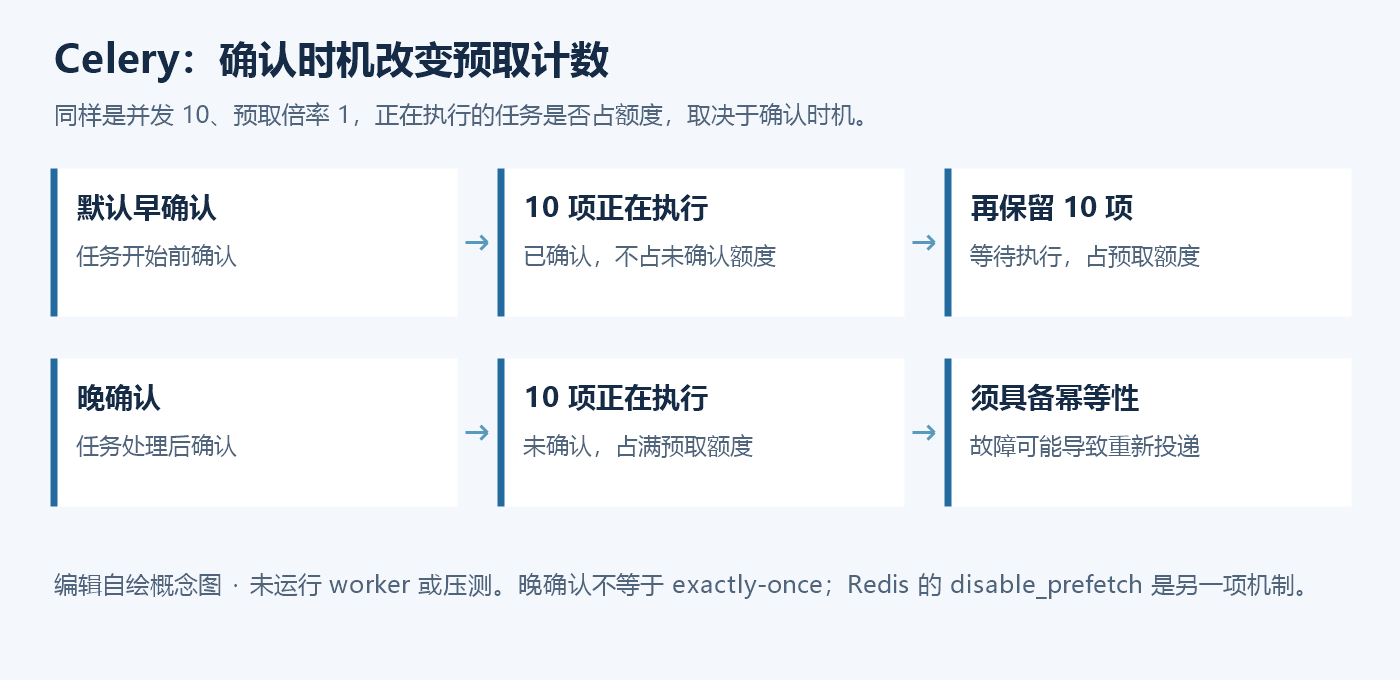
broker 只有在收到确认后才认为消息已处理。默认的早确认通常发生在任务开始执行之前,因此正在执行的任务不再占用未确认额度。
假设 worker 的并发为 -c 10,预取倍率为 1。在早确认模式下,可能同时有十项已确认且正在执行的任务,以及十项尚未确认、等待执行的任务。总共二十项,并不违反“预取额度十”的限制。
如果希望正在执行的十项任务本身占住额度,可以使用晚确认:
task_acks_late = True
worker_prefetch_multiplier = 1
晚确认把确认延后到任务处理之后。断电或 worker 整体意外终止时,未确认的消息可能被重新投递,因此任务必须设计为幂等:相同业务输入被处理多次,不应重复扣款、重复写入不可撤回的副作用。
编辑补充:晚确认不提供 exactly-once,也不等同于重试所有 Python 异常。原文明确指出,普通异常属于 Celery 可以处理的正常流程,消息会被确认;业务重试应使用 task.retry() 或合适的自动重试策略。子进程退出、致命信号和 worker 丢失又有各自的确认选项,例如 task_reject_on_worker_lost,应结合幂等与失败循环风险阅读配置说明,不能笼统承诺任何崩溃都会安全重跑。
如果业务不能使用晚确认,Celery 5.6 文档还给出 worker_disable_prefetch,也可通过命令行 --disable-prefetch 设置。它在执行槽空闲时才获取新任务,同时保留早确认语义。该能力当前只支持 Redis broker,不能直接推广到 RabbitMQ 等后端。
把内存泄漏与内存高水位分开
在 prefork worker 中,应首先分开观察主进程与子进程。主进程启动后不应长期大幅增长;如果出现这种情况,官方建议调查并向 Celery 提交可能的缺陷。若主要是子进程占用高,则应检查任务本身。
Python 进程可能保留曾经申请过的内存。某项任务即使已经释放大对象,分配器也未必立即把内存还给操作系统,于是一次高峰就让子进程的 RSS 长期维持在较高水位。这不自动证明存在对象泄漏。把大输入切块处理、减少同时存活的中间结果,往往比单纯重启更接近问题根源。
Celery 提供两种子进程回收控制:
worker_max_tasks_per_child:子进程处理一定数量的任务后替换。worker_max_memory_per_child:达到相应内存条件后替换子进程。配置单位及支持池应以当前配置参考为准。
编辑补充:内存回收设置不是限制单项任务峰值的硬性隔离机制。超过阈值的任务可能先完成,然后才替换子进程;如果任务瞬时内存峰值已经触发系统 OOM,回收策略并不能替代容量规划或容器、操作系统级资源约束。
回收也有代价。原文的例子是:若 worker_max_tasks_per_child=1,而每次启动子进程需要一秒,即使任务本身瞬间完成,每个这样的槽每分钟最多也只处理约六十项任务。内存阈值过低、导致每项任务之后都重启,会产生类似问题。应以代表性工作负载比较等待时间、吞吐、内存峰值和重启频率,再决定回收策略。
把调优做成可解释的取舍
一次改变一个主要因素,记录负载构成和关键指标。长任务关注分配公平与等待年龄,短任务关注交付延迟与吞吐,内存问题则关注峰值、持续增长和进程回收成本。本文没有提供实测最优参数,也没有把“未发现硬编码秘密或命令注入”当作安全保证;所示配置仍须结合任务副作用、broker 语义和部署边界审查。
来源与延伸阅读:Celery Optimizing、配置参考、任务路由。原文及代码归其原作者所有;中文翻译整理与技术示意图由未完纪编辑制作。
文档版权与许可:Celery User Manual,Ask Solem;Copyright © 2009–2016, Ask Solem;本篇源页另保留 Copyright © 2009–2023, Ask Solem & contributors。依官方版权页,文档采用 Creative Commons Attribution-ShareAlike 4.0 International(知识共享署名—相同方式共享 4.0 国际,CC BY-SA 4.0)。中文翻译、整理及标注的编辑补充与原创示意图由未完纪于 2026-10-05 制作,并以同一许可提供。再使用须保留适当署名、来源与许可链接,说明改动,不暗示原作者背书;改编按同一或兼容许可共享,不另加限制,许可不提供保证。许可说明及完整法律条款。Celery 软件另采用 BSD 3-Clause,其软件许可与此文档许可分别适用。











暂无评论内容