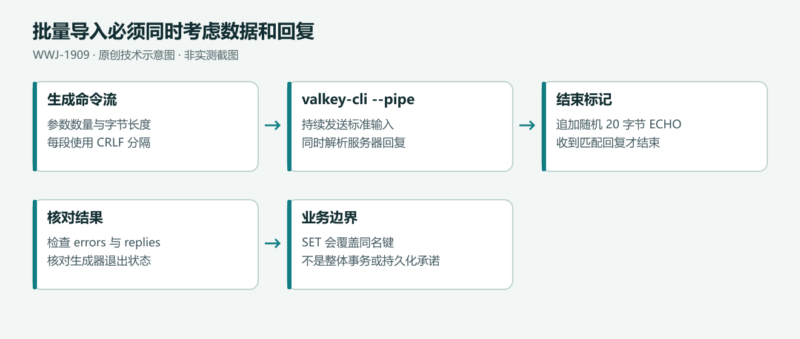



先把命令编码成长度准确的 RESP 流,再用 pipe 模式同时发送和读取回复,避免逐条往返。完成传输不等于事务提交或持久化保证。
为什么逐条发送太慢
批量导入要把大量已有数据写入 Valkey。最朴素的客户端循环,每发送一条命令就等待一次回复,会反复支付网络往返延迟。普通流水线虽能减少等待,但大规模导入仍需要同时写入命令和读取回复,避免一侧阻塞另一侧。
官方文档建议直接生成原始 RESP 协议文件,再交给专门的 pipe 模式。文件中的业务命令可以是依次写入 Key0、Key1 等键的 SET,真正发送的内容则必须是协议帧,不能只是任意拼接的命令文本。
不要用等待十秒代替完成确认
原文曾展示以 netcat 发送数据、固定等待一段时间并丢弃回复的做法,随后明确指出它不可靠:netcat 不知道最后一条命令是否已执行完成,也不会替你检查 Valkey 返回的错误。
以下保留原文反例便于识别,不能把它当可靠导入方案,也没有执行:
(cat data.txt; sleep 10) | nc localhost 6379 > /dev/null应该使用 valkey-cli --pipe,并保留输出与退出状态进行核对。
原文进一步指出,只有一部分客户端支持非阻塞I/O,回复解析效率也会限制吞吐。通用文件导入例为 cat data.txt | valkey-cli --pipe,其独立示例输出是 errors: 0, replies: 1000000;下面Ruby例只有1000条,两处数字不能混同。原文还说明客户端会将Valkey返回的错误写到标准输出,处理时不能丢弃该信息。
RESP 中的长度是字节长度
一个命令可编码为数组。数组头给出参数数量,每个参数都用一个 bulk string 表示:先写美元符号及参数字节数,再写 CRLF、参数内容和另一个 CRLF。
SET key value 一共有三个参数,其精确字符串表示为:
*3\r\n$3\r\nSET\r\n$3\r\nkey\r\n$5\r\nvalue\r\n
其中 \r 是 ASCII 13,\n 是 ASCII 10。示意中的转义符表示实际控制字符;生成文件时不能把两个可见字符“反斜杠加 r”误当作回车。
多个命令的完整帧直接首尾相接,即构成导入文件。每个参数都要有自己的长度前缀;中文、多字节字符或二进制内容尤其不能按字符个数计算。
Ruby 生成器
下面保留原文的 bytesize 计算方式。它先把参数转换成字符串,再记录实际字节数:
def gen_redis_proto(*cmd)
    proto = ""
    proto << "*" + cmd.length.to_s + "\r\n"
    cmd.each { |arg|
        proto << "$" + arg.to_s.bytesize.to_s + "\r\n"
        proto << arg.to_s + "\r\n"
    }
    proto
end

(0...1000).each { |n|
    STDOUT.write(
        gen_redis_proto("SET", "demo:Key#{n}", "Value#{n}")
    )
}
与原文的差异是给演示键增加 demo: 前缀。它仍会覆盖同名键,因此前缀只降低误碰机会,不构成权限隔离。导入前应确认目标实例、键空间和可用内存;不要把示例连接直接指向生产库。
原文还用 puts gen_redis_proto("SET", "mykey", "Hello World!").inspect 展示转义后的协议字符串。inspect 适合人眼检查,不是用于发送原始帧;实际生成器应使用 STDOUT.write。
生成与导入分开检查
原文将 Ruby 直接接到 valkey-cli --pipe。为使上游生成失败更容易发现,本稿改成两步,以下仅针对已授权的本机隔离测试实例:
ruby proto.rb > data.resp
# 确认上一条退出成功,检查文件及预期命令数,再执行:
valkey-cli -h 127.0.0.1 -p 6379 --pipe < data.resp
这组命令会写入数据库,本文没有执行。生产环境还应按实际部署补齐认证、TLS、备份和恢复方案,不把明文口令直接写入教程或命令历史。若采用管道,需要同时检查生成器和客户端的退出状态,不能只看最后一个进程。
原文对一千条命令给出的输出示例如下:
All data transferred. Waiting for the last reply...
Last reply received from server.
errors: 0, replies: 1000
这不是本次运行结果。核对时,回复数应与预期命令数一致,错误数也必须检查;出现零错误并不代表导入在业务层面完全正确,例如写到了错误实例或覆盖了不该覆盖的键,协议本身未必报错。
pipe 模式怎样判断最后一条回复
pipe 模式一边尽快发送输入数据,一边读取并解析可用回复。标准输入结束后,它还会发送一个包含随机二十字节字符串的特殊 ECHO 命令。
这条命令排在导入流最后。客户端在后续回复中寻找同样的二十字节 bulk reply,匹配到后便知道已经收到了最后标记的回复,因此可以结束,而不必靠猜测等待时间。
它不需要重新解析全部已发送命令来预先计算命令数;只需解析回复并累加计数,就能报告这次导入得到多少回复。
传输完成之后还要核对什么
pipe 模式解决高效发送和回复确认,不提供整批原子事务,也不自动证明持久化完成。集群环境还存在分片与重定向语义,不能把单实例演示当成跨集群导入方案。
应在独立测试环境核对命令总量、抽样键值、编码和异常处理,再根据实际持久化策略验证恢复。本稿只完成了协议与代码的静态审核,没有生成业务数据、发送写入命令或测量吞吐。
来源、署名与版本说明
原作者/维护方:Valkey documentation contributors。本文为中文翻译与技术整理,编辑补充和修正已在文中标明。
来源为 Valkey 官方 Bulk loading 文档,维护方 Valkey documentation contributors。
核对日期:2026-10-05。源页未锁定 Valkey 发行版本;例子描述 RESP 命令与 valkey-cli pipe 模式。集群路由、认证和 TLS 应使用目标版本文档配置。
文档许可与版权
© Valkey contributors。此页的原始文档位于 valkey-doc 文档仓库,依该仓库 文档许可采用 Creative Commons Attribution-ShareAlike 4.0 International(CC BY-SA 4.0)。本文中文翻译、结构调整、demo:键前缀、两阶段导入建议和安全注释亦按CC BY-SA 4.0发布;内容按原样提供,不作担保。原创配图:未完纪。
Valkey及其标志是LF Projects, LLC的商标。原站说明Valkey包含Redis Ltd.部分BSD 3-Clause代码及其他来源代码,Redis Ltd.并非其他代码的来源;Redis是Redis Ltd.的注册商标。这些软件说明不替代本页文档的CC许可。











暂无评论内容