


原作者:Valkey documentation contributors。原文《Persistence》;依据 2026 年 10 月 5 日访问的官方正文中文译编。原文及本译编采用 CC BY-SA 4.0;编辑更正和补注已标明。
持久化,是把数据写入 SSD 等不会随进程退出而消失的存储。Valkey 提供四种选择:按时间点保存数据集的 RDB 快照,顺序记录写入操作的 AOF,完全不启用持久化,以及同时使用 RDB 与 AOF。
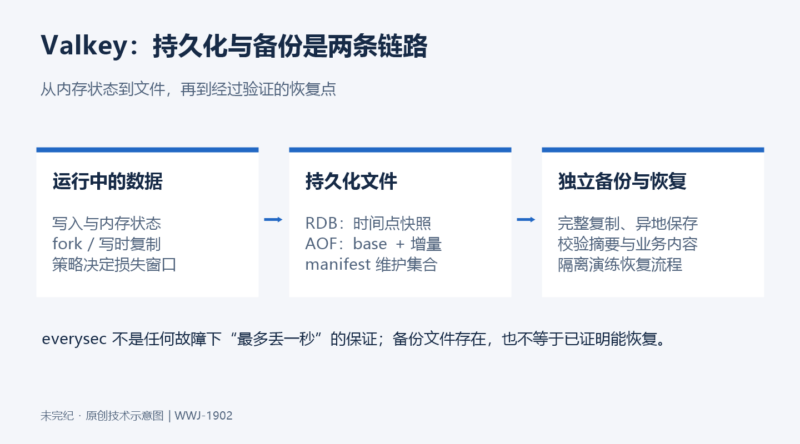
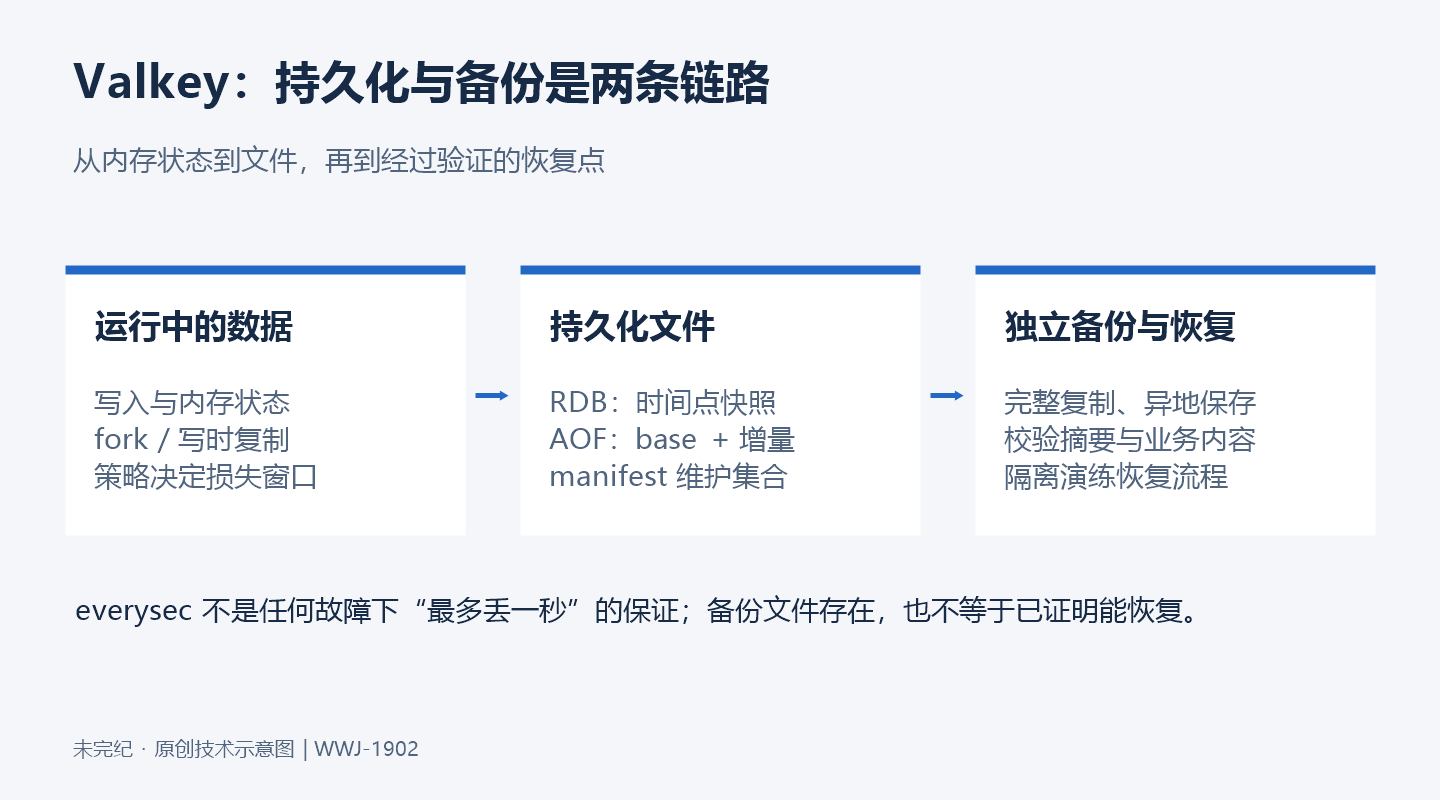
RDB 回答“某个时刻的数据是什么”,AOF 回答“怎样重放写入以重建状态”。两者都不能代替独立备份,也不能自动保证文件系统、硬件和恢复流程可靠。本文保留官方文档的完整技术主线,对容易被误解的安全结论作明确补注。
RDB 的优势和代价
RDB 用一个紧凑文件表示某一时刻的数据集,非常适合留存多个恢复点。例如,按小时保存最近一天的快照,再按天保存最近一个月的数据。文件小而完整,也适合传到异地机房或对象存储。
生成快照时,父进程主要负责 fork() 出子进程,快照写盘由子进程完成。大型数据集从 RDB 恢复通常比重放 AOF 更快;在副本上,RDB 还支持重启或故障转移后的部分重新同步。
代价是快照之间的写入可能丢失。可以设多个保存条件,例如一段时间内发生至少一定次数的变化后保存;如果每五分钟或更久才生成一次快照,就应准备好承担最后几分钟数据丢失的风险。RDB 不适合独自满足尽量少丢数据的要求。
fork() 也有成本。数据集大、CPU 不足时,服务可能暂停数毫秒,甚至更久。AOF 重写也需要 fork,但通常频率较低;调整重写频率不必改变刷盘策略。编者补注:原文中的延迟量级不是当前环境实测,写时复制产生的额外内存需求也应纳入容量规划。
AOF 的优势和代价
AOF 使用 Valkey 协议格式记录修改数据的操作,重启时按顺序重放。追加方式减少了文件内寻址;如果末尾只写入半条命令,可以检测并处理不完整尾部。文件过大时,后台重写会生成重建当前状态所需的较短操作序列。
同一数据集下,AOF 通常比 RDB 更大。它的性能取决于 fsync 策略:每秒刷盘通常在速度和持久性之间折中;每次追加都刷盘会增加延迟。原文认为 RDB 在高写入负载下更利于控制最大延迟,实际效果仍须结合工作负载验证。
可读的操作日志也能提供人工恢复线索。原文举例:误执行 FLUSHALL 后,如果 AOF 尚未重写,有时可以停止服务、从日志移除误操作并恢复数据。这不是通用撤销功能。后续写入、多文件结构和过期行为都可能影响恢复,本文不运行破坏性示例,也不提供未经验证的日志剪裁脚本。
先理解刷盘,再谈“丢多少数据”
| 策略 | 行为 | 主要取舍 |
|---|---|---|
appendfsync always |
新命令追加后执行 fsync;一批并发客户端或流水线命令可以合并提交,并在回复前完成相应刷盘。 | 更强的落盘要求,通常带来更高延迟。 |
appendfsync everysec |
后台约每秒执行一次 fsync,是文档建议的默认折中。 | 正常设计目标下,可能丢失最近约一秒写入;不是任何故障下的严格上界。 |
appendfsync no |
Valkey 不主动 fsync,把回写时机交给操作系统。 | 通常更快,持久性更弱,不能承诺固定损失窗口。 |
编者更正:原文出现“只会丢一秒”“完全持久”等绝对化表述,本文不将其解释为保证。I/O 阻塞、文件系统、磁盘缓存与硬件都会影响结果。原文提到 Linux 常见回写间隔约为 30 秒,也依赖内核配置;顺序追加同样不能排除介质损坏。
单用还是组合使用
如果业务可以接受灾难时丢失几分钟数据,单独使用 RDB 可能足够。更重视数据安全时,RDB 与 AOF 组合既提供较细的恢复进度,也保留便于归档的快照。官方文档不鼓励仅依赖 AOF:周期性 RDB 有利于备份、快速启动,并在 AOF 实现或文件出问题时提供另一条恢复路径。
编者补注:原文用 PostgreSQL 作数据安全程度的类比,但 RDB+AOF 不自动取得 PostgreSQL 的事务语义或全部持久性保证。应按业务允许丢多少数据、多久恢复、故障模型和已演练的恢复路径作选择。
配置快照,以及有意关闭持久化
默认快照文件名为 dump.rdb。可以配置“经过 N 秒且至少发生 M 次变化”时保存,也可以用 SAVE 或 BGSAVE 触发。原文示例:
save 60 1000它表示满足 60 秒和至少 1000 次变化两个条件后保存,不是无条件每 60 秒保存。流程是:父进程 fork,子进程写临时 RDB,完成后替换旧文件。这利用了写时复制。
操作边界:SAVE 同步执行,会阻塞服务;BGSAVE 走后台,也有 fork 和资源成本。本文没有执行任一种命令。
纯缓存场景可以不持久化。关闭 RDB 的配置是 save "",同时移除其他保存条件;也可以给 valkey-server 传 --save ""。这只关闭 RDB;AOF 若仍启用,就不是完全无持久化。应确认缓存可重建,并评估冷启动压力。
多文件 AOF 的组成与重写
设置 appendonly yes 后,改变数据集的命令会追加到 AOF。已有数据的在线实例不能只改配置后重启,应采用后文的在线转换流程。
当前文档描述多文件 AOF:最多一个 base 文件和一个或多个增量文件。base 表示重写时的数据快照,可使用 RDB 或 AOF 格式;增量文件保存之后的修改。它们集中在单独目录,由 manifest 追踪有效文件集合。因此,不能只备份一个旧式 appendonly.aof 文件。
假设计数器增加了 100 次,内存只需要一个最终值,日志却有 100 条写入。重写可以用更短的序列表示当前状态。可用 BGREWRITEAOF 请求重写,也可以自动触发。多文件机制的具体过程是:
- 父进程 fork 出子进程,并打开新的增量 AOF,继续记录更新。
- 子进程把新 base 写到临时文件。若重写失败,旧 base、旧增量与新增量仍共同表示当前数据。
- 子进程完成后,父进程以新 base 和当前增量构建临时 manifest,并将其持久化。
- 原子替换 manifest,让新集合生效,再清理旧 base 与不再使用的增量文件。
失败重写的重试会逐渐放慢,避免连续失败积累大量增量文件。后台重写不停止正常接收请求,但仍消耗 CPU、内存和磁盘资源,不能理解为完全没有性能影响。
区分尾部截断与中间损坏
写 AOF 时进程崩溃或磁盘写满,可能留下末尾半条命令。文档所述默认行为是在 aof-load-truncated 启用时,丢弃不完整尾部,继续加载之前一致的数据。原文示例日志如下,不是此次测试输出:
* Reading RDB preamble from AOF file...
* Reading the remaining AOF tail...
# !!! Warning: short read while loading the AOF file !!!
# !!! Truncating the AOF at offset 439 !!!
# AOF loaded anyway because aof-load-truncated is enabled
也可以调整配置,使这种情况阻止启动。较旧版本可能无法自动处理,需要使用随版本提供的检查工具;具体行为必须核对所用版本。
如果非法字节出现在日志中间,服务器可能报告格式错误并拒绝启动。应先保留原始 AOF 及相关多文件集合副本,再用不带 --fix 的 valkey-check-aof 只读检查,理解报告的偏移与损坏范围。原文的修复形式为 valkey-check-aof --fix <filename>,并建议比较修复前后的差异。
风险说明:--fix 会修改文件,可能丢弃损坏位置直到末尾的全部日志;损坏靠前时,损失会很大。应在隔离副本上分析和比较,确认可接受的损失后再决定恢复路径,不能盲目修改唯一副本。
在线从 RDB 转向 AOF
只修改 valkey.conf 后重启,可能造成数据丢失。必须先在仍持有当前内存数据的运行实例上启用 AOF,再等待它把已有状态持久化。以下是依据原文整理的顺序,全部未执行:
- 复制最近的
dump.rdb并保存到安全位置。 - 确认目标实例、授权身份和维护窗口,再在线启用 AOF。
- 观察重写完成且成功,并确认新写入进入 AOF。
- 把最终策略保存到持久配置,确保重启后仍生效。
- 在有回退方案的条件下验证重启后数据;除了键数量,还应检查代表性值、有效期和业务不变量。
# 仅说明操作形式;本文未连接或修改任何实例
valkey-cli CONFIG SET appendonly yes
valkey-cli INFO persistence
观察 aof_rewrite_in_progress=0、aof_rewrite_scheduled=0,并确认 aof_last_bgrewrite_status=ok。成功后,按部署方式更新 valkey.conf,或使用适用的 CONFIG REWRITE。忘记持久保存,会在重启后重新使用旧配置。
原文列出的 CONFIG SET save "" 只是可选关闭 RDB,不是开启 AOF 必须执行的步骤。需要保留两种方式时,不要关闭快照。命令示例没有硬编码密码;认证和 TLS 参数应由实际部署的凭证管理方式提供。
两类后台任务如何协调
Valkey 避免 RDB 快照和 AOF 重写两个后台过程同时执行繁重磁盘 I/O。快照期间收到 BGREWRITEAOF,成功响应表示任务已经安排,需等快照完成后开始;不能把“安排成功”解释为“重写完成”。
同时启用 RDB 与 AOF 时,重启使用 AOF 重建数据,因为它包含更完整的近期写入。RDB 仍具有独立归档和恢复价值。
备份 RDB:保留多个恢复点
RDB 生成后不会被原地修改;下一份快照先写临时文件,再通过原子重命名替换。因此,可以在服务运行时复制已完成的 RDB。官方建议分别保存小时和每日快照,并在文件名中加入时间。例如保留最近 48 小时的小时版本和一到两个月的每日版本,至少每天把一份副本传到机器外或数据中心外。
保留窗口需结合恢复目标、存储容量和备份失败情况。原文提到用 find 清理旧快照;本文不附自动删除命令。实际落地前应先列出拟删除对象,确认路径、日期条件以及仍有足够已验证恢复点,避免误删唯一有效副本。
备份 AOF:让 manifest 与文件集合保持一致
多文件 AOF 位于 appenddirname 指定目录。普通追加期间可以复制或打包;如果复制途中发生重写,manifest 与实际复制文件可能不匹配。原文流程是:
- 记录原来的
auto-aof-rewrite-percentage,临时设为0,并协调所有操作者,不要手工触发重写。 - 用
INFO persistence确认aof_rewrite_in_progress=0;否则等待已启动的重写结束。 - 复制目录内完整有效的 manifest、base 和增量文件集合。
- 完成后恢复原阈值,避免日志因一直禁用重写而不断增长。
如果备份期间可能重启,原文建议将临时关闭策略也通过 CONFIG REWRITE 保存,恢复阈值后再次保存。异常退出路径也应确保恢复配置,不要永久遗留临时状态。
为缩短禁止重写时间,原文还提出先建立文件硬链接,再恢复重写,随后复制或打包硬链接所引用的内容。它依赖文件系统支持以及 Valkey 只追加或整体替换文件的机制。编者补注:硬链接共享底层文件,不是独立备份,后续追加仍可变化;不能把它描述为冻结的时间点快照。最终必须验证清单与整个集合能加载,并做隔离恢复演练。
异地保存与恢复演练
灾难恢复是在备份基础上,把副本放进独立故障域。原文介绍了低成本方式:将小时或每日 RDB 加密后上传 S3 等存储,或通过 SSH/SCP 发往远方服务器,必要时选不同供应商的多个目的地。
原文提到 gpg -c 对称加密,并把解密材料保存在多个安全位置。加密副本与密钥必须都可恢复,但不应直接放进同一公开目录。需要限制备份身份的访问与删除权限,并使用独立告警,发现新备份未能送达的情况。
编者更正:原文为自动 SCP 提出免口令 SSH 私钥方案。无人值守凭证一旦泄露,可能赋予远端访问能力;应采用专用身份、最小权限和受限用途,保护私钥或使用合适的短期凭证。本文没有生成密钥或写入 authorized_keys。
原文要求传输后核对大小,必要时比较 SHA-1。这里建议用 SHA-256 等摘要校验完整性;但摘要一致只证明两端字节一致,不证明文件能够恢复,也不单独证明来源可信。应在隔离环境检查加载日志、键与有效期、代表性值和业务一致性,并测量恢复时间。没有恢复演练,最关键的不确定性仍然存在。
来源:Valkey Documentation: Persistence,© Valkey contributors。文档仓库 LICENSE 为 CC BY-SA 4.0,本译编及改写同许可提供。材料按原样提供,不作适用性或无错误保证。本文增加安全、版本和恢复验证说明,并纠正部分绝对化表述,不表示 Valkey 项目背书。
原文中段损坏日志
以下为原文说明AOF中间出现非法字节时的启动日志,并非运行结果;日志中的修复建议仍须遵守前文先保留副本、只读诊断、评估数据损失的步骤。
* Reading the remaining AOF tail...
# Bad file format reading the append only file: make a backup of your AOF file, then use ./valkey-check-aof --fix <filename>










暂无评论内容