


保存小红书图片时,下载版本有时会带水印。要分析不同资源版本的差别,可以先从浏览器开发者工具里的请求看起。
这里把分析过程整理一下:先看请求,再找页面数据,最后检查实际返回的图片或视频。
本文主要讲思路,不展开完整代码。内容包括图片、视频和实况照片的资源定位,以及做成 CLI、Web 工具时需要处理的细节。
1. 先观察:水印到底是怎么加上去的?
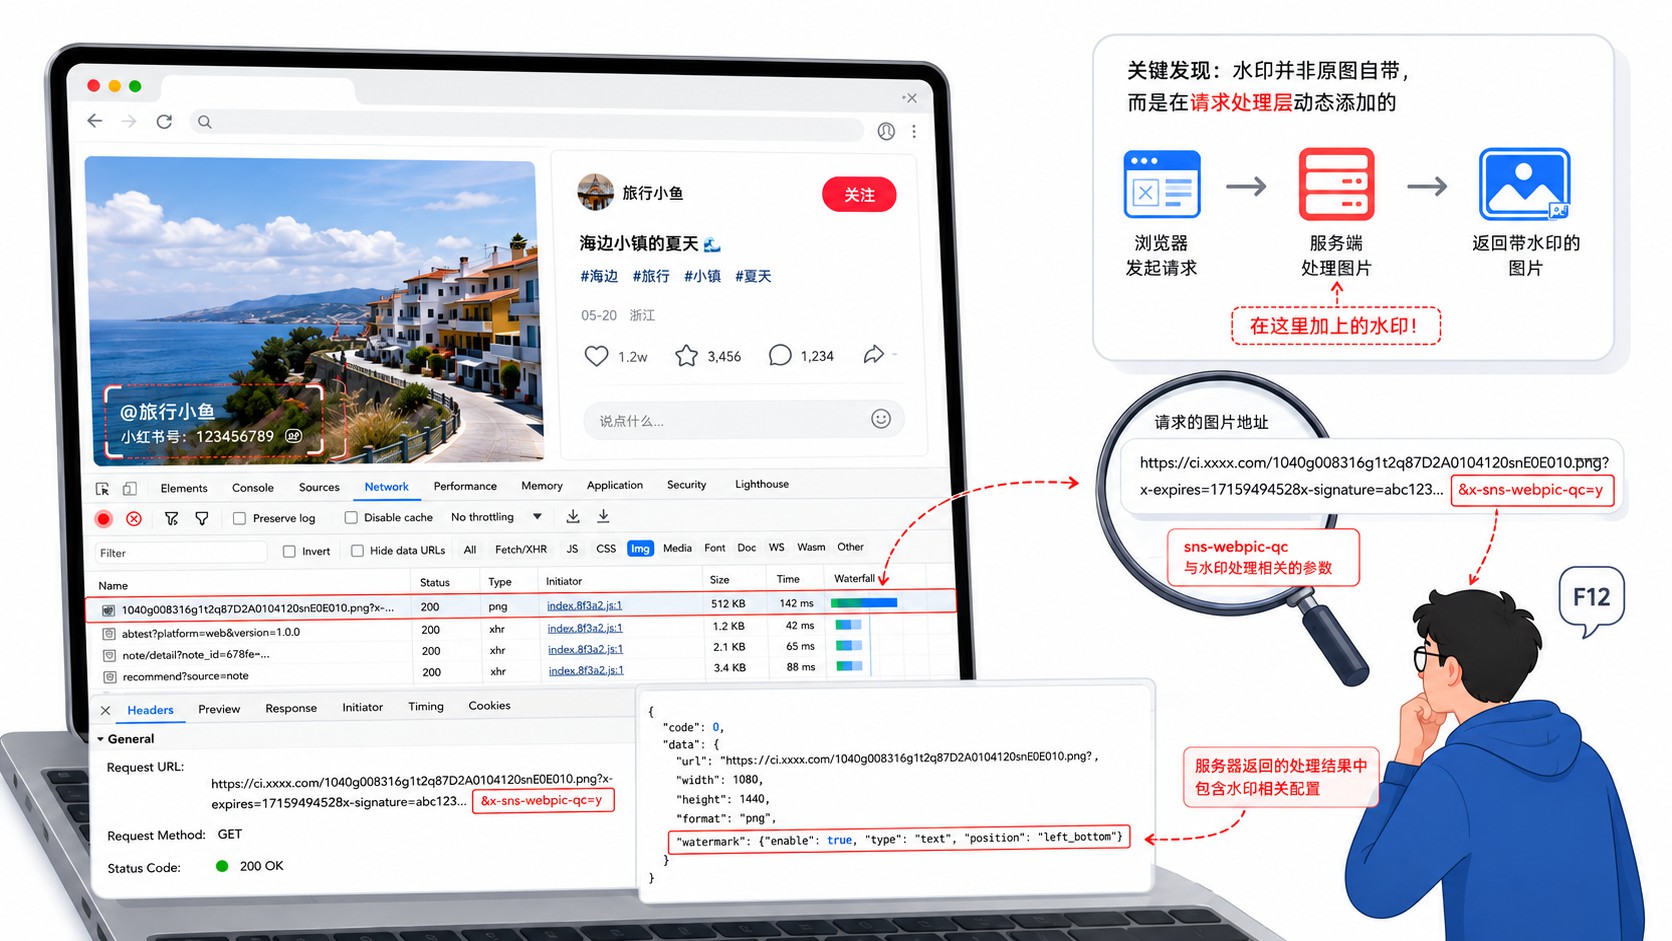
打开一篇小红书笔记,F12 → Network,随便点开一张图片的请求,看 URL:
https://sns-webpic-qc.xhscdn.com/xxxx注意主机名中的 sns-webpic-qc。qc 可能与质量处理有关,但这只是从命名得到的推测,不能据此确认其缩写或水印处理链路。应比较同一图片的不同响应,核对尺寸、格式与水印,判断是否存在其他资源版本。
接下来要验证的是:页面是否实际返回了可访问的其他图片版本,它们与当前版本有什么差别?
2. 翻数据:页面里藏了什么宝贝
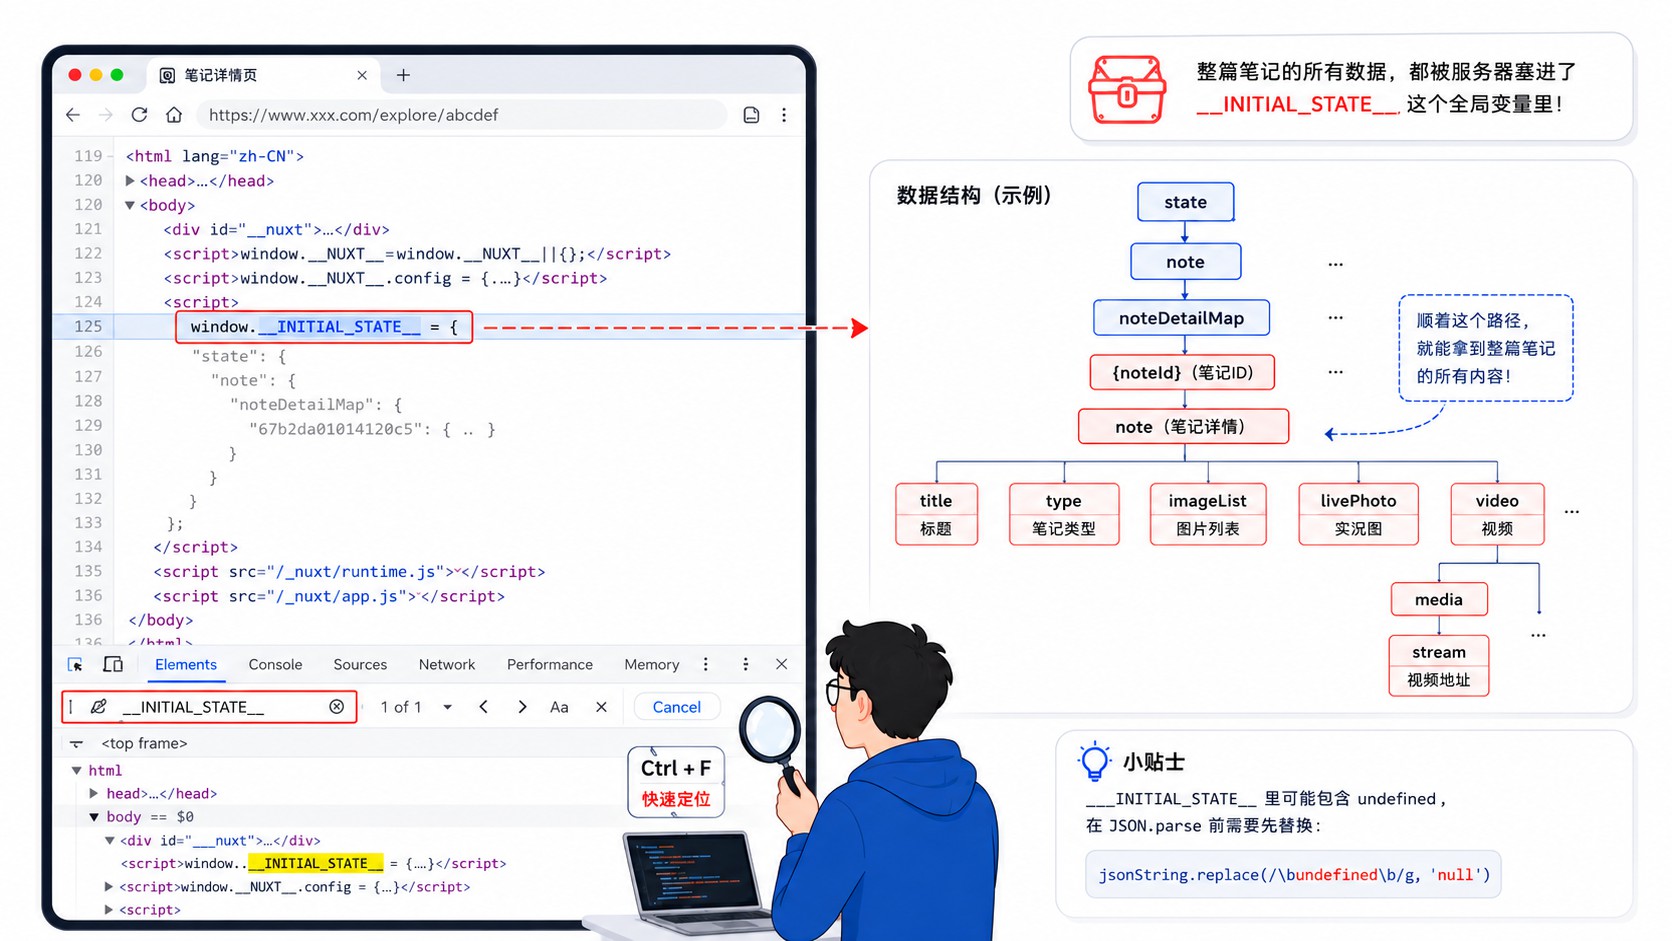
部分历史样本的 HTML 或内联脚本中可以找到 window.__INITIAL_STATE__ 一类初始化状态,但这不证明所有页面都采用同一渲染方式,也不保证普通 HTTP 请求能取得全部内容。可以在开发者工具中搜索 __INITIAL_STATE__,再检查实际返回结构。下面只是赋值形式示意,不是可执行代码:
window.__INITIAL_STATE__ = { ... 一大坨 JSON ... }以下是历史样本的数据结构示意。字段可能缺失或变化,读取前要检查实际类型,不能把它当作稳定的接口契约:
state
 └── note
      └── noteDetailMap
           └── {noteId}
                └── note
                     ├── title        → 笔记标题
                     ├── type         → "normal"(图文)或 "video"(视频)
                     ├── imageList[]  → 图片数组
                     │    ├── traceId    → 样本中的资源标识(关键)
                     │    ├── fileId     → 备用标识
                     │    ├── urlDefault → 默认图片地址(检查水印)
                     │    └── livePhoto  → 实况照片数据
                     └── video
                          └── media.stream
                               ├── h264[]  → 视频流(通常兼容较广)
                               ├── h265[]  → 视频流
                               └── av1[]   → 视频流
如果普通 HTTP 请求取得的 HTML 已包含初始化数据,就不一定需要 Selenium 或 Playwright。先可靠定位数据边界,再检查它是否是标准 JSON;标准 JSON 才直接用 json.loads 解析。JavaScript 对象字面量不一定是 JSON,不能用宽泛正则截取任意嵌套对象,也不要用 eval 执行网页脚本。
裸 undefined 不是 JSON 值。需要处理这类初始化脚本时,应使用不执行脚本的语法解析方法,区分字符串、转义和代码 token,只接受明确支持的字面量结构,遇到未知表达式就报错。
3. 灵魂一步:用 traceId 拼出无水印原图地址
历史样本的 imageList 中曾出现 traceId 一类资源标识。它与资源地址的对应关系要以当前样本验证,不能保证只凭该字段就能取得原文件。
下面是一个候选 URL 模板,用来说明如何根据资源标识检查图片地址:
https://ci.xiaohongshu.com/{traceId}?imageView2/2/format/png这个模板在部分样本中对应不带水印的图片。使用时仍应核对当前响应的内容、尺寸、格式和水印,不能只根据 URL 判断。
imageView2 在七牛官方文档中用于图片处理,format/png 是输出格式转换。因此,即使模板返回图片,也不能据此称其为未经处理的 CDN 源文件,更不能确认小红书内部的水印处理链路。
如果 traceId 不存在,还可以检查 fileId。对于带 spectrum/xxxxxx 一类前缀的值,部分样本可以取最后一段使用;前缀也可能属于完整资源键,需要先核对当前地址规则。另一种方式是使用页面明确返回的 urlDefault,再检查实际水印情况。
4. 视频怎么拿?
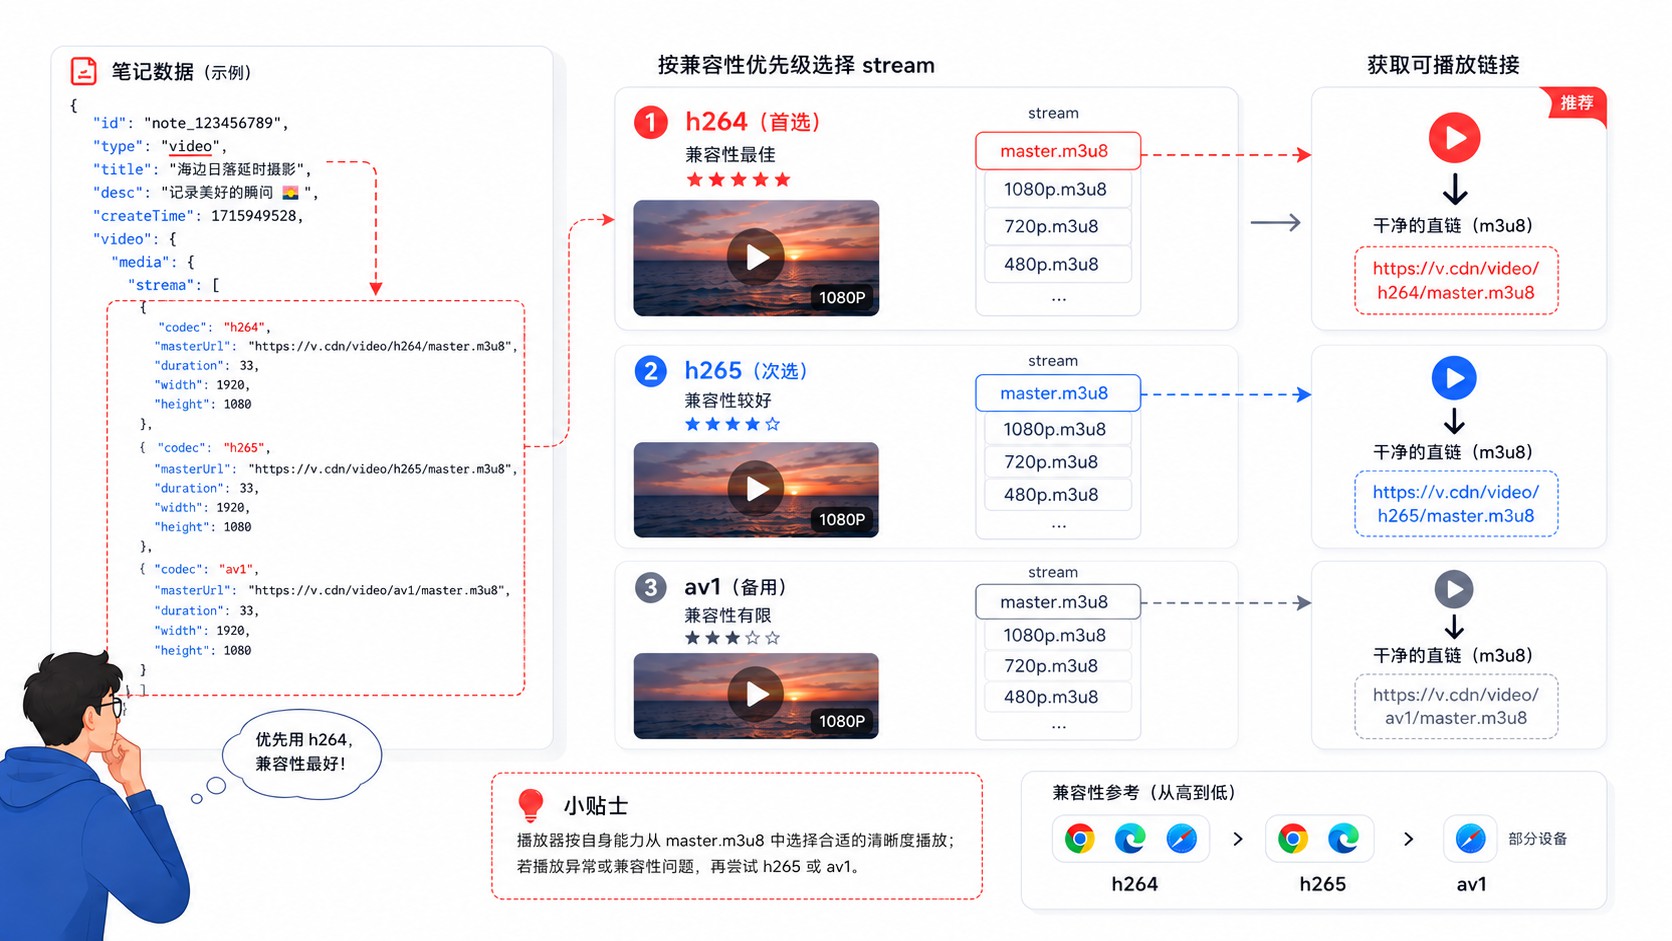
视频类型的笔记,note.type 是 "video",视频流地址在 note.video.media.stream 下面。
样本中的 stream 曾包含 h264、h265、av1 数组及 masterUrl 字段。读取前检查对象、数组和 URL 类型,数组为空时不能直接取第一个元素,第一项也不必然是最高质量。
H.264 通常兼容范围较广,但能否播放还取决于编码参数、容器和设备。H.265、AV1 的压缩效果与兼容性也应按实际资源选择,不能仅凭编码名称判断。
拿到 masterUrl 后,可以下载自己有权获取的资源。部分视频直链对应不带水印的文件,具体结果仍要看实际返回内容。
5. 实况照片:最折腾的部分
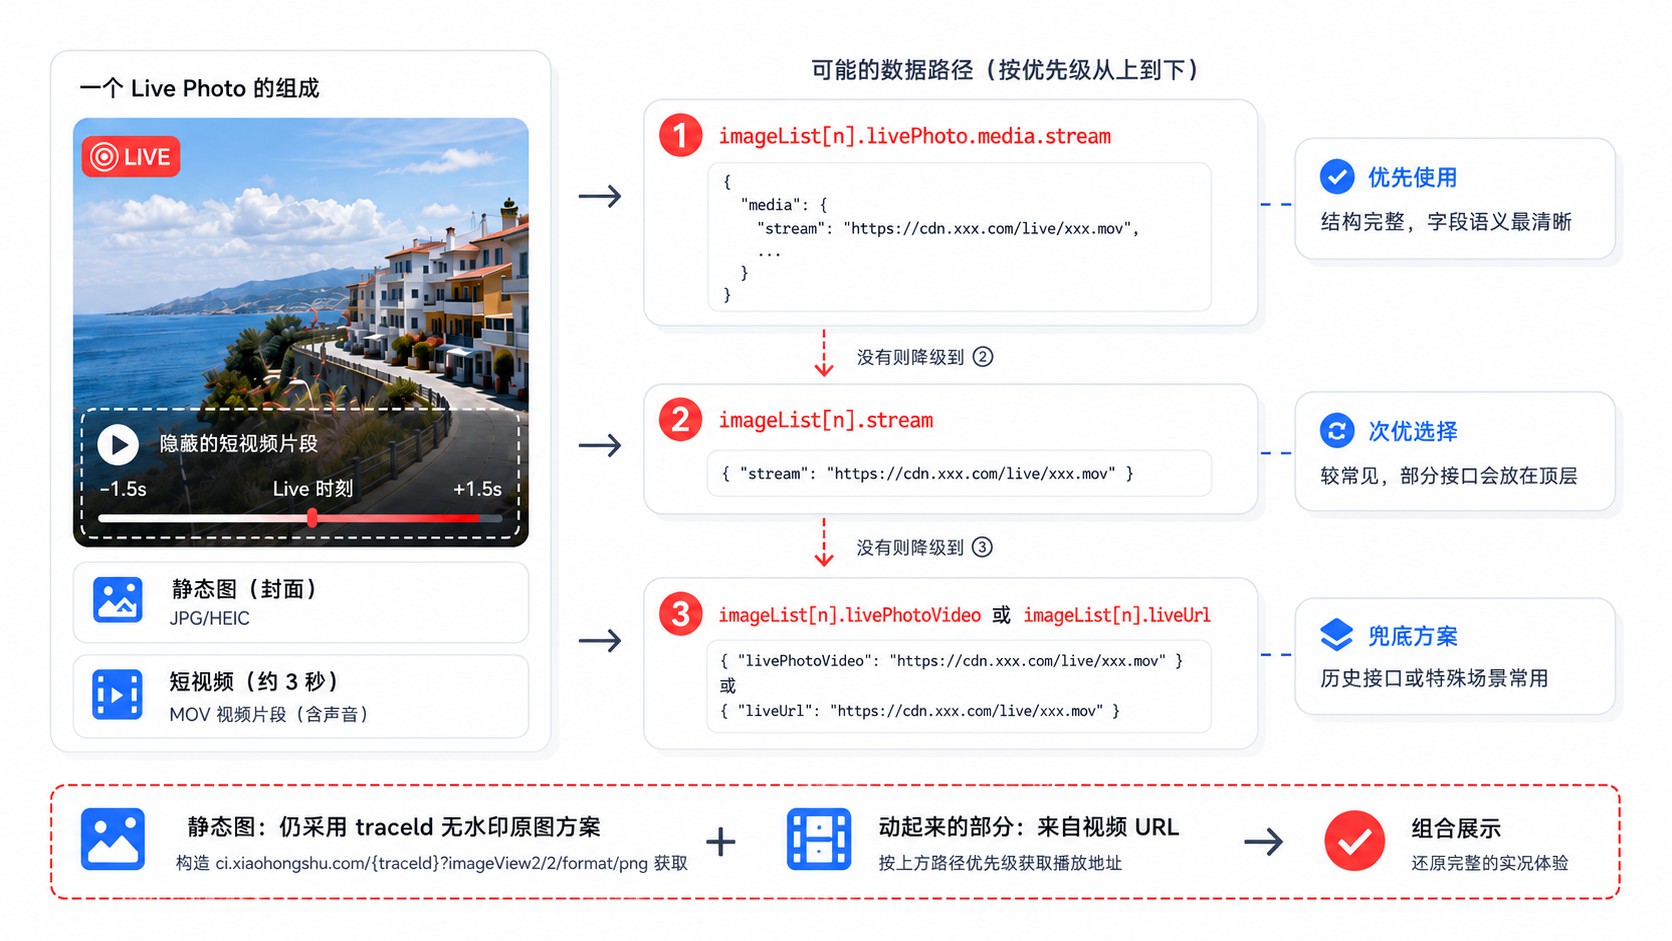
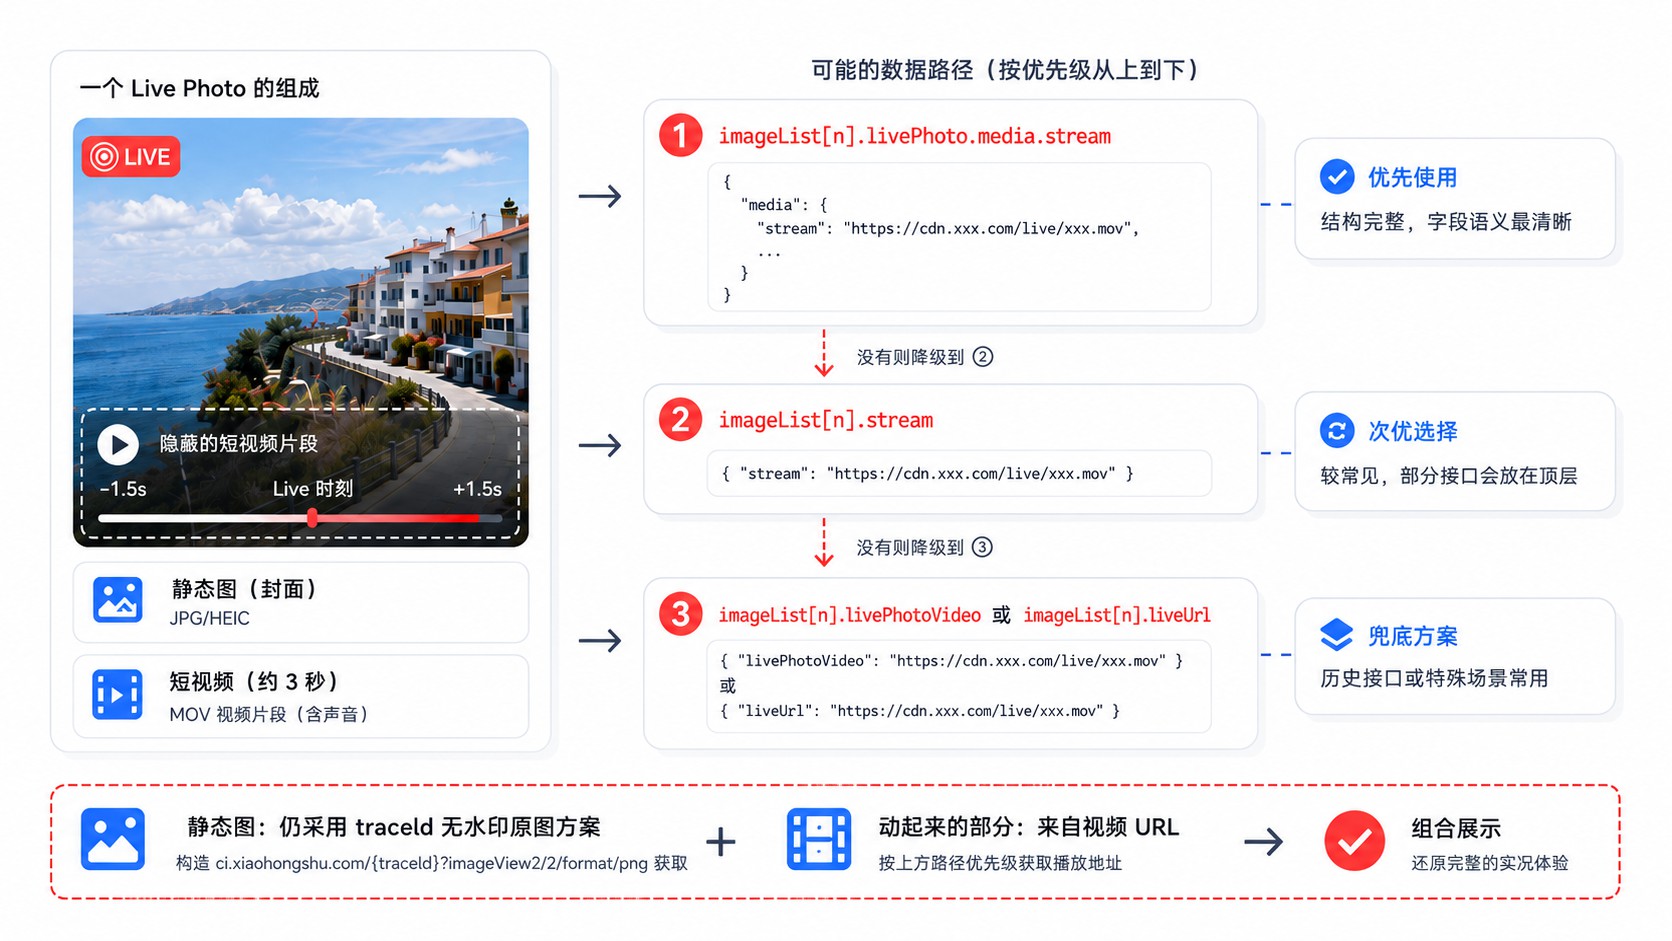
实况照片相关数据可能包含静态图和短视频,两者需要分别检查。分别保存两个文件,也不等于已经生成系统相册可识别的 Live Photo 配对文件。
实况视频的数据可以依次检查下面三个位置:
最常见的: imageList[n].livePhoto.media.stream —— 和主视频一样的结构,按编码分组,取 masterUrl。
旧版本: imageList[n].stream —— 直接挂在图片对象的顶层,不在 livePhoto 下面。
兜底字段: imageList[n].livePhotoVideo 或 imageList[n].liveUrl —— 有些笔记会把实况视频的 URL 直接扔在这些字段里,没有嵌套结构。
这些路径仅覆盖曾观察到的样本。逐项检查结构和返回内容,没有符合预期的字段时明确提示不支持,不能声称新老笔记都能正确提取。
6. 分享链接的处理
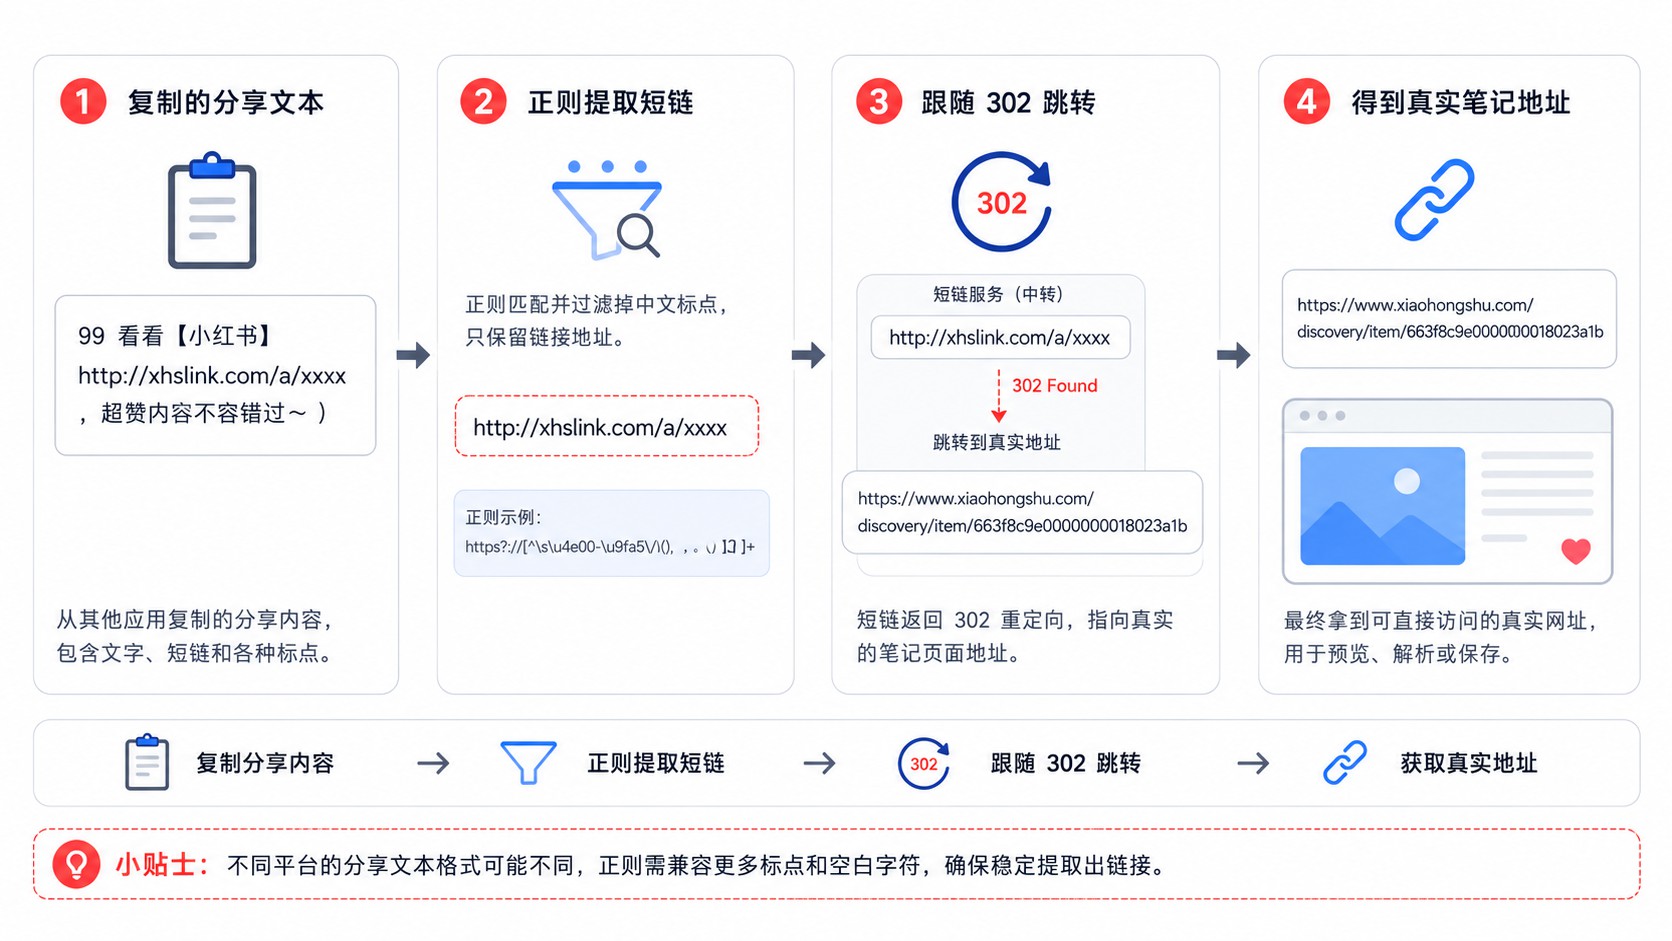
从 App 里复制出来的分享文本通常长这样:
99 看看〖小红书〗 http://xhslink.com/a/xxxx先从分享文本识别候选链接,再用 URL 解析器校验协议和精确主机名。正则可以用于初步提取,但不能充当安全校验。xhslink.com 短链可能多次跳转,不能假定只有一次 302。
先把分享链接处理好,后面的页面解析才能使用正确的笔记地址。
7. 做成工具时的几个设计决策
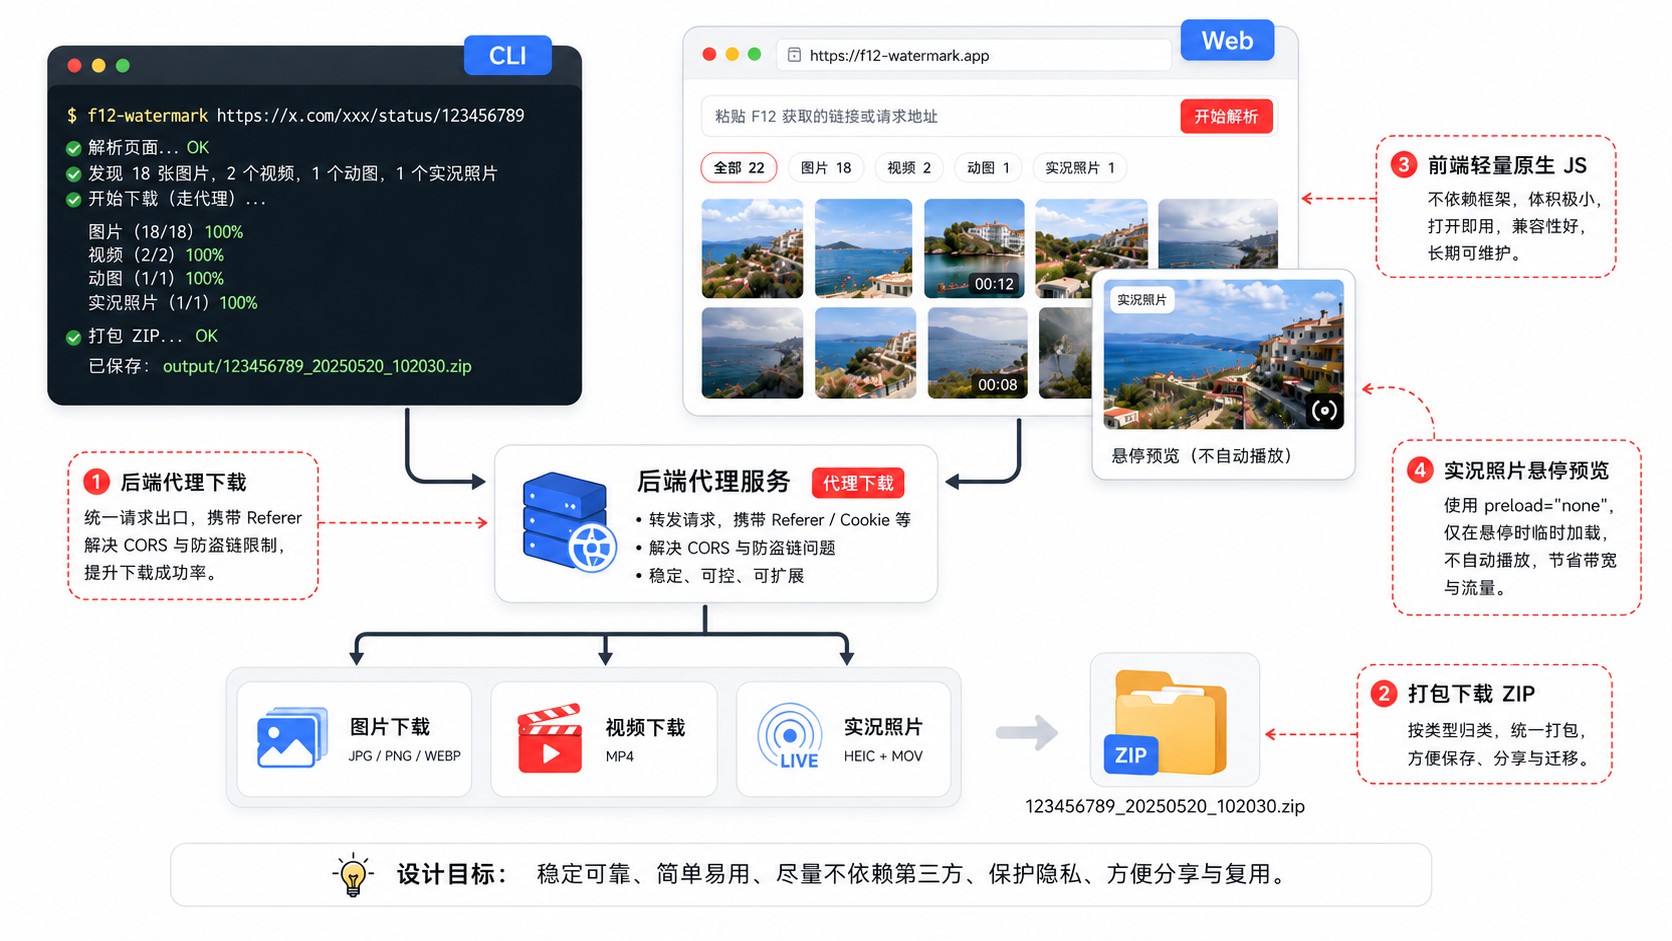
工具可以提供 CLI 和 Web 两种使用方式。下面说明几个实现上的选择:
为什么需要后端代理下载?前端 fetch 读取跨域内容可能受 CORS 限制,而 img/video 跨域展示与读取内容的规则不同。Referer 防盗链、鉴权和 CORS 需要分别排查。确有需要且有权获取资源时,可用受限制的后端代理转发下载;中文文件名可用 Content-Disposition 的 filename* 参数和 UTF-8 百分号编码处理(RFC 5987 编码形式),同时过滤路径分隔符等不安全字符。
打包下载:一篇笔记可能有多张图片和视频,可以通过一个接口把图片、实况视频和主视频打包为 ZIP,减少逐个保存的操作。
前端结构:一个输入框、图片网格和几个按钮,用原生 JavaScript 就能组织。这里的示例方案约一百多行,不需要构建步骤,修改后刷新即可查看效果;功能变复杂时,再考虑是否引入框架。
实况照片的交互可以通过叠放 <video> 元素预览,用 position: absolute 和 opacity 控制显隐。preload="none" 只是建议浏览器不要提前加载,并非绝对流量开关;播放或 autoplay 等行为仍会触发下载。需要更严格控制时,在用户触发预览后才设置 src,并处理 play() 被浏览器拒绝的情况。
8. 踩过的坑
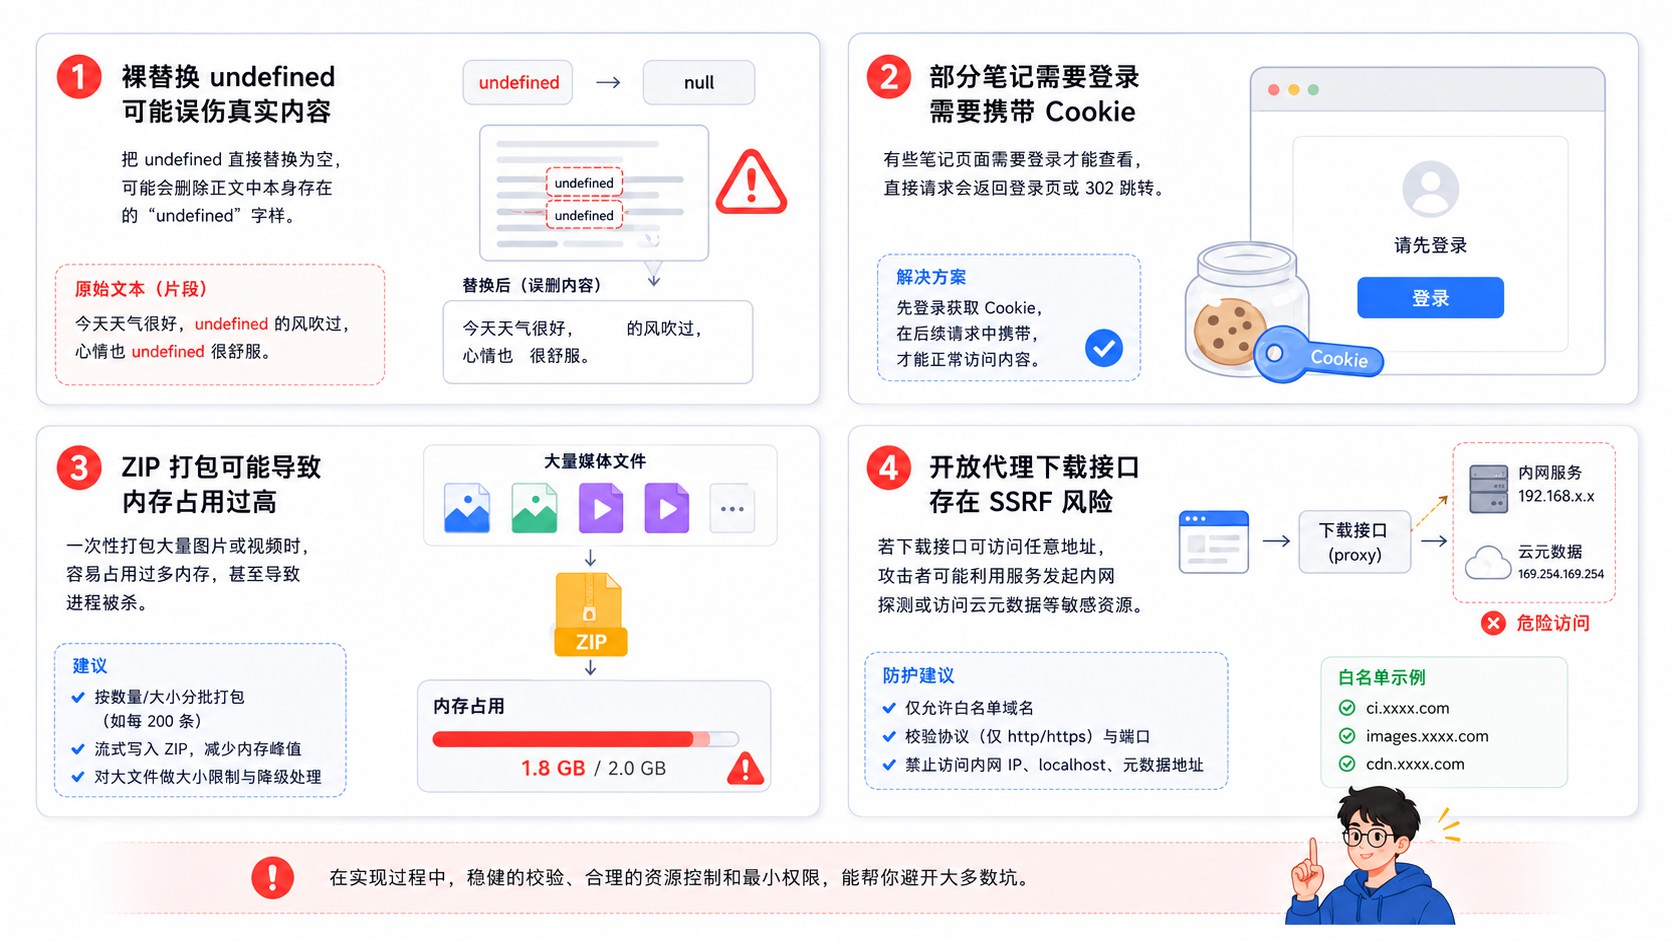
undefined 替换的误伤:全局 replace("undefined", "null") 和加词边界的正则都不能识别字符串边界,例如字符串里的 "undefined" 仍会被改坏。应按前文的语法解析思路处理,而不是简单替换文本。
缺少初始化状态:可能由登录、权限、风控、动态加载或版本变化造成,不能直接判断原因。只通过正常登录流程处理自己有权访问的内容;不要收集他人的 Cookie,也不要在公开工具、日志或前端代码中泄露会话凭据。
打包下载的内存问题:本地和公开服务都应限制单文件、总体积与并发,分块下载并流式写入 ZIP 或受限临时文件,成功和失败后都要清理。不能以“本地用无所谓”忽略资源耗尽。
安全风险:后端代理优先接收经过校验的资源标识,再由服务端构造 URL;如必须接收 URL,用解析器检查协议、端口和精确主机白名单,不做简单子串匹配。禁用自动重定向,或逐跳重新校验;同时检查实际 DNS/IP,阻止回环、私网、链路本地及元数据地址,并设置网络出站、大小、超时和并发限制。仅有域名白名单不足以完成 SSRF 防护。
最后
核心方法是观察授权页面返回的数据和资源请求,形成假设,再对实际响应逐项验证。内部字段、资源地址与处理参数都会变化,历史样本中的成功不能当作今天仍有效的保证。
按请求、数据结构和实际响应的顺序检查,保留观察结果,再逐步调整实现。
技术参考
Python JSON 文档 · 七牛 imageView2 · MDN 同源策略 · MDN video · OWASP SSRF 防护








暂无评论内容