


-
Meta 团队从根本上改造了 Facebook 群组搜索,帮助用户更可靠地发现、梳理和验证与自己最相关的社区内容。
-
Meta 团队采用新的混合检索架构,并实现自动化模型评估,解决用户搜索社区内容时面临的主要障碍。
-
在这个新框架下,搜索互动和相关性有了切实改善,同时错误率没有上升。
世界各地的人每天都依赖 Facebook 群组寻找有用信息,但内容太多,用户的查找过程并不总是顺畅。在把兴趣相近的人联系起来的同时,Meta 团队也需要在大量对话中设计出一条路径,尽可能精准地呈现他们所寻找的内容。Meta 团队发表了一篇论文,介绍 如何通过重构 Facebook 群组范围搜索解决这些问题。通过从传统关键词匹配转向混合检索架构,并实现自动化模型评估,Meta 团队正在改变人们发现、阅读和验证社区内容的方式。
解决社区知识中的使用障碍
用户在社区内容中寻找答案时,主要面临发现、阅读和验证三个方面的障碍。
发现:表达方式不同导致匹配失败
过去,内容发现依赖基于关键词的词法系统。这些系统寻找精确词语,使用户的自然语言意图与现有内容之间出现鸿沟。例如,用户搜索“带糖霜的独立小蛋糕”,而社区使用的是“纸杯蛋糕”一词,传统关键词系统可能返回零条结果。具体用语不一致,使用户错过高度相关的建议。
Meta 团队需要这样的系统:搜索“意大利咖啡饮品”时,即使帖子没有明确出现“咖啡”一词,也能有效匹配关于“卡布奇诺”的帖子。
阅读:额外的整理成本
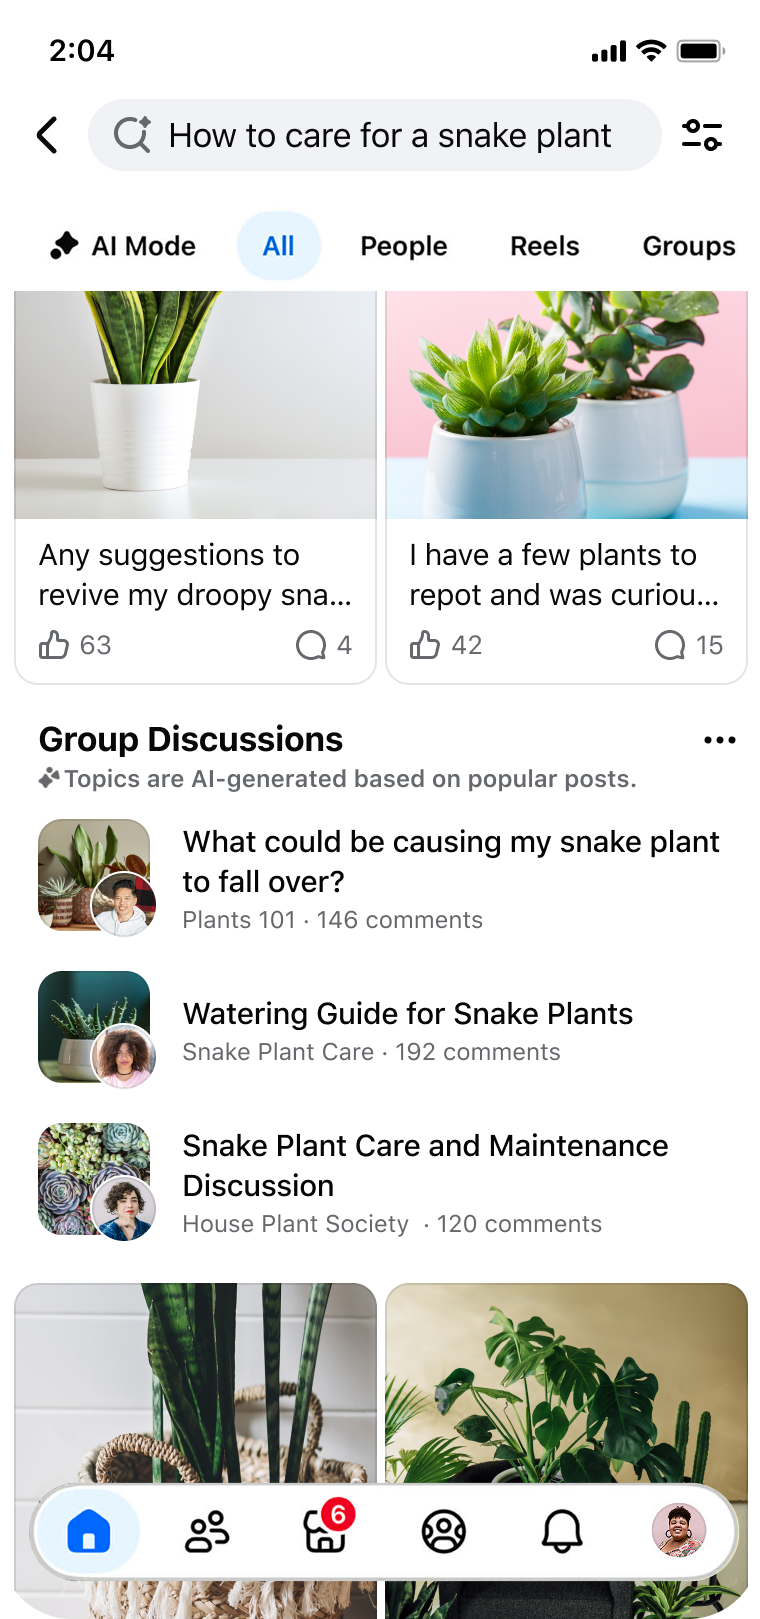
即便找到正确内容,用户仍要付出“整理成本”:往往需要滚动浏览并梳理大量评论,才能确定大家的共识。比如搜索“虎尾兰养护技巧”,为了得到明确答案,可能要读几十条评论,才能拼出合适的浇水计划。
验证:借助社区知识做决策
人们经常需要借助可信的社区经验,核实某个决策或潜在购买行为。例如,Facebook Marketplace 上的买家看到一辆价格较高的经典 Corvette,购买前希望获得真实评价和建议,但这些经验通常散落在群组讨论中。用户需要利用专业群组的集体智慧有效评估商品,然而手动挖掘这些验证信息并不容易。
解决方案:现代化混合检索架构
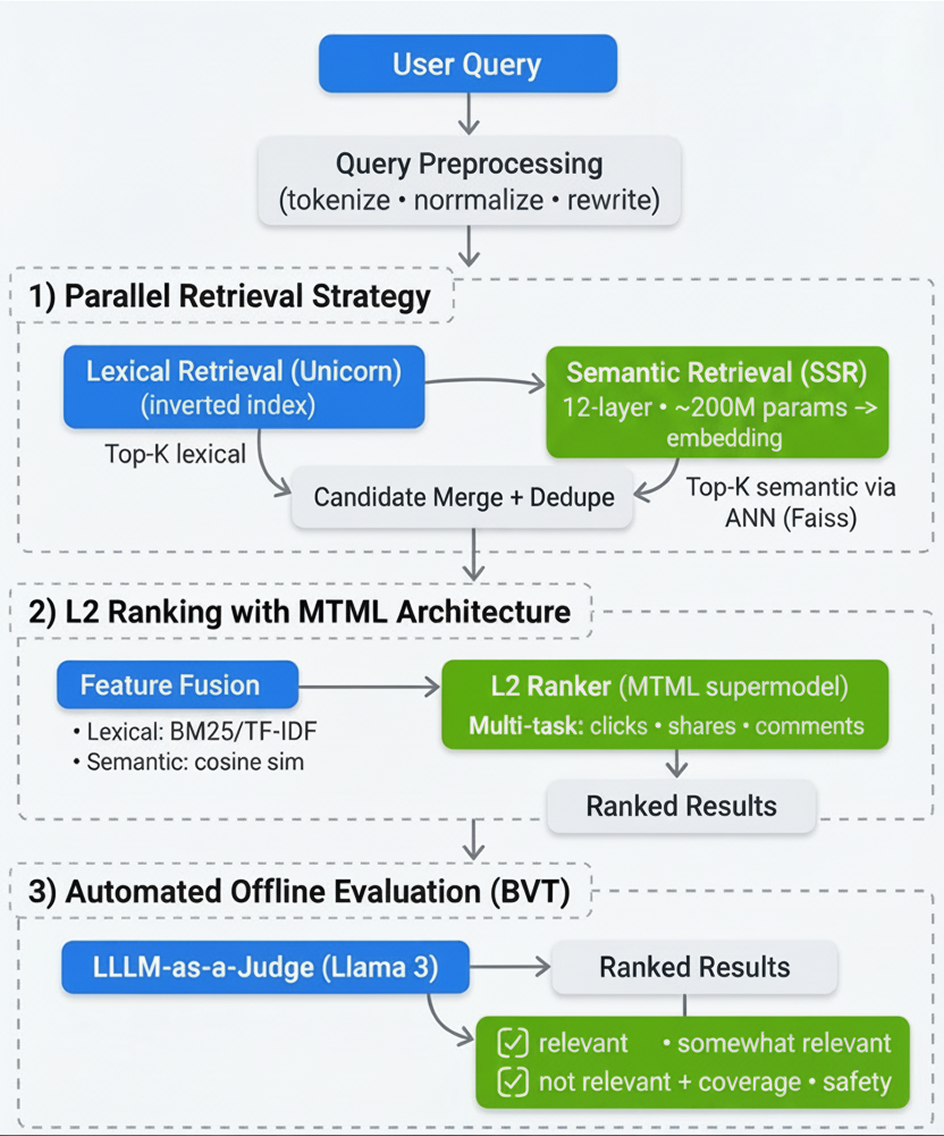
Meta 团队构建了混合检索架构,为 Facebook 搜索中的讨论模块提供支持。系统通过并行管线,把倒排索引的精确性与稠密向量表示的概念理解能力结合起来。为解决旧搜索的限制,Meta 团队重构了基础设施的三个重要部分。
下面的流程展示了Meta 团队如何更新技术栈,以处理自然语言意图:
并行检索策略
Meta 团队把查询处理拆成两条并行路径,更新召回阶段,确保同时捕捉精确词语和宽泛概念:
查询预处理:检索之前,用户查询先经过分词、规范化和改写。这对于向倒排索引和嵌入模型提供干净输入都很重要。
词法路径(Unicorn):利用 Facebook 的 Unicorn 倒排索引 获取包含精确词语或近似匹配词语的帖子,保证专有名词或特定引用类查询的高精确性。
同时,查询被传递给搜索语义检索器 SSR。这是一个12层、2亿参数的模型,把用户自然语言输入编码为稠密向量。随后在预先计算的群组帖子 Faiss 向量索引上执行近似最近邻(ANN)搜索。这样,即使关键词不重叠,也能根据高维概念相似性召回内容。
采用多任务多标签(MTML)架构的 L2 排序
稀疏词法特征和稠密语义特征来自根本不同的范式,要合并两者的结果,需要更精细的排序策略。关键词系统与嵌入系统召回的候选项在排序阶段合并。模型同时接收词法特征,例如 TF-IDF、BM25 分数,以及语义特征,例如余弦相似度分数。
接下来,Meta 团队从单目标模型转向 MTML 超级模型架构。它在保持即插即用模块化能力的同时,联合优化点击、分享和评论等多个互动目标。通过对这些信号加权,模型让最终结果既具有理论相关性,也更有可能促成有意义的社区互动。
自动化离线评估
语义搜索带来新的验证难题:高维向量空间中的相似度分数并不总是直观。为了大规模验证质量,同时避免人工标注成为瓶颈,Meta 团队在构建验证测试(BVT)过程中集成了自动化评估框架。
Meta 团队使用具备多模态能力的 Llama 3 作为自动评判者,对查询与搜索结果进行评分。不同于“好/坏”二元标签,评估提示词专门捕捉细微差别。系统明确识别“有一定相关性”类别:查询与结果具有共同领域或主题,例如不同运动在一般体育上下文中仍然相关。这样可以衡量结果多样性和概念匹配的改进。
影响与未来工作
部署混合架构后,质量指标出现可衡量的提升,说明将词法精确性与神经理解能力结合,优于只使用关键词的方法。根据原文中 Meta 团队的离线评估结果,与基线相比,新的 L2 Model + EBR(Hybrid)系统在搜索互动方面表现更好,指标涉及每天在 Facebook 上进行搜索的用户数量。
这些结果说明,通过整合语义召回,Meta 团队能够呈现更多相关内容,同时保留用户期待的精确性。检索栈升级是重要里程碑,但只是释放社区知识价值的起点。未来的工作将进一步把高级模型融入搜索体验:
-
在排序中使用大语言模型:计划直接在排序阶段应用 LLM,通过处理帖子内容,将相关性评分进一步推进到向量相似度之外。
-
自适应检索:探索由 LLM 驱动的自适应检索策略,根据用户查询的复杂程度动态调整检索参数。











暂无评论内容