


In [1]: import pandas as pd
本教程使用的数据:
-
泰坦尼克号数据
本教程使用以 CSV 保存的泰坦尼克号数据集,包含以下列:
-
PassengerId:每位乘客的ID。
-
Survived:乘客是否生还,
0表示否,1表示是。 -
Pclass:三种票舱等级之一,分别为
1、2和3。 -
Name:乘客姓名。
-
Sex:乘客性别。
-
Age:乘客年龄,以年为单位。
-
SibSp:同行兄弟姐妹或配偶数量。
-
Parch:同行父母或子女数量。
-
Ticket:票号。
-
Fare:票价。
-
Cabin:客舱编号。
-
Embarked:登船港口。
In [2]: titanic = pd.read_csv("data/titanic.csv") In [3]: titanic.head() Out[3]: PassengerId Survived Pclass ... Fare Cabin Embarked 0 1 0 3 ... 7.2500 NaN S 1 2 1 1 ... 71.2833 C85 C 2 3 1 3 ... 7.9250 NaN S 3 4 1 1 ... 53.1000 C123 S 4 5 0 3 ... 8.0500 NaN S [5 rows x 12 columns] -
-
空气质量数据
本教程使用 OpenAQ 提供、通过 py-openaq 包获取的 NO2 与粒径小于2.5微米的颗粒物数据。
air_quality_long.csv数据集包含巴黎 FR04014、安特卫普 BETR801、伦敦 London Westminster 三个监测站的 NO2 和 PM2.5 浓度。空气质量数据集包含以下列:
-
city:传感器所在城市,Paris、Antwerp 或 London。
-
country:传感器所在国家,FR、BE 或 GB。
-
location:传感器ID,FR04014、BETR801 或 London Westminster。
-
parameter:传感器测量的参数,即 NO2 或颗粒物。
-
value:测量值。
-
unit:测量参数的单位,此处为 µg/m³。
DataFrame的索引是datetime,即测量时间。提示
空气质量数据以“长格式”提供:每条观测占一行,每个变量占数据表的一列。长表或窄表格式也称为 整洁数据格式(tidy data)。
In [4]: air_quality = pd.read_csv( ...: "data/air_quality_long.csv", index_col="date.utc", parse_dates=True ...: ) ...: In [5]: air_quality.head() Out[5]: city country location parameter value unit date.utc 2019-06-18 06:00:00+00:00 Antwerpen BE BETR801 pm25 18.0 µg/m³ 2019-06-17 08:00:00+00:00 Antwerpen BE BETR801 pm25 6.5 µg/m³ 2019-06-17 07:00:00+00:00 Antwerpen BE BETR801 pm25 18.5 µg/m³ 2019-06-17 06:00:00+00:00 Antwerpen BE BETR801 pm25 16.0 µg/m³ 2019-06-17 05:00:00+00:00 Antwerpen BE BETR801 pm25 7.5 µg/m³ -
如何重塑表格布局
排序表格行
-
我想按乘客年龄排序泰坦尼克号数据。
In [6]: titanic.sort_values(by="Age").head()
Out[6]:
     PassengerId  Survived  Pclass  ...     Fare Cabin  Embarked
803          804         1       3  ...   8.5167   NaN         C
755          756         1       2  ...  14.5000   NaN         S
644          645         1       3  ...  19.2583   NaN         C
469          470         1       3  ...  19.2583   NaN         C
78            79         1       2  ...  29.0000   NaN         S

[5 rows x 12 columns]
-
我想按票舱等级和年龄,以降序排序泰坦尼克号数据。
In [7]: titanic.sort_values(by=['Pclass', 'Age'], ascending=False).head() Out[7]: PassengerId Survived Pclass ... Fare Cabin Embarked 851 852 0 3 ... 7.7750 NaN S 116 117 0 3 ... 7.7500 NaN Q 280 281 0 3 ... 7.7500 NaN Q 483 484 1 3 ... 9.5875 NaN S 326 327 0 3 ... 6.2375 NaN S [5 rows x 12 columns]DataFrame.sort_values()按指定列排序表格行,索引会跟随行顺序移动。
用户指南
更多表格排序细节,请参见用户指南的 数据排序 一节。
长表转宽表
先取空气质量数据的一小部分。只关注 NO2 数据,每个监测站只取前两次测量,也就是每组的前两行。这个子集称为 no2_subset。
# filter for no2 data only
In [8]: no2 = air_quality[air_quality["parameter"] == "no2"]
# use 2 measurements (head) for each location (groupby)
In [9]: no2_subset = no2.sort_index().groupby(["location"]).head(2)

In [10]: no2_subset
Out[10]:
                                city country  ... value   unit
date.utc                                      ...
2019-04-09 01:00:00+00:00  Antwerpen      BE  ...  22.5  µg/m³
2019-04-09 01:00:00+00:00      Paris      FR  ...  24.4  µg/m³
2019-04-09 02:00:00+00:00     London      GB  ...  67.0  µg/m³
2019-04-09 02:00:00+00:00  Antwerpen      BE  ...  53.5  µg/m³
2019-04-09 02:00:00+00:00      Paris      FR  ...  27.4  µg/m³
2019-04-09 03:00:00+00:00     London      GB  ...  67.0  µg/m³

[6 rows x 6 columns]
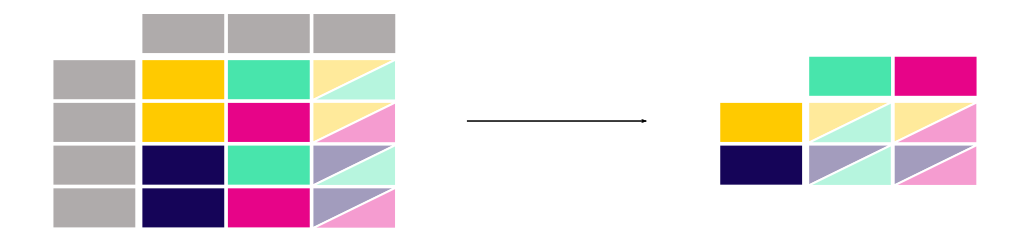
-
我想让三个监测站的数据分别成为相邻的独立列。
In [11]: no2_subset.pivot(columns="location", values="value") Out[11]: location BETR801 FR04014 London Westminster date.utc 2019-04-09 01:00:00+00:00 22.5 24.4 NaN 2019-04-09 02:00:00+00:00 53.5 27.4 67.0 2019-04-09 03:00:00+00:00 NaN NaN 67.0pivot()只重排数据:每个索引与列的组合必须对应一个值。
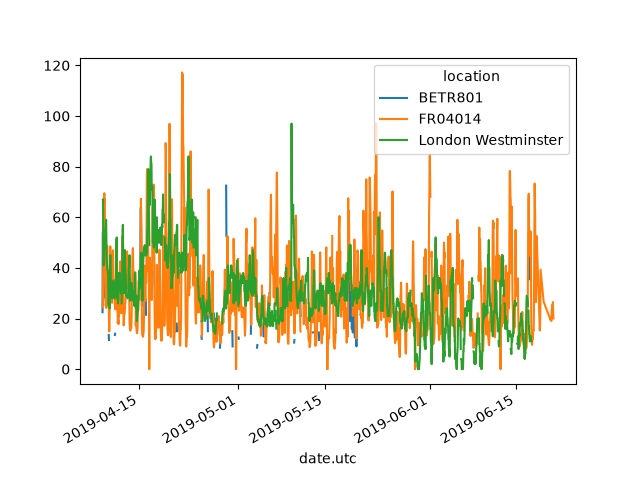
pandas 原生支持多列绘图,参见 绘图教程。因此,把长表转成宽表后,就能同时绘制不同的时间序列:
In [12]: no2.head()
Out[12]:
                            city country location parameter  value   unit
date.utc
2019-06-21 00:00:00+00:00  Paris      FR  FR04014       no2   20.0  µg/m³
2019-06-20 23:00:00+00:00  Paris      FR  FR04014       no2   21.8  µg/m³
2019-06-20 22:00:00+00:00  Paris      FR  FR04014       no2   26.5  µg/m³
2019-06-20 21:00:00+00:00  Paris      FR  FR04014       no2   24.9  µg/m³
2019-06-20 20:00:00+00:00  Paris      FR  FR04014       no2   21.4  µg/m³
In [13]: no2.pivot(columns="location", values="value").plot()
Out[13]: <Axes: xlabel='date.utc'>
提示
不定义 index 参数时,使用现有索引,即行标签。
用户指南
更多 pivot() 信息,请参见用户指南的 DataFrame 对象的透视变换 一节。
透视表
-
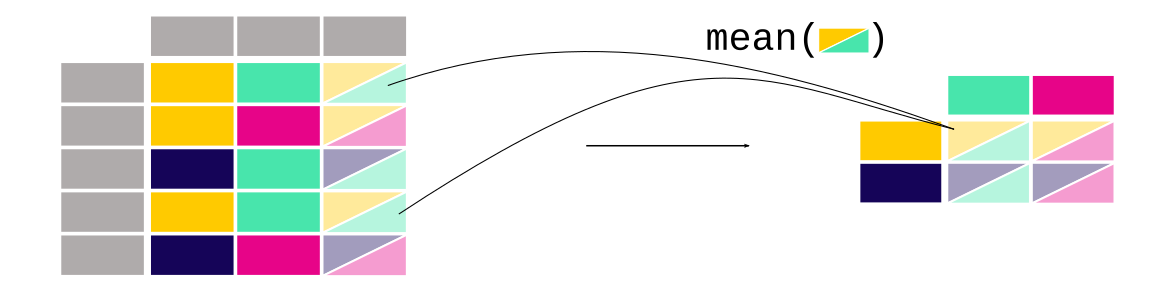
我想以表格形式显示各监测站 NO2 和 PM2.5 的平均浓度。
In [14]: air_quality.pivot_table( ....: values="value", index="location", columns="parameter", aggfunc="mean" ....: ) ....: Out[14]: parameter no2 pm25 location BETR801 26.950920 23.169492 FR04014 29.374284 NaN London Westminster 29.740050 13.443568pivot()只重排数据。如果需要聚合多个值——本例是不同时间点的测量值——可使用pivot_table(),并提供聚合函数,例如 mean,决定如何合并。
透视表是电子表格软件中的常见概念。如果希望查看每个变量的行列汇总值,将 margins 参数设为 True:
In [15]: air_quality.pivot_table(
   ....:     values="value",
   ....:     index="location",
   ....:     columns="parameter",
   ....:     aggfunc="mean",
   ....:     margins=True,
   ....: )
   ....:
Out[15]:
parameter                 no2       pm25        All
location
BETR801             26.950920  23.169492  24.982353
FR04014             29.374284        NaN  29.374284
London Westminster  29.740050  13.443568  21.491708
All                 29.430316  14.386849  24.222743
用户指南
更多 pivot_table() 信息,请参见用户指南的 透视表 一节。
提示
pivot_table() 的确与 groupby() 直接相关。也可以同时按 parameter 与 location 分组,得到同样结果:
air_quality.groupby(["parameter", "location"])[["value"]].mean()
用户指南
宽表转长表
再次从上一节创建的宽表开始,在 DataFrame 上调用 reset_index() 添加新索引。
In [16]: no2_pivoted = no2.pivot(columns="location", values="value").reset_index()

In [17]: no2_pivoted.head()
Out[17]:
location                  date.utc  BETR801  FR04014  London Westminster
0        2019-04-09 01:00:00+00:00     22.5     24.4                 NaN
1        2019-04-09 02:00:00+00:00     53.5     27.4                67.0
2        2019-04-09 03:00:00+00:00     54.5     34.2                67.0
3        2019-04-09 04:00:00+00:00     34.5     48.5                41.0
4        2019-04-09 05:00:00+00:00     46.5     59.5                41.0
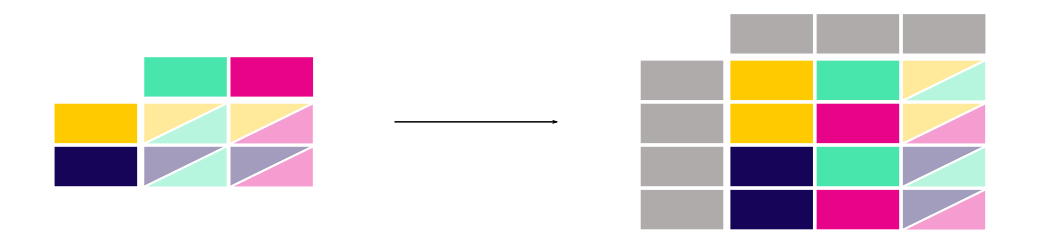
-
我想把所有空气质量 NO2 测量值汇集到一列,也就是长格式。
In [18]: no_2 = no2_pivoted.melt(id_vars="date.utc") In [19]: no_2.head() Out[19]: date.utc location value 0 2019-04-09 01:00:00+00:00 BETR801 22.5 1 2019-04-09 02:00:00+00:00 BETR801 53.5 2 2019-04-09 03:00:00+00:00 BETR801 54.5 3 2019-04-09 04:00:00+00:00 BETR801 34.5 4 2019-04-09 05:00:00+00:00 BETR801 46.5pandas.melt()方法作用于DataFrame,可把数据表从宽格式转成长格式。原来的列标题会成为新创建列中的变量名称。
上面的示例是 pandas.melt() 的简写用法。它把所有未在 id_vars 中指定的列合并为两列:一列存放原列标题,另一列存放对应的值。后者默认名为 value。
可以更详细地指定传给 pandas.melt() 的参数:
In [20]: no_2 = no2_pivoted.melt(
   ....:     id_vars="date.utc",
   ....:     value_vars=["BETR801", "FR04014", "London Westminster"],
   ....:     value_name="NO_2",
   ....:     var_name="id_location",
   ....: )
   ....:

In [21]: no_2.head()
Out[21]:
                   date.utc id_location  NO_2
0 2019-04-09 01:00:00+00:00     BETR801  22.5
1 2019-04-09 02:00:00+00:00     BETR801  53.5
2 2019-04-09 03:00:00+00:00     BETR801  54.5
3 2019-04-09 04:00:00+00:00     BETR801  34.5
4 2019-04-09 05:00:00+00:00     BETR801  46.5
新增参数的作用如下:
-
value_vars定义要合并的列。 -
value_name为数值列指定自定义名称,替代默认列名value。 -
var_name为存放原列标题的列指定自定义名称;未指定时,采用列索引名称或默认名称variable。
因此,value_name 和 var_name 只是两个新生成列的用户自定义名称。要合并的列由 id_vars 和 value_vars 决定。
用户指南
使用 pandas.melt() 将宽表转成长表的方法,详见用户指南的 使用 melt 重塑数据 一节。
记住
-
sort_values支持按一列或多列排序。 -
pivot只是重构数据布局,pivot_table则支持聚合。 -
pivot将长表转成宽表;反向操作melt将宽表转成长表。
用户指南
完整概览见用户指南中关于 数据重塑与透视变换 的页面。











暂无评论内容