


在 Scala Days 2011 上,Robert Hundt 发表了论文 Loop Recognition in C++/Java/Go/Scala。论文用 C++、Go、Java 和 Scala 分别实现一种循环识别算法,类似编译器流分析阶段可能使用的算法,并据此讨论这些语言的典型性能问题。论文里的 Go 程序运行较慢,恰好可以用来演示:怎样通过 Go 的性能分析工具定位瓶颈,把慢程序逐步改快。
这个案例通过识别并修正具体瓶颈,让 Go 循环识别程序快了一个数量级。原稿报告内存用量缩小为原来的约六分之一;2013 年修订时,因 GCC 中 libstdc++ 的优化,比较结果更新为约三点七分之一。
这里的环境、命令输出、采样细节和性能数字均属于 2011 年发表、2013 年修订的历史实验。分析方法仍有参考价值,但这些数值不能当作当前 Go、C++ 或任意硬件上的性能承诺。
实验环境与基线
Hundt 的论文没有说明所用 C++、Go、Java、Scala 工具的版本。原稿采用当时最新的 6g Go 编译器周快照,以及 Ubuntu Natty 附带的 g++。作者没有比较 Java 或 Scala,因为不擅长用这两种语言写高效程序,这样比较不够公平;C++ 是论文里最快的实现,因此本文与 C++ 的比较已经足够。
修订版改用当时 amd64 平台的最新 Go 开发快照,以及 2013 年 3 月发布的 g++ 4.8.0:
$ go version
go version devel +08d20469cc20 Tue Mar 26 08:27:18 2013 +0100 linux/amd64
$ g++ --version
g++ (GCC) 4.8.0
Copyright (C) 2013 Free Software Foundation, Inc.
...
$
实验机器搭载 3.4 GHz Core i7-2600 CPU、16 GB RAM,运行 Gentoo Linux 的 3.8.4-gentoo 内核。原文把下面的 performance 调速器设置描述为关闭 CPU 动态调频,以减少实验中的频率变化:
$ sudo bash
# for i in /sys/devices/system/cpu/cpu[0-7]
do
    echo performance > $i/cpufreq/scaling_governor
done
#
这是原实验对八个 CPU 逻辑编号及 Linux sysfs 路径的设置记录,需要相应权限且依赖系统支持;不能把这些路径或频率设置直接套用到其他机器。按当前 Linux CPUFreq 文档,通用 performance 调速器请求策略允许的最高频率,实际频率还受驱动与硬件条件影响,不能据此保证频率恒定。本文未执行该设置。
作者取出 Hundt 的 C++ 与 Go 基准程序,把每种实现分别合并为一个源文件,并按原文描述将输出删减到只保留一行。下方命令记录仍按官网历史输出保留。计时采用 Linux 的 time 工具,格式依次显示用户态时间、系统态时间、实际经过时间,以及最大内存用量:
$ cat xtime
#!/bin/sh
/usr/bin/time -f '%Uu %Ss %er %MkB %C' "$@"
$

$ make havlak1cc
g++ -O3 -o havlak1cc havlak1.cc
$ ./xtime ./havlak1cc
# of loops: 76002 (total 3800100)
loop-0, nest: 0, depth: 0
17.70u 0.05s 17.80r 715472kB ./havlak1cc
$

$ make havlak1
go build havlak1.go
$ ./xtime ./havlak1
# of loops: 76000 (including 1 artificial root node)
25.05u 0.11s 25.20r 1334032kB ./havlak1
$
这次实验中,C++ 程序运行 17.80 秒,使用约 700 MB 内存;Go 程序运行 25.20 秒,使用约 1302 MB 内存。这些测量值很难与原论文完全对应,不过目标是研究如何使用 go tool pprof,而不是复现论文结果。
采集 CPU 性能资料
开始优化之前,先启用性能分析。如果程序使用 Go testing 包的基准测试支持,就能使用标准的 -cpuprofile 和 -memprofile 标志;历史原文把当时的测试命令称为 gotest。对于这里的独立程序,需要导入 runtime/pprof,并增加几行代码:
var cpuprofile = flag.String("cpuprofile", "", "write cpu profile to file")

func main() {
    flag.Parse()
    if *cpuprofile != "" {
        f, err := os.Create(*cpuprofile)
        if err != nil {
            log.Fatal(err)
        }
        pprof.StartCPUProfile(f)
        defer pprof.StopCPUProfile()
    }
    ...
代码定义名为 cpuprofile 的标志,使用 flag 库解析命令行。当用户指定这个标志时,调用 undefined,把 CPU 资料写入文件。
退出前必须调用 undefined,把尚未写出的数据刷入文件。这里用 defer,确保 main 返回时完成这一步。原示例是带省略号的代码片段,并非可单独编译的完整程序;实际接入时还应处理性能分析启动失败及文件生命周期。
添加这段代码后,用新的 -cpuprofile 标志运行程序,再由 go tool pprof 解读性能资料:
$ make havlak1.prof
./havlak1 -cpuprofile=havlak1.prof
# of loops: 76000 (including 1 artificial root node)
$ go tool pprof havlak1 havlak1.prof
Welcome to pprof!  For help, type 'help'.
(pprof)
go tool pprof 是 Google 的 C++ pprof 分析器的一个变体。交互环境中最重要的命令之一是 topN,显示资料中排名前 N 的采样条目:
(pprof) top10
Total: 2525 samples
     298  11.8%  11.8%      345  13.7% runtime.mapaccess1_fast64
     268  10.6%  22.4%     2124  84.1% main.FindLoops
     251   9.9%  32.4%      451  17.9% scanblock
     178   7.0%  39.4%      351  13.9% hash_insert
     131   5.2%  44.6%      158   6.3% sweepspan
     119   4.7%  49.3%      350  13.9% main.DFS
      96   3.8%  53.1%       98   3.9% flushptrbuf
      95   3.8%  56.9%       95   3.8% runtime.aeshash64
      95   3.8%  60.6%      101   4.0% runtime.settype_flush
      88   3.5%  64.1%      988  39.1% runtime.mallocgc
在这一历史实现中,启用 CPU 分析后,程序大约每秒暂停 100 次,记录当前执行 goroutine 调用栈上的程序计数器。这里一共取得 2525 个样本,因此运行时间略超过 25 秒。
输出为每个出现在样本中的函数列出一行。前两列分别表示函数本身正在运行,而不是等待被调用函数返回的样本数,以及它占全部样本的比例。runtime.mapaccess1_fast64 正在运行的样本有 298 个,占 11.8%;top10 默认按这个样本数排序。
第三列是从列表开头累加到当前行的比例,前三行合计占 32.4%。第四、第五列则统计函数出现在调用栈中的样本数及比例,既包括函数自身运行,也包括它调用的函数运行。main.FindLoops 自身运行占 10.6%,但它或其调用的函数在 84.1% 的样本中正在运行。
要按后两列的累计开销排序,使用 -cum:
(pprof) top5 -cum
Total: 2525 samples
       0   0.0%   0.0%     2144  84.9% gosched0
       0   0.0%   0.0%     2144  84.9% main.main
       0   0.0%   0.0%     2144  84.9% runtime.main
       0   0.0%   0.0%     2124  84.1% main.FindHavlakLoops
     268  10.6%  10.6%     2124  84.1% main.FindLoops
(pprof) top5 -cum
理论上,main.FindLoops 和 main.main 的累计比例应为 100%。但当时每个栈样本最多包含 100 个栈帧;大约四分之一的样本里,递归函数 main.DFS 与 main.main 的距离超过 100 帧,因此完整调用轨迹被截断。这是案例所用实现的采样限制,不能据此假定所有当前版本都采用相同限制。
用调用图查看函数关系
调用栈样本包含的函数关系,比文本列表能展示的更多。web 命令把性能资料转成 SVG 调用图,并在浏览器中打开。还有 gv 命令,会生成 PostScript 并用 Ghostview 打开;这两种方式都需要安装 Graphviz。
(pprof) web
完整调用图的一小部分如下。原文中的 RawGit 链接属于历史链接,正文保留出处;下图使用 Go 官方页面保留的教学图片。
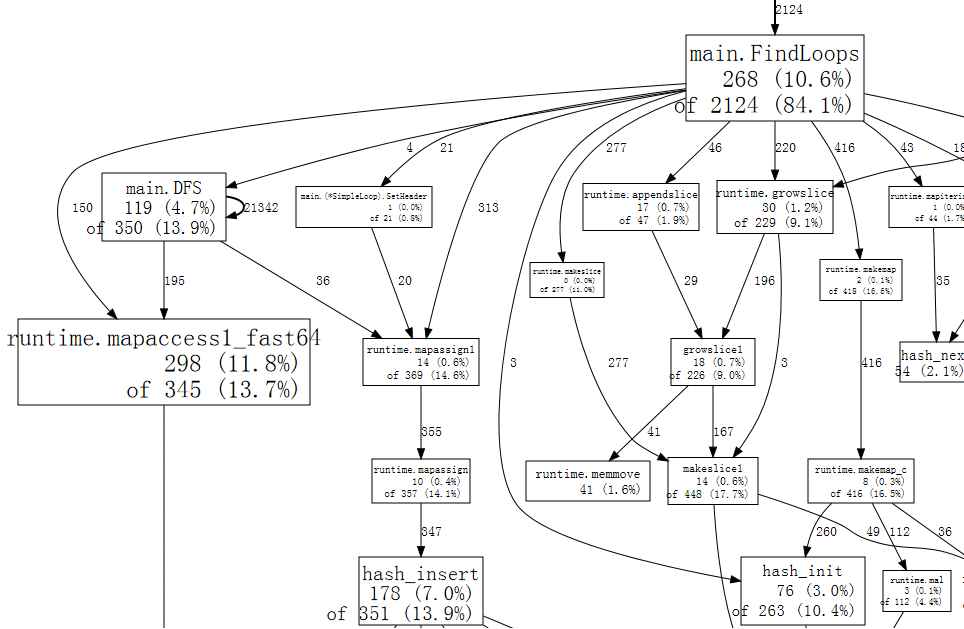
图中每个方框对应一个函数,方框大小与函数自身运行的样本数相关。从 X 指向 Y 的边表示 X 调用了 Y;边上的数字是该调用出现在样本中的次数。如果同一个调用在一个样本中多次出现,例如递归,每次出现都计入边的权重。这就解释了 main.DFS 指向自身的边为何标着 21342。
粗看即可发现,程序花了大量时间在哈希操作上,对应 Go 中的 map 使用。可以让 web 只使用包含指定函数的样本,例如 runtime.mapaccess1_fast64,减少图中的干扰:
(pprof) web mapaccess1
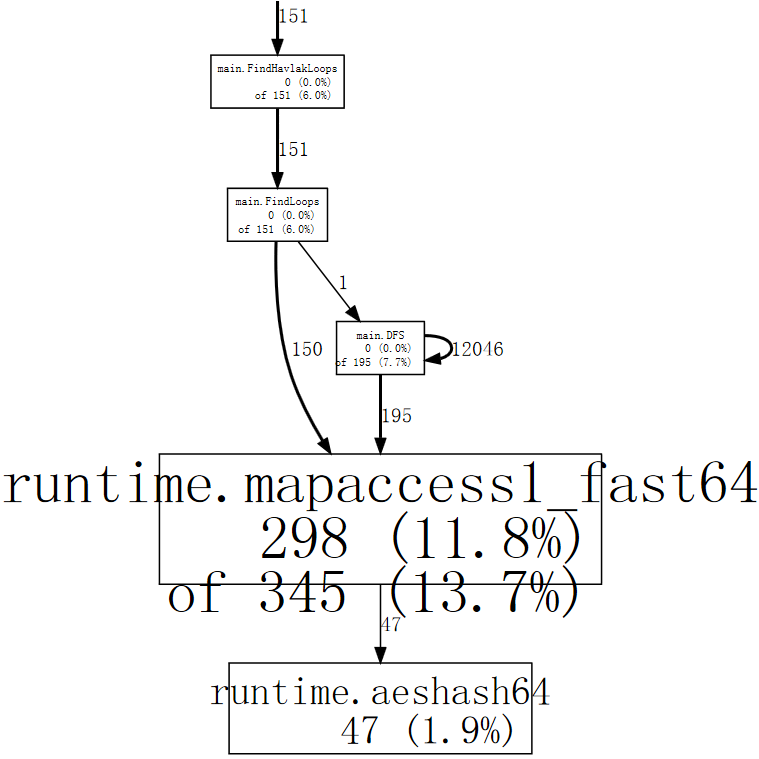
图中可以看出,runtime.mapaccess1_fast64 的调用来自 main.FindLoops 和 main.DFS。
定位 DFS 中的数据结构开销
有了整体方向后,进一步看具体函数。先看较短的 main.DFS:
(pprof) list DFS
Total: 2525 samples
ROUTINE ====================== main.DFS in /home/rsc/g/benchgraffiti/havlak/havlak1.go
   119    697 Total samples (flat / cumulative)
     3      3  240: func DFS(currentNode *BasicBlock, nodes []*UnionFindNode, number map[*BasicBlock]int, last []int, current int) int {
     1      1  241:     nodes[current].Init(currentNode, current)
     1     37  242:     number[currentNode] = current
     .      .  243:
     1      1  244:     lastid := current
    89     89  245:     for _, target := range currentNode.OutEdges {
     9    152  246:             if number[target] == unvisited {
     7    354  247:                     lastid = DFS(target, nodes, number, last, lastid+1)
     .      .  248:             }
     .      .  249:     }
     7     59  250:     last[number[currentNode]] = lastid
     1      1  251:     return lastid
(pprof)
list DFS 显示名称匹配正则表达式 DFS 的函数源代码。前三列依次表示:执行这一行时采到的样本数;执行这一行或其调用代码时采到的样本数;源文件行号。
相关命令 disasm 显示反汇编,而不是源代码。在样本足够时,可以帮助找到昂贵的机器指令。weblist 结合这两种显示方式:源代码列表中的行可以点击展开反汇编,该链接同样属于原文历史链接。
我们已经知道时间主要花在由哈希运行时函数实现的 map 查找上,因此重点看第二列。递归遍历的大量开销来自第 247 行的递归 DFS 调用,这符合预期。除递归以外,时间似乎集中在第 242、246、250 行对 number 这个 map 的访问。
对于这种查找,map 并不是最高效的选择。与编译器中的基本块类似,这些基本块结构都有唯一的序号。可以把 map[*BasicBlock]int 换成 []int,直接用基本块编号索引切片。数组或切片足以完成任务时,就没有必要使用 map。
把 number 从 map 改为切片,只需修改七行,实验中的运行时间明显下降:
$ make havlak2
go build havlak2.go
$ ./xtime ./havlak2
# of loops: 76000 (including 1 artificial root node)
16.55u 0.11s 16.69r 1321008kB ./havlak2
$
具体改动见 undefined 到 undefined 的差异。原文将这次改善描述为接近两倍;保留输出中的 25.20 秒与 16.69 秒,可以按实际记录判断效果,不能把描述当作精确倍数。
重新采样,确认 main.DFS 不再是主要热点:
$ make havlak2.prof
./havlak2 -cpuprofile=havlak2.prof
# of loops: 76000 (including 1 artificial root node)
$ go tool pprof havlak2 havlak2.prof
Welcome to pprof!  For help, type 'help'.
(pprof)
(pprof) top5
Total: 1652 samples
     197  11.9%  11.9%      382  23.1% scanblock
     189  11.4%  23.4%     1549  93.8% main.FindLoops
     130   7.9%  31.2%      152   9.2% sweepspan
     104   6.3%  37.5%      896  54.2% runtime.mallocgc
      98   5.9%  43.5%      100   6.1% flushptrbuf
(pprof)
main.DFS 已不在热点列表中,其余程序的运行时间也下降了。此时程序主要在分配内存和执行垃圾回收。runtime.mallocgc 同时承担分配及周期性垃圾回收,其累计开销占 54.2%。
用堆资料寻找内存分配
要弄清垃圾回收为何如此频繁,需要先知道谁在分配内存。可以给程序增加内存性能分析:提供 -memprofile 时,在一次循环识别完成后写出堆资料并退出。
var memprofile = flag.String("memprofile", "", "write memory profile to this file")
...

    FindHavlakLoops(cfgraph, lsgraph)
    if *memprofile != "" {
        f, err := os.Create(*memprofile)
        if err != nil {
            log.Fatal(err)
        }
        pprof.WriteHeapProfile(f)
        f.Close()
        return
    }
用 -memprofile 运行:
$ make havlak3.mprof
go build havlak3.go
./havlak3 -memprofile=havlak3.mprof
$
相关代码见 undefined 之后的改动。仍然用 go tool pprof 分析,但这次样本表示内存分配,不是时钟采样:
$ go tool pprof havlak3 havlak3.mprof
Adjusting heap profiles for 1-in-524288 sampling rate
Welcome to pprof!  For help, type 'help'.
(pprof) top5
Total: 82.4 MB
    56.3  68.4%  68.4%     56.3  68.4% main.FindLoops
    17.6  21.3%  89.7%     17.6  21.3% main.(*CFG).CreateNode
     8.0   9.7%  99.4%     25.6  31.0% main.NewBasicBlockEdge
     0.5   0.6% 100.0%      0.5   0.6% itab
     0.0   0.0% 100.0%      0.5   0.6% fmt.init
(pprof)
pprof 报告,在约 82.4 MB 的在用内存中,FindLoops 占约 56.3 MB,CreateNode 另占约 17.6 MB。为减少分析本身的开销,历史内存分析器按约每半兆字节分配记录一个样本,也就是输出中的 1-in-524288 sampling rate,所以这些数值是对实际用量的估计。
列出相关函数即可找到分配位置:
(pprof) list FindLoops
Total: 82.4 MB
ROUTINE ====================== main.FindLoops in /home/rsc/g/benchgraffiti/havlak/havlak3.go
  56.3   56.3 Total MB (flat / cumulative)
...
   1.9    1.9  268:     nonBackPreds := make([]map[int]bool, size)
   5.8    5.8  269:     backPreds := make([][]int, size)
     .      .  270:
   1.9    1.9  271:     number := make([]int, size)
   1.9    1.9  272:     header := make([]int, size, size)
   1.9    1.9  273:     types := make([]int, size, size)
   1.9    1.9  274:     last := make([]int, size, size)
   1.9    1.9  275:     nodes := make([]*UnionFindNode, size, size)
     .      .  276:
     .      .  277:     for i := 0; i < size; i++ {
   9.5    9.5  278:             nodes[i] = new(UnionFindNode)
     .      .  279:     }
...
     .      .  286:     for i, bb := range cfgraph.Blocks {
     .      .  287:             number[bb.Name] = unvisited
  29.5   29.5  288:             nonBackPreds[i] = make(map[int]bool)
     .      .  289:     }
...
瓶颈似乎又是同一个问题:本可使用更简单的数据结构,却使用了 map。FindLoops 分配的 map 占约 29.5 MB。
还可以用 --inuse_objects,把报告单位从内存大小改成对象数量:
$ go tool pprof --inuse_objects havlak3 havlak3.mprof
Adjusting heap profiles for 1-in-524288 sampling rate
Welcome to pprof!  For help, type 'help'.
(pprof) list FindLoops
Total: 1763108 objects
ROUTINE ====================== main.FindLoops in /home/rsc/g/benchgraffiti/havlak/havlak3.go
720903 720903 Total objects (flat / cumulative)
...
     .      .  277:     for i := 0; i < size; i++ {
311296 311296  278:             nodes[i] = new(UnionFindNode)
     .      .  279:     }
     .      .  280:
     .      .  281:     // Step a:
     .      .  282:     //   - initialize all nodes as unvisited.
     .      .  283:     //   - depth-first traversal and numbering.
     .      .  284:     //   - unreached BB's are marked as dead.
     .      .  285:     //
     .      .  286:     for i, bb := range cfgraph.Blocks {
     .      .  287:             number[bb.Name] = unvisited
409600 409600  288:             nonBackPreds[i] = make(map[int]bool)
     .      .  289:     }
...
(pprof)
原文据此估计,约 200,000 个 map 占用 29.5 MB,初始分配每个 map 大约需要 150 字节。代码列表中的对象数量本身是抽样估计,不能当作逐个对象的精确计数。存放键值对时,这样的开销尚可理解;如果这里只是用 map 模拟简单集合,就不合适。
可以改用切片列出元素。除了一个位置之外,算法在其他使用集合的地方本来就不可能插入重复元素。剩下那个位置,则可以写一个简单的 append 变体:
func appendUnique(a []int, x int) []int {
    for _, y := range a {
        if x == y {
            return a
        }
    }
    return append(a, x)
}
除这个函数外,把程序里的 map 改成切片只需再改几行:
$ make havlak4
go build havlak4.go
$ ./xtime ./havlak4
# of loops: 76000 (including 1 artificial root node)
11.84u 0.08s 11.94r 810416kB ./havlak4
$
具体改动见 undefined 之后的差异。现在运行速度已达到初始程序的 2.11 倍。再看 CPU 资料:
$ make havlak4.prof
./havlak4 -cpuprofile=havlak4.prof
# of loops: 76000 (including 1 artificial root node)
$ go tool pprof havlak4 havlak4.prof
Welcome to pprof!  For help, type 'help'.
(pprof) top10
Total: 1173 samples
     205  17.5%  17.5%     1083  92.3% main.FindLoops
     138  11.8%  29.2%      215  18.3% scanblock
      88   7.5%  36.7%       96   8.2% sweepspan
      76   6.5%  43.2%      597  50.9% runtime.mallocgc
      75   6.4%  49.6%       78   6.6% runtime.settype_flush
      74   6.3%  55.9%       75   6.4% flushptrbuf
      64   5.5%  61.4%       64   5.5% runtime.memmove
      63   5.4%  66.8%      524  44.7% runtime.growslice
      51   4.3%  71.1%       51   4.3% main.DFS
      50   4.3%  75.4%      146  12.4% runtime.MCache_Alloc
(pprof)
这一次,内存分配及由此触发的垃圾回收,也就是 runtime.mallocgc,仍占运行时间的 50.9%。
过滤调用图,找到重复分配
另一种查法,是专看哪些分配使程序花费大量时间在 mallocgc 上:
(pprof) web mallocgc

图里有许多样本数很少的节点,遮住了主要路径。可以让 pprof 忽略占比不足 10% 的节点:
$ go tool pprof --nodefraction=0.1 havlak4 havlak4.prof
Welcome to pprof!  For help, type 'help'.
(pprof) web mallocgc
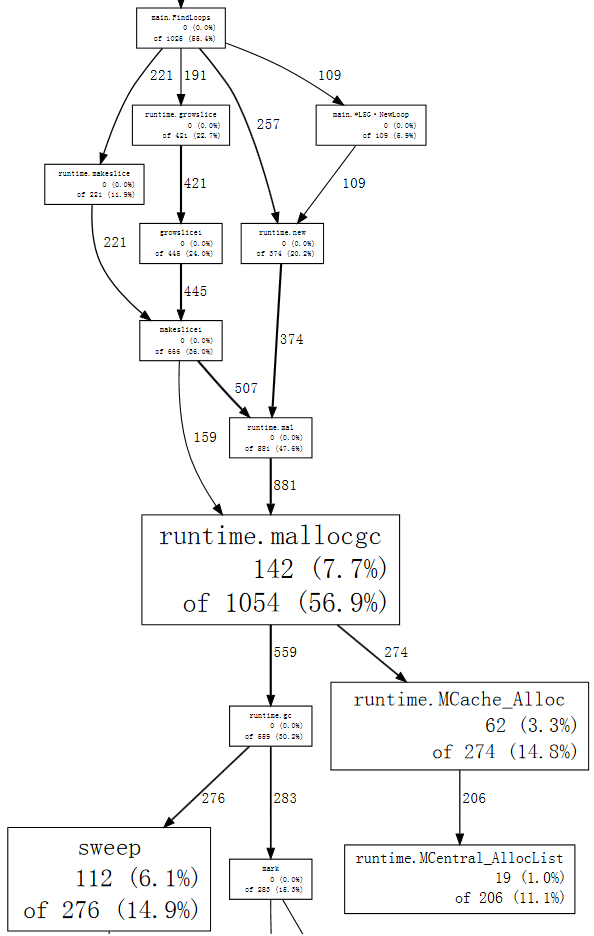
现在沿着粗箭头就容易看出,大部分垃圾回收由 FindLoops 触发。列出该函数,可以看到不少开销集中在开头:
(pprof) list FindLoops
...
     .      .  270: func FindLoops(cfgraph *CFG, lsgraph *LSG) {
     .      .  271:     if cfgraph.Start == nil {
     .      .  272:             return
     .      .  273:     }
     .      .  274:
     .      .  275:     size := cfgraph.NumNodes()
     .      .  276:
     .    145  277:     nonBackPreds := make([][]int, size)
     .      9  278:     backPreds := make([][]int, size)
     .      .  279:
     .      1  280:     number := make([]int, size)
     .     17  281:     header := make([]int, size, size)
     .      .  282:     types := make([]int, size, size)
     .      .  283:     last := make([]int, size, size)
     .      .  284:     nodes := make([]*UnionFindNode, size, size)
     .      .  285:
     .      .  286:     for i := 0; i < size; i++ {
     2     79  287:             nodes[i] = new(UnionFindNode)
     .      .  288:     }
...
(pprof)
每次调用 FindLoops 都会分配一批不小的辅助结构。基准程序调用它 50 次,这些结构累积成大量垃圾,也就带来大量垃圾回收工作。语言具备自动垃圾回收,并不意味着可以忽略内存分配问题。
一个简单方案是增加缓存,让后一次调用尽可能复用前一次的存储。Hundt 在论文里提到,Java 程序需要这样的修改才有合理性能,却没有把同一修改用于其他垃圾回收语言的实现。
先增加一个全局缓存结构:
var cache struct {
    size int
    nonBackPreds [][]int
    backPreds [][]int
    number []int
    header []int
    types []int
    last []int
    nodes []*UnionFindNode
}
然后让 FindLoops 从缓存取得存储,替代每次重新分配:
if cache.size < size {
    cache.size = size
    cache.nonBackPreds = make([][]int, size)
    cache.backPreds = make([][]int, size)
    cache.number = make([]int, size)
    cache.header = make([]int, size)
    cache.types = make([]int, size)
    cache.last = make([]int, size)
    cache.nodes = make([]*UnionFindNode, size)
    for i := range cache.nodes {
        cache.nodes[i] = new(UnionFindNode)
    }
}

nonBackPreds := cache.nonBackPreds[:size]
for i := range nonBackPreds {
    nonBackPreds[i] = nonBackPreds[i][:0]
}
backPreds := cache.backPreds[:size]
for i := range nonBackPreds {
    backPreds[i] = backPreds[i][:0]
}
number := cache.number[:size]
header := cache.header[:size]
types := cache.types[:size]
last := cache.last[:size]
nodes := cache.nodes[:size]
这个全局变量从工程角度并不合适:并发调用 FindLoops 会变得不安全。这里暂时采用最小改动,只是为了理解哪些因素影响性能,也与原 Java 实现保持对应。最终版本会用独立的 LoopFinder 实例管理这些存储,恢复实例之间的并发使用能力;不要直接把这个中间版本作为可并发共享的实现。
$ make havlak5
go build havlak5.go
$ ./xtime ./havlak5
# of loops: 76000 (including 1 artificial root node)
8.03u 0.06s 8.11r 770352kB ./havlak5
$
改动见 undefined 之后的差异。
继续复用存储,并进行公平比较
程序还能进一步整理并加速,但不需要引入新的分析技巧。内层循环使用的工作列表,可以跨迭代、跨 FindLoops 调用复用,并与该阶段创建的独立“节点池”合并。同样,每次迭代也可以复用循环图的存储,避免重新分配。
最终版本除这些性能改动外,还改用更符合 Go 习惯的数据结构与方法。风格修改对运行时间影响很小,算法和约束没有改变。这个版本运行 2.29 秒,使用约 351 MB 内存:
$ make havlak6
go build havlak6.go
$ ./xtime ./havlak6
# of loops: 76000 (including 1 artificial root node)
2.26u 0.02s 2.29r 360224kB ./havlak6
$
它约为起始程序的 11 倍速度。即使禁用生成的循环图复用,只缓存循环识别过程中的辅助结构,仍比原程序快 6.7 倍,内存用量约为原来的三分之二,也就是原文所说的“少 1.5 倍”:
$ ./xtime ./havlak6 -reuseloopgraph=false
# of loops: 76000 (including 1 artificial root node)
3.69u 0.06s 3.76r 797120kB ./havlak6 -reuseloopgraph=false
$
此时再拿它与最初的 C++ 程序比较,就不公平了:后者也使用了不合适的数据结构,例如应使用向量时用了集合。为进行合理校验,作者把最终 Go 程序改写为等效 C++ 代码,其运行时间与 Go 版本相近:
$ make havlak6cc
g++ -O3 -o havlak6cc havlak6.cc
$ ./xtime ./havlak6cc
# of loops: 76000 (including 1 artificial root node)
1.99u 0.19s 2.19r 387936kB ./havlak6cc
Go 程序运行速度接近这个 C++ 程序。C++ 使用自动删除和分配,而不是显式缓存,因此代码稍短、稍易编写,但差别并不显著:
$ wc havlak6.cc; wc havlak6.go
 401 1220 9040 havlak6.cc
 461 1441 9467 havlak6.go
$
基准测试的价值取决于它实际测量的程序。这个案例用 go tool pprof 分析了一个低效 Go 程序,让速度提高约一个数量级,内存用量缩小为约三点七分之一。随后与同样优化过的 C++ 实现比较,说明在这个案例中,注意内层循环产生的垃圾量,Go 可以具有竞争力;不能由此推出所有程序或语言的普遍排名。
文中使用的源码、Linux x86-64 二进制文件和性能资料,都保存在 GitHub 的 benchgraffiti 项目中。
基准测试与 HTTP 分析入口
如前所述,undefined已经包含这些性能分析标志,编写基准函数即可使用。
Go 也提供获取性能资料的标准 HTTP 接口。在 HTTP 服务中添加:
import _ "net/http/pprof"
这会注册 /debug/pprof/ 下的一组处理器。导入本身不会启动 HTTP 监听;需要服务使用相应的处理器,并实际监听供分析使用的地址。
随后给 go tool pprof 传一个参数,即服务的性能资料 URL,它会下载并分析实时资料:
go tool pprof http://localhost:6060/debug/pprof/profile   # 30-second CPU profile
go tool pprof http://localhost:6060/debug/pprof/heap      # heap profile
go tool pprof http://localhost:6060/debug/pprof/block     # goroutine blocking profile
例子使用 localhost:6060,要以实际监听地址为准。性能资料可能包含程序内部信息,分析入口应限制在合适的访问范围。原文末尾预告将在后续文章中解释 goroutine 阻塞资料;这里保留其功能入口,不把当年的预告写成未来发布承诺。
来源与许可
原文:Profiling Go Programs,Russ Cox,2011 年 7 月撰写;Shenghou Ma 于 2013 年 5 月修订。页面所列发表日期为 2011 年 6 月 24 日。中文稿完整保留案例、代码、历史输出和四幅官方教学图片链接,并增加明确标出的版本、运行与边界说明。
相关网站材料的 BSD 3-Clause 许可全文如下,保留版权、条件和免责声明:
Copyright 2009 The Go Authors.
Redistribution and use in source and binary forms, with or without modification, are permitted provided that the following conditions are met:
* Redistributions of source code must retain the above copyright notice, this list of conditions and the following disclaimer. * Redistributions in binary form must reproduce the above copyright notice, this list of conditions and the following disclaimer in the documentation and/or other materials provided with the distribution. * Neither the name of Google LLC nor the names of its contributors may be used to endorse or promote products derived from this software without specific prior written permission.
THIS SOFTWARE IS PROVIDED BY THE COPYRIGHT HOLDERS AND CONTRIBUTORS “AS IS” AND ANY EXPRESS OR IMPLIED WARRANTIES, INCLUDING, BUT NOT LIMITED TO, THE IMPLIED WARRANTIES OF MERCHANTABILITY AND FITNESS FOR A PARTICULAR PURPOSE ARE DISCLAIMED. IN NO EVENT SHALL THE COPYRIGHT OWNER OR CONTRIBUTORS BE LIABLE FOR ANY DIRECT, INDIRECT, INCIDENTAL, SPECIAL, EXEMPLARY, OR CONSEQUENTIAL DAMAGES (INCLUDING, BUT NOT LIMITED TO, PROCUREMENT OF SUBSTITUTE GOODS OR SERVICES; LOSS OF USE, DATA, OR PROFITS; OR BUSINESS INTERRUPTION) HOWEVER CAUSED AND ON ANY THEORY OF LIABILITY, WHETHER IN CONTRACT, STRICT LIABILITY, OR TORT (INCLUDING NEGLIGENCE OR OTHERWISE) ARISING IN ANY WAY OUT OF THE USE OF THIS SOFTWARE, EVEN IF ADVISED OF THE POSSIBILITY OF SUCH DAMAGE.











暂无评论内容