


隐私控制系统负责执行保留期限、访问、允许用途、下游共享或匿名化策略,必须可靠理解数据,才能发挥作用。控制生效前,要准确知道自己面对什么。这可能很复杂:一个简单名为 age 的字段,在某个上下文中可能描述人的年龄,要求严格保护;在另一个上下文中,却可能是基础设施流水线里的缓存存活时间(TTL)数值。
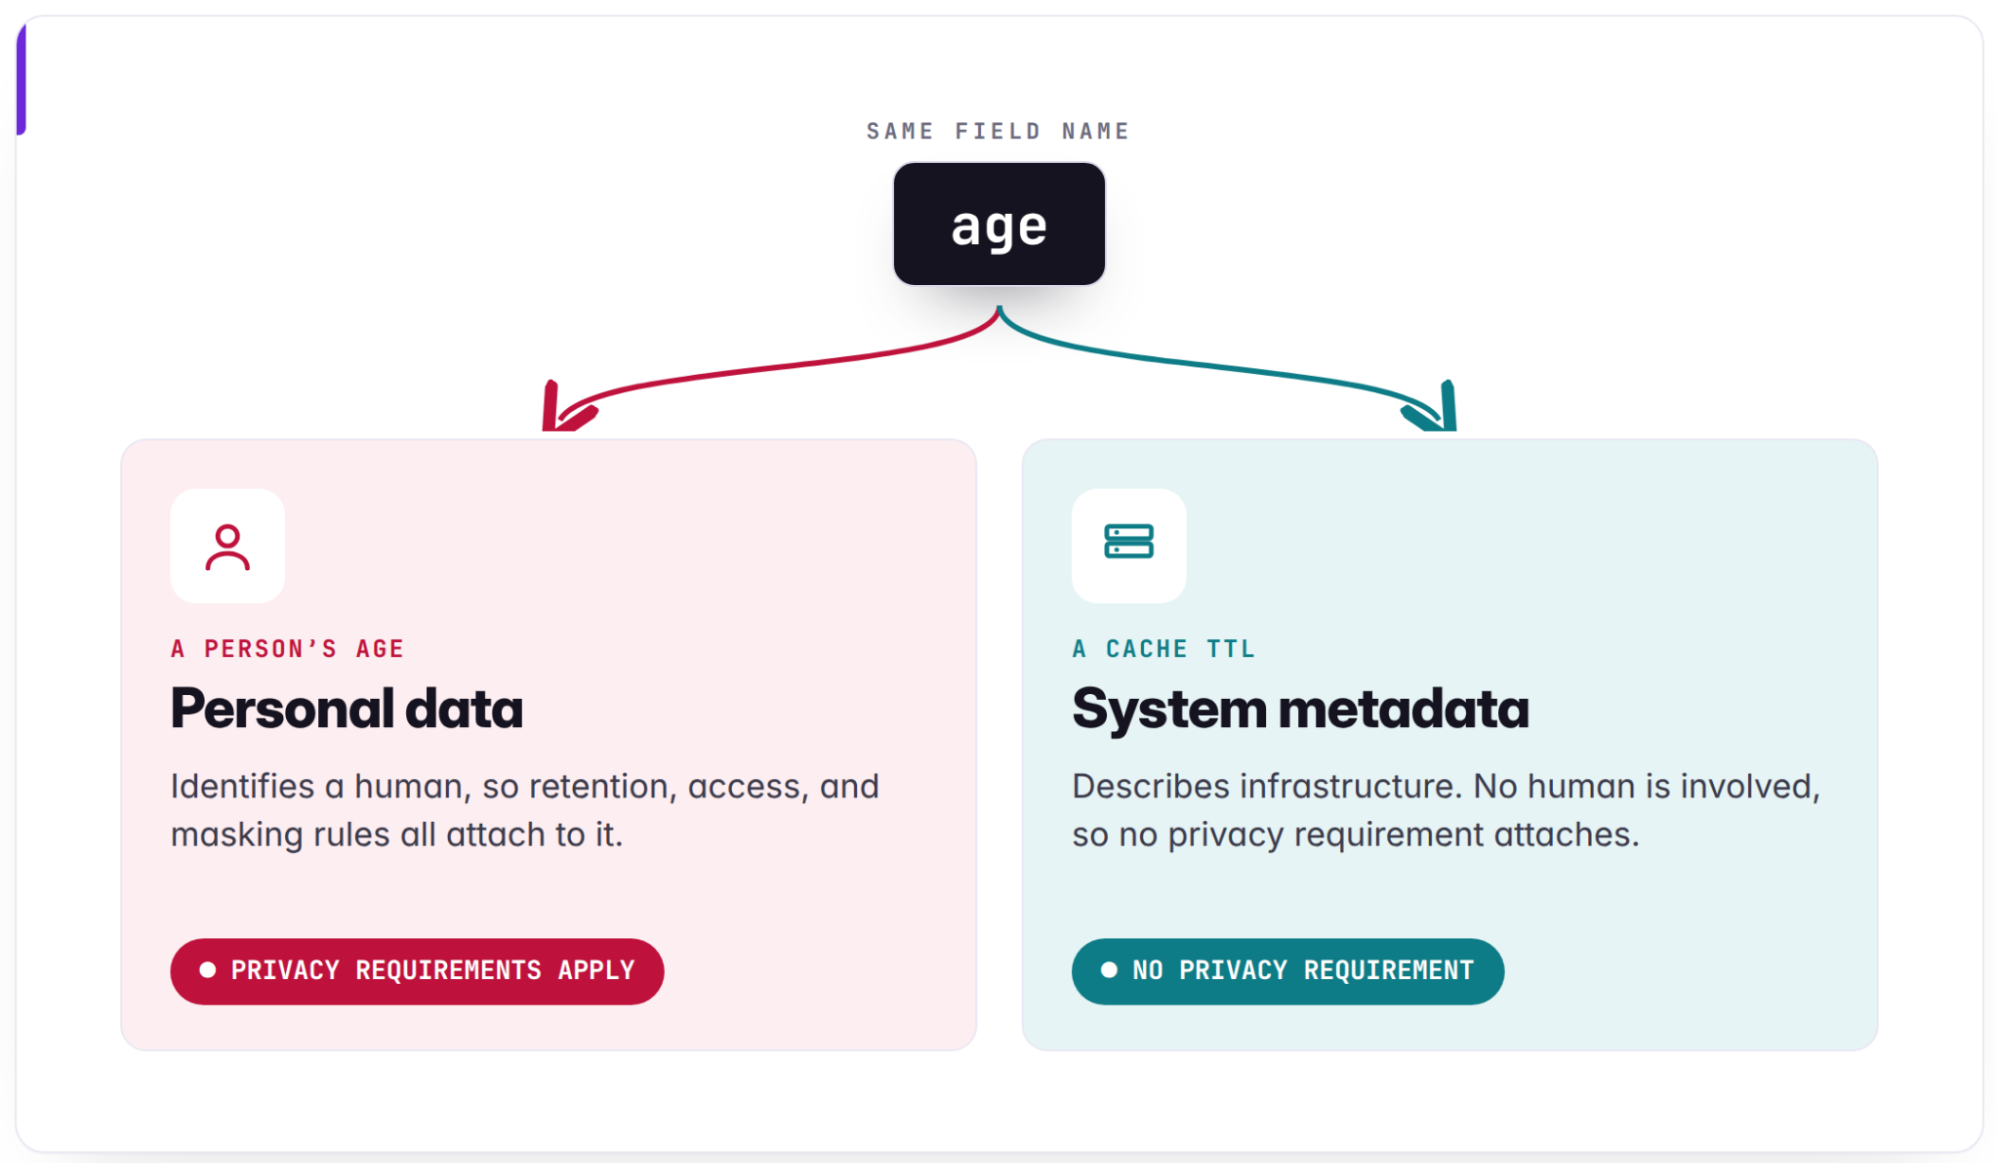
这就是隐私感知基础设施(PAI)每天面对的问题:输入带有噪声和概率性,输出却要足够精确,才能驱动策略执行。
AI 原生产品使问题更难。它们带来新的数据模态、更快的迭代、派生特征、嵌入、多模态输入,以及不断变化的策略解释。人工审查对判断和问责仍很重要,却跟不上变化的规模与速度。
在 Meta,我们用混合模式大规模进行资产分类:
- 先构建丰富上下文,再让模型推理。
- 用 LLM 处理歧义、冷启动和新情况。
- 把人工审阅标签与模型生成建议分开。
- 把稳定行为蒸馏成确定性、版本化规则,服务于常规执行。
最终目标不是“到处都是 LLM”,而是让系统能从模糊信号学习,同时把生产执行逐步转为低延迟、可重放、更易审计的逻辑。
常见情况下,生产决策由确定性规则完成。我们有意限制 LLM 的使用:解释新颖或含糊资产,再把学到的模式蒸馏成人工审查、版本化的确定性规则,随时间持续缩小 LLM 在生产中的角色。人仍留在最关键的位置:裁定审阅后的参考标签,并审查批准可能改变保护执行方式的规则晋升。
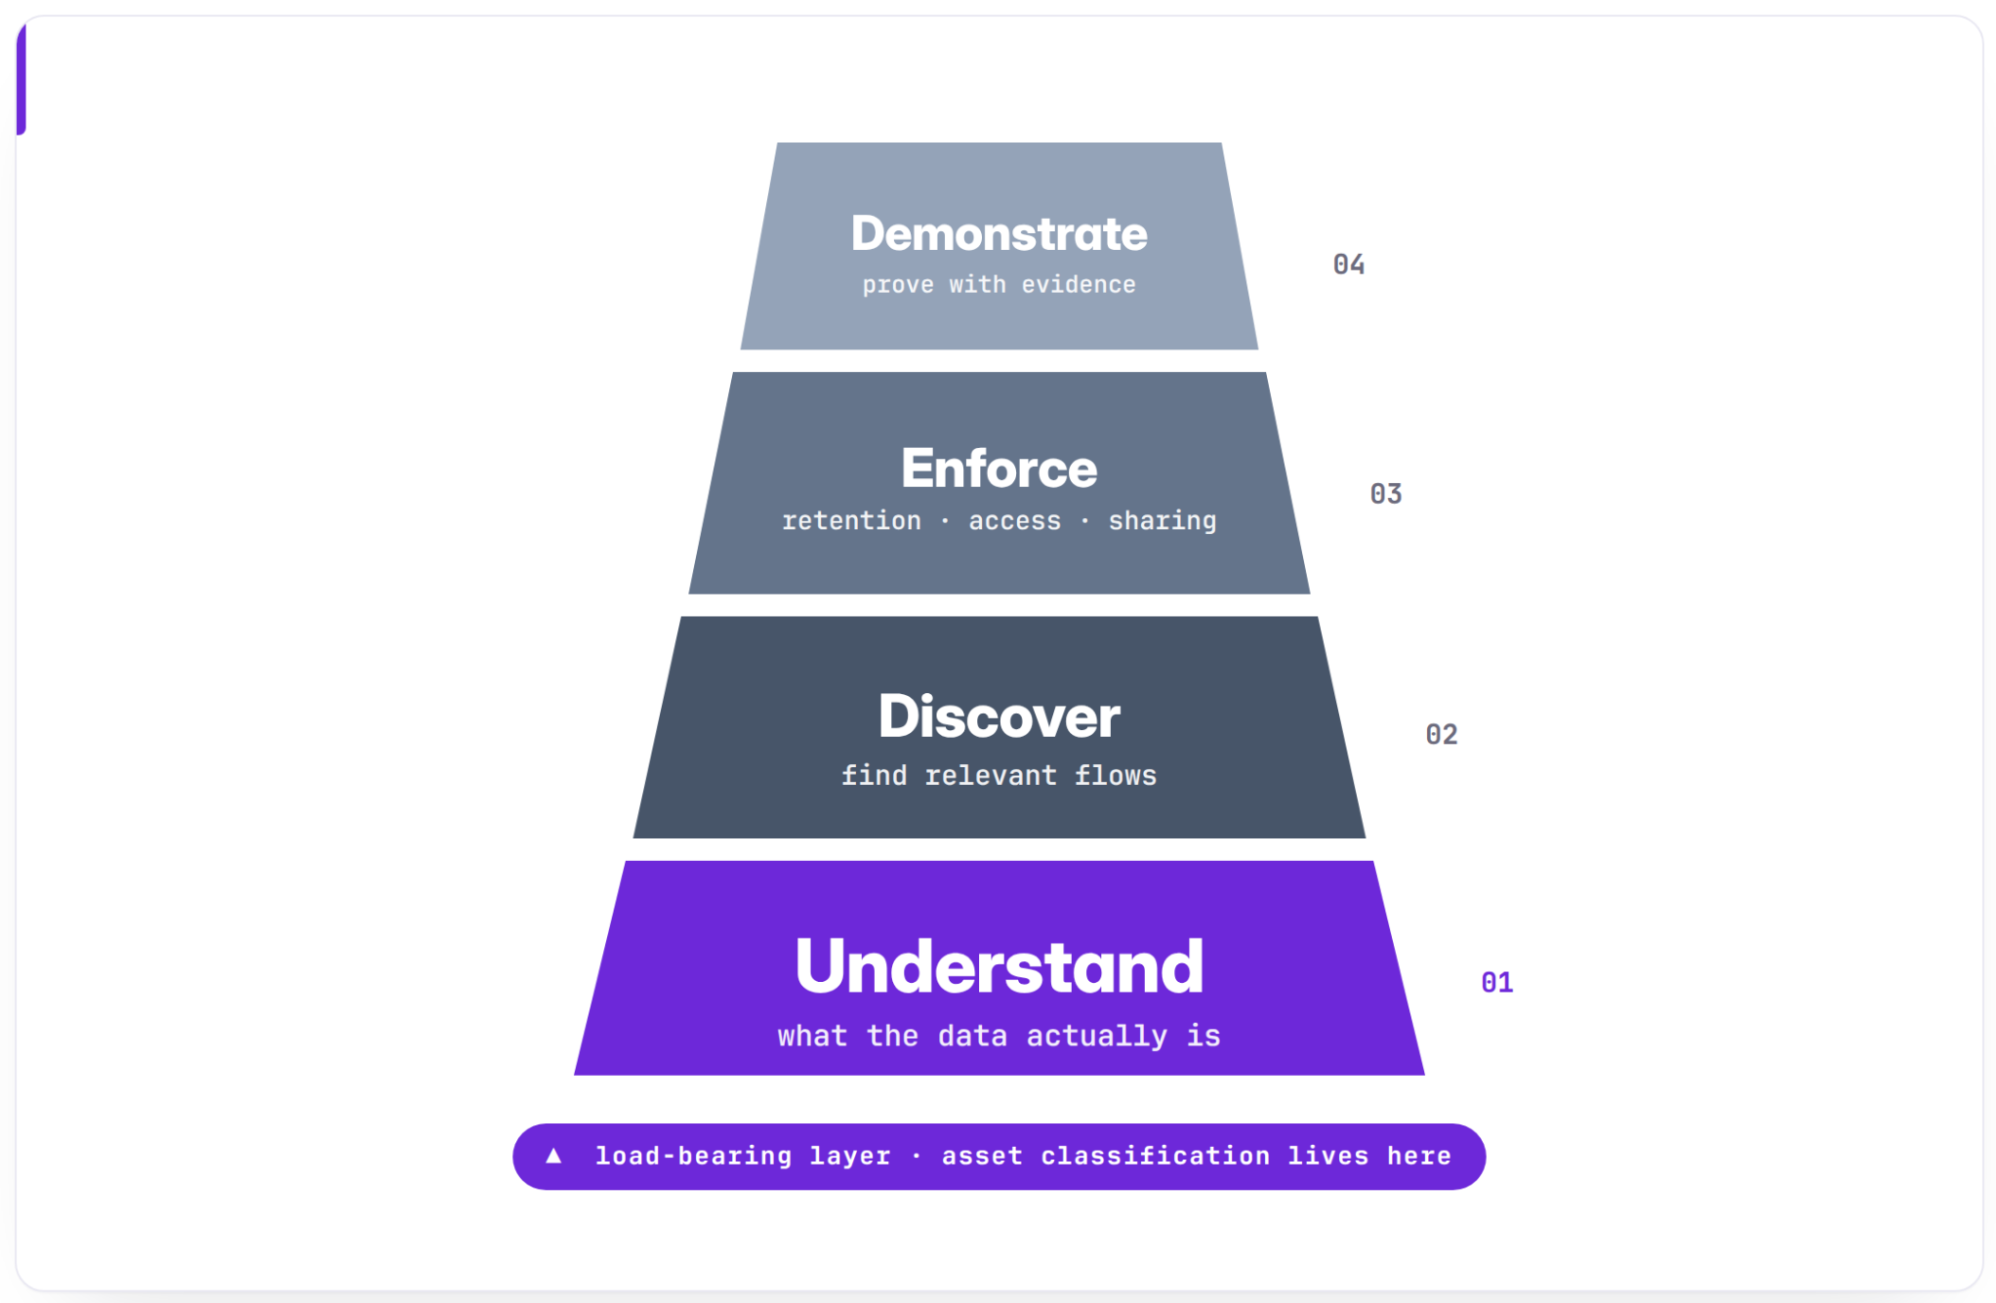
PAI 处理四类运行需求:
- 理解有哪些数据,以及如何治理。
- 发现与策略问题相关的数据流。
- 执行保留、访问、用途和共享约束。
- 通过可验证证据证明合规。
资产分类位于“理解”层,为所有下游需求提供基础。
为什么资产分类重要
资产分类是许多隐私控制的基础。系统执行保留、访问、允许用途、下游共享或匿名化策略之前,需要可靠地了解资产是什么,以及应如何治理。
资产不局限于表或列,还可能是载荷中的嵌套字段、日志键、事件参数、API 字段、机器学习(ML)特征、嵌入,或中间流水线生成的派生数据集。这个范围很重要,因为 AI 原生系统会在多种表示之间转换数据。单一源信号可能穿过流水线,成为特征,进入模型训练工作流,或与其他派生信号连接。分类要跟随数据的含义,而非只看形状。
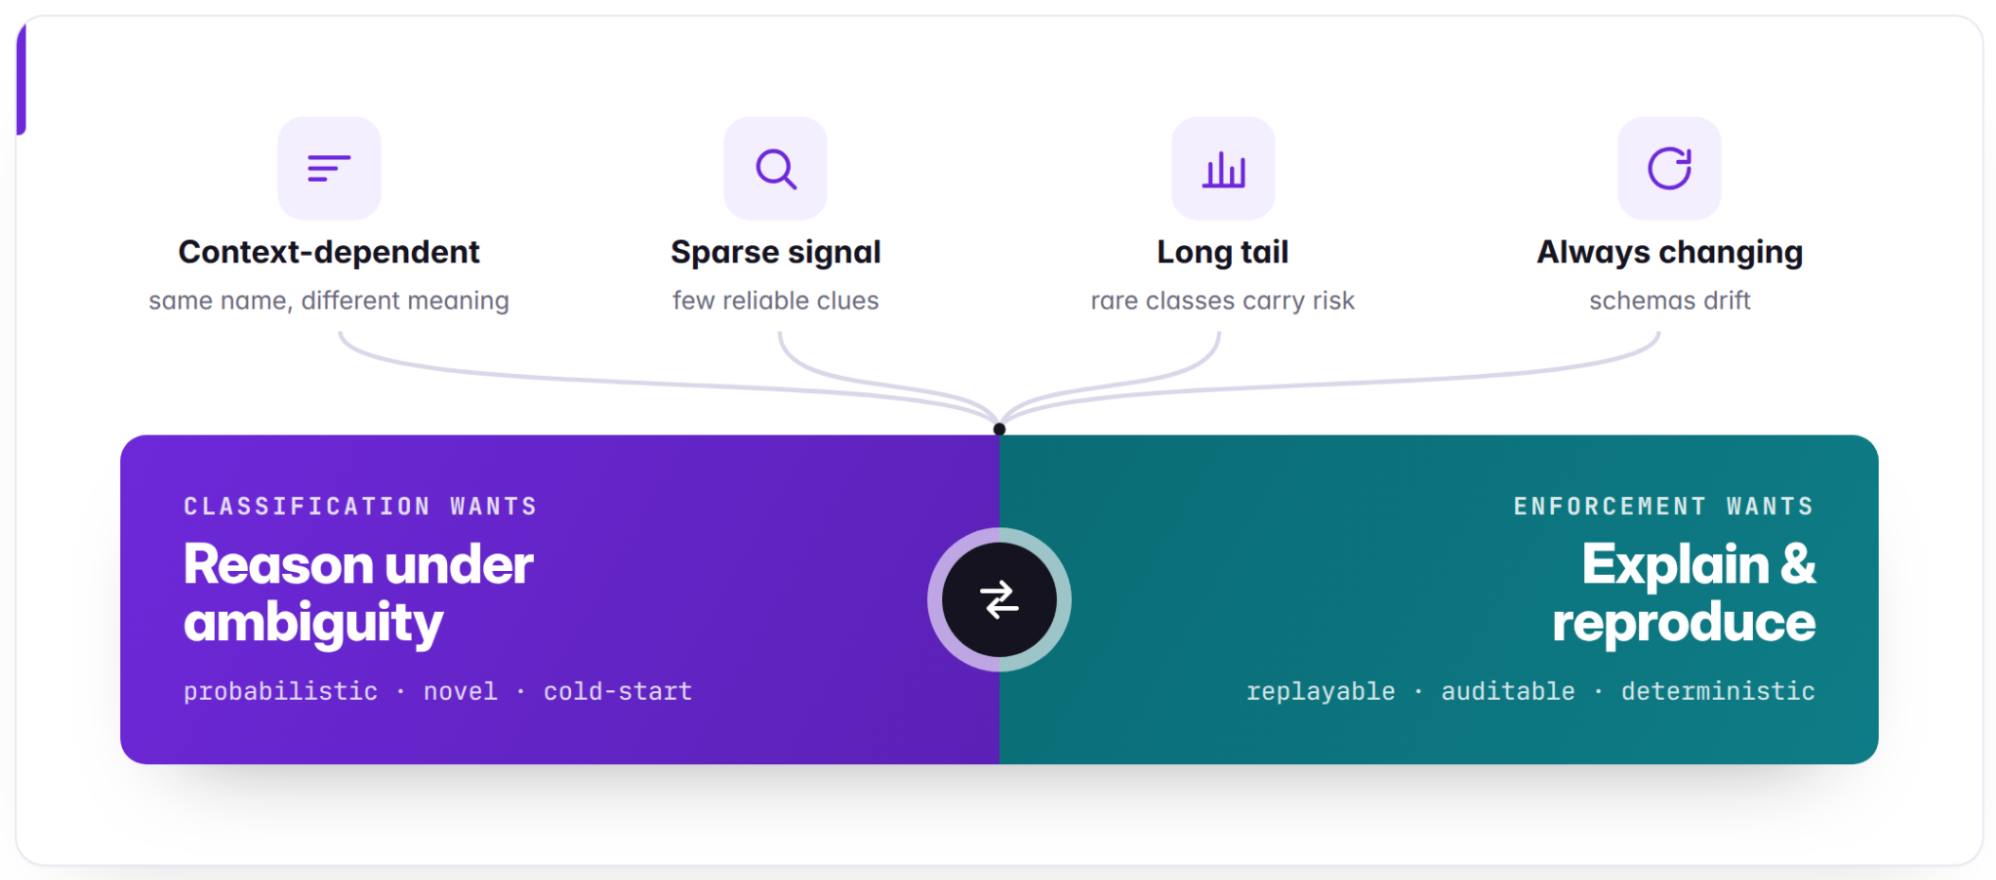
这里有四个反复出现的挑战。
第一,信号嘈杂且弱。每个资产会获取数十个上下文字段,模型每次都要重新发现什么重要。大量令牌稀释注意力,决策边界埋在无关或误导字段中。缓存流水线里名为 age 的字段就是具体例子:没有代码解析和血缘分析,分类器会对整条流水线施加错误限制。
第二,相关上下文分散。代码、血缘、所有权、语义注解、文档与使用模式,通常位于不同系统。好的分类器必须在决策前把它们组装起来。
第三,要求持续演进。产品团队行动迅速,新能力出现时,策略解释也可能改变。静态规则或周期性人工审查,会在两次审查之间留下空白。
第四,分类只有进入执行才有用。假阳性会在下游触发不必要限制,假阴性则会留下保护缺口。分类器位于执行流水线前端附近,因此它的错误特征会影响所有依赖它的系统。
核心张力由此产生:分类需要在歧义下推理,执行却需要能够日后解释并复现的决策。
这种模式
我们的做法建立在构建和运行系统过程中形成的三个原则之上。
第一,上下文比提示更重要。多数分类失败不是因为指令不够好,而是证据薄弱或缺失。模型面对原始、嘈杂字段时,花数小时优化提示,只带来小幅改善。把上下文整理成证据简报,包含支持信号、反对信号、来源,并屏蔽循环字段,准确率提升更大。实际经验很简单:优化提问方式之前,先关注模型收到什么。
第二,把评估与优化解耦。LLM 输出是有用建议,却不能成为自己的真值。评估循环必须独立于分类器,采用不同模型、不同提示策略、冻结参考集、人工审阅标签,以及回归门槛。若评估与优化共用循环,系统可能测量的是漂移,而非进步。
第三,把稳定行为蒸馏成确定性规则。LLM 适合处理歧义、冷启动与新模式,却不适合作为大规模执行的默认机制。发现稳定且经过验证的模式后,应转换成不用 LLM 即可运行、版本化、可审计的规则。随着时间推移,分类器应逐渐缩小自己的 LLM 使用范围,把模型推理留给新颖或含糊资产,让常规执行确定、低延迟、可重放。
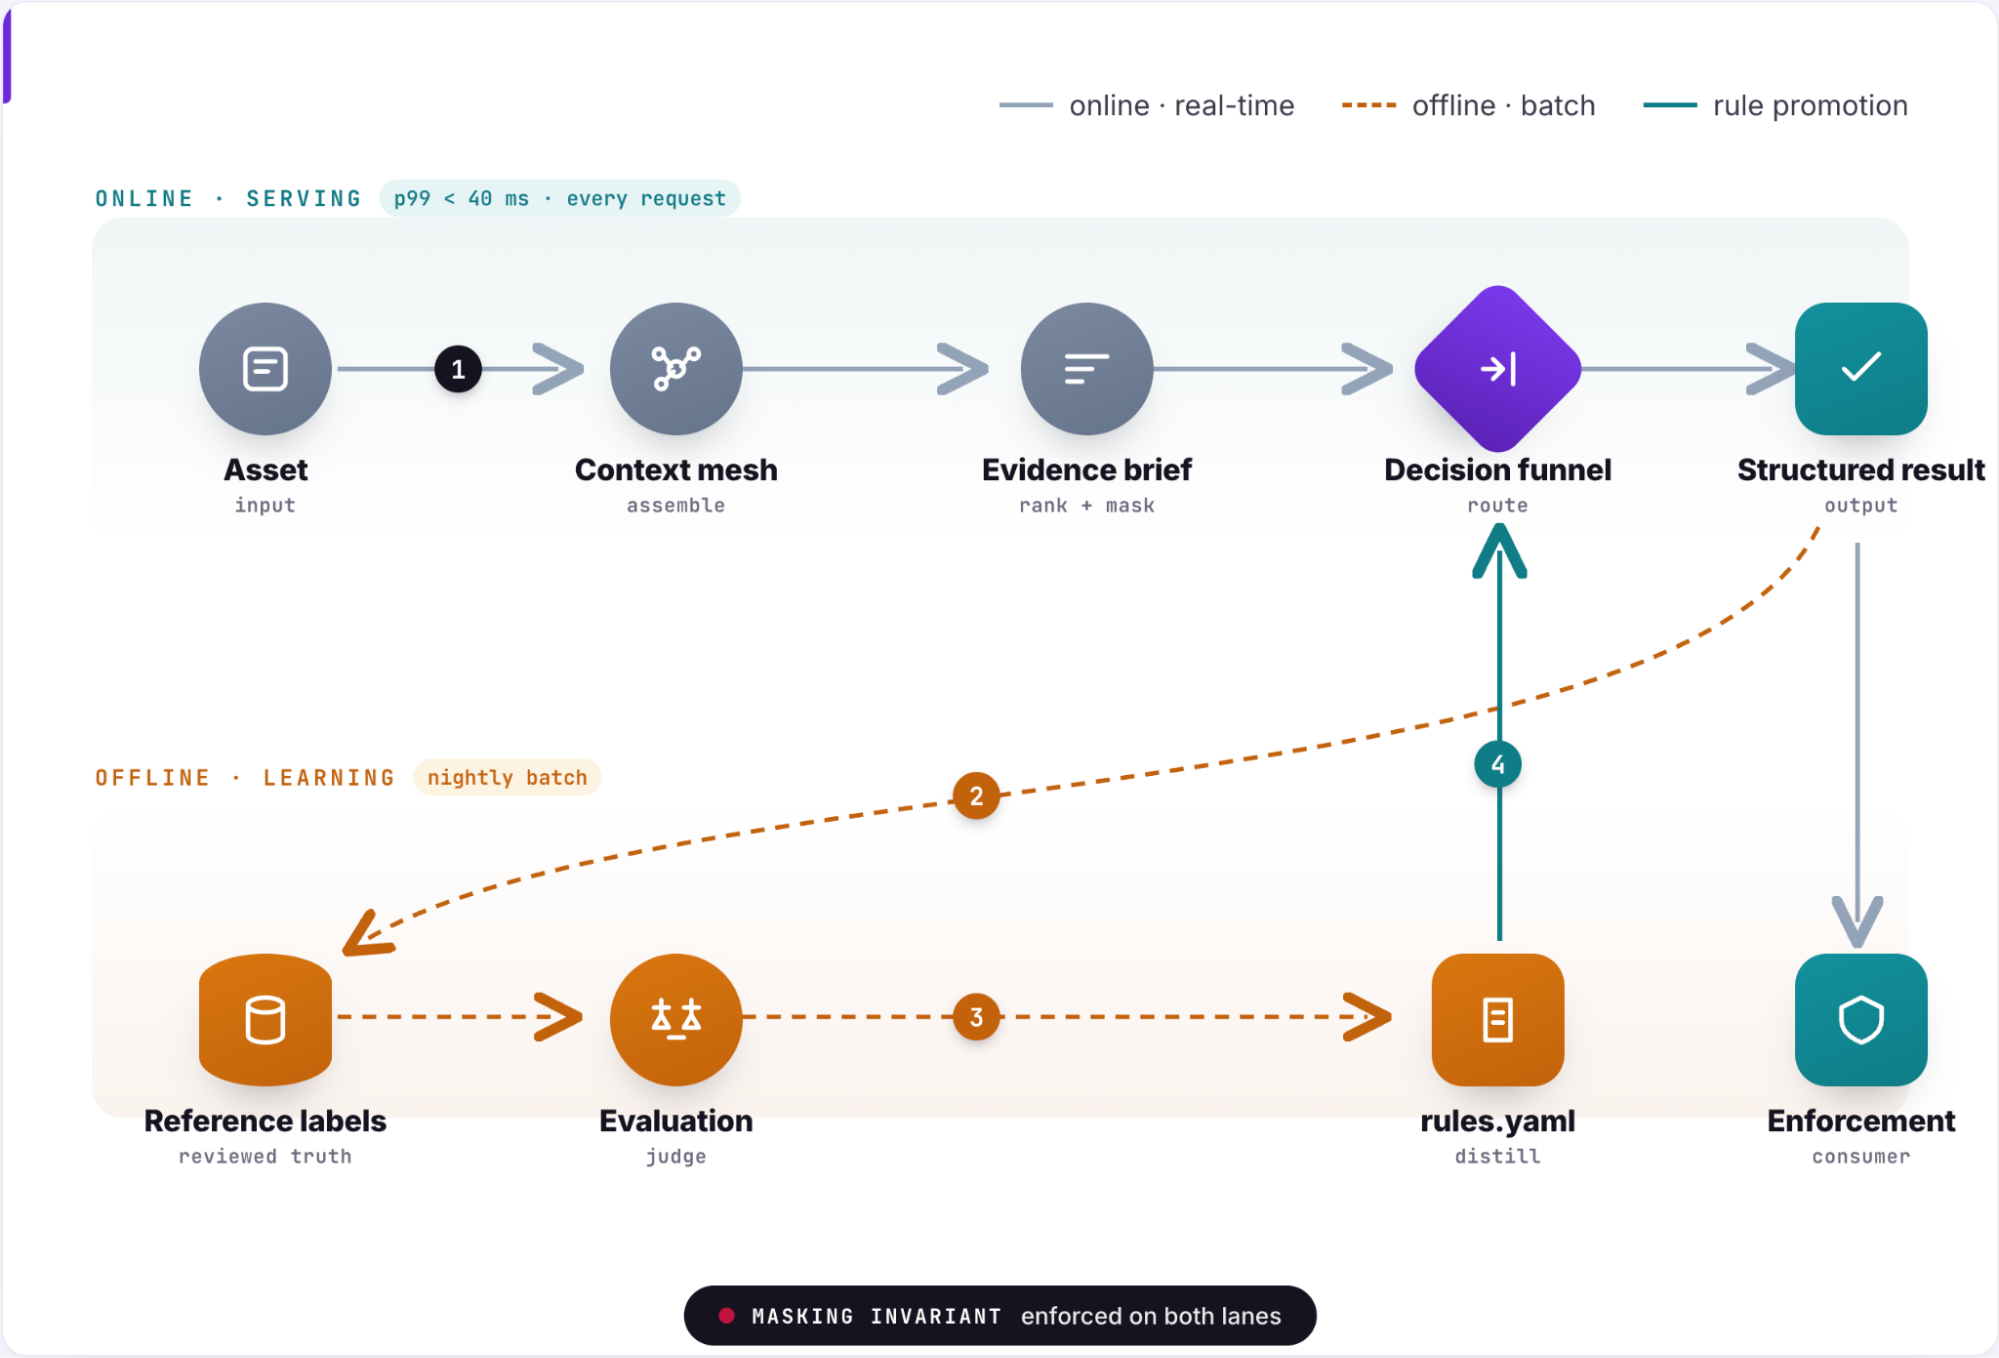
这些原则形成具体运行模式:定义稳定的分类契约,构建上下文网格,将决策导入确定性优先的漏斗,并通过独立评估与审阅标签保证学习循环安全。
为落地这套模式,我们把工作分为七个实用阶段,将高层架构转换成具体、可重复流程。后文以资产分类为例逐一说明。
1. 从契约开始
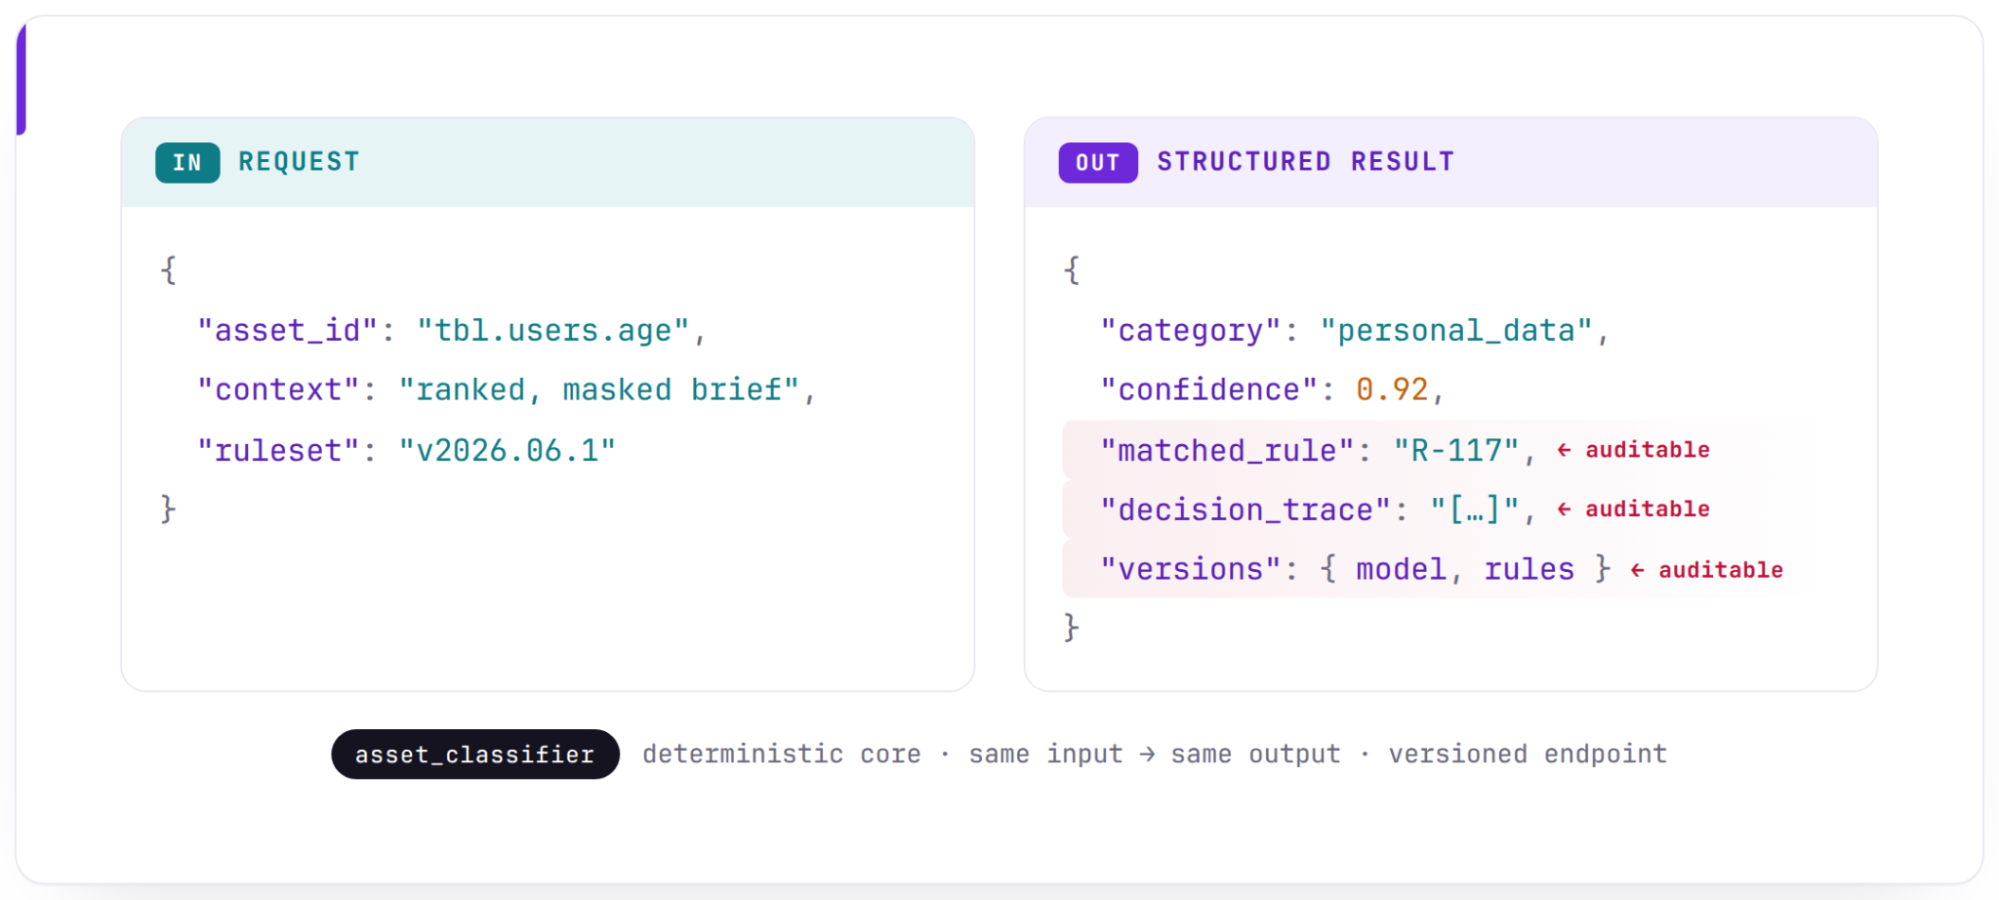
分类器应像平台服务一样工作:契约要小、明确、稳定。针对每个资产,它接收标识符和一组上下文,并返回结构化结果,包括:
- 分类体系中的类别。
- 置信度分数:这是模型的原始自我评估,我们对照审阅标签评估其校准情况,后文详述。
- 展示哪些证据影响结果的决策轨迹。
- 若决策来自确定性逻辑,给出匹配规则。
- 决策所用上下文、规则和提示的版本信息。
分类体系取决于领域。一个分类器可能区分用户数据与运维数据,另一个判断资产是否可以用于某个特定 AI 训练用途。我们避免强迫所有分类器采用统一分类体系,而让每个分类器负责一个有范围的问题;下游系统需要多侧面判断时,再组合答案。
这种范围限定很重要。窄分类器更容易评估、调试和治理,决策轨迹也更有意义,因为它解释一个决定,而不是试图同时解决全部策略问题。
2. 提示之前,先构建上下文
多数分类失败是上下文失败,而非提示失败。如果唯一信号是字段名,模型只能猜。如果系统还能提供代码引用、血缘、所有权、语义注解及附近用法,模型就能基于更好的证据推理。
实践中,上下文网格可能包含:
- 源代码解析,包括字段定义或使用位置。
- 所有权与组织元数据。
- 数据类型或来源等语义注解。
- 展示数据从哪里来、流向何处的血缘信号。
- 扫描器或基于嵌入的分类器产生的 ML 启发式输出。
- 显示引用、日志声明或调用位置的代码搜索结果。
重点不是把一切传给 LLM。更多上下文不自动意味着更好:有些字段冗余,有些嘈杂,有些已编码待预测标签,可能导致循环推理。
因此,系统生成证据简报:对最强支持信号、反对信号及来源链的紧凑摘要。我们不让模型筛选原始上下文,而让它对分类决策最相关的证据推理。
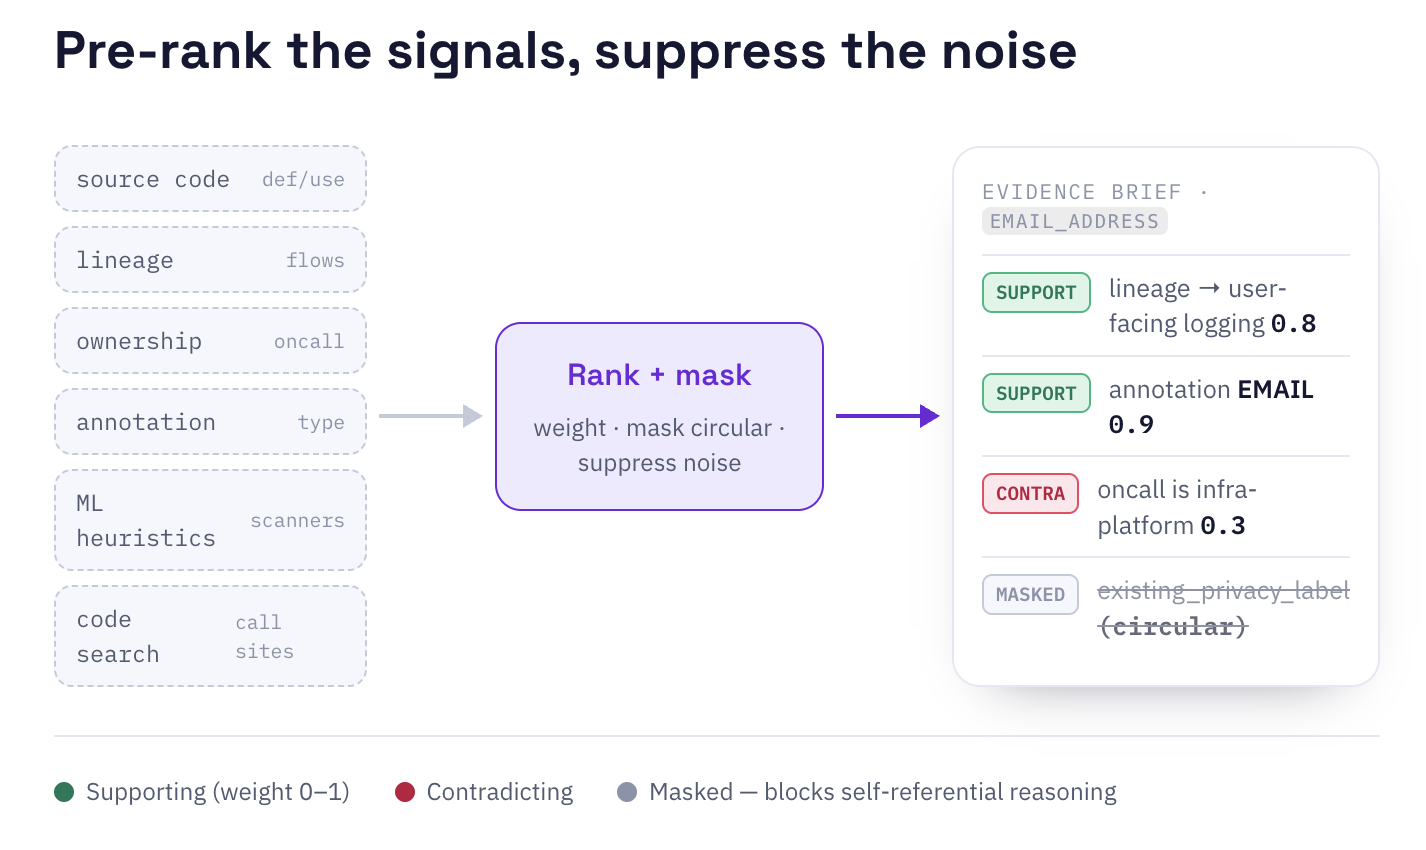
没有这种结构化,每个资产数十个原始字段都要由模型重新筛选重要性,导致令牌消耗高、注意力稀释、决策边界埋在噪声中。证据简报通过预先排序信号解决问题。例如 user_payload.email_address 的简报可能写道:
- 支持信号:血缘将资产连接到面向用户的日志流水线,权重0.8。
- 支持信号:语义注解表明数据类似 EMAIL,权重0.9。
- 反对信号:所有权元数据指向基础设施团队,而非面向用户的产品,权重0.3。
- 抑制信号:移除已有隐私标签,以避免循环推理。
最后一点很重要。模型不应通过读取已经包含答案的字段“发现”正确答案。屏蔽不只是提示卫生,而是系统不变量。 对 LLM 屏蔽的字段,也被禁止进入学习得到的规则蒸馏,避免模型借循环字段把答案偷渡进规则。使用高风险字段的确定性规则,必须明确审查。
系统还能随时间学习哪些上下文字段有用:持续改善分类的字段可优先使用,不稳定、冗余或有害的字段可被抑制,使信号质量由直觉判断转成可测量事项。
3. 使用决策漏斗
上下文组装后,分类器把资产送入决策漏斗。
第一条路径是确定性的。已知、版本化规则匹配资产时,分类器可以快速返回决策并清楚解释。规则适合稳定模式,例如已充分理解的命名空间、高精度语义注解,或长期验证过的信号组合。
第二条路径基于 LLM。如果资产新颖、含糊,或超出现有规则覆盖范围,分类器让模型对证据简报推理,模型返回候选标签、置信度指标、决策路径及引用证据。
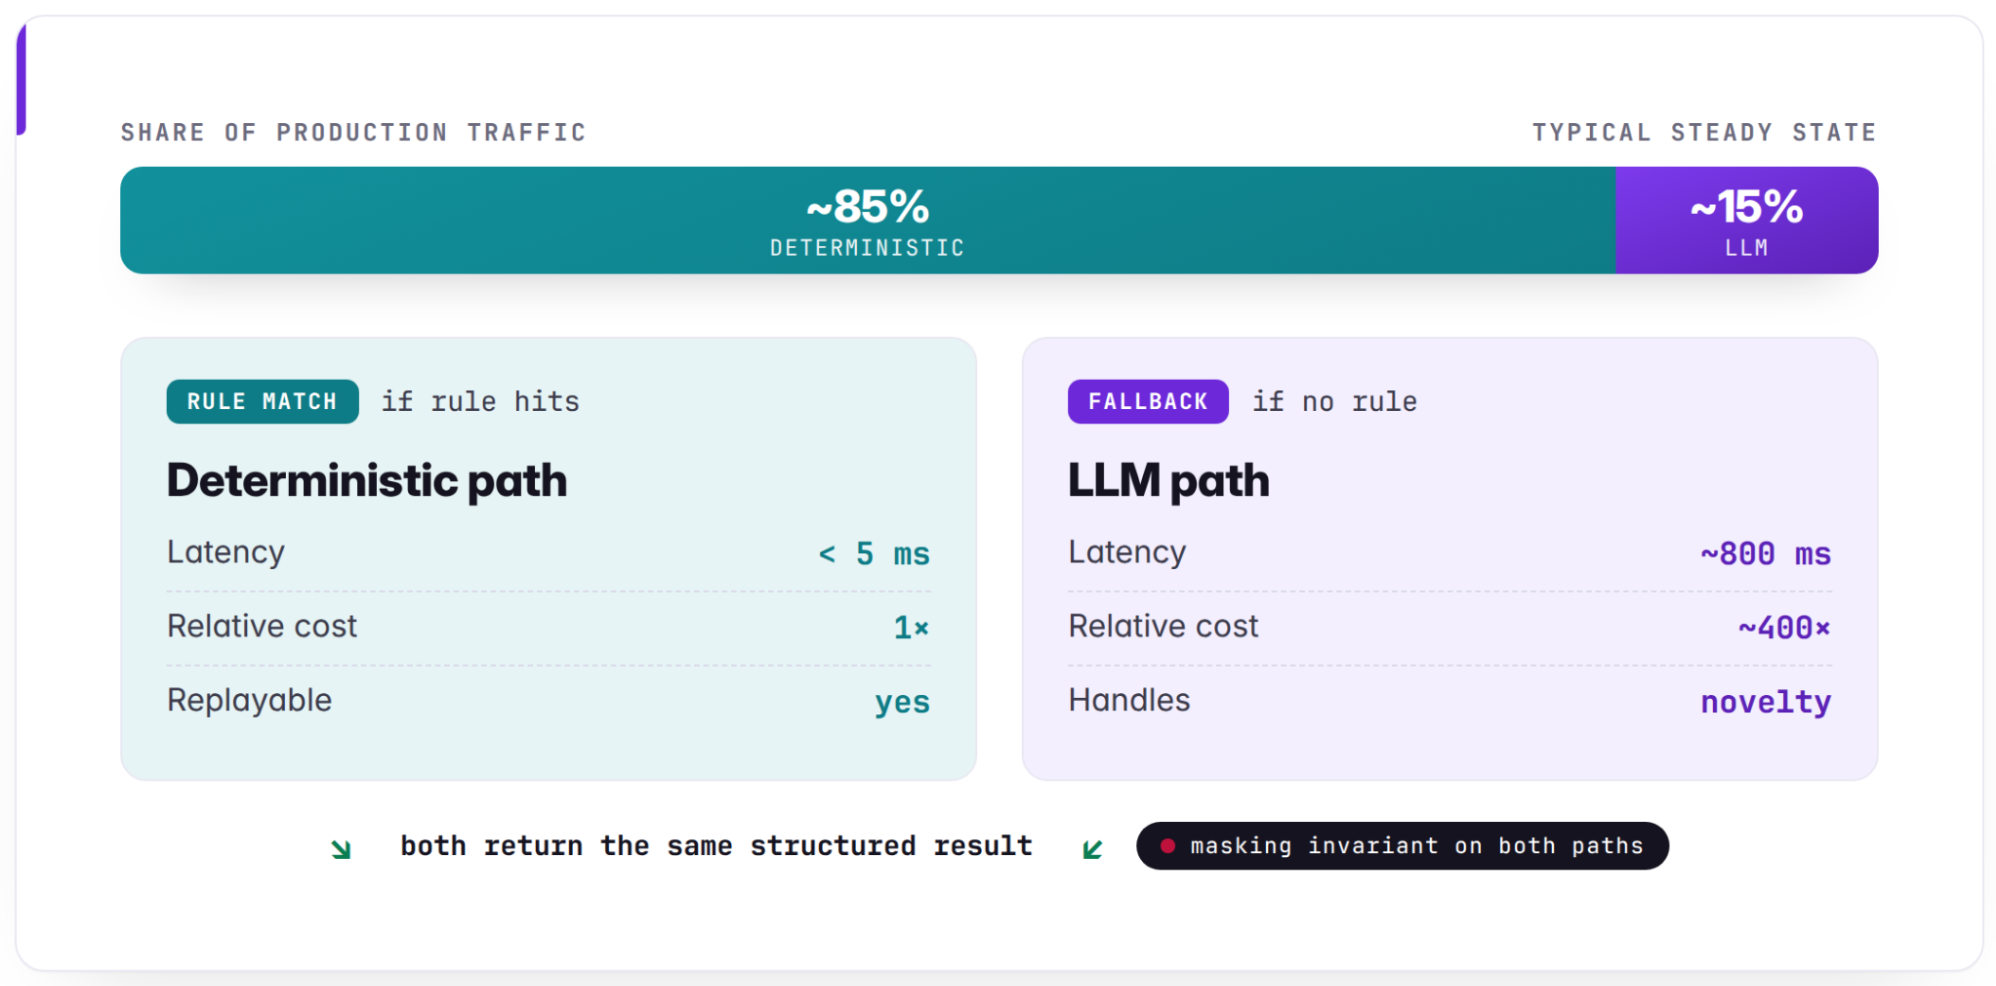
生产部署中,图7展示廉价确定性规则如何在个位数毫秒内解决绝大多数流量,约85%。LLM 作为回退,处理约15%的新颖或含糊情况。该路径更慢,约为秒级,计算成本约高400倍,因此单独分配预算。两条路径输出相同结果模式,并各自强制执行屏蔽不变量。
必须谨慎理解置信度。原始分数是模型依据自身判断给出的自我评估,并非天然等于正确概率。因此,我们对照审阅标签评估校准:比较原始分数与人工审阅参考集中实际观察到的正确率,判断给定分数与真实正确概率吻合程度。在启用校准路径的情况下,漏斗中基于置信度的路由,例如自动接受或转人工,应使用校准后分数,而不是原始数字。
两条路径输出相同格式。下游执行系统不需要知道结果来自规则还是模型推理,只接收类别、置信度、轨迹及版本化决策元数据。
这种分工让模式可行。LLM 处理歧义和冷启动,规则更适合常规执行。蒸馏入规则的稳定行为越多,服务路径越少调用模型。
规则覆盖率成为重要运行指标。如果质量稳定而覆盖上升,分类器正走向更健康的稳态:常规模型调用更少,资源消耗和延迟更低,决策更容易重放。
一个关键系统不变量是:对 LLM 屏蔽的字段,也不能进入学得规则的蒸馏,因此屏蔽信号不能通过自动蒸馏规则重新进入决策。某次生产部署中,规则评估处理屏蔽上下文的微妙错误,让规则悄然落入 LLM 回退;尽管规则集增长,覆盖率却看似进入平台期。修复后,规则覆盖立即上升,LLM 推理调用显著下降。
经验是:屏蔽不是提示工程问题,而是系统不变量;依赖高风险字段的确定性规则,必须明确审查,不能隐式继承屏蔽。
4. 有意识地解决冷启动
第零天,分类器可能面对数百万资产,却几乎没有审阅标签。随机采样不够:最重要的隐私类别可能稀有,等例子自然出现,很容易漏掉。
我们通过策略引导的样例初始化流程:
- 罕见敏感类别。
- 策略解释困难的边界案例。
- 看似敏感、实际并非敏感的负例。
- 上下文信号互相冲突的资产。
目的不是消除人工审查,而是把人的注意力集中在最需要判断的地方。
5. 保证学习循环安全
分类器上线后,需要改进,却不能给自己的作业打分。
我们分开两个循环。
参考循环产生审阅标签。标签只追加、版本化、记录来源。标签改变时保留历史,而不是覆盖。模型标签是有用建议,但不会自动成为参考标签。人裁定不确定或高风险案例,裁定后的标签成为评估参考集。
优化循环改善提示、路由、上下文使用及候选规则。它可以快速演进,但要针对审阅参考集评估,而不是针对待优化模型自身产生的标签。这很关键:分类器若用自己的预测训练或验证自己,可能看似改进,实际却偏离策略意图。
质量控制采用多面板裁判:三个独立 LLM 评估,提示策略各不相同。一个直接从证据分类,一个先批评推理再分类,一个只关注值班责任、血缘、语义注解等元数据,忽略名称和描述。三者共用一个裁判模型,这是更大的推理模型,有意不同于分类器模型。
三个裁判共用框架,仅推理要求不同。下面是说明结构的示意骨架,并非真实生产提示。每个裁判收到相同、经过屏蔽的证据简报,屏蔽不变量仍成立,并各自返回结构化裁决。
# Shared scaffold (all three judges)
INPUT  = masked_evidence_brief   # pre-existing privacy label removed; masking invariant holds
OUTPUT = {label, rationale, confidence}
JUDGE_MODEL = larger reasoning model, deliberately != classifier model

# V1 - direct-from-evidence
verdict_1 = judge(brief, instruction="Classify the asset directly from the evidence.")

# V2 - critique-then-classify
verdict_2 = judge(brief, instruction="First critique the supporting and contradicting signals, then classify.")

# V3 - metadata-only
verdict_3 = judge(brief, instruction="Use ONLY metadata signals (on-call, lineage, semantic annotations). Ignore names and descriptions.")

# Aggregate
final_label = majority_vote(verdict_1, verdict_2, verdict_3)
Agreement = cohens_kappa(verdict_1, verdict_2, verdict_3)   # inter-rater reliability
结果通过多数票汇总。我们把三种裁判框架的面板一致性作为稳定信号;Cohen’s kappa(κ)则比较裁判共识与参考标签,或与分类器输出,为分类可靠性提供统计信号。Kappa 分数驱动结构化循环决定:健康时 Continue;疑有标签噪声时 WidenAudit;连续两次或以上迭代质量下降时 FreezeAndAudit;标签或分类体系似乎根本损坏时进入 DataProblem,停止并升级处理。这样防止迭代把回归带入生产。
对于不平衡分类体系,我们使用能暴露罕见类别失败的指标。单看准确率会误导:敏感资产稀有时,把一切标成不敏感的分类器也可能很“准确”。Matthews 相关系数、宏平均 F1、每类召回率、平衡准确率及校准检查,共同提供更完整视角。
我们还寻找脆弱决策。一个有用测试是反事实屏蔽:每次移除一个上下文字段,再分类。如果移除一个弱信号就使决策翻转,则标记资产待审。原预测可能仍然正确,但推理或许过于脆弱,不宜放心自动化。
质量下降时,系统应放慢或停止:扩大审计样本、冻结优化,或把分类体系、标注问题交给人工。学习系统需要刹车,而不只是油门。
6. 把稳定行为蒸馏成规则
即便很强的 LLM 分类器,也不应永远是默认执行路径。我们把模型价值集中于蒸馏,而非自主决策。任何可能改变敏感数据保护方式的规则,上线前都要由人审查批准。
系统积累审阅标签和决策轨迹后,可识别足够稳定、能编码为确定性规则的模式。例如高精度语义注解、可靠的所有权与血缘组合,或某类资产中的重复模式。
候选规则影响服务决策前要经过验证,典型流程如下:
- 根据稳定上下文和标签模式提出规则。
- 在保留的审阅集上测试。
- 在类似生产流量上以影子模式运行,不改变服务行为。
- 只有质量、覆盖和回归检查通过所需门槛,才晋升。
- 模式过时或质量退化时,退役或修订。
蒸馏按复杂度逐步提高的阶段进行。
阶段1:字段规则。提取单字段模式,包括精确匹配、关键词、数值范围、值集合成员关系、命名空间模式。最小支持量为两个资产,最低纯度为80%。这是用于找出待评估候选的挖掘阈值,不是晋升门槛。任何阶段的候选,正式服务前仍必须通过保留集验证、更高的开发集精度要求、影子模式,以及保护可能改变时的人工审查。
阶段2:组合规则。对未覆盖类别搜索合取,例如“值班责任包含 X 且语义类型为 ACCOUNT_ID”,门槛更严格:95%纯度、至少10个样例,并对50%子样本进行稳定性检查。
阶段3(可选):LLM 辅助规则生成。模型提出结合血缘深度与所有权模式的自定义条件,捕捉手工启发式漏掉的情况。此功能受发布控制,默认关闭。每条候选规则依次经过:保留集验证;失败时进入有界 TTL 黑名单;影子模式,只记录不应用;只有质量门槛通过,才晋升到 rules.yaml。晋升后的规则缩小 LLM 使用范围。
关键原则是确定性规则不能悄然降低保护。晋升需要针对回归设计的保障,尤其是敏感类别。
经过验证的规则导出为 Python、SQL、JSON 或 Hack,部署到完全不依赖 LLM 的生产系统。发布使用比较并交换(CAS)语义:写入不可变规则和提示版本,再通过租约保护的 CAS 激活已发布指针;在我们的单写入者模型中,这是原子的。生产路径因此保持确定性引擎,而 LLM 仅处理缺少规则覆盖的新资产。
这使混合方法可持续:LLM 帮系统学习,确定性规则帮系统执行。
7. 自动化正确的事情
自动化是必需的,但边界很重要。
我们自动化上下文获取、证据简报生成、候选分类、评估运行、失败分析和候选规则提议。这些任务量大,自动化能减少人工重复劳动,提高一致性。
我们在需要判断处保留人工:含糊策略解释、审阅参考标签、高风险分歧,以及可能实质改变保护的晋升决定。这是一项路由策略,而不是提示。
满足以下任一情况时,决策升级为人工审查:
- 校准置信度低:低于自动接受阈值,不能安全地自动发布。
- 裁判面板分歧:三个裁判没有明确多数,或评定者一致性 Cohen’s kappa 较低,表明案例存在实际歧义。
- 高代价罕见类别:候选属于稀有敏感类别,假阴性代价高,因此即便置信度中等,非对称错误成本也要求人工检查。
- 推理脆弱:反事实屏蔽移除单个弱信号就使标签翻转。预测可能正确,但推理不够稳健,不宜放心自动化。
- 降低保护的规则晋升:候选规则可能以降低保护的方式改变敏感类别执行。确定性规则不能悄然削弱保护。
- 控制器升级:调优控制器进入
Pausing或Diagnosing,表明质量问题或根本标注、分类体系问题需要人工解决。
这种平衡是有意设计的。隐私感知基础设施不应隐藏不确定性。模型、裁判或评估循环意见不一致时,系统应把分歧作为有用信号呈现。有时答案不是更好的提示,而是更清楚的策略指引、更好的标签,或更窄的分类体系。
这里最好的自动化并不替代人,而是把注意力集中到最难案例,记录推理,并随时间把稳定学习转换成可重复执行。
我们学到了什么
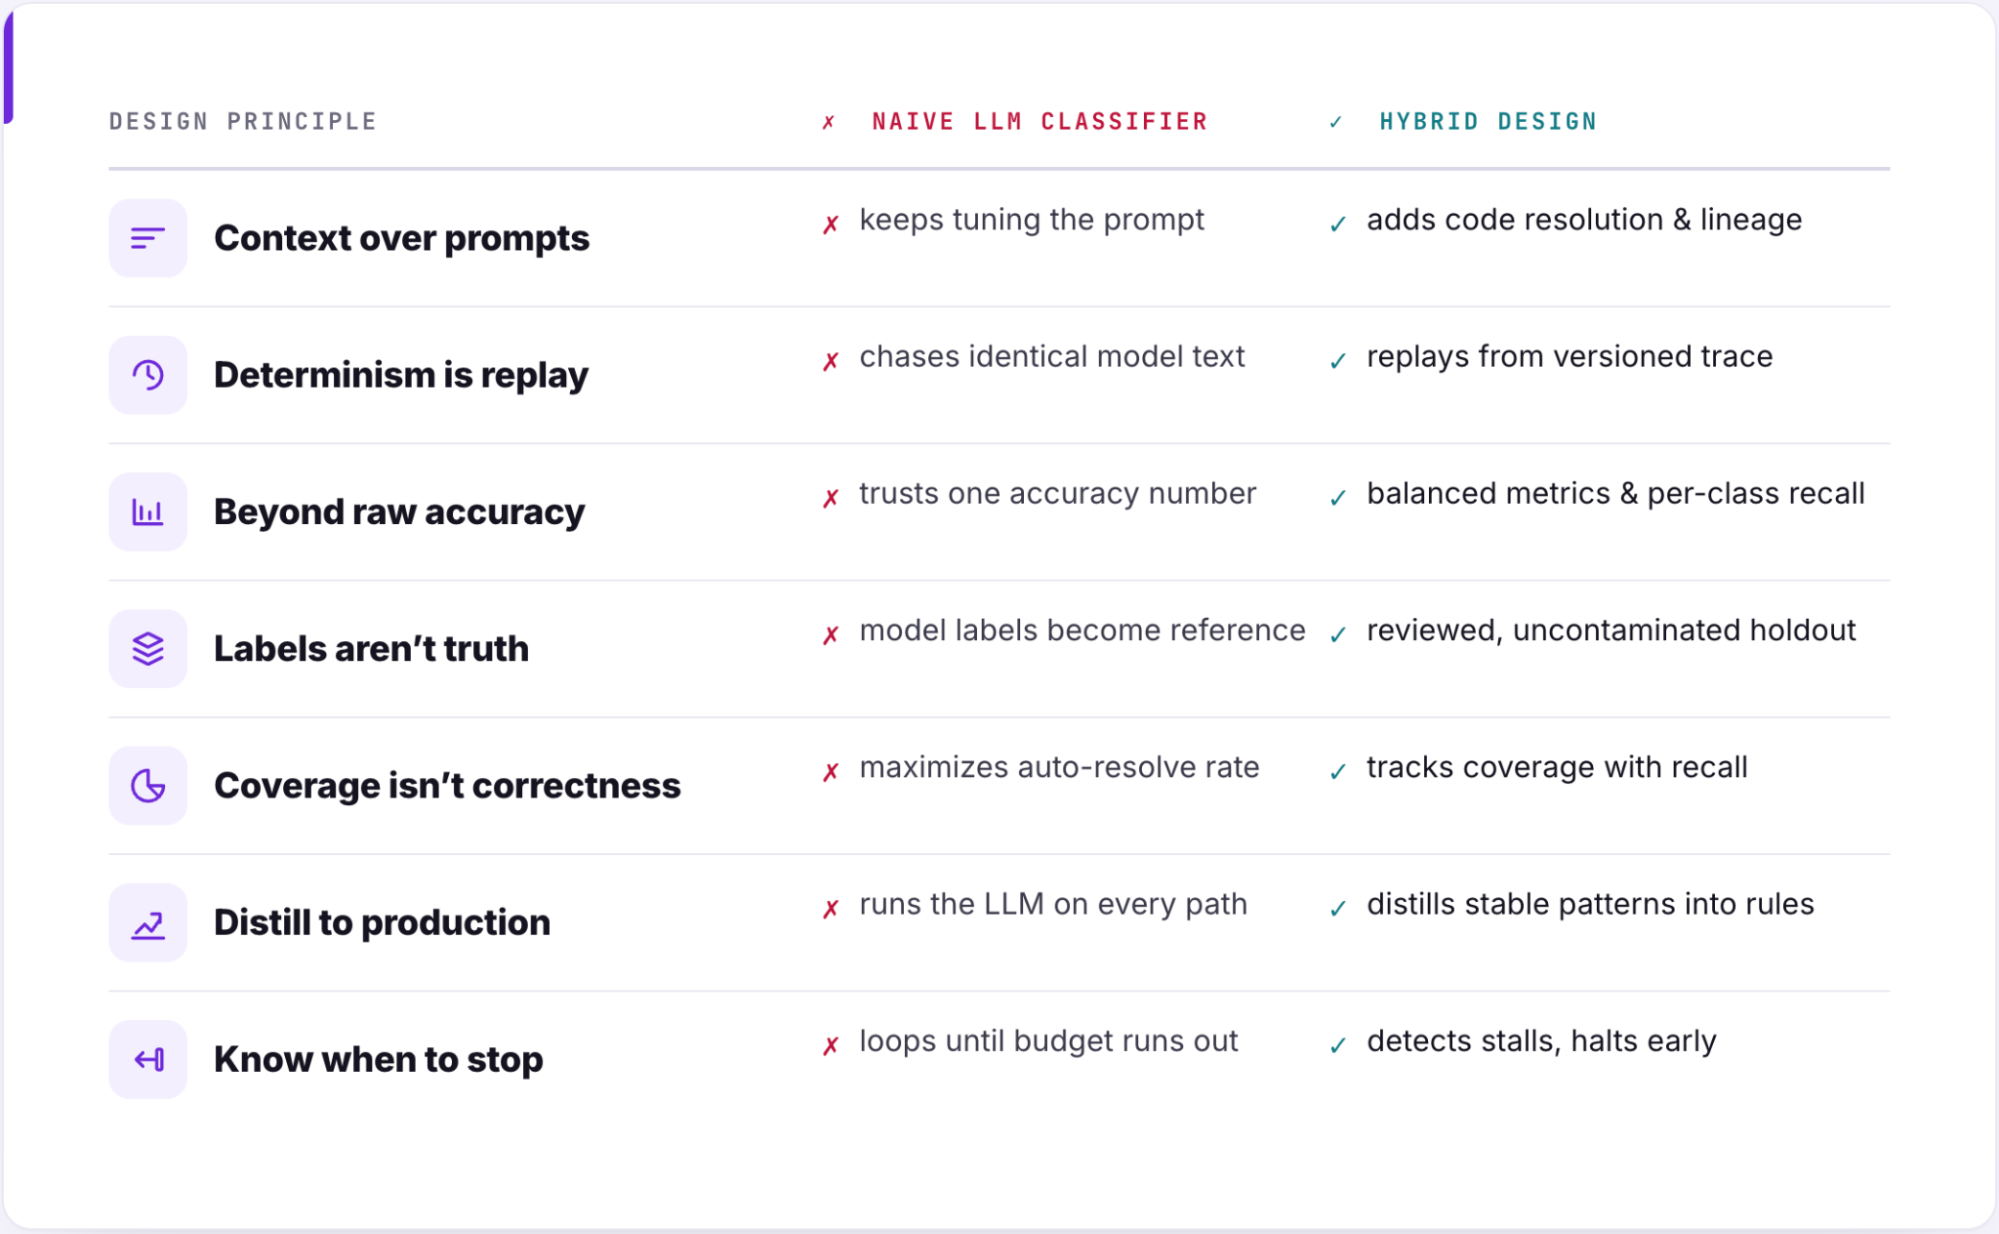
上下文质量胜过提示质量
分类停滞时,很容易不断调提示。根据我们的经验,更好的上下文通常更重要。代码解析、血缘、所有权和语义注解,能以提示修改做不到的方式改变决策空间。
问模型是否需要更好指令之前,先问它是否具备人工审阅者需要的证据。我们在缓存流水线的 age 字段上看到这一点:它是缓存 TTL,不是人的年龄。只改提示不能可靠解决,加入代码解析和血缘却可以。模型看见字段解析为 TTL 后,假阳性就消失了。
确定性意味着可重放
目标不是让 LLM 每次输出相同文本,而是能用同样版本化的输入、上下文和逻辑,在日后复现决策。
这就是版本化的重要性。有效轨迹应告诉我们使用哪些证据、启用哪个规则或提示版本,以及如何在调试、事故复盘或审计中重放。某次审查中,我们根据存储轨迹及固定的上下文、规则、提示版本,重放了一个历史分类,不再调用 LLM,就准确重建了资产为何获得该标签。
单看准确率不够
对于不平衡分类体系,准确率可能隐藏最重要的失败。敏感类别稀少时,分类器可能看起来很好,却漏掉太多此类样本。
平衡指标、每类召回率、校准检查及假阴性审查,都是质量视角的一部分。没有单个指标能说明全部。我们看到一个几乎把所有资产标成不敏感的分类器,总体准确率很高,稀有敏感类别召回却低。Matthews 相关系数和宏平均 F1 揭露了准确率掩盖的缺口,漏判案例因此重新进入审查。
把建议与真值分开
模型标签有用,但不能自动成为参考标签。参考集需要审阅来源,保留集评估不能被正在评估的同一模型输出污染。
这种分离有意增加摩擦,防止自我强化循环看起来更好、实际上越来越缺乏依据。我们直接观察过:对同一模型早期标签计分的优化运行,似乎进步了;改用冻结、人工审阅的参考集重新评估后,所谓收益却是偏离策略意图的漂移。
覆盖不等于正确
更高自动化覆盖只有质量维持时才有用。分类器可能自动解决更多资产,却在关键案例上更不可靠。
因此,要把覆盖与召回、精度、回归检查和稳健性测试一起跟踪。目标不是不惜代价自动分类更多资产,而是自动化足够稳定的情况。某次晋升宽泛规则,提高了自动化覆盖,却降低影子模式中某敏感类别的召回。由于同时跟踪覆盖与召回,我们在规则正式服务前发现回归并缩窄规则。
蒸馏是生产模型
LLM 适合歧义、冷启动和新模式;常规路径需要快速、可解释、可复现的决策,确定性逻辑更好。
可持续模型是漏斗:让 LLM 帮助发现与推理,再把稳定模式蒸馏成版本化规则,由执行系统高效运行。
自我调节属于架构,而不是运行操作
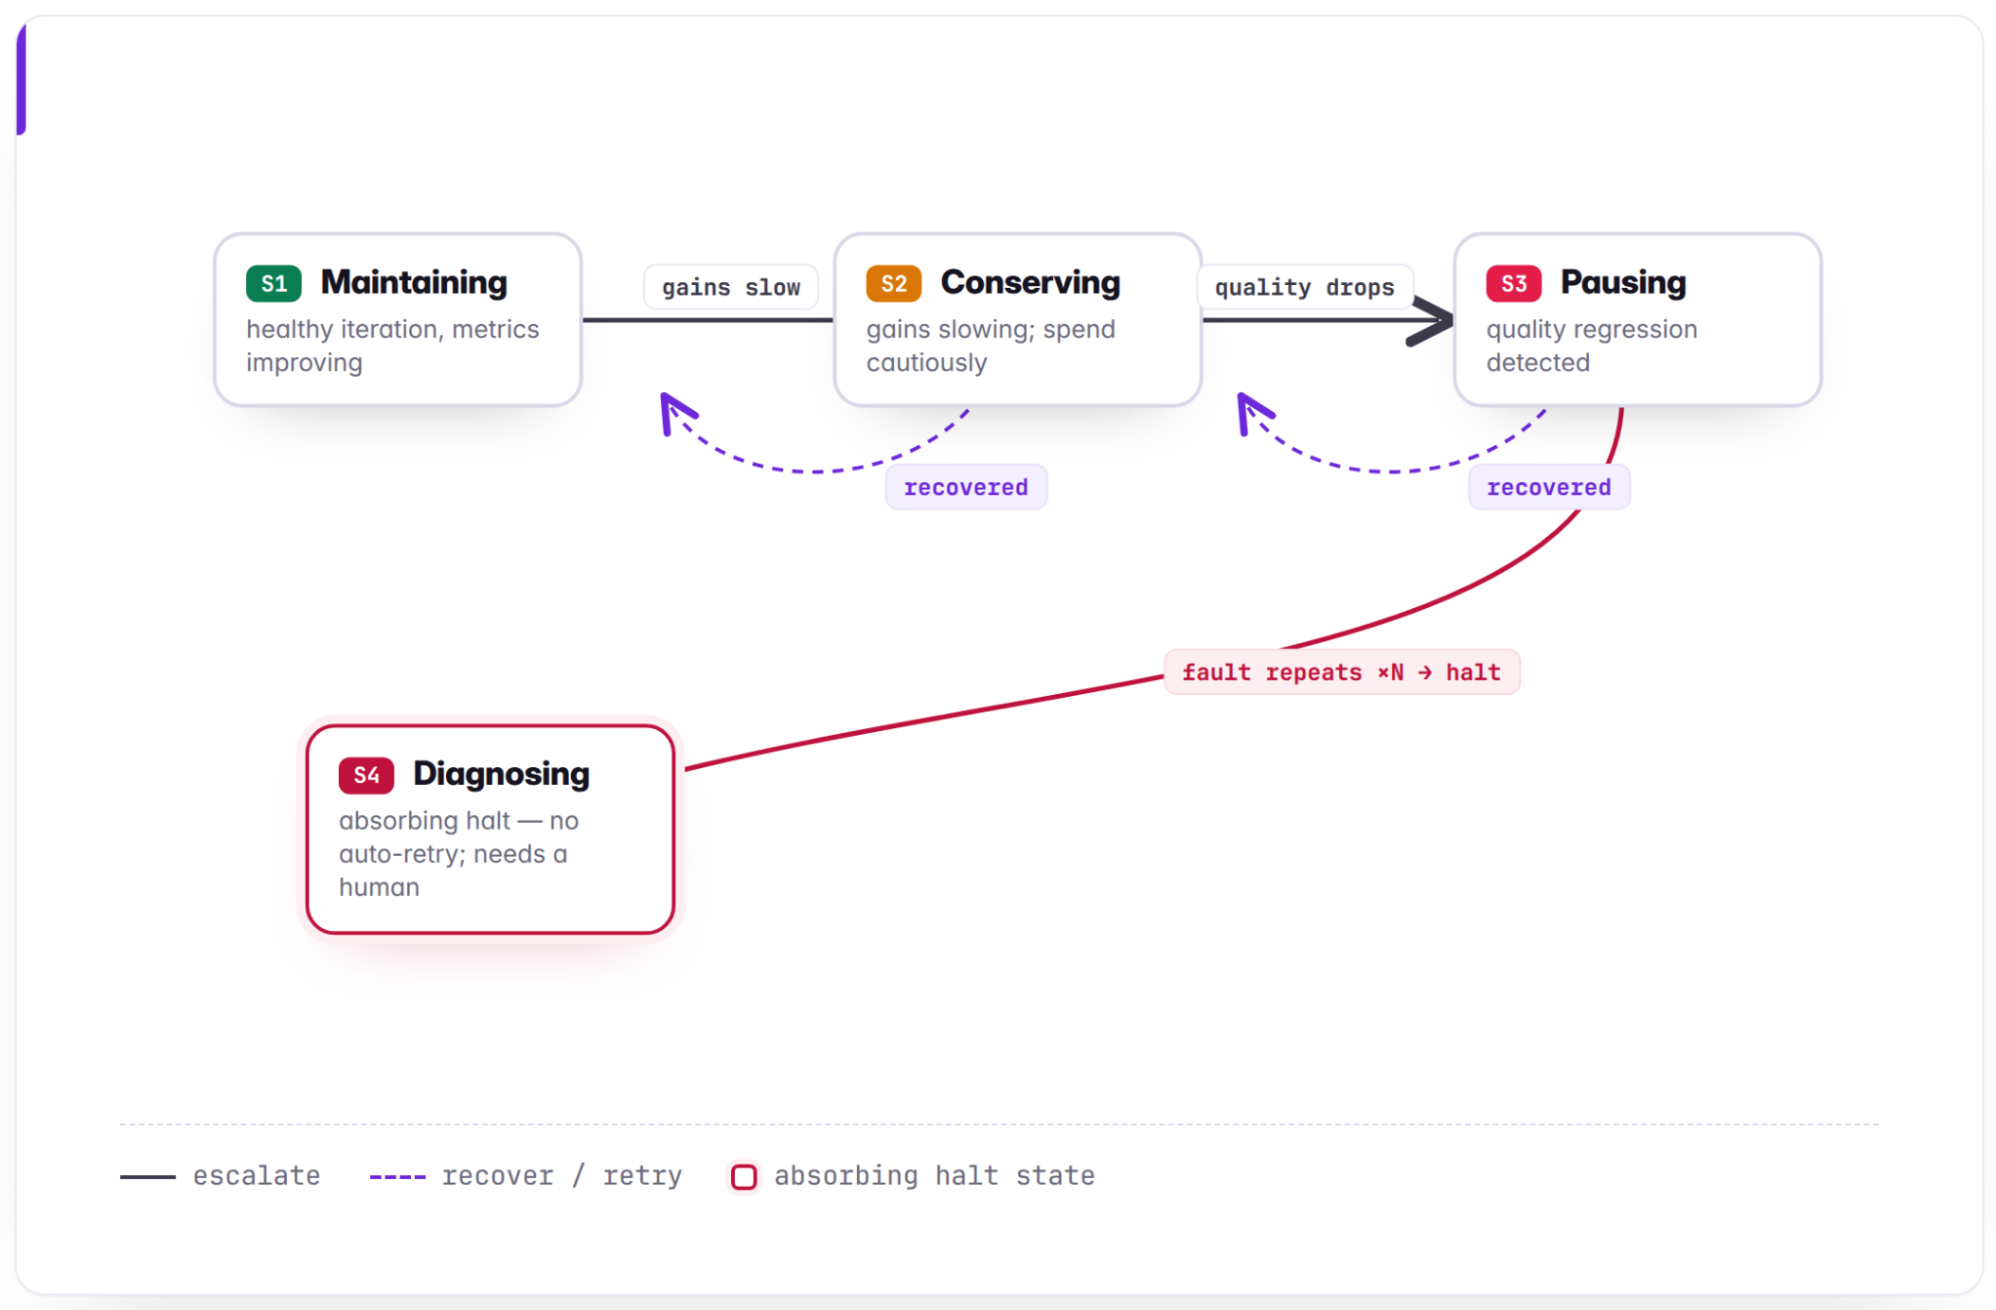
不知道何时停止的学习系统可能构成负担。我们构建了在以下状态间转换的调优控制器:
Observing:收集信号。Maintaining:健康迭代。Conserving:收益放缓。Pausing:质量担忧。Diagnosing:因根本问题停止。
实践中,振荡检测器识别停滞优化,例如分类器在两个候选提示之间循环却没有改善,并提前终止,每个停滞运行可节省数千次无效分类调用。自我调节从一开始就纳入架构,事后补装会困难得多。
接下来的方向
由这项工作延伸出三个方向:
- 把旧分类器迁移到该系统,用完整“上下文网格+蒸馏”流水线替代临时启发式。
- 扩展到其他 PAI 工作流:上下文 → LLM 推理 → 蒸馏 → 确定性执行,同样适用于血缘验证、用途边界检查和保留策略分配。
- 应用到隐私之外:初步实验表明,这些技术可推广到智能体可观测性与监督,其中同样存在概率推理与可审计执行之间的张力。
AI 原生产品提高了 PAI 的要求
AI 原生产品带来新数据模态、更快迭代及更含糊信号,提高了隐私感知基础设施的要求。同时,隐私执行仍需要一致、可解释、可复现的决策。
资产分类展示如何弥合差距:从清楚契约开始,构建丰富上下文,用 LLM 处理新颖与歧义,把审阅标签与模型建议分开,用能揭示罕见类别失败的指标评估,再把稳定行为蒸馏为确定性、版本化规则。
这种模式让系统从歧义学习,却不把歧义作为执行基础。
模式也能推广到我们的使用场景之外。另一个执行团队独立于我们的工作,将其与三种替代方法直接比较,并选作分类层。在他们的评估中,确定性优先、LLM 回退的分类,比端到端 LLM 方法产生更一致、可调试、可审计的决策。两个团队独立选择同一权衡——用 LLM 推理,用规则执行——说明它是一种稳健模式。
更广泛的经验是:隐私感知基础设施不是工程税负,而是推动更好架构的力量,带来更清楚的契约、更丰富的上下文、更强评估、更安全发布,以及知道何时请求人工判断的系统。
致谢
作者感谢隐私感知基础设施团队许多成员,他们为本文工作发挥了关键作用。特别感谢 Alex Basiuk、Dionisios Sotirios Krongos、Fanghao Song、Kartikey Sachdeva 和 Loka Potnuru,感谢他们在分类器分析、运行时特征迁移、扫描器强化、假阳性减少和年龄数据流精度改善方面的基础贡献;也感谢更广泛的 PAI 团队完成上下文增强与评估。
还感谢 Dave Kurtzberg、Inchara Shivalingaiah、Juemin Wei、Nithya Arumugam、Zhe Wang 及其团队,在自主补救流水线中独立验证分类模式;感谢 Jonathan Bergeron 全程支持;感谢 Deborah Davis 全程编辑指导。









暂无评论内容