


Laravel Scout:从可搜索模型到可控的索引与查询
来源:Laravel 文档贡献者,Laravel 13.x Scout 官方文档,2026-10-05 核对。本文依据授权翻译整理,覆盖模型接入、引擎选择、索引生命周期、过滤分页与软删除,并概述原页新增的语义搜索能力。示例基于 Laravel 13 / PHP 8.3+ 的文档边界,不能直接套用于所有旧版 Scout。
Scout 通过模型观察器把 Eloquent 记录与搜索引擎关联起来。给模型添加 Searchable trait 后,常规的创建、保存和删除操作会触发相应的搜索同步。它统一了常用接口,但不同引擎的数据类型、过滤能力、索引方式与一致性仍然不同。
先选引擎,再决定需要多少基础设施
| 引擎 | 工作方式 | 适用边界 |
|---|---|---|
| database | 直接使用 MySQL / PostgreSQL 的全文索引和 LIKE | 常规检索的简洁起点,没有独立的外部索引导入步骤 |
| collection | 把候选记录取到 PHP,再用 Str::is 过滤 | 原型、测试或几百条级别的小数据;大数据集不合适 |
| Algolia | 外部托管搜索索引 | 需要 SDK、服务凭据和独立索引配置 |
| Meilisearch / Typesense | 独立搜索服务,可自托管 | 需要兼容的客户端、服务端版本、字段设置或 schema |
| Turbopuffer | 外部全文、语义与混合搜索服务 | 需要模型 schema、搜索字段、区域及 API key |
官方文档把数据库引擎作为很多应用的务实选择。它避免额外部署搜索集群;需要拼写容错、分面、向量或大规模地理检索等能力时,再考虑专用引擎。collection 虽然兼容包括 SQLite、SQL Server 在内的关系数据库,但可移植不等于高效。
安装与模型接入
composer require laravel/scout
php artisan vendor:publish --provider="Laravel\Scout\ScoutServiceProvider"
第二条命令把配置发布到 config/scout.php。给需要检索的模型添加 trait:
<?php
namespace App\Models;

use Illuminate\Database\Eloquent\Model;
use Laravel\Scout\Searchable;

class Post extends Model
{
    use Searchable;
}
如果选择数据库引擎,在应用环境中配置 SCOUT_DRIVER=database。对于外部引擎,则按对应驱动配置服务。安装命令会访问软件仓库并修改项目依赖;实际部署应保留锁文件、检查兼容性,并在自己的项目中验证,而不是依据本文推断安装已经成功。
不要默认把整个模型送去索引
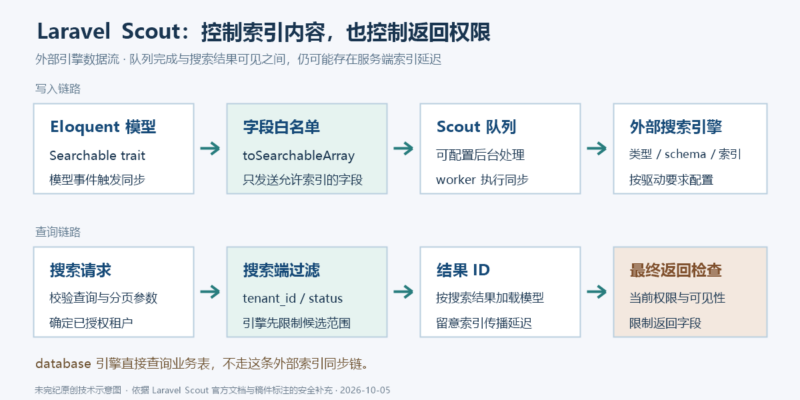
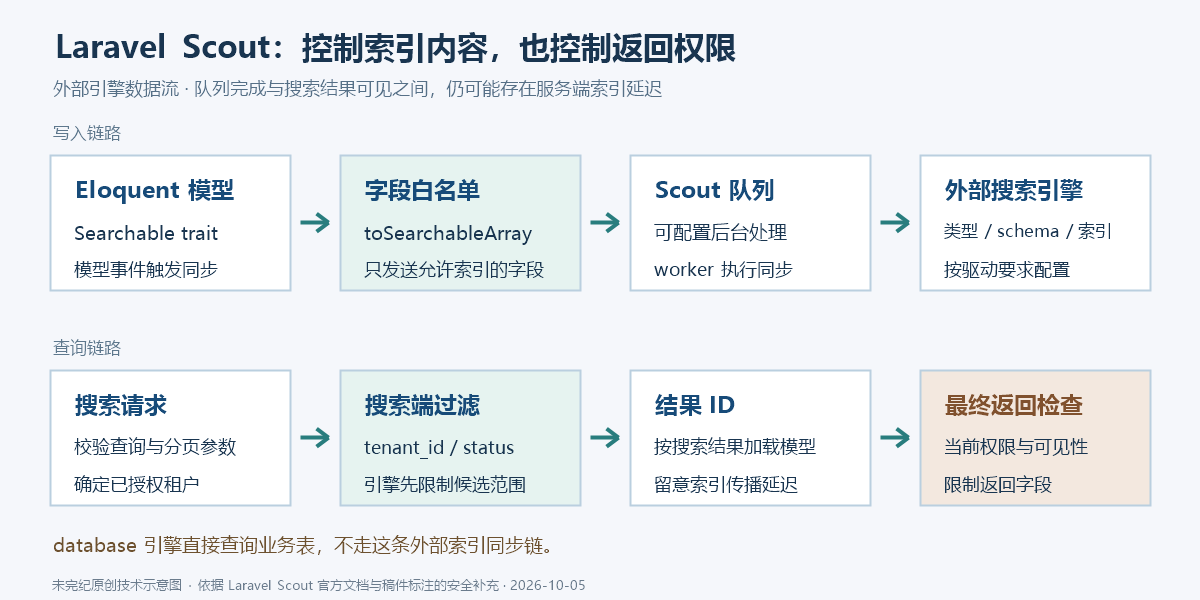
Scout 默认把模型的 toArray() 形式作为可搜索内容。对于外部服务,这可能使字段离开业务数据库。即便模型已经隐藏密码等属性,也应该主动定义字段白名单,避免后续新增字段或关联被意外带入。
下面是对原文 toSearchableArray() 示例的编辑改写,假定业务表确实有这些字段,并且发布状态使用字符串 published:
public function toSearchableArray(): array
{
    return [
        'id' => (int) $this->id,
        'title' => $this->title,
        'body' => $this->body,
        'tenant_id' => (int) $this->tenant_id,
        'status' => $this->status,
    ];
}
与原文先调用 $this->toArray() 再裁剪的骨架相比,这里只返回明确允许的字段。没有加入密码、会话凭据、内部备注或不必要的用户信息。白名单中的正文也仍需符合应用的数据发送边界;“字段叫 body”本身不代表可以发给第三方。
Scout 的引擎由 config/scout.php 中的默认驱动决定;数据库与 collection 驱动无需外部搜索服务。Laravel 13 文档列出的专用驱动为 Algolia、Meilisearch、Typesense 和 Turbopuffer。不同模型可以分别选择不同驱动,Scout 不会自动把同一次查询扇出到所有引擎再合并结果。切换默认驱动前,应准备相应 SDK、凭据、索引设置,并考虑存量索引如何迁移。
use Laravel\Scout\Engines\Engine;
use Laravel\Scout\Scout;
use Laravel\Scout\Searchable;

class Article extends Model
{
    use Searchable;

    public function searchableUsing(): Engine
    {
        return Scout::engine('typesense');
    }
}
searchableUsing() 为这个模型选择引擎,默认驱动仍可服务其他模型。模型也可重载 searchableAs() 定义索引名;第三方引擎下如要使用自定义记录主键,须同时理解 getScoutKey() 与 getScoutKeyName()。这些模型级设定不会把 Eloquent 全局作用域自动同步到外部服务;字段隔离、租户过滤和访问控制仍须明确设计。
数据库引擎:给不同列选择合适的匹配方式
数据库引擎默认对可搜索字段执行包含匹配的 LIKE '%example%'。SearchUsingPrefix 可改为前缀匹配 example%,SearchUsingFullText 则使用数据库全文索引。属性附加在模型的 toSearchableArray() 方法上;没有特别指定的列继续采用默认 LIKE。
use Laravel\Scout\Attributes\SearchUsingFullText;
use Laravel\Scout\Attributes\SearchUsingPrefix;

#[SearchUsingPrefix(['id'])]
#[SearchUsingFullText(['title', 'body'])]
public function toSearchableArray(): array
{
    return [
        'id' => $this->id,
        'title' => $this->title,
        'body' => $this->body,
    ];
}
这段是独立的数据库引擎示例,不应与上一节同名方法一起粘进一个类。使用全文策略前,必须先给相应列建立全文索引。数据库引擎始终查询模型自己的数据表,因此外部引擎使用的 searchableAs()、getScoutKey() 和 getScoutKeyName() 不会改变它的表名或主键。
外部引擎的连接、字段设置与类型
Algolia 需要配置应用 ID 与 secret,并安装 algolia/algoliasearch-client-php。Meilisearch 需要 meilisearch/meilisearch-php 与 http-interop/http-factory-guzzle;Typesense 使用 typesense/typesense-php。这些 SDK 版本必须与目标服务兼容,尤其要留意升级时服务端自身的破坏性变化。
原文的 Meilisearch / Typesense 环境示例使用 masterKey 作为说明性值,并展示本地 HTTP 地址。这不是生产秘密,也不是建议在互联网链路上明文传送管理请求。本稿不生成真实 key;应从受控环境变量或秘密管理设施提供凭据,限制其权限,并按部署网络设置 TLS 与访问控制。.env 不应公开或提交到版本库。
Turbopuffer 使用 SCOUT_DRIVER=turbopuffer、TURBOPUFFER_API_KEY,可用 TURBOPUFFER_REGION 指定区域;原页默认区域为 gcp-us-central1。区域选择同时影响数据落地与网络延迟。
外部引擎默认索引名通常与模型表名一致。可通过 searchableAs(): string 返回 posts_index 等名字;若修改索引中的唯一标识,则需要同时实现 getScoutKey() 与 getScoutKeyName()。原文用 email 举例,但可变且带有个人信息的字段是否适合当稳定搜索 ID,需要按业务权衡。
每个 Eloquent 模型会对应自己的第三方搜索索引;index-settings 可以按模型分别定义。下面保留原文的两个独立索引示例。Algolia 例中用户索引和航班索引可以有不同的可搜索字段与分面规则;Meilisearch 例中也分别为用户与航班设置可过滤和可排序字段:
use App\Models\User;
use App\Models\Flight;

// config/scout.php
'algolia' => [
    'id' => env('ALGOLIA_APP_ID', ''),
    'secret' => env('ALGOLIA_SECRET', ''),
    'index-settings' => [
        User::class => [
            'searchableAttributes' => ['id', 'name', 'email'],
            'attributesForFaceting' => ['filterOnly(email)'],
        ],
        Flight::class => [
            'searchableAttributes' => ['id', 'destination'],
        ],
    ],
],
use App\Models\User;
use App\Models\Flight;
// config/scout.php
'meilisearch' => [
'host' => env('MEILISEARCH_HOST', 'http://localhost:7700'),
'key' => env('MEILISEARCH_KEY', null),
'index-settings' => [
User::class => [
'filterableAttributes' => ['id', 'name', 'email'],
'sortableAttributes' => ['created_at'],
],
Flight::class => [
'filterableAttributes' => ['id', 'destination'],
'sortableAttributes' => ['updated_at'],
],
],
],若某个软删除模型的索引需要启用软删除分面,但没有其他索引设置,可以在该模型名下保留空设置项。保存配置后,用 php artisan scout:sync-index-settings 把设置同步到目标引擎;这会改变外部索引配置,应先确认环境和目标索引。Meilisearch 的比较运算依赖数据类型,价格等数字应转成 float、数值 ID 等按设计转成 int,不能指望数字字符串总是按数值比较。
Typesense 需要模型的 id 为字符串,created_at 为 Unix 时间戳,并在配置中定义字段 schema。软删除模型还需要 __soft_deleted 的 int32 字段。修改 schema 时,原文列出 scout:flush 后再 scout:import 的方式,也说明可用 Typesense API 改 schema;前一种会清空现有搜索数据,并非无损配置刷新。
Algolia 的 SCOUT_IDENTIFY=true 会把请求 IP 与已认证用户的主标识关联到搜索分析数据。启用之前应明确这项额外的数据发送,不应因为它只是一个环境开关就忽略隐私影响。
队列完成,不等于搜索结果已经可见
对 database 和 collection 以外的引擎,原文强烈建议配置队列,让模型同步在后台处理,以缩短 Web 请求等待时间。可以设置 'queue' => true,或指定连接与队列:
'queue' => [
    'connection' => 'redis',
    'queue' => 'scout',
],
php artisan queue:work redis --queue=scout这要求真实的队列后端和持续运行的 worker。即使把 Scout 的 queue 设为 false,Algolia、Meilisearch 等服务自身仍可能异步建立索引:Laravel 已完成提交,并不保证此刻搜索已经反映新记录。
对写入很频繁的应用,可在服务提供者中注册 MakeSearchableUniquely 和 RemoveFromSearchUniquely,分别通过 Scout::makeSearchableUsing() 与 Scout::removeFromSearchUsing() 启用唯一任务锁,减少同一模型重复排队。它解决的是队列去重,不是跨数据库与搜索服务的原子事务。
既有数据导入与后续维护
给已有应用接入外部引擎时,需要把历史记录放进索引:
php artisan scout:import "App\Models\Post"
# 或选择排队导入;这是另一种方式,不必重复执行两种
php artisan scout:queue-import "App\Models\Post" --chunk=500
批量导入可通过模型的 makeAllSearchableUsing(Builder $query) 调整查询,例如预加载作者关系。原文同时提醒:排队处理模型集合时,关系不一定会被恢复,因此不能只依赖导入查询时预加载;可通过 makeSearchableUsing(Collection $models) 在实际索引前准备集合,如 $models->load('author')。
模型常规 save() 或 create() 会触发索引维护。也可以在 Eloquent 查询、关系或已有集合上调用 searchable(),把目标记录分块加入索引。其语义接近 upsert:不存在则新增,已存在则更新。
默认每次模型更新都会重新索引。若只希望搜索相关字段改变时更新,可以定义 searchIndexShouldBeUpdated(): bool,结合 wasRecentlyCreated 和 wasChanged(['title', 'body']) 判断。若索引中还包含租户、权限或发布状态,这些字段也必须纳入更新条件;照抄只检查 title/body 的示例可能留下过期可见性。
删除模型通常会移除对应搜索记录;unsearchable() 只移除索引记录,不删除业务行;removeAllFromSearch() 和 scout:flush 则会批量清空模型索引。它们需要明确的目标、维护窗口和重建计划。本文不提供自动执行这些清空动作的脚本。
withoutSyncingToSearch() 可以让闭包里的模型操作暂时不触发同步,适合有计划的批处理,但结束后不会自动证明索引已重新一致。需要明确补同步策略。
只索引已发布内容,也仍要过滤查询
可以用 shouldBeSearchable() 表示模型实例在什么条件下应进入外部索引,例如仅当文章已发布时返回 true。但原文说明,直接对模型或集合调用 searchable() 会覆盖这一判断;不能把它当成无法绕过的授权防线。
database 引擎不应用 shouldBeSearchable(),因为数据本来就一直在数据库里;需要在查询中加入对应的 where 条件。外部索引也可能存在传播延迟,所以应用最终返回数据时仍应遵守当前的权限和可见性规则。
查询、过滤与分页
Post::search('关键词')->get() 返回 Eloquent 模型集合,raw() 返回引擎原始结果。对外部引擎,可用 within() 临时选择索引;这一功能不适合接受用户随意提供的索引名。
过滤支持基本相等和 =、!=、<、>、>=、<=,以及 whereIn()、whereNotIn()。下面是围绕多租户文章的编辑示例:$tenantId 必须由已验证的身份与租户授权上下文取得,不能直接信任请求参数。
$posts = Post::search($validatedQuery)
    ->where('tenant_id', $tenantId)
    ->where('status', 'published')
    ->paginate(15);
这里假定相关字段已经按引擎要求声明可过滤。生产接口还需限制查询长度、分页大小,并按应用策略校验最终输出字段和权限。原文直接从路由返回模型的示例用于说明序列化能力,不等同于完整的认证、授权与资源序列化实现。
query() 接受 Eloquent 查询回调,常用于加载关联。对外部引擎,它发生在引擎已经选出结果 ID 之后,不能拿它代替搜索端过滤,否则分页总量与返回行数可能不一致。数据库引擎则会把该回调约束直接施加到数据库查询,可用于过滤。
这一差异也解释了全局作用域问题:外部搜索引擎不知道 Eloquent 模型的全局作用域。分页时需要在 Scout 查询中明确重建租户、可见性等限制,而不是假定应用平时的全局作用域自动保护了索引结果。
paginate(15) 返回 LengthAwarePaginator,可以通过 Blade 输出分页链接,或作为 JSON 返回。数据库引擎还支持 simplePaginate(15),省去总数查询,只判断是否还有下一页。
软删除:保留索引与彻底删除不是一回事
将 config/scout.php 的 soft_delete 设为 true 时,Scout 不立即移除软删除记录,而是在索引中标记隐藏字段 __soft_deleted。需要查回收站时,可以使用 withTrashed() 或 onlyTrashed()。永久 forceDelete() 则会触发索引移除。
Algolia、Meilisearch 需要相应的软删除分面/过滤支持,Typesense 需要前文的 schema 字段。能够搜索到软删除记录,不代表普通用户有权读取它们;回收站检索通常还应受独立授权控制。
语义与混合搜索:先把模型、维数和引擎配置对齐
Laravel 13 当前文档将 database、Meilisearch、Typesense 与 Turbopuffer 列为支持语义搜索的引擎。Scout 为文本生成 embedding 时需要 Laravel AI SDK;Typesense、Turbopuffer 的原生 embedding 和预先计算的查询向量有各自路径,不必一概安装该 SDK。先在数据库列、引擎 schema、模型配置与 embedding 模型间统一维数,再调用搜索 API。
PostgreSQL database 引擎依赖 pgvector。向量列必须可空,因为模型保存后 Scout 才写入 embedding;混合搜索还需全文索引:
use Illuminate\Database\Schema\Blueprint;
use Illuminate\Support\Facades\Schema;

Schema::ensureVectorExtensionExists();

Schema::table('articles', function (Blueprint $table) {
    $table->vector('embedding', dimensions: 1536)->nullable();
    $table->vectorIndex('embedding');
    $table->fullText(['title', 'body']);
});
模型的 toSearchableEmbedding() 可返回要交给 Laravel AI SDK 嵌入的源文本,也可返回预计算向量数组;默认列名是 embedding,若使用别的列,可覆写 searchableEmbeddingColumn()。以下是源文本示意,具体模型与 provider 需在应用中配置:
public function toSearchableEmbedding(): string|array
{
    return $this->title.' '.$this->body;
}配置好引擎后,semantic() 用查询含义检索,支持的引擎可加最低相似度阈值;hybrid() 合并文本与语义结果,两个权重控制两路结果的相对比重:
$semantic = Article::search('夏季保持室内凉爽的方法')
    ->semantic(minSimilarity: 0.6)
    ->get();

$hybrid = Article::search('可再生能源储能')
    ->hybrid(textWeight: 1, semanticWeight: 2)
    ->get();
minSimilarity 是否受当前驱动支持取决于所选引擎。它不是授权过滤或准确率承诺。
Meilisearch:用户提供向量与原生 embedding 是两种配置
使用用户提供的向量时,在 config/scout.php 同时配置索引 embedder 与模型 embedding;维数必须一致。改变设置后运行 php artisan scout:sync-index-settings 才会通知 Meilisearch:
'meilisearch' => [
    'index-settings' => [
        App\Models\Article::class => [
            'embedders' => [
                'default' => [
                    'source' => 'userProvided',
                    'dimensions' => 1536,
                ],
            ],
        ],
    ],
    'model-settings' => [
        App\Models\Article::class => [
            'embedding' => [
                'embedder' => 'default',
                'dimensions' => 1536,
            ],
        ],
    ],
],
toSearchableEmbedding() 返回源文本时由 Scout/Laravel AI SDK 生成向量;返回数组则由应用提供预计算向量。另一条路径是让 Meilisearch 自己生成文档及查询向量。此时 embedder 可写成:
// config/scout.php
'meilisearch' => [
    'host' => env('MEILISEARCH_HOST', 'http://localhost:7700'),
    'key' => env('MEILISEARCH_KEY', null),
    'index-settings' => [
        App\Models\Article::class => [
            'embedders' => [
                'default' => [
                    'source' => 'openAi',
                    'apiKey' => env('OPENAI_API_KEY'),
                    'model' => 'text-embedding-3-small',
                    'documentTemplate' => 'An article titled {{ doc.title }}: {{ doc.body }}',
                ],
            ],
        ],
    ],
    'model-settings' => [
        App\Models\Article::class => [
            'embedding' => [
                'embedder' => 'default',
                'driver' => 'meilisearch',
            ],
        ],
    ],
],
这里的 API key 只能从受控 secret 注入,不能把真实值写入配置库。使用 Meilisearch 原生 embedding 时,不需要 dimensions 设置或模型的 toSearchableEmbedding();Scout 也不会再替文档生成并写入向量,但搜索调用仍可显式传入预计算查询向量。索引设置同步会改变目标服务,先核实环境与索引名称。
Typesense:collection schema 必须定义向量字段
Typesense 的模型 schema 指明向量字段类型与维度,embedding 配置再映射到相同字段。以下按原文用 title 做关键词检索,并设置 1,536 维示例:
'model-settings' => [
    App\Models\Article::class => [
        'collection-schema' => [
            'fields' => [
                ['name' => 'title', 'type' => 'string'],
                ['name' => 'embedding', 'type' => 'float[]', 'num_dim' => 1536],
            ],
        ],
        'search-parameters' => ['query_by' => 'title'],
        'embedding' => [
            'attribute' => 'embedding',
            'dimensions' => 1536,
        ],
    ],
],
默认由 Scout/Laravel AI SDK 根据 toSearchableEmbedding(): string|array 生成向量;也可返回预先计算好的数组。schema 变更可能需要重建 collection;原文提供 scout:flush 后 scout:import 的做法会删除现有索引记录。只有做好备份、重建计划并锁定目标 collection 后才能考虑,本文没有执行这些命令。Typesense 的 id 应为字符串,created_at 应为 Unix 时间戳,必须连同向量配置一起保留。
Turbopuffer:权重、字段 schema 与向量 schema 要同时声明
以下是用 Laravel AI SDK 生成向量的完整模型配置骨架。搜索字段数字是相对 BM25 权重,示例中标题权重为正文的三倍:
'turbopuffer' => [
    'model-settings' => [
        App\Models\Article::class => [
            'searchable-attributes' => [
                'title' => 3,
                'body' => 1,
            ],
            'embedding' => [
                'attribute' => 'embedding',
                'dimensions' => 1536,
            ],
            'schema' => [
                'title' => ['type' => 'string', 'full_text_search' => true],
                'body' => ['type' => 'string', 'full_text_search' => true],
                'embedding' => ['type' => '[1536]f32', 'ann' => true],
            ],
        ],
    ],
],
该路径的 toSearchableEmbedding() 返回源文本或预计算向量。Turbopuffer 也可使用其原生 embedding,无需 Laravel AI SDK 和该模型方法,但源属性必须出现在 toSearchableArray() 输出中:
'embedding' => [
    'driver' => 'turbopuffer',
    'attribute' => 'embedding_text',
],
'schema' => [
    'embedding_text' => [
        'type' => 'string',
        'embed' => [
            'model' => 'voyage/voyage-4',
            'dimensions' => 1024,
            'attribute' => 'embedding',
        ],
    ],
],
模型、维数与提供方必须彼此匹配。1,536 和 1,024 是原文不同配置实例的示范,不可交叉复制。生成 embedding 可能把正文发送给模型提供方并产生费用;API key、数据驻留、保留策略和调用授权必须另行审查。本文仅核对配置结构,没有连接 embedding 服务。
更深定制:保持引擎特有行为可见
Typesense 可通过 options() 设置 query_by 等参数。search() 的第二个参数可接受回调,让开发者在发送前定制原生查询。这里应以所装 SDK 的真实接口为准。
静态审核发现:当前源页“Customizing Engine Searches”例子一边使用 Algolia 的 SearchIndex,一边构造 body.query.bool.filter.geo_distance 形式的选项。这段结构不能仅凭文档出现就推定适用于当前 Algolia SDK。本稿保留扩展机制说明,不转抄该地理查询为可用配方,也未对它做执行测试。
若内置驱动都不合适,可以继承 Laravel\Scout\Engines\Engine 实现自定义引擎。Laravel 13 原页要求实现以下八个操作;表中的说明是接口职责释义,具体 API 调用与异常处理由适配器实现:
| 方法 | 需要落实的行为 |
|---|---|
update($models) |
把给定模型写入或更新后端索引。 |
delete($models) |
从后端删除这些模型对应的索引记录。 |
search(Builder $builder) |
把 Scout Builder 的查询文字、过滤条件和选项转换为后端搜索请求。 |
paginate(Builder $builder, $perPage, $page) |
以指定页码和每页条数执行查询。 |
mapIds($results) |
从后端响应抽取模型标识。 |
map(Builder $builder, $results, $model) |
把后端结果映射回 Eloquent 模型,维护需要的结果次序和查询语义。 |
getTotalCount($results) |
返回分页器使用的匹配总数。 |
flush($model) |
清空该模型对应的整份索引,是会删除数据的管理操作。 |
原页建议参照 AlgoliaEngine 了解这些方法如何协作。实际实现应将后端错误、超时、部分成功、批次大小、排序和过滤支持映射到 Scout 语义;若外部索引返回 ID 后再从数据库取模型,也要处理记录删除、租户边界和权限变更。
实现后,在应用服务提供者的 boot() 中经服务容器解析 EngineManager 并调用 extend() 注册。以下是注册骨架,类名应改成真实实现;本文没有伪造一个可工作的后端适配器:
use App\ScoutExtensions\RemoteSearchEngine;
use Laravel\Scout\EngineManager;

public function boot(): void
{
    resolve(EngineManager::class)->extend('remote_search', function () {
        return new RemoteSearchEngine;
    });
}
注册后,可在 config/scout.php 将默认 driver 设为 remote_search;也可以在特定模型的 searchableUsing() 返回 Scout::engine('remote_search')。这只完成引擎选择与注册,仍须补齐上表全部方法和后端配置,再于隔离项目中验证。
Scout 提供的是统一入口,不会替应用决定哪些数据允许索引、哪些用户可以看、何时算真正同步完成。先把这些边界写清,再选择驱动与队列,才能让搜索功能在数据量和业务规则增长后仍然可控。










暂无评论内容