


Valkey 小对象编码与内存建模
原文作者:Valkey 文档贡献者。中文翻译及编辑整理:未完纪。来源:Valkey《Memory optimization》(文档源文件)。本文补充 Valkey 9.0 起的 Hash 字段过期能力、修正编号分桶示例的说明,并细化 maxmemory 的边界。文中配置阈值是官方文档列出的 Valkey 7.2 默认值,不代表所有版本的默认配置。来源文档版权 © Valkey contributors,按 CC BY-SA 4.0 许可;本文改编版亦按 CC BY-SA 4.0 发布。许可条款。
为什么小型聚合类型可以更省内存
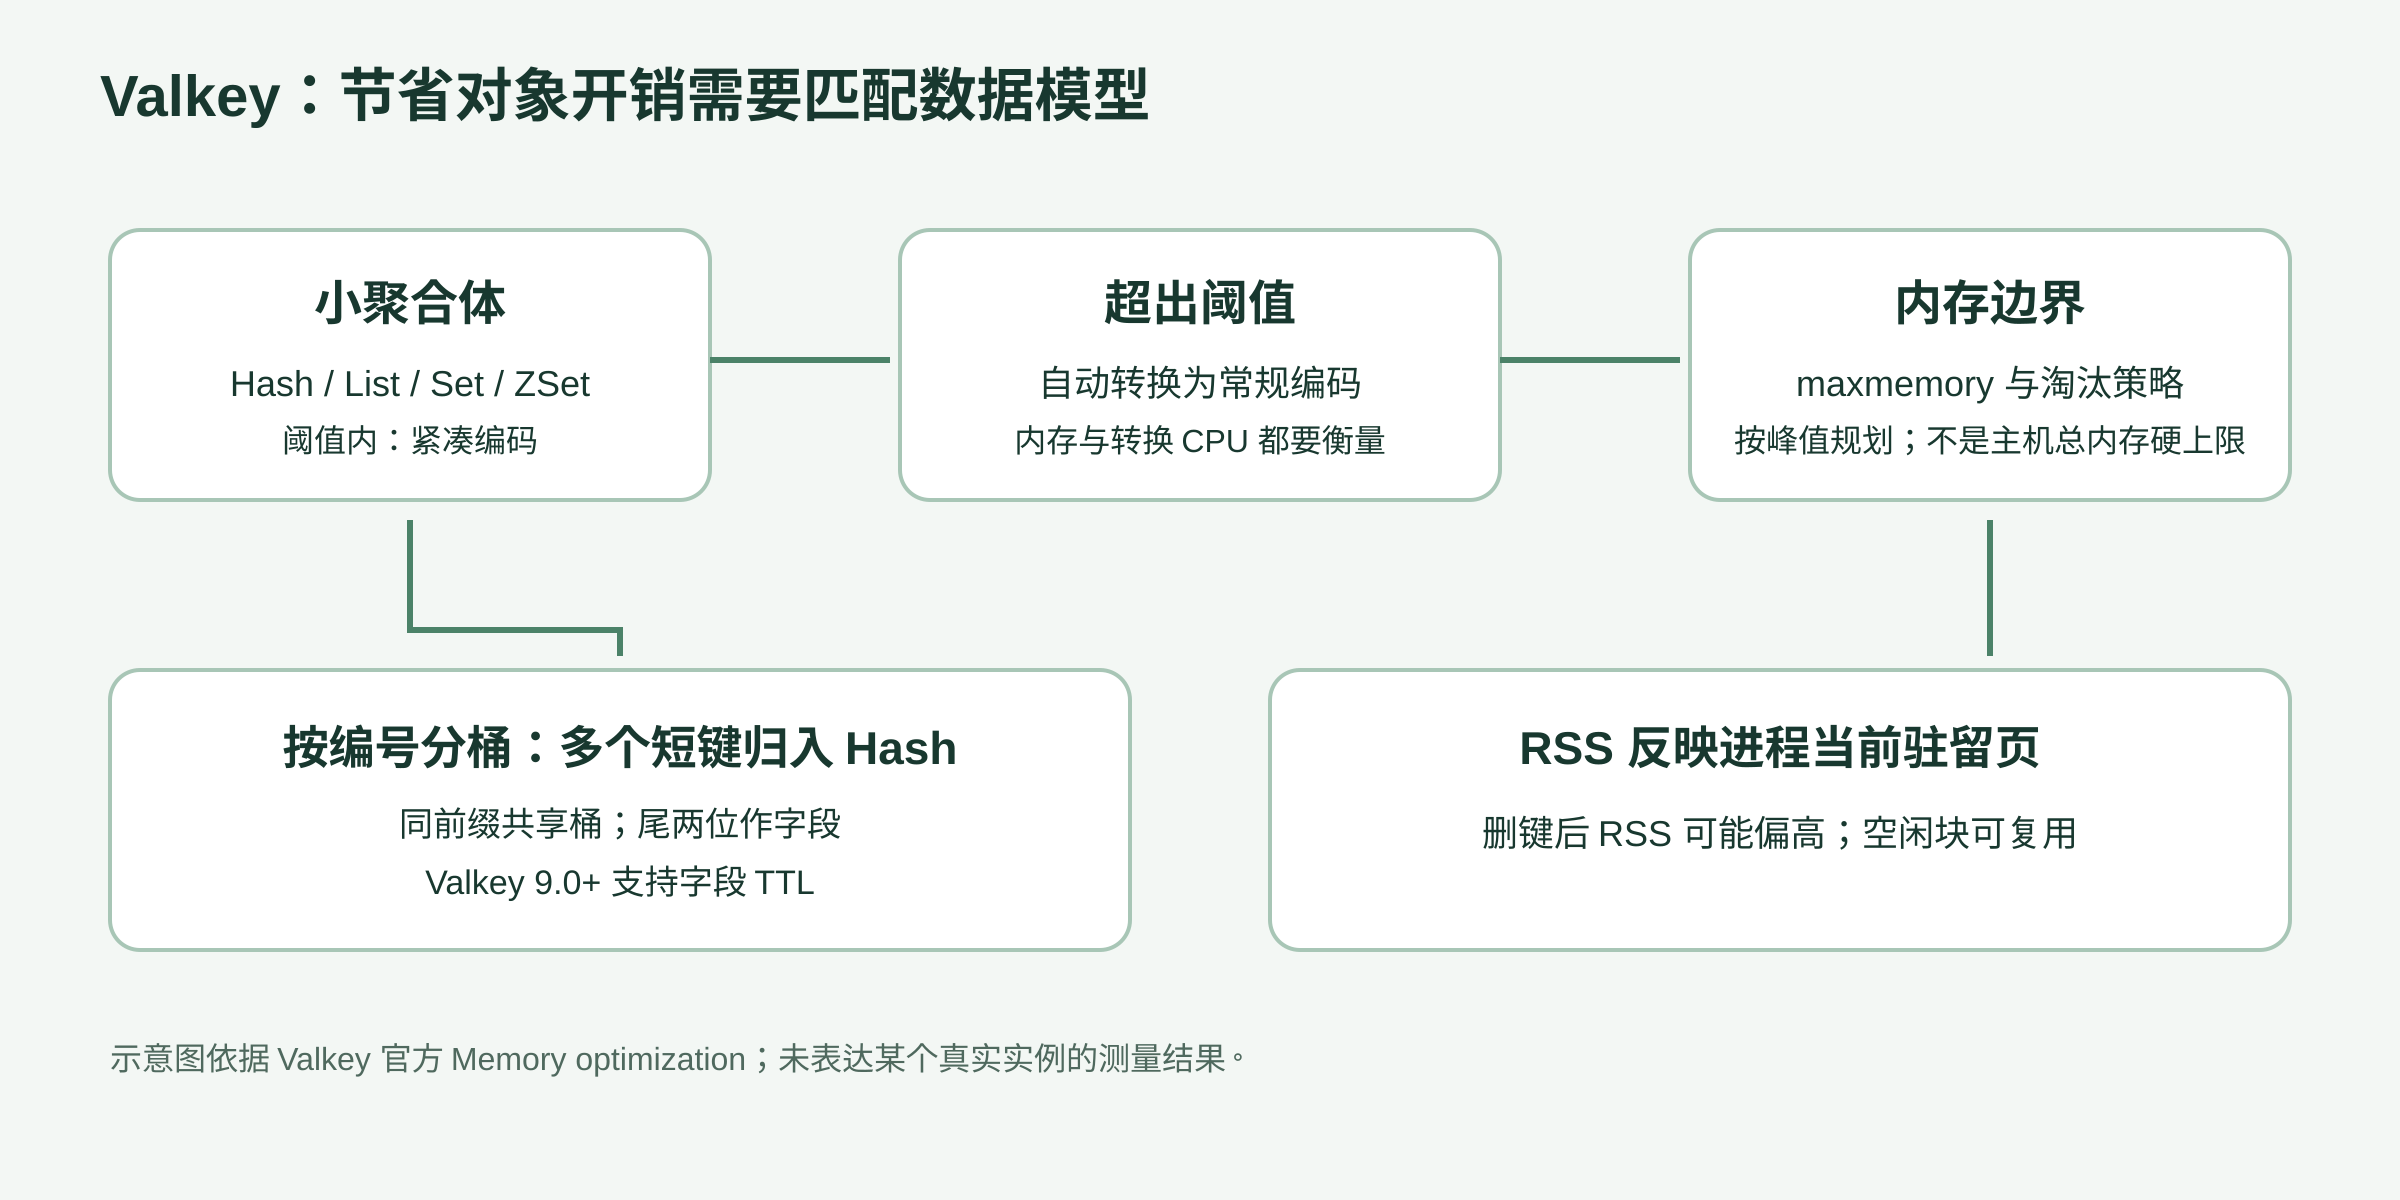
Hash、List、只包含整数的 Set,以及 Sorted Set,在元素数目较少、元素又未超过限制时,可以采用紧凑的内部编码。对用户和命令 API 来说转换通常是透明的,但这是一种 CPU 时间换内存的选择。文档称在特定数据上可节省至多约 10 倍,平均约 5 倍;这不是对每种键和值的保证。
文档列出一组 Valkey 7.2 配置示例:
hash-max-listpack-entries 512
hash-max-listpack-value 64
zset-max-listpack-entries 128
zset-max-listpack-value 64
set-max-intset-entries 512
set-max-listpack-entries 128
set-max-listpack-value 64
其中一部分阈值分别控制元素数量和单个值的最大字节长度;名称中有 intset 的集合设置针对整数集合。数据超出紧凑编码所能容纳的限制后,Valkey 会转换为常规编码。小聚合体的转换很快,但把阈值调得很大时,单次转换可能变得更重。应针对实际数据分布测量命令延迟和内存占用,而不是盲目调高数字。特别留意线上配置的版本和命名:不同 Valkey 版本可能调整了设置和默认值。
32 位实例:每个指针更小,地址空间也更小
把 Valkey 编译为 32 位目标可以缩小指针,从而减少每个键等对象的部分开销。官方 Memory optimization 页把其内存上限概括为 4 GB;Key eviction 文档同时指出,32 位系统的隐式 maxmemory 默认值为 3 GB。实际可用量受操作系统和进程地址空间布局影响,可能更低。该页给出的构建方式是:
make 32bit文档称 RDB 与 AOF 文件在 32 位和 64 位实例之间兼容,也能跨大小端环境切换。即便文件格式兼容,生产迁移仍应检查目标版本、模块和平台行为,并先备份及验证恢复路径。32 位上限使这种方案不适合仅因“少几个字节”就用于大容量服务。
用位与字节运算表达密集状态
Valkey 的 String 类型支持 GETRANGE、SETRANGE、GETBIT 与 SETBIT。把字符串当作随机访问数组,可以把布尔状态压成位图。例如按递增整数 ID 标识用户时,可用某一位表示是否订阅邮件列表。
原文把 1 亿个用户的单个位图概算为 12 MB;按十进制单位计算,1 亿个位约为 12.5 MB(约 11.9 MiB),还未计入字符串、键及对象管理开销。若每个用户需要一个字节,也可按偏移使用 GETRANGE 和 SETRANGE,但原始状态数据约为位图的 8 倍。这类模型适合密集、固定映射的状态;若 ID 稀疏、需要复杂字段语义,或要逐用户设置过期,位图未必合适。
把同一对象的字段放进 Hash
Web 用户对象若把姓名、姓氏、邮箱、密码等分别存成顶层键,会重复承担键与对象的固定开销。字段关联紧密、单个对象不大时,可以把它们放到同一个 Hash 中。Valkey 的小 Hash 可使用紧凑表示,多个字段共同摊薄顶层键开销。
紧凑 Hash 可采用长度前缀的线性序列存储字段和值,查找一个字段在紧凑阶段是 O(N),而不是哈希表的平均 O(1)。由于 N 受到较小阈值限制,文档把整个生命周期的摊销操作描述为 O(1):元素增多到超出配置限制时,内部编码会转换为常规哈希表。连续数组也更容易利用 CPU 缓存局部性。
Hash 字段和值是字符串。旧版 Valkey 不能给单个字段设置过期时间;Valkey 9.0 起可用 HEXPIRE 等命令为 Hash 字段设置 TTL,见 HEXPIRE 命令说明。字段过期能力及其内存开销会随版本和实现变化,需核对目标实例。即使字段支持独立过期,Hash 仍只有一个顶层键:按键执行的淘汰策略会以整张 Hash 为单位,分桶也会改变顶层 TTL 与淘汰粒度。应按访问、过期和淘汰需求选择模型。
把许多短键分桶到 Hash
文档进一步示范:若缓存内容都是短字符串、键以编号结尾,可把原来的独立键拆成“桶键”和“字段名”。以 object:1234 为例,保留末两位作字段名,则桶键为 object:12,字段名为 34:
HSET object:12 34 somevalue对于至少两位数的编号,同一前缀下的编号会进入同一个桶,字段名则是末两位;例如 object:1234 变成桶键 object:12、字段 34。编号连续且后缀覆盖 00 至 99 时,每桶约有 100 个字段。这个例子不是按编号末两位分片,而是按末两位之前的共同前缀分组。编号不足两位时,示例把 object: 用作桶键,并以完整数字作字段,因此 object:2 和 object:10 是两个字段。
这是特定键空间的建模技巧,不是 Valkey 自动提供的普通键语义。Valkey 9.0 起可用 HEXPIRE 为字段设置过期时间;仍需考虑按键执行的淘汰策略、顶层键 TTL、热点前缀、写入并发与桶增长。任何 Hash 超过元素数或元素大小限制后都会转换为常规编码,原有内存优势可能减弱或消失。
读懂数据集内存、RSS 与峰值
maxmemory 是 Valkey 数据集内存的驱逐阈值,不是进程或主机总内存的硬上限;Valkey 自身还有管理开销,复制和 AOF 缓冲区等部分内存也不计入驱逐阈值。大型命令执行期间,内存可能暂时明显越过该阈值。详见 Valkey Key eviction 文档。规划时要为复制、持久化、客户端缓冲区、模块、系统和其他进程预留余量,并同时观察进程与主机内存。文档强调,删除键不意味着底层分配器会立刻把对应页面归还操作系统。示例:曾装入 5 GB 数据,再删除约 2 GB 后,Valkey 记账可能显示 3 GB,而进程 RSS 仍接近 5 GB。
物理页之所以暂时保留,是因为同一内存页仍有其他对象占用,分配器不一定能把整个页面释放。后续写入可以复用已释放的块,所以 RSS 可能维持稳定而不继续增长。容量规划要看工作负载峰值:偶尔达到 10 GB 的数据集不能只按通常 5 GB 预算。
RSS 是进程当前驻留在物理内存中的页数,不等于当前键数据量,也不是不可降低的固定高水位。碎片率近似为 RSS 与 Valkey 当前记账内存之比;当已删除许多键而 RSS 仍偏高时,比值会升高,这不必然表示刚发生了新的碎片或内存泄漏。Valkey 可使用 jemalloc、libc 或其他分配器,具体取决于平台和构建;官方资料说明 Linux 通常默认 jemalloc,而 ARM 构建默认使用 libc。可查看 INFO MEMORY 输出中的 mem_allocator 字段。应结合 RSS、已用内存、峰值、分配器统计、复制缓冲区和主机可用内存判断。
设置内存上限与淘汰策略
在 64 位系统上,未设置 maxmemory 时默认不限制数据集内存,Valkey 会继续按需申请,可能耗尽主机余量。32 位系统的文档默认隐式上限是 3 GB。应按数据、复制、持久化、客户端缓冲区、进程外开销和操作系统需求规划限制。配置 maxmemory-policy noeviction 后,达到阈值时需要更多内存的写命令会返回 OOM 错误;应用必须处理失败。
noeviction 把数据集增长时的淘汰行为变成写入错误,但不保证进程或主机不会因其他内存开销而耗尽资源。缓存业务需在合适的淘汰策略与关键业务数据之间做选择。配置策略前要明确数据可丢弃性、故障行为与客户端重试,并核对目标版本的实际默认配置。










暂无评论内容