


结构化输出:用 JSON Schema 约束模型响应
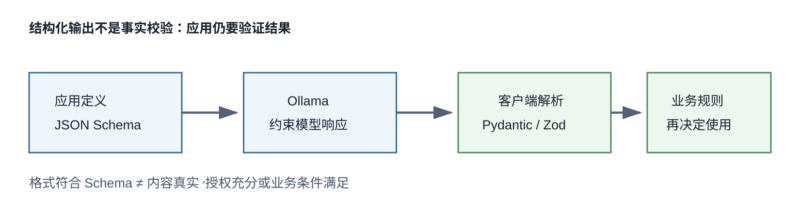
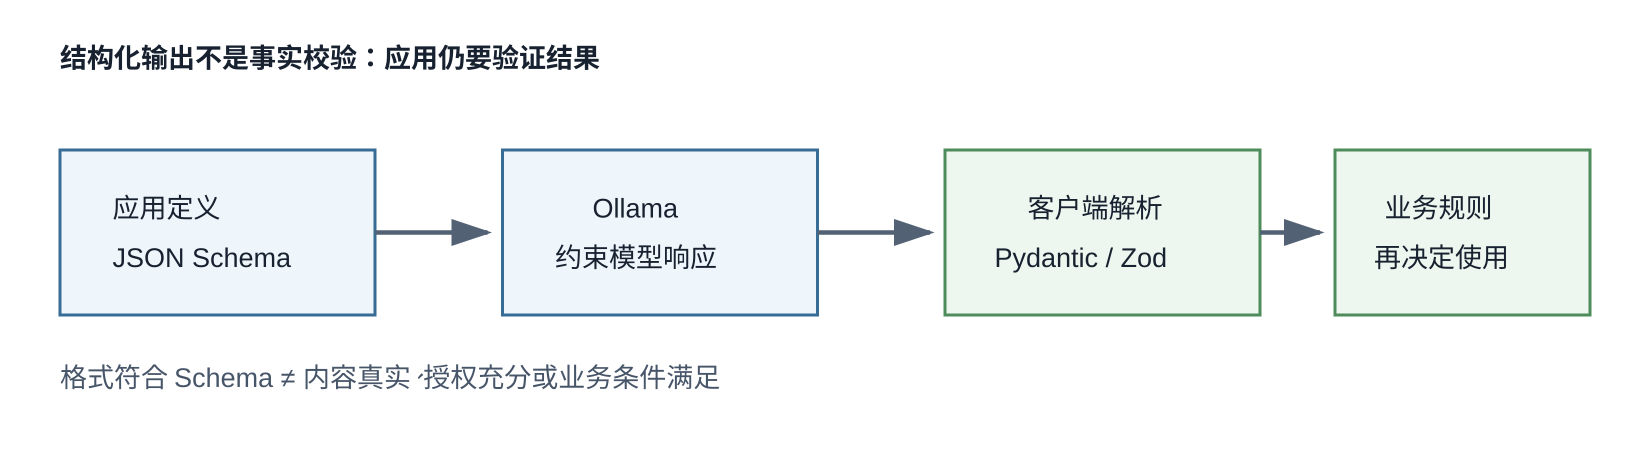
Ollama 的结构化输出功能允许调用方把 JSON Schema 传给模型,约束响应的字段、类型与必填项。它可用于文档抽取、图像描述和统一下游接口格式。模式约束能减少格式不一致,却不能证明模型给出的内容真实;应用仍需做类型、业务和来源核验。
准备客户端并定义 Schema
原文发表于 2024 年 12 月 6 日,介绍当时 Ollama 的 Python 与 JavaScript 客户端支持。文中建议先将 Ollama 更新到较新版本,并升级相应客户端库。升级会改变当前环境中的依赖;实际操作前应查看当前兼容要求,并优先在隔离环境和锁文件约束下进行。以下安装命令只作原文示例,本稿未运行。
python -m pip install -U ollama
npm install ollama
请求中的 format 字段可以直接接收 JSON Schema,也可以由 Pydantic 或 Zod 类型生成 Schema,再在客户端解析响应。下面的对象要求模型返回国家名称、首都和语言列表:
{
  "type": "object",
  "properties": {
    "name": { "type": "string" },
    "capital": { "type": "string" },
    "languages": {
      "type": "array",
      "items": { "type": "string" }
    }
  },
  "required": ["name", "capital", "languages"]
}
通过 HTTP API 传入 Schema
HTTP 示例把模型、用户消息、非流式响应设置和 Schema 放进同一个请求。服务默认监听本机 11434 端口;Schema 描述的是返回格式,不是请求者身份或访问权限。
curl -X POST http://localhost:11434/api/chat \
  -H 'Content-Type: application/json' \
  -d '{
    "model": "llama3.1",
    "messages": [
      {"role": "user", "content": "介绍加拿大。"}
    ],
    "stream": false,
    "format": {
      "type": "object",
      "properties": {
        "name": {"type": "string"},
        "capital": {"type": "string"},
        "languages": {
          "type": "array",
          "items": {"type": "string"}
        }
      },
      "required": ["name", "capital", "languages"]
    }
  }'
原文展示的响应包含加拿大名称、渥太华首都,以及英语和法语两项语言。字段顺序可以不同,只要数据满足 Schema。
{
  "capital": "Ottawa",
  "languages": [
    "English",
    "French"
  ],
  "name": "Canada"
}
localhost 只表示示例目标在本机;不要把未经鉴权的推理服务端口暴露给不可信网络。若服务需要网络访问,应另行设计访问控制、防火墙和传输保护。
Python:用 Pydantic 描述并验证
Python 客户端可把字典形式的 Schema 传给 format,也可用 Pydantic 定义数据类型并调用 model_json_schema()。收到响应后,再用同一类型解析 JSON:
from ollama import chat
from pydantic import BaseModel

class Country(BaseModel):
    name: str
    capital: str
    languages: list[str]

response = chat(
    messages=[
        {
            "role": "user",
            "content": "介绍加拿大。"
        }
    ],
    model="llama3.1",
    format=Country.model_json_schema(),
)

country = Country.model_validate_json(response.message.content)
print(country)
原文所示输出是已解析的类型化对象;这是原文中的演示输出,不是本稿执行所得:
name='Canada' capital='Ottawa' languages=['English', 'French']从文本抽取记录时,也可以建模嵌套列表。下例要求模型从用户描述中整理两只猫的信息:
from ollama import chat
from pydantic import BaseModel

class Pet(BaseModel):
    name: str
    animal: str
    age: int
    color: str | None
    favorite_toy: str | None

class PetList(BaseModel):
    pets: list[Pet]

response = chat(
    messages=[
        {
            "role": "user",
            "content": """
                I have two pets.
                A cat named Luna who is 5 years old and loves playing with yarn. She has grey fur.
                I also have a 2 year old black cat named Loki who loves tennis balls.
            """
        }
    ],
    model="llama3.1",
    format=PetList.model_json_schema(),
)

pets = PetList.model_validate_json(response.message.content)
print(pets)
原文给出的预期输出如下。实际结果仍应与输入文本逐项比对;缺失字段、空值与可选字段的业务含义需要在数据模型和应用规则中明确。
pets=[
  Pet(name='Luna', animal='cat', age=5, color='grey', favorite_toy='yarn'),
  Pet(name='Loki', animal='cat', age=2, color='black', favorite_toy='tennis balls')
]
JavaScript:用 Zod 生成 Schema
原文使用 Ollama JavaScript 库、Zod 和 zod-to-json-schema。先定义对象结构,再把它转换为 JSON Schema;对返回的字符串执行 JSON 解析和 Zod 验证:
import ollama from 'ollama';
import { z } from 'zod';
import { zodToJsonSchema } from 'zod-to-json-schema';

const Country = z.object({
  name: z.string(),
  capital: z.string(),
  languages: z.array(z.string()),
});

const response = await ollama.chat({
  model: 'llama3.1',
  messages: [{ role: 'user', content: '介绍加拿大。' }],
  format: zodToJsonSchema(Country),
});

const country = Country.parse(JSON.parse(response.message.content));
console.log(country);
原文展示的对象具有同样三项字段:
{
  name: "Canada",
  capital: "Ottawa",
  languages: [ "English", "French" ],
}
这段客户端写法属于原文 2024 年示例。截至 2026 年 10 月 8 日,Ollama 当前官方文档改用 z.toJSONSchema() 的示例;采用哪种转换函数取决于安装的库版本,使用前应核对当前文档与类型定义。
图像描述:限定视觉结果字段
结构化输出也可配合视觉模型。原文示例把图像描述拆成摘要、对象列表、场景、颜色、时段、室内外设置及可选文本;时段与场景使用枚举值,对象记录含名称、置信度和属性。path/to/image.jpg 是占位路径,不是可直接读取的图片:
from ollama import chat
from pydantic import BaseModel
from typing import List, Optional, Literal

class Object(BaseModel):
    name: str
    confidence: float
    attributes: str

class ImageDescription(BaseModel):
    summary: str
    objects: List[Object]
    scene: str
    colors: List[str]
    time_of_day: Literal['Morning', 'Afternoon', 'Evening', 'Night']
    setting: Literal['Indoor', 'Outdoor', 'Unknown']
    text_content: Optional[str] = None

path = 'path/to/image.jpg'

response = chat(
    model='llama3.2-vision',
    format=ImageDescription.model_json_schema(),
    messages=[
        {
            'role': 'user',
            'content': 'Analyze this image and describe what you see, including any objects, the scene, colors and any text you can detect.',
            'images': [path],
        },
    ],
    options={'temperature': 0},
)

image_description = ImageDescription.model_validate_json(response.message.content)
print(image_description)
原文示例输出描述了一张海滩照片。下方仅转录其字段结果,没有附上原文图片,也没有声称重新识别或验证照片内容:
summary='A palm tree on a sandy beach with blue water and sky.'
objects=[
  Object(name='tree', confidence=0.9, attributes='palm tree'),
  Object(name='beach', confidence=1.0, attributes='sand')
],
scene='beach',
colors=['blue', 'green', 'white'],
time_of_day='Afternoon'
setting='Outdoor'
text_content=None
模型返回的置信度是模型输出字段,不应当作经校准的概率。真实应用还应限制进程可读取的路径和文件类型,并评估图像上传中个人信息的处理边界。格式完整并不代表图像识别正确。
通过 OpenAI 兼容接口调用
原文还演示用 OpenAI Python SDK 的解析接口接入 Ollama 兼容端点,以 Pydantic 类型作为响应格式,并分别处理正常解析、拒答和长度限制错误:
from openai import OpenAI
import openai
from pydantic import BaseModel

client = OpenAI(
    base_url="http://localhost:11434/v1",
    api_key="ollama",
)

class Pet(BaseModel):
    name: str
    animal: str
    age: int
    color: str | None
    favorite_toy: str | None

class PetList(BaseModel):
    pets: list[Pet]

try:
    completion = client.beta.chat.completions.parse(
        temperature=0,
        model="llama3.1:8b",
        messages=[
            {
                "role": "user",
                "content": """
                    I have two pets.
                    A cat named Luna who is 5 years old and loves playing with yarn. She has grey fur.
                    I also have a 2 year old black cat named Loki who loves tennis balls.
                """
            }
        ],
        response_format=PetList,
    )

    pet_response = completion.choices[0].message
    if pet_response.parsed:
        print(pet_response.parsed)
    elif pet_response.refusal:
        print(pet_response.refusal)
except Exception as e:
    if type(e) == openai.LengthFinishReasonError:
        print("Too many tokens: ", e)
        pass
    else:
        print(e)
        pass
原文的 api_key="ollama" 是供本机兼容客户端填写的占位参数,不是可复用密钥,也不能证明端点已经鉴权。服务一旦可从网络访问,就应设计并核实实际的访问控制与传输保护。SDK 的兼容接口和模型名称会演进;此处示例未测试。
提高结构化输出的可靠性
- 用 Pydantic(Python)或 Zod(JavaScript)定义和复用响应 Schema,并在客户端解析校验。
- 在提示中补充“以 JSON 返回”,帮助模型理解预期格式。
- 把温度设为 0 可以让输出更确定一些,但不保证事实准确,也不保证不同运行逐字相同。
- 解析成功后仍执行领域规则、权限检查和来源核对;不要将模型生成的字段直接作为可信决策输入。
原文把结构化输出描述为比 JSON mode 更可靠、更加一致的格式约束;这属于原文的产品说明,不是此稿独立测得的比较结论。原文还列出控制 logits、提升性能与准确性、GPU 采样加速以及扩展 JSON Schema 以外格式等后续方向。它们是 2024 年文章发布时的展望,不代表当前路线图。
版本边界:本文中的代码和模型名保留自 2024 年 12 月的原文,未对当前版本作适配或执行。截至 2026 年 10 月 8 日,Ollama 当前官方文档称 Ollama Cloud 当前不支持结构化输出,并使用不同的模型和客户端示例。请按实际部署方式、模型和库版本核对功能支持,尤其不要由本地示例推断云端能力。










暂无评论内容