


向量搜索过滤:在相关性、结果数量和延迟之间做取舍
精确搜索与近似搜索对过滤的反应不同。理解前置过滤、后置过滤及文档级权限过滤,才能正确解释 HNSW 的遍历成本和返回结果。
语义相似还不够
电商检索可以找到外观或语义相似的商品,但用户还会限定价格、品牌、库存或评分。向量距离解决“像不像”,过滤条件解决“是否符合要求”。只有两者一起工作,结果才真正可用。
这也意味着不能只测一次不带条件的近邻检索,就推断业务查询的延迟。过滤位置、选择性和索引类型都会改变工作量。
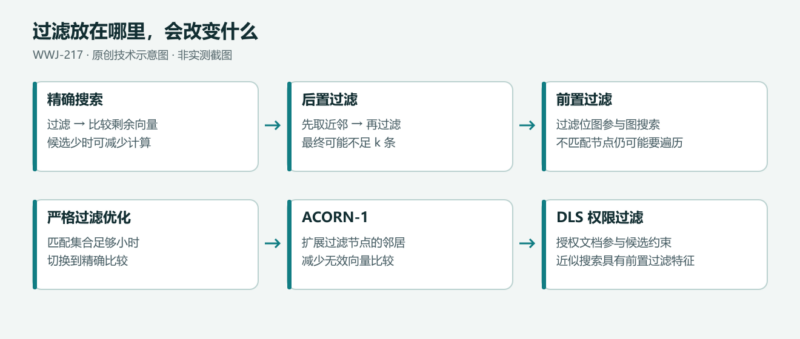
精确向量搜索:先减少需要比较的文档
原文介绍两种精确搜索路径:把 dense_vector 字段的索引类型设为 flat,使 kNN 采用精确搜索;或者使用 script_score 中的向量函数计算分数,后者可配合不同索引类型。
精确搜索会比较候选中的每一个向量。先过滤掉不需要的文档,就能减少距离计算,而不会遗漏过滤后集合中的近邻。条件越严格,剩余向量越少,精确搜索有时反而比近似搜索更合适。
作者给出的经验值是:过滤后少于约一万条文档时考虑精确搜索;BBQ 比较更快,可在少于约十万条时考虑。这里是文章中的经验界线,并不是 API 承诺,也不应覆盖硬件、维度、量化方式与版本差异。如果查询长期都高度受限,建索引时就可以评估 flat 类型,而不一定总选 HNSW。
近似搜索:过滤信息不在同一套结构里
HNSW 等近似检索结构,通过减少昂贵的向量比较,在大规模数据中寻找近邻。价格、类别或权限等属性,则可能存储在词典、倒排表和 doc values 等其他索引结构中。
因此,系统需要把普通过滤条件的结果与向量图搜索结合。最直观的选择有两个:先找近邻再过滤,或把过滤信息提前交给向量搜索。
后置过滤:检索过程不变,结果可能不够
后置过滤先取相似度最高的 k 个候选,再删除不满足条件的结果。好处是向量搜索过程不用知道过滤条件;代价是最后可能不足 k 条。把 k 调大能增加机会,但仍不能保证有足够结果。
下面保留原文的 knn 查询示例。注意 filter 是 bool 的成员,而不在 knn 内:
{
  "query": {
    "bool": {
      "must": {
        "knn": {
          "field": "image-vector",
          "query_vector": [54, 10, -2],
          "k": 5,
          "num_candidates": 50
        }
      },
      "filter": {
        "term": {"file-type": "png"}
      }
    }
  }
}
使用顶层 knn 搜索时,原文要求用显式的 post_filter:
{
  "knn": {
    "field": "image-vector",
    "query_vector": [54, 10, 2],
    "k": 5,
    "num_candidates": 50
  },
  "post_filter": {
    "term": {"file-type": "png"}
  }
}
不能把一个普通查询或过滤随意并列在顶层,然后认为它必然起到后置过滤作用。原文提醒,kNN 结果可能与其他查询组合,语义与显式后置过滤不同。
前置过滤:知道哪些结果有效,不代表只走有效节点
前置过滤先确定满足条件的文档,Lucene 用 BitSet 保存这组文档。HNSW 搜索在准备把候选放入结果集时,检查它是否属于有效集合。
但是,不匹配条件的节点仍可能需要探索和计算距离。因为它可能连接着最终要找的邻居,直接停止探索会破坏图上的可达路径。作者把它比作开车去加油站:没有加油站的道路仍可能是到达目的地的必经之路。
在原文描述的普通遍历中,前置过滤需要访问节点、检查资格,并丢弃无效候选,为凑够合格结果可能做更多工作。因此,“加过滤就一定更快”不适用于这类近似搜索。
顶层 kNN 的前置过滤写在 knn.filter 内:
{
  "knn": {
    "field": "image-vector",
    "query_vector": [54, 10, -2],
    "k": 5,
    "num_candidates": 50,
    "filter": {
      "term": {"file-type": "png"}
    }
  }
}
查询形式也支持内嵌过滤:
{
  "query": {
    "knn": {
      "field": "image-vector",
      "query_vector": [-5, 9, -12],
      "k": 5,
      "filter": {
        "term": {"file-type": "png"}
      }
    }
  }
}
这些是 DSL 结构示例,不包含建索引与数据准备。真实字段的向量维度、相似度及映射必须匹配;示例的三维向量不能直接查询任意高维 embedding 字段。
两类前置过滤优化
第一类优化是及时转向精确搜索。如果过滤后只剩很少的向量,与其在图中绕行,不如把剩余向量全部比较。原文说明 Lucene 与 Elasticsearch 会自动采用这种优化。
第二类是 ACORN-1。它减少对不满足条件的向量本身进行比较,同时进一步探索相关邻接关系,避免简单跳过节点造成路径中断。关键在于改变探索方式,而不是假设可以安全删除所有不匹配节点后继续按原算法行走。
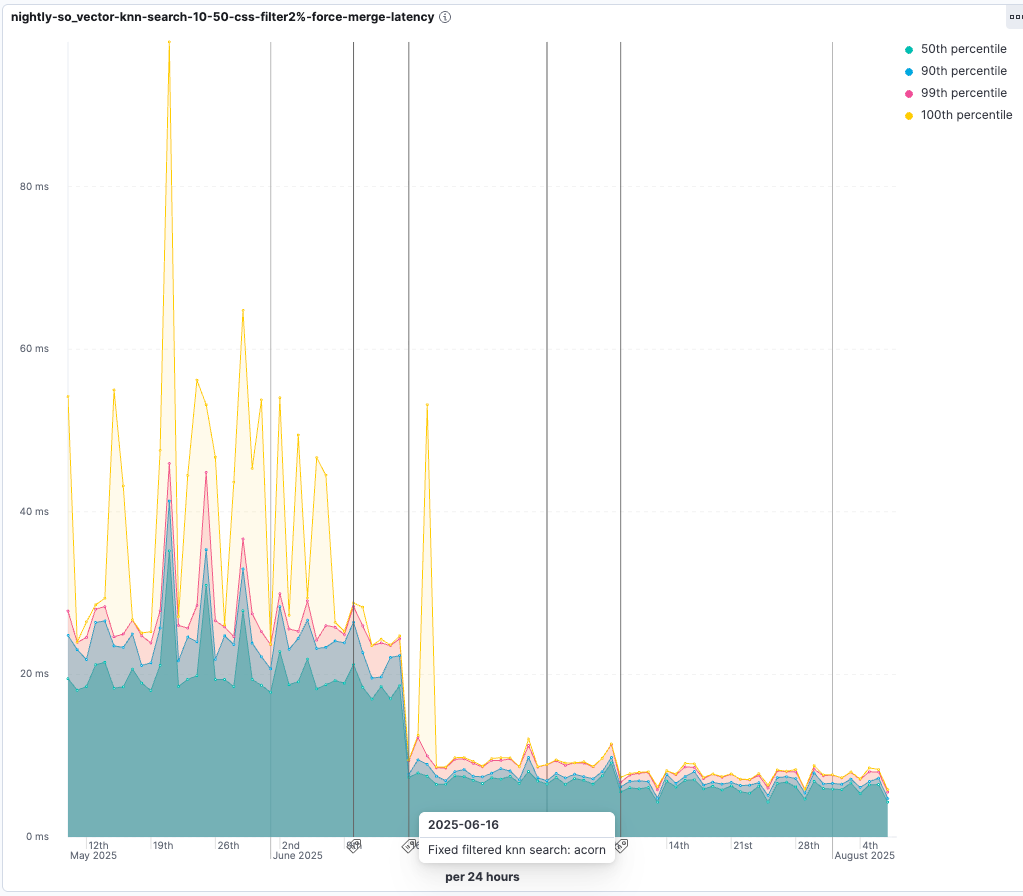
原文展示的基准中,当只有 2% 的向量通过过滤,引入 ACORN-1 后查询耗时约为此前的 55%。这个结果属于作者引用的特定 benchmark,没有在本稿环境复测;不能推广成任意数据上都降低 45% 延迟。
原文还链接到 Elastic Benchmark Analytics 的历史延迟图。图表序列名含 nightly-so_vector-knn-search-10-50-css-filter%2-force-merge-latency,以毫秒展示 p50、p90、p99 和 p100 延迟的时间序列;图中日期覆盖 2025 年 5 月至 8 月,并标出了 2025-06-16 的 ACORN 修复事件。它是作者链接的基准历史图,不是本稿运行或复测结果;只解读为来源图表,不把它当作受控的同条件 A/B 实验。
DLS 也会参与过滤
文档级安全(Document Level Security,DLS)通过角色关联的查询,限定用户能读取哪些文档。匹配结果可缓存成 BitSet,并用于包装底层 Lucene reader,使查询只把用户有权访问的文档视为可见。
对近似 kNN 来说,这组授权文档会与已有前置过滤条件共同约束候选,因此具有前置过滤相同的性能取舍和优化机会。对精确搜索来说,权限范围越小,需要比较的向量也可能越少。
业务端的 file-type 过滤不自动变成可靠的权限机制;真正的授权边界应由受控的权限配置建立,而不是让调用者自由选择是否带上一个 term 条件。
按目标结果选择方案
如果需要在符合条件的集合中寻找近邻,前置过滤更贴近目标,但还要测召回和耗时。如果可以接受对已有候选继续筛选,后置过滤的过程更直接,却要接受结果不足。过滤非常严格时,精确搜索值得纳入比较。
本稿仅静态核对全文和 JSON 结构,没有建立索引、写入向量或运行性能测试。评估应覆盖实际维度、过滤选择性、k、候选数、权限范围与目标版本。
来源、署名与版本说明
原作者:Carlos Delgado。原文由 Elastic Search Labs 发布。本文为中文翻译与技术整理,保留原作者和来源;编辑补充与版本边界说明已在文中标明。
- 原文:Vector search filtering: Keep it relevant
- 当前 Elasticsearch kNN 查询文档
- 当前 dense_vector 字段文档
- 文档级与字段级访问控制文档
原文发表于 2025-09-03。原文页末标注 © Elasticsearch B.V. All Rights Reserved;页面未声明适用于全文的开放许可。本文不将原文表述为开放授权作品,原作权利仍归权利人所有。
核对日期:2026-10-08。原文未固定完整 Elasticsearch 或 Lucene 发行号。向量维度、相似度、索引类型、查询 DSL 和权限配置均须与目标版本核对;过滤阈值与基准数字仅为原文经验和特定测试结果,不作保证。










暂无评论内容