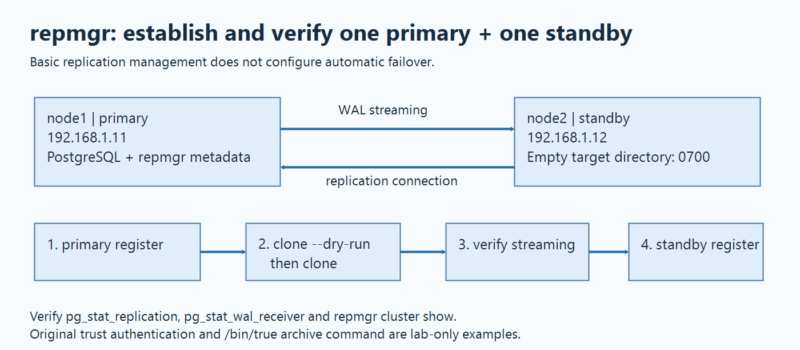



用 repmgr 建立并验证一主一备复制集群
repmgr 为 PostgreSQL 复制集群提供节点注册、备用节点克隆和集群状态管理。官方快速开始把这些工作安排成十个连续步骤:先准备两端,再注册主库、克隆备用节点,最后同时核对 PostgreSQL 的流复制状态与 repmgr 的元数据。本篇合并翻译这些子节,保留其操作顺序,并标明不适合直接复制到生产环境的简化配置。
原文:EDB 的 Quick-start guide,Copyright © 2010–2025 EDB。核验日期:2026-10-09。当前手册首页标明 repmgr 5.5.0、PostgreSQL 13–18;快速开始仍保留 PostgreSQL 9.6 路径、旧视图字段与 2017 年示例输出。这些是历史示例,不能当成当前固定路径或发表日期。
适用范围:这是一套隔离实验的一主一备复制管理流程,官方明确省略了生产账户安全和部分系统管理实践。它没有配置 repmgrd、自动故障切换、仲裁、读写路由或可靠 WAL 归档。本次没有创建数据库、克隆目录、启动服务或执行 SQL,所有命令只做静态审查。
1. 两个节点的前置条件
按原文前置条件,主库名为 node1,地址 192.168.1.11;备用库名为 node2,地址 192.168.1.12。两台都安装 PostgreSQL,以及与 PostgreSQL 主版本匹配的 repmgr。数据库端口(默认 5432)应允许两节点之间双向连接,主机名解析也要一致。
只有在让 repmgr 复制数据目录以外的配置文件,或演练 switchover 时,才额外需要双向免密码 SSH 和 rsync;不能据此把无限制 SSH 当作每个基本克隆的必要条件。原文也允许在同机不同端口运行多个 PostgreSQL 实例来做测试,相关场景需配置到 localhost 的 SSH。此处仍以两节点说明流程。
2. 为主库准备复制参数
主节点必须已经初始化且正在运行。检查复制参数时,WAL sender 数量应超过要连接的备用节点数,并留出克隆需要的余量:repmgr 调用带 WAL 流的 pg_basebackup,预检会要求至少两个空闲 WAL sender。
max_wal_senders = 10
max_replication_slots = 10
wal_level = 'replica'
hot_standby = on
上面的 wal_level='replica' 是本篇面向手册所述 PostgreSQL 13–18 的明确修正。原示例写 'hot_standby',同时注释说明 PostgreSQL 9.6 起使用 replica 或 logical,旧名仍作为别名接受。这里不需要为物理流复制选择 logical。
原文将两个容量值设为 10,它们不是固定最佳值。启用复制槽时,max_replication_slots 至少要比将连接的备用节点数量多 1;一主一备示例至少需要 2。若不使用复制槽,原文允许将其设为 0;repmgr 只有在 repmgr.conf 配置 use_replication_slots=true 时才使用槽。使用复制槽还要规划失联备用节点造成 WAL 保留的容量和监控,不能只增加槽数。
hot_standby=on 允许备用库接受只读查询。它在主库上暂时不生效,原文仍建议预先设置,以便这个节点以后转为备用库。可以把这些参数写入独立的 postgresql.replication.conf,再在主配置末尾用 include 'postgresql.replication.conf' 包含;应用哪些参数需要重启或重载,应以目标 PostgreSQL 版本说明为准。
原例的归档简化不可用于备份保证:源文另列 archive_mode=on 和 archive_command='/bin/true'。后者只返回成功,不会保存任何 WAL;把它放在生产配置中会造成“归档成功”的假象。本篇不把这两行并入上面的建议配置,保留说明以便对照原文。实验如果不需要归档,应明确选择相应配置;需要恢复能力时必须实现真实归档并验证恢复,而不是用空命令占位。
原文还提示,如果以后使用 pg_rewind,而集群初始化时没有开启数据校验和,可评估 wal_log_hints。这只是前置规划,本篇没有扩展为 rewind 或切换教程。
3. 创建 repmgr 账号和元数据库
源文为简化实验,使用名为 repmgr 的 PostgreSQL 超级用户和同名数据库:
createuser -s repmgr
createdb repmgr -O repmgr
-s 确实授予超级用户权限,不是普通的应用账户。原文允许使用普通账号,把需要超级用户的特定操作通过 --superuser 指定其他账号执行;复制连接也可以改用独立复制用户。实际部署必须按所用命令设计权限,不能把“专用账号”误解为“权限已经最小化”。这里仅保留实验源例,没有创建账号或硬编码密码。
repmgr 会安装同名扩展并创建 repmgr schema,其中保存元数据表、函数和视图。原文建议把该 schema 加入账号的 search_path:
ALTER USER repmgr SET search_path TO repmgr, "$user", public;4. 为普通连接和复制连接分别配置认证
认证子节同时允许 repmgr 访问元数据库,以及使用 PostgreSQL 的 replication 连接模式。原文的隔离测试片段如下:
# 原文测试配置:trust 不验证密码,禁止直接用于生产网段。
local   replication   repmgr                            trust
host    replication   repmgr      127.0.0.1/32          trust
host    replication   repmgr      192.168.1.0/24        trust
local   repmgr        repmgr                            trust
host    repmgr        repmgr      127.0.0.1/32          trust
host    repmgr        repmgr      192.168.1.0/24        trust
这个 /24 范围允许整个网段中的匹配客户端无密码使用 repmgr 身份,而该身份在前一节还是超级用户,是本教程最重要的安全边界之一。实际环境应收紧到指定节点地址,选择符合部署要求的认证方式与传输保护,并正确配置 PostgreSQL 客户端凭据;不要把密码直接写在文章、命令行历史或公开 conninfo 中。本篇没有给出未经目标环境验证的“生产万能替换片段”。
5. 准备备用库的空目录
备用库准备子节要求:不要对目标目录执行 initdb,也不要运行发行版提供的数据库初始化脚本。目录应存在,归 postgres 系统用户所有,权限为 0700,即 drwx------。repmgr 要把主库的数据库文件放进去;如果目标已经有 PostgreSQL 实例,克隆会拒绝运行。
应先确认目录确实是计划中的空目标。不要用递归删除命令“清空”一个不确定的数据目录。本篇没有提供删除现有实例的步骤。然后在备用端验证主库可达:
psql 'host=node1 user=repmgr dbname=repmgr connect_timeout=2'这条连接测试同时检验名称解析、网络、认证和数据库是否存在。repmgr 全程使用 libpq 连接字符串,通常称为 conninfo 或 DSN;它与分开的 -h、-d、-U 参数表达相同类型的信息。
6. 为每个节点创建独立 repmgr.conf
主节点的最小配置包含:
node_id=1
node_name='node1'
conninfo='host=node1 user=repmgr dbname=repmgr connect_timeout=2'
data_directory='/var/lib/postgresql/data'
node_id 在集群中必须唯一。conninfo 描述的是这个节点自身的可连接地址,不是统一填主库地址。data_directory 必须对应实际数据目录;示例路径只作为说明。
把 repmgr.conf 放在 PostgreSQL 数据目录之外,例如本例用 /etc/repmgr.conf,否则初始化或重建数据库时可能被覆盖。Debian 系发行版通常需要用 pg_bindir 指定 PostgreSQL 二进制目录;源例的 /usr/lib/postgresql/9.6/bin/ 是历史路径,必须按当前主版本替换。
pg_bindir 只用于 repmgr 直接执行 PostgreSQL 二进制的场景。promote_command、各类 service_*_command 等用户脚本必须显式给出完整路径,即使它们再次调用 repmgr 也一样。若 repmgr 二进制位于 PostgreSQL 安装目录之外,还可用 repmgr_bindir 帮助远端节点操作找到正确程序。
7. 注册主节点并读取元数据
注册主库会安装 repmgr 扩展和元数据对象,再写入 node1 的节点记录:
repmgr -f /etc/repmgr.conf primary register
repmgr -f /etc/repmgr.conf cluster show
原文成功日志显示扩展安装完成,以及 primary node record(id: 1)registered。随后 cluster show 应能辨认 node1 为运行中的 primary;这属于原文预期检查点,不是本篇实际输出。
SELECT * FROM repmgr.nodes;源例记录包含 node_id=1、node_name=node1、type=primary、active=t、config_file=/etc/repmgr.conf,上游为空;还有 location、priority、conninfo、repluser 和 slot_name 等字段。每个节点各有记录。如果以后使用 repmgrd,节点角色和状态变化会更新 upstream_node_id、active 和 type;本流程没有因此自动启用 repmgrd。
8. 先预检,再克隆备用节点
在 node2 上创建自己的 repmgr.conf:
node_id=2
node_name='node2'
conninfo='host=node2 user=repmgr dbname=repmgr connect_timeout=2'
data_directory='/var/lib/postgresql/data'
原文描述这一步时把字段写成了 node,但实际配置代码使用 node_id;本篇按配置代码采用后者。两台机器可以有相同的目录字符串,因为它们指向各自本机的目录。
先执行克隆预检:
repmgr -h node1 -U repmgr -d repmgr -f /etc/repmgr.conf standby clone --dry-run阅读预检输出,确认目标目录、源节点连接、两个空闲 WAL sender,以及备用节点将跟随上游 node1。只有这些前提满足后,才是去掉 --dry-run 的实际克隆:
repmgr -h node1 -U repmgr -d repmgr -f /etc/repmgr.conf standby clone原文日志说明,repmgr 在内部调用 pg_basebackup,使用 -X stream 传输备份期间的 WAL。它把主库的数据文件复制到目标目录,并生成启动流复制所需的配置。PostgreSQL 12 及之后的相关参数加入 postgresql.auto.conf;PostgreSQL 11 及之前使用 recovery.conf。不要在新版本中照抄旧 recovery.conf 流程。
数据目录内的 postgresql.conf、postgresql.auto.conf、pg_hba.conf、pg_ident.conf 默认也会复制。因此启动前检查其中的监听地址、端口、认证规则和本机路径是否适用于 node2。原文提示可用 -c/--fast-checkpoint 加快检查点,但它会改变主库负载行为,不应不加判断地默认打开。
确认备用配置后,使用你实际安装方式对应的服务管理方法启动 PostgreSQL。源文给的通用示例是:
pg_ctl -D /var/lib/postgresql/data start这不是要求对由系统服务托管的实例再启动一个独立进程。应按发行版的管理方式选择,并先核对所指目录和端口。
9. 从主备两端证明流复制正在工作
在主库查询:
SELECT * FROM pg_stat_replication;原文输出中,application_name=node2、client_addr=192.168.1.12、state=streaming,表明克隆出的备用库已连接;sync_state=async 说明它是异步复制。不能把一主一备自动理解为同步复制或零数据丢失。
在备用库查询:
SELECT * FROM pg_stat_wal_receiver;原文看到 status=streaming,发送端为 node1、端口为 5432。它的 conninfo 由复制配置生成,会包含备用节点名作为 application_name,因此与 repmgr.conf 中的本节点连接串并不完全相同。
原文表格里的 sent_location、write_location、flush_location、replay_location 以及部分 receiver 字段属于旧版本输出。这里保留 SELECT * 的检查方式,并解释关键连接与 streaming 状态,不把这些旧字段名固定到 PostgreSQL 13–18。日志中的 PID、LSN、端口和 2017 年时间也不是本次环境数据。
这两个视图能确认复制连接正在流式传输,但单次看到 streaming 不能证明长期无延迟、数据完整、备份可恢复或故障切换正确。更完整的验收需在你的测试环境观察持续状态和实际业务恢复要求。
10. 注册备用节点并检查最终拓扑
确认复制运行后,按最后一节注册 node2:
repmgr -f /etc/repmgr.conf standby register
repmgr -f /etc/repmgr.conf cluster show
源文预期最终看到 node1 为运行中的 primary,node2 为运行中的 standby,node2 的 Upstream 为 node1。两节点都出现在 repmgr 元数据中,记录也随着物理复制到达备用库。这个检查与 PostgreSQL 视图互补:前者说明 repmgr 知道节点拓扑,后者说明数据库复制连接实际在工作。
到这里完成的是基础复制集群注册与状态验证。若要继续自动故障切换,需要另行设计并配置 repmgrd、故障判定、网络分区处理及旧主库隔离;不能因为 cluster show 有两行就宣布高可用方案已完成。
安全审查与许可说明
本篇静态审查特别标记了 trust 无密码认证、超级用户账号、/bin/true 假归档、克隆目标目录、服务启动方式和历史版本字段。正文中仅将 wal_level 改为当前术语 replica,并统一 node_id 的拼写,其他与原文不同的取舍已逐处说明。没有执行破坏性清理或任何数据库命令;未发现其他问题不等于无漏洞。
原作归 EDB,保留 Copyright © 2010–2025 EDB。Legal Notice说明 repmgr 程序按 GPLv3 或后续版本提供且无担保;本交付不包含程序二进制,也不把程序许可证自动扩展为文档许可。本文中文翻译与原创示意图依单独发布授权提供。中文整理和自绘图归未完纪。










暂无评论内容