


原作:Frank · Frank’s Weblog · 2026 年 2 月 12 日。本文依据原文整理和修订,保留故障链与关键日志,并用 systemd v245 文档补充技术边界。
理解 Systemd Timer:一次 D-Bus connection terminated 错误排查
一次云实例创建失败,表面上只留下一句 D-Bus 连接中断。真正的原因藏在几个同时发生的动作里:业务初始化正在启动服务,自动更新恰好升级了 systemd,升级又触发了管理器重执行。把这些事件放回同一条时间线,才能解释为什么错误只偶尔出现。
原作者维护的是一项 SaaS 服务。客户创建实例时,系统通过 Terraform 创建 EC2 及相关基础设施;实例来自预先构建的 AMI,里面已经安装好业务软件。文章用 sinatra 指代该软件。实例启动后,setup.sh 负责配置它,期间会通过 systemctl 多次重启服务。故障发生时,初始化脚本收到:
Warning! D-Bus connection terminated.
Failed to wait for response: Connection reset by peer先划清证据范围:这是作者公开的历史诊断案例,涉及 systemd 245.4-4ubuntu3.19 升级至 245.4-4ubuntu3.20。私有初始化脚本、业务 unit 全量配置以及修复后的批量创建数据没有公开。下文的复现结果来自原作者记录,本次整理只做静态核验,没有启动实例或执行文中命令。
从 D-Bus 错误回到系统日志
D-Bus 是进程间通信机制,用来在程序之间传递消息或请求。systemctl 与 systemd 管理器之间的通信使用 D-Bus 协议。因此,这条错误首先应被理解为“控制命令等待响应的连接出问题了”,而不是直接当作业务服务的崩溃日志。
原作者查看本次启动的 journal,发现业务启动与管理器重执行只相隔十秒。下面保留影响判断的日志行;原文重复的 D-Bus reload、CRON 会话和非关键服务停止记录以省略号表示。
$ journalctl -b
Jan 01 00:23:01 vm systemd[1]: Starting sinatra Service...
Jan 01 00:23:01 vm sinatractl[33072]: [   Info] Starting XXX
Jan 01 00:23:01 vm systemd[1]: Reloading.
...
Jan 01 00:23:02 vm sinatractl[33072]: [   Info] Starting XXX
Jan 01 00:23:03 vm sinatractl[33072]: [   Info] Starting XXX XXX XXX
Jan 01 00:23:11 vm dbus-daemon[701]: [system] Reloaded configuration
...
Jan 01 00:23:11 vm systemd[1]: Reexecuting.
Jan 01 00:23:11 vm systemd[1]: systemd 245.4-4ubuntu3.20 running in system mode.
Jan 01 00:23:11 vm systemd[1]: Detected virtualization kvm.
Jan 01 00:23:11 vm systemd[1]: Detected architecture x86-64.
...
Jan 01 00:23:11 vm google_guest_agent[858]: GCE Agent Stopped
Jan 01 00:23:11 vm systemd[1]: Stopping Google Compute Engine Guest Agent...
...
Jan 01 00:23:11 vm systemd[1]: Stopping Network Service...
Jan 01 00:23:11 vm systemd[1]: Stopped Network Service.
Jan 01 00:23:11 vm systemd[1]: Starting Network Service...关键顺序是:00:23:01 开始启动 sinatra;00:23:11 出现 Reexecuting.,随后输出 systemd 的版本与系统信息。该业务平时需要约 10—20 秒启动,管理器重执行恰好落在控制命令等待完成的窗口中。
整理注:原文背景写 EC2,示例日志却含 GCE 代理;后面的日期和星期也有不一致。这些日志只能支持作者给出的相对事件链,不适合当作已经独立核验过的完整生产取证材料。原文将这里概括为“Systemd 重新启动”,下文使用更精确的“管理器重执行”。
daemon-reexec 做了什么
systemd v245 的 systemctl 文档说明,daemon-reexec 会先序列化管理器状态,再重新执行管理器进程,然后反序列化恢复状态。它主要用于调试或软件包升级,也可视为比 daemon-reload 更重的一次操作。管理器替配置监听的套接字在这期间仍保持可访问。
这不是整台机器重新启动,也不意味着所有服务都重新启动。daemon-reload 则是重读 unit 文件、重新运行生成器并重建依赖关系,不能与 daemon-reexec 或对某个服务执行 restart 混为一谈。
为验证关联,原作者在同一台机器上打开两个终端:一个启动业务服务,另一个在其启动期间触发重执行,得到与初始化失败时一致的连接错误。
# 终端 1:原作者的历史复现记录
sudo systemctl start sinatra
# Warning! D-Bus connection terminated.
# Failed to wait for response: Connection reset by peer

# 终端 2:在服务启动过程中执行
sudo systemctl daemon-reexec
这说明并发重执行能够解释原作者环境中的错误。但连接失败与 unit 的最终状态是两层证据:前者表示 systemctl 没有正常等到响应,后者要继续查看 journal、job 或服务状态。不能把“命令返回失败”直接改写成“业务进程肯定启动失败”。上面的两条命令会改变系统状态,并需要相应权限;本文保留它们是为了还原案例,不代表已经在当前版本复现。
顺着 APT 日志找到重执行的来源
接下来要解释的是:没有手动操作时,是什么让 systemd 重执行?同一份 journal 显示,自动升级任务覆盖了该时间窗口:
$ journalctl -b
Jan 01 00:18:16 vm systemd[1]: Started Daily apt upgrade and clean activities.
...
Jan 01 00:28:16 vm systemd[1]: apt-daily-upgrade.service: Succeeded.
Jan 01 00:28:16 vm systemd[1]: Finished Daily apt upgrade and clean activities.
apt-daily-upgrade.service 是自动升级、清理软件包的服务,由同名 timer 调度。作者查看的配置如下:
[Unit]
Description=Daily apt upgrade and clean activities
After=apt-daily.timer

[Timer]
OnCalendar=*-*-* 6:00
RandomizedDelaySec=60m
Persistent=true

[Install]
WantedBy=timers.target
原文使用的读取命令是 cat /etc/systemd/system/timers.target.wants/apt-daily-upgrade.timer。这个路径反映该实例的安装情况,不应假定所有发行版都在同一处保存 vendor unit。日常排查可用下面的只读命令查看 unit 及覆盖配置:
systemctl cat apt-daily-upgrade.timer
systemctl list-timers --all
后一组命令是整理补充,不是原文实测输出。原文 list-timers 的关键记录为:
NEXT                         LEFT          LAST                         PASSED       UNIT                       ACTIVATES
Tue 2025-01-02 06:28:09 UTC    4h 51min left Mon 2025-01-01 00:18:40 UTC  3h 18min ago apt-daily-upgrade.timer    apt-daily-upgrade.service
这行的星期与日期并不一致,且 timer 的上次触发与 service 日志相差几十秒,所以只能作为作者诊断线索保留。更直接的包升级证据来自 APT:
$ cat /var/log/apt/history.log
Start-Date: 2025-01-01  00:23:10
Commandline: /usr/bin/unattended-upgrade
Upgrade: libsystemd0:amd64 (245.4-4ubuntu3.19, 245.4-4ubuntu3.20),
 systemd-sysv:amd64 (245.4-4ubuntu3.19, 245.4-4ubuntu3.20),
 libpam-systemd:amd64 (245.4-4ubuntu3.19, 245.4-4ubuntu3.20),
 systemd:amd64 (245.4-4ubuntu3.19, 245.4-4ubuntu3.20),
 libnss-systemd:amd64 (245.4-4ubuntu3.19, 245.4-4ubuntu3.20)
End-Date: 2025-01-01  00:23:14
term.log 还记录了对应的软件包解包、配置与触发器处理。为便于阅读,以下省略数据库读取的 5%—100% 进度;版本与动作保留:
$ cat /var/log/apt/term.log
Log started: 2025-01-01  00:23:10
...
Unpacking systemd-sysv (245.4-4ubuntu3.20) over (245.4-4ubuntu3.19) ...
Unpacking libnss-systemd:amd64 (245.4-4ubuntu3.20) over (245.4-4ubuntu3.19) ...
Unpacking libpam-systemd:amd64 (245.4-4ubuntu3.20) over (245.4-4ubuntu3.19) ...
Unpacking systemd (245.4-4ubuntu3.20) over (245.4-4ubuntu3.19) ...
Unpacking libsystemd0:amd64 (245.4-4ubuntu3.20) over (245.4-4ubuntu3.19) ...
Setting up libsystemd0:amd64 (245.4-4ubuntu3.20) ...
Setting up systemd (245.4-4ubuntu3.20) ...
Setting up systemd-sysv (245.4-4ubuntu3.20) ...
Setting up libnss-systemd:amd64 (245.4-4ubuntu3.20) ...
Setting up libpam-systemd:amd64 (245.4-4ubuntu3.20) ...
Processing triggers for man-db (2.9.1-1) ...
Processing triggers for dbus (1.12.16-2ubuntu2.3) ...
Processing triggers for libc-bin (2.31-0ubuntu9.18) ...
Log ended: 2025-01-01  00:23:14
业务在 00:23:01 开始启动,APT 在 00:23:10 开始这批升级,systemd 在 00:23:11 重执行,升级在 00:23:14 结束。软件包变动与控制连接断开的时间关系因此能够对上。
为什么每天六点的任务,会在首次启动时运行
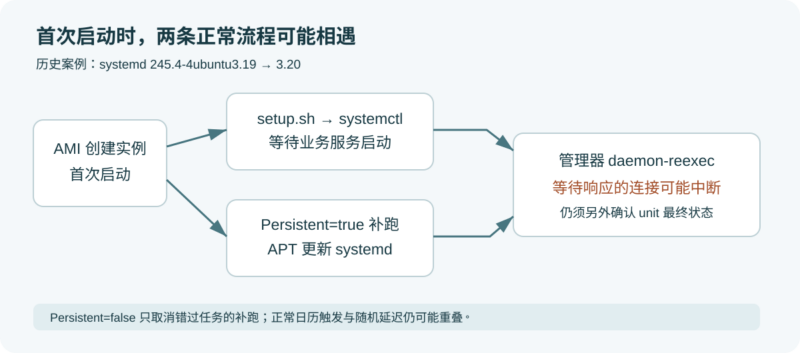
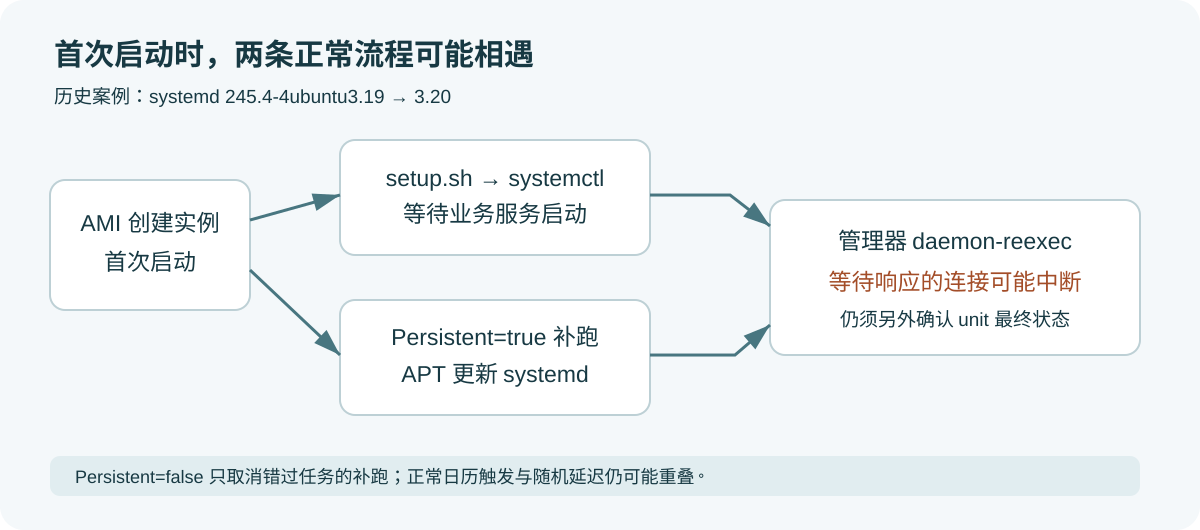
OnCalendar=*-*-* 6:00 定义每天 06:00 的日历触发时间;RandomizedDelaySec=60m 允许在触发安排上加入随机延迟,避免许多机器同一时刻更新。但作者创建实例并不在六点附近,因此只看 OnCalendar 还解释不了现象。真正关键的是 Persistent=true。
systemd v245 的 timer 文档说明:启用持久化后,服务上次触发的时间会记录到磁盘。timer 再次激活时,如果发现它在未激活期间本应触发过至少一次,就会安排补跑。这一设置只对 OnCalendar= 类型的 timer 生效,默认值是 false。
在这个镜像场景中,从 AMI 制作到新实例首次启动的间隔,可能构成 timer 眼中的未激活时期。只要遗留的时间状态和错过的日历触发满足条件,自动更新就可能在首次启动阶段补上。因此,不能根据“现在不是早上六点”排除 timer。
原文差异:原文第二次展示配置时写成了 OnCalendar=--* 6:00,与前面的正确表达式不一致。本文只保留 *-*-* 6:00,不把该处排版错误作为可替换配置。持久化补跑也不代表每次启动必然更新;是否补跑取决于时间状态、错过的触发以及 timer 当时的激活情况。
把故障链连起来
- 云实例从包含业务软件和定时任务状态的 AMI 启动。
setup.sh配置 sinatra,并多次通过 systemctl 重启服务,每次等待约 10—20 秒。- 持久化 timer 发现有错过的日历任务,安排
apt-daily-upgrade.service补跑。 - 本次自动升级更新了 systemd 软件包,触发管理器重执行。
- 重执行与初始化的服务控制命令重叠,systemctl 等待响应的连接被中断。
- 初始化流程将该命令错误作为失败处理,实例创建没有按预期完成。
这条链说明,单独看每个动作都很正常:新实例要初始化,安全更新要执行,systemd 升级后要加载新程序。故障出现在这些动作争用了同一个时间窗口。
Persistent=false 能解决哪一部分问题
原作者的处理办法是把 timer 的 Persistent 改为 false,降低首次启动补跑与初始化重叠的概率。这个选择切断的是“错过任务补跑”这条路径。
需要修正原文的一句保证:原文说这样可以“确保自动更新不会在实例刚创建的时候执行”。更准确的说法是:Persistent=false 取消错过的 OnCalendar 任务补跑,正常日历触发及随机延迟仍然存在。如果实例恰好在更新窗口创建,两个流程仍可能重叠。它不是初始化阶段的互斥锁。
实际系统还应明确初始化与更新的先后关系,保留安全补丁计划,并让初始化在查询真实 unit 状态后进行有限、幂等的重试。不能简单关闭自动更新后就不再安排补丁,也不能因为控制连接中断就盲目重复所有配置步骤。这些属于对案例的工程补充,原文没有提供现成的通用互斥脚本,本文也不伪造一份。
迁移这个经验时,应先核对当前发行版的 unit 配置、systemd 版本及初始化流程。本案例最值得复用的是排查顺序:把业务启动、管理器日志、timer 触发和包管理日志对齐,再区分“调用失败”与“服务失败”。










暂无评论内容