
一颗行星从恒星前方经过,望远镜看到的亮度会短时间下降。若行星有大气,某些波长的光更容易被吸收,恒星变暗的程度就会随波长改变。研究者要找的,往往是一条已很浅的光变曲线上,在不同颜色之间更微小的差异。光斑漂移、探测器噪声和恒星本身的活动,都可能留下与这一差异量级相近的痕迹。
Ariel Data Challenge 2024 用模拟探测器观测把这个困难变成可以评分的任务。模拟器知道输入的透射谱,参赛者看到的则是带仪器干扰的观测。这样就能检验去噪算法是否恢复了预设信号,以及它报告的误差有多可靠。挑战的稳定结论来自模拟条件下的检验,方法能否处理实际观测还要看它在新的噪声与校准误差下如何表现。
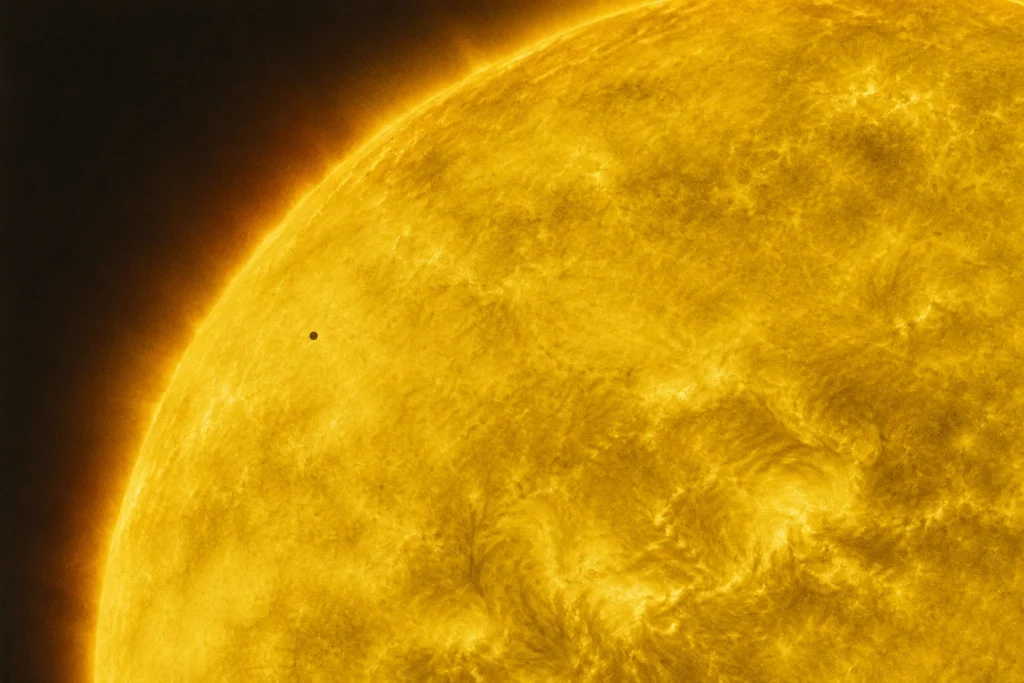
把光变和光谱放在同一条测量链里
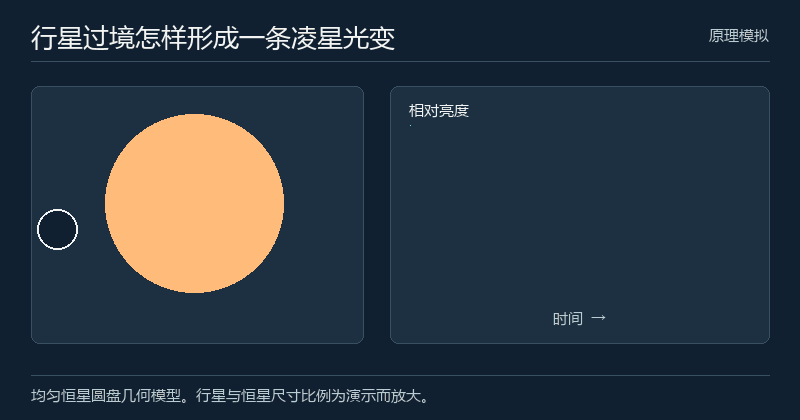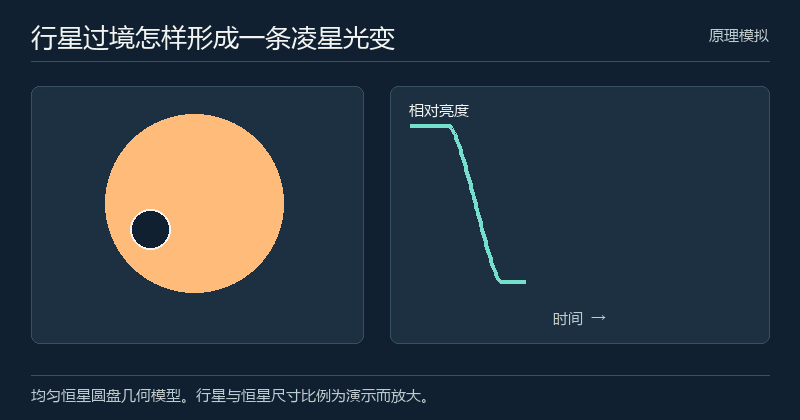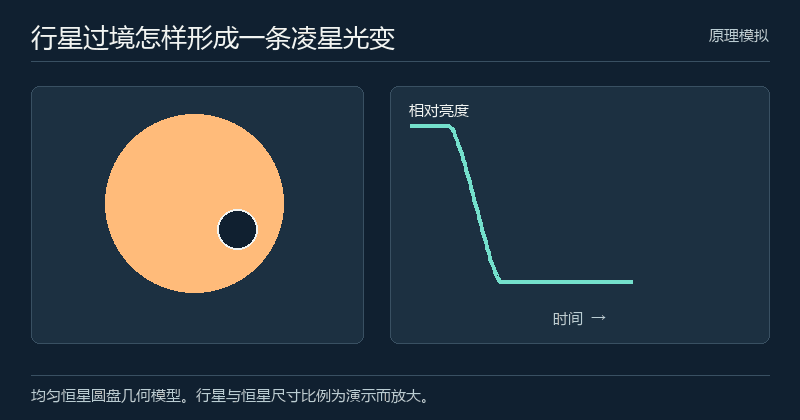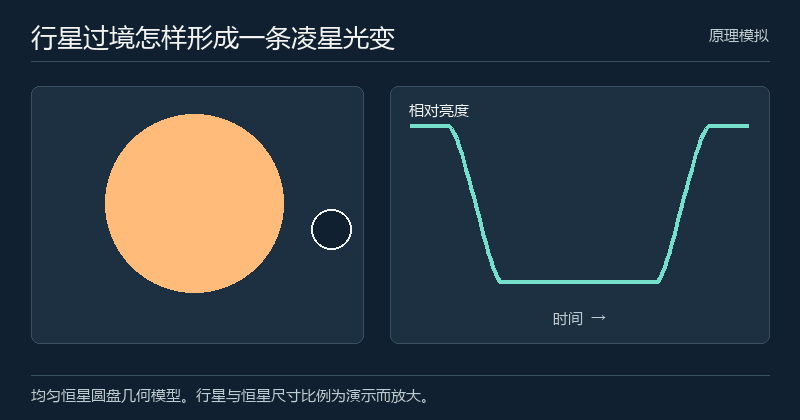
最简单的凌星模型把恒星画成一个均匀发亮的圆盘,把行星画成小圆盘。整颗行星位于恒星圆盘内时,遮光面积与两者的半径平方比有关。进入和离开的过程中,两个圆盘的重叠面积逐渐增加或减少,所以光变曲线会出现两段斜坡及一段较平的底。这里的 GIF 就演示了这部分几何。真实恒星的盘面亮度从中心到边缘有变化,行星经过不同位置会挡住亮度不同的区域,曲线并不一定有一个完全平的底。
把光按波长拆开,可以逐个波段拟合凌星深度。大气在有吸收的波长上使有效遮挡半径略大,得到的深度随波长排列成透射谱。与此同时,星斑与恒星活动也可能改变不同波段的亮度比例。观测分析需要区分一个共同的过境几何与各波段独立的深度变化,再看它们是否能由物理模型共同解释。从透射谱继续推断分子种类、温度或云层,又是下一阶段的问题。
因而一次光变处理至少有三层输出。第一层是从探测器像素提取随时间变化的通量。第二层是利用通量和凌星模型估计分波段深度。第三层才讨论大气模型解释。若把模拟比赛里的光谱恢复分数直接用作分子检出的证据,就跳过了第三层所需的独立推断。
一个用平方比估算量级的假设例子
设某行星在参考波段的半径是恒星半径的十分之一。均匀圆盘近似下,凌星的相对深度约为 0.1²,也就是 0.01,相当于一百万份亮度中少一万份。若在另一个有吸收的波段,有效半径比增为 0.1005,深度约为 0.01010025。两条光变在理想化的同一位置相差 0.00010025,相当于约 100 个百万分之一。这些数值是为了帮助估算差异的人工设定。
如果光斑移动造成的亮度起伏也在百个百万分之一附近,两者就不会天然分开。只做更强的平滑虽然可能降低散点,也可能把窄波段吸收削弱。反过来,复杂拟合有可能把相关仪器误差误认成一个小吸收谷。判断算法是否成功的量是注入谱是否按其幅度与位置被恢复,以及误差估计能否覆盖它,图像是否更平整只能作为补充观察。
还可用算例检查半径与深度的语义。把相对半径错当成相对深度,会比微弱大气特征大许多倍。公开分析中要在图注和表格里写清深度是相对通量、百分数还是百万分数。比较模拟与拟合结果时,也应先用统一的单位和同一组波段边界再算误差。
展开演示动图 · 合成凌星光变
指向抖动如何进入亮度曲线
理想情况下,若恒星不变,经过同一套仪器测得的短时亮度也应稳定。现实中,航天器指向改变会使光斑在探测器上略微移动。如果不同像素的响应不完全一样,光斑内各像素的加权贡献就会变。以固定窗口提取信号时,偏移还可能让一部分光落到窗口外面。因此与真实凌星无关的几何运动,也能进入最终通量时间序列。
Ariel 竞赛的挑战就是从包含这类干扰的模拟资料中估计谱深和不确定度。可用信息来自多个方向,例如在时序中查看光斑位置、在波长上比较若干通道的共同变化。若许多通道同时随光斑运动而起伏,共变部分可能与仪器响应相关。某个大气特征也可能在相邻通道具有相关性,因此提取共同趋势时要检验是否顺便消除了真实吸收。观察入凌和出凌之外的时段可以帮助估计漂移,但两部分的仪器状态还要能相互代表。
对这种问题,物理处理与学习模型可以参与同一流程。先用已知的探测器信息做校准,利用解析凌星曲线作为基线,再让学习模型承担难以逐项建模的余量。也可以用学习模型预测时变的仪器分量,然后将估计的不确定度传递到谱深拟合。只用黑箱输出最终光谱也可参加基准,不过遇到异常结果时,需要更有针对性的消融实验才知道问题出在像素读出、时序估计还是波长间处理。
如何比较学习法和物理拟合
一个可复现的基线先根据每个波段拟合带基线漂移的光变模型,使用相同的恒星与轨道参数,再检查留出时段是否有偏。另一个基线可以在拟合前用光斑位置或低维共同成分校正漂移。它们未必能处理所有非线性误差,但可以交代不用复杂模型时已经能够恢复多少信号。在比较机器学习方法时,应让各方法看到同样的校准信息和观测范围,并使用独立的模拟系统做最终测试。
如果随机抽取同一颗行星的相邻波段分别进入训练集与测试集,网络可能从同一系统的整体特征推测留出的答案。这和面对新目标的任务不同。更有说服力的划分会把同一行星系统的重复观测放在同一组,并另外保留不同亮度或不同噪声结构的条件。还可以让同一份底层谱经历多次独立仪器实现,用来衡量不同干扰下输出的波动。
误差条也需要独立验证。假定某模型报告的区间名义上有 90% 覆盖率,在足量的同类独立测试中,真值落进区间的比例应当接近 90%。仅检查光谱曲线的均值误差,容易忽略模型把误差条报得太窄。单个波段看似不大的偏差还可能在多个波段向同一方向叠加,改变对后续吸收带的解释。批量评估时可以同时报告不同波段残差的协方差,而将光谱上的协同偏差留下来。
把注入回收做成候选方法的验收
设计多组有已知深度、宽度和中心位置的吸收特征,再让它们通过一套可靠的模拟观测。回收时不向模型告知哪一组是阳性对照。在噪声幅度或抖动模式不同的组中画出真值与回收值的关系。如果真实幅度越小,被压低的比例反而越大,方法可能把弱特征当作可削减的噪声。如果无吸收的组也频繁出现一条窄峰,则需要检查模型会不会主动生成常见的谱形。
还应比对在模拟中不起作用的对照条件。例如对稳定指向的模拟,无须抖动校正也应得到相近结果。若加入去噪模块以后,稳定条件反而出现了更大的系统偏差,就有理由暂停使用该模块。把校准数据、训练时所见的噪声类型、适用通量区间及测试指标一并保存,下一组研究者才有机会在不同数据上验证结论。
这类竞赛给出了一个很有价值的训练场,因为真值可控,算法的失败也可以追到仪器和物理设定。真正有用的恢复结果必须能交代弱信号从哪里来、误差是怎样传播的,以及在哪些条件下还能得到同样的结论。保留这些证据以后,一条更干净的光谱才有资格进入下一步的科学解释。
把每个波段的不确定性传给下一步
一条光谱通常伴随一列误差条。若使用同一次指向校正、同一个恒星参考通量或同一条基线曲线,误差会在波段之间相关。对后续大气反演来说,同时偏高的三个邻近波段可能只是一次共同波动。把它们当成三个独立支持某分子特征的证据,会高估结论强度。条件允许时,可以从多个对同一观测独立生成的校准实现中估计这种关联,再将它纳入拟合。资料不足时,可以比较独立误差和富有相关性的替代假设,报告科学解释对两者有多敏感。
模型若对欠佳的观测确实缺乏把握,诚实的宽区间仍有用。它能提示下一步优先补观测、重做校准或改变观测方案。在同一颗行星已有多次凌星记录时,先独立处理,再比较波段特征能否在不同观测中出现。若一条窄吸收只在某次指向漂移最大的记录里出现,就该先做噪声复查。这一流程可以在不抹去小信号的前提下限制偶然发现。