
一根被加热的细杆,内部温度会随时间变化。给定材料参数、初始温度和边界条件,预测温度场属于正问题;从少量温度读数反过来估计参数,则属于逆问题。后者的困难不仅是数据少,还在于不同物理原因可能产生相似曲线:材料传热快一些、边界散热强一些,或传感器响应慢一些,都可能改变记录。
物理信息神经网络,通常简称 PINN,把微分方程写进训练目标,用连续神经网络表示未知温度场。赵暾等在 2021 年研究了这一方法求解一维热传导正问题与参数辨识的表现。要理解它什么时候有用,必须把方程约束、参数可辨识性和数值优化分别讨论,不能把“加入物理”理解成自动获得正确答案。
热扩散率与热导率不是同一个未知量
对均匀、各向同性材料,在忽略体热源且物性近似不变的一维模型中,温度可以满足 ∂T/∂t = α ∂²T/∂x²。其中 α 是热扩散率,等于热导率除以密度与比热的乘积。它描述温度差异消退的时间尺度;热导率则与给定温度梯度下的热流有关,两者单位与物理含义不同。
如果只从温度演化辨识出 α,不能在缺少密度和比热信息时唯一得到热导率。即使额外数据齐全,这个结论也依赖所设方程:温度相关物性、接触热阻、侧面散热或内部热源,都可能使简单模型不足。网络可以把这些未建模效应部分吸收到某个“有效参数”里,得到漂亮拟合,却改变了参数解释。
因此,实验开始前要先定义问题:估计常数扩散率,还是随温度变化的函数;边界温度是否已知,还是需要一起反演;传感器测到的是表面还是内部温度。未知量越多,越需要独立信息。模型更灵活有时会提高拟合能力,同时降低参数之间的可区分程度。
方程残差怎样进入神经网络训练
令网络根据位置与时间输出温度近似。自动微分得到它的时间导数和二阶空间导数,便可在一批配置点上计算热方程残差。损失函数再结合温度测量误差、初始条件误差和边界条件误差。如果 α 也是未知量,就让它与网络权重一起更新,并用适当参数化保证它满足物理取值范围。
Raissi 等在 2019 年的论文系统阐述了这类正反问题框架;赵暾等的一维热传导研究则具体讨论了收敛与参数辨识,包括采样和优化带来的影响。这里的配置点可以没有实际传感器,因为它们约束的是网络与方程的一致性。它们增加了计算约束,并没有凭空增加独立实验观测。
自动微分计算的是当前网络的导数,避免了对离散网络输出做简单差分时的一部分误差,但不保证这个网络已经接近真实解。方程通常以软约束进入损失,残差只是在选定点上被压低。若配置点漏掉快速变化区域,或权重使某项约束被忽略,训练损失很小仍可能存在明显的场误差。
展开演示动图 · 热扩散率对温度曲线的影响
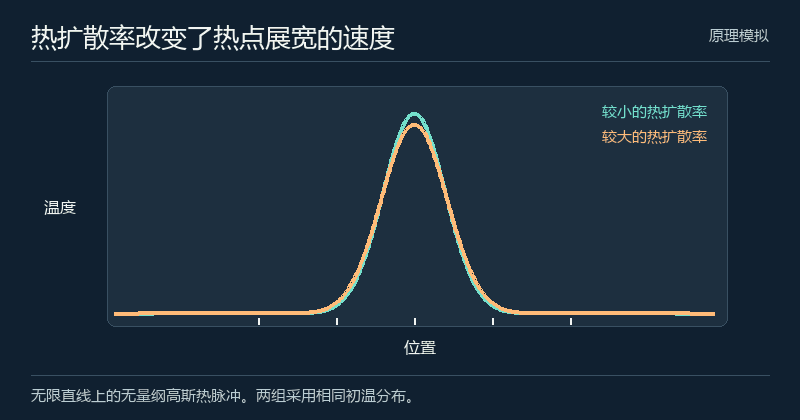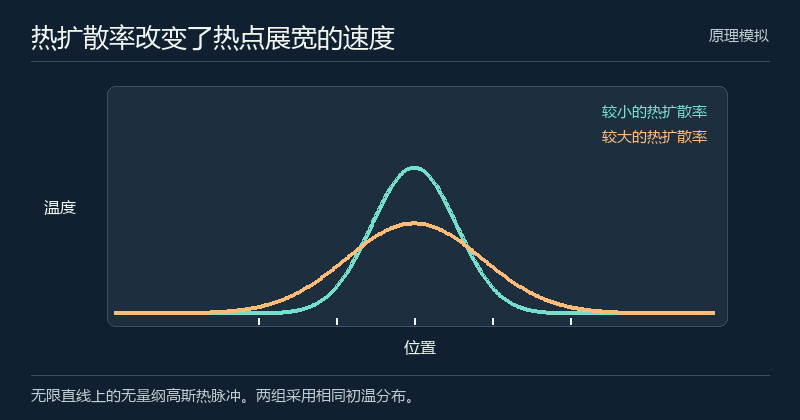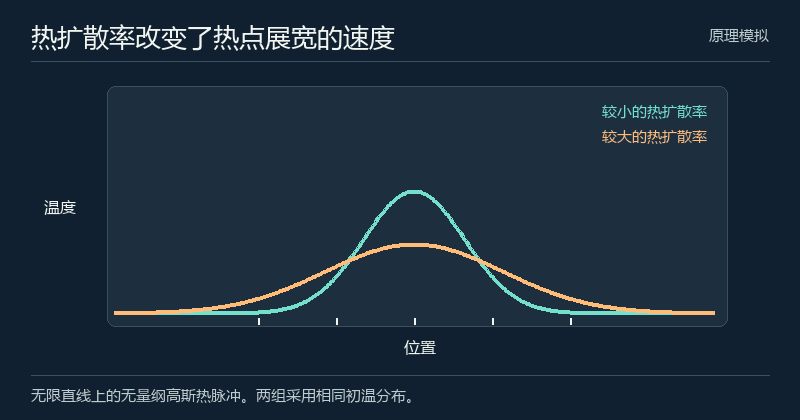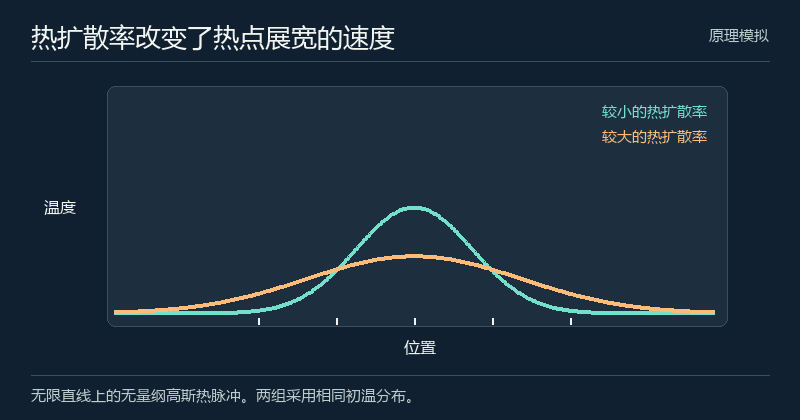
一个合成细杆算例,直接看出辨识信息来自哪里
考虑长度为 L、两端温度固定的理想细杆,初始温度偏差取正弦形。方程给出这一空间模式的幅度随时间按 exp(−π²αt/L²) 衰减。这是为解释机制构造的解析算例,不是实际材料测量。若能准确测出某时刻幅度相对初始值的比例 r,就可由其对数反推出 α。
取合成参数 L 为 0.1 米,α 为每秒十的负五次方平方米。在一百秒时,幅度比例约为 0.373,对应明显的温度变化。用关系 α = −L² ln(r)/(π²t) 即可恢复参数。这也提供了检验 PINN 实现的简单办法:先在无噪声解析数据上检查反演,再逐步引入测点稀疏、噪声和边界误差。
若测量太早,r 接近一,温度变化很小,同样的读数误差会造成更大的相对参数误差。一阶误差传播给出相对误差约为 |δr|/(r|ln r|)。例如 r 为 0.98、比例误差为 0.01 时,参数相对误差可接近百分之五十;r 约为 0.37 时,同样误差只对应约百分之三。这说明选择有信息的观测时段,比单纯增加网络层数更重要。
为什么温度拟合很好,参数仍可能不唯一
在近乎均匀的温度场中,空间二阶导数很小,温度对扩散率的敏感性也可能很弱。多个 α 都能给出相近预测。若未知边界散热系数也参与优化,参数之间还可能互相补偿。优化器最终返回一个数值,只说明它选择了某个损失较低的位置,不等于该数值被观测唯一确定。
可以对不同候选参数固定求解,再查看最优拟合误差怎样变化。如果一大片参数区间都能解释观测,结果应表达为宽范围,而不是给出许多小数位。也可以检查各参数对观测的灵敏度,以及这些灵敏度是否近似成比例。近似共线意味着两项作用难以被现有测点区分,需要改变实验而非只换优化器。
实用的改进包括改变加热时程,在温度梯度较明显的位置布置测点,或增加独立热流、密度与比热测量。对传感器还应测量响应时间与接触条件。若把传感器时间常数误当成材料扩散,网络可能稳定地得到错误参数;只有不同测量机制的交叉检验,才有机会暴露这种系统偏差。
损失权重与尺度会改变求解难度
温度、位置和时间的量纲不同,方程残差与测量误差的量纲也不同。直接把平方项相加,数值大小可能主要反映单位选择。通常需要先用合适的长度、时间与温差尺度无量纲化,再说明各项权重。测量误差已知时,可让数据项体现不同传感器的噪声水平,而不是假设所有读数同样可靠。
权重过强的方程项可能迫使网络忽略真实但模型无法解释的数据,权重过弱则可能退化成缺乏物理约束的插值。Krishnapriyan 等在 2021 年研究了 PINN 的若干失败模式,强调将方程加入损失之后,优化仍可能相当困难。简单方程或存在解析解,并不意味着神经网络训练一定容易。
诊断时应分别绘制各类损失、独立残差和留出观测误差,观察它们是否共同下降。可改变初始化、配置点分布与训练策略,再比较参数稳定性。如果总损失下降只是因为某一项很容易,而重要边界持续偏离,平均曲线就会掩盖真正的问题。训练日志应帮助定位错误,不能只作为一条收敛证明。
与传统反演比较,应该固定哪些条件
对于只有一个未知常数的一维热方程,有限差分或有限元求解器配合最小二乘优化,往往是很有竞争力的基准。它们可以明确控制离散误差,也便于重复扫描参数。PINN 的价值可能体现在同时重建连续场、处理不规则观测或扩展复杂耦合任务,但这些收益应在相同数据与误差目标下证明。
公平比较至少包括观测位置、噪声、边界信息和参数范围一致,并计入训练总时间与调参成本。若传统方法获得准确边界,而 PINN 同时需要猜边界,比较就不公平;若 PINN 接触了测试时刻的温度标签,再拿它与纯外推方法比较,也会高估优势。基准必须先明确每种方法可用的信息。
还可比较计算预算增加后的误差下降曲线。对同一个问题,让两类方法逐步增加配置点、网格或迭代次数,观察参数和预测是否收敛。若只挑一个配置,可能把某种方法的未收敛结果误当作固有限制。真正需要比较的是,在同等信息和可接受成本下,谁能更稳定地得到目标精度。
最后应交付一组经得起新实验的预测
反演之后,最有说服力的测试是固定参数,预测未用于拟合的测点、加热程序与时间区间。可将 PINN 得到的参数交给独立数值求解器,避免网络表示误差与参数误差相互抵消。合成数据还应由不同求解器或更精细网格生成,以减少逆向犯罪,也就是生成与反演共用同一误差结构。
误差条应同时考虑传感器噪声、边界不确定性与模型失配。多个网络给出相近参数,只反映某些优化或表示差异较小,并不自动覆盖所有系统误差。可通过重复实验、重采样和受控边界变化检验区间覆盖。若声称的区间很窄,独立实验却反复落在外面,就需要重新估计不确定性。
当参数随测点选择大幅漂移,或新的加热程序无法被同一个参数解释时,应先怀疑可辨识条件与物理假设。PINN 提供的是一种把方程和数据共同用于反演的计算工具。可信的材料结论,最终来自清楚的参数定义、足够的信息和经独立实验检验的预测,而非某一次优化返回的低损失数值。