


像 Spotify 这样的公司,需要让大量数据以低延迟供在线服务使用,也越来越需要供代表用户行动的 AI 智能体使用。例如,展示或使用用户收听历史的门户与个性化功能,需要以可交互的速度查找并分页读取每个用户的数据。
当 AI 智能体回答“我去年夏天听了什么?”时,也需要快速取得用户数据,进行过滤、聚合,甚至在本地运行 SQL,为 LLM 提示构建上下文。这两种模式都依赖同一个基础操作:在大型数据集上按键快速点查。这些数据集通常大到难以经济地全部常驻 Bigtable 或 DynamoDB 等键值(KV)存储中。
Spotify 为在线场景在 Bigtable 中保存 PB 级数据,而 GCS 数据湖中保存的是 EB 级数据。数据湖的底层存储已经很快,并且还在加速:原文给出 GCS 每次请求30–100毫秒,S3 Express One Zone 与 GCS Rapid Storage 已能提供个位数毫秒的延迟。
瓶颈越来越不是存储层本身,而是上层查询引擎。Trino、BigQuery 等分布式 SQL 引擎即使只查一行,也会增加数秒的任务调度和查询规划开销。它们为分析吞吐量设计,而不是为交互式点查设计。
Random Access Parquet(RAP)填补这一空白。外部索引把键直接映射到文件位置,精确范围读取只取所需字节。RAP 使用的就是机器学习流水线、Notebook、实验平台和批量分析已经共享的同一批 Parquet 文件:只存一次、只付一次存储费用,无需在专用在线服务系统中维护另一份副本。
分布式 SQL 引擎如何在海量数据中找出目标
用户问 AI 智能体自己去年夏天听了什么。仅收听历史就横跨数十亿用户,分布在每天数千个大型文件中;夏天约90天。假设每天1000个文件,就有90000个 Parquet 文件。对于在线场景,哪怕每个文件只读一点,也难以控制在合理时间和计算预算内。
有标准方法可以缩小候选集合。在每天的分区内,还可以进一步按键分区。这常用于加速连接,键选择合适时也利于点查。仅从文件名,引擎就能判断某个用户 ID 是否可能位于该文件中。如果每天有1000个桶,候选文件就从90000个缩到90个。用户 ID 列上的布隆过滤器可以不打开文件就排除候选;把它们缓存到元数据存储里,可能将90个候选缩到用户实际活跃的12天。
但这12个文件仍需读取。文件很大,在其中寻找一个用户的数据,需要一串相互依赖的读取:取得文件尾部并解析行组元数据,扫描键列定位匹配行,再利用列索引和页索引找到各值列中的对应页。这意味着每个文件、每列都要进行多次依赖前一次结果的云存储往返读取,每次往返还与其他并发查询争用 IOPS。按键分区和布隆过滤器有助于筛选文件,却无法解决文件内部的定位问题。
RAP 的方法
依赖式读取链是根本瓶颈,适用于每一层存储。每个环节都有延迟成本(下一次读取必须等上一次往返结束),还有带宽成本(读取一些字节,仅为知道下一次该读哪里)。云存储每个 I/O 环节需要数十毫秒;本地 SSD 是微秒级;内存是纳秒级。绝对数值变化了,结构没有变:每一步都依赖上一步的结果。
把这条链压缩成一次预先计算的查询,无论在哪一层存储,都能节省延迟和带宽。原文用云对象存储举例,因为每次往返成本较高,收益最明显;但原则是通用的。
RAP 做查找,而不是扫描。外部索引把每个键直接映射到数据所在的文件及行号。给定一个键,读取器查询索引,通过缓存文件元数据把行号解析为页位置,再发起范围读取,精确获取所需页。索引查询为 O(1),缓存页映射是低延迟操作,数据获取只需少量精确范围读取。这些读取能够并行发出,不存在依赖式加载链。
外部索引
RAP 可以在任何现有 Parquet 文件上运行,无需特殊预处理。索引构建器读取所需列的文件尾部及页位置,扫描键列建立“键到位置”的映射,再将其写出。新数据到达时,每次流水线运行都会产生对应索引条目。索引通过追加片段增长,不修改已有片段。
索引是一个多值映射:单个键可能在多个文件和分区中有条目。每条记录很紧凑:
| 字段 | 说明 |
|---|---|
| key | 查询键,例如用户 ID,也可以是复合键。 |
| file | 所在 Parquet 文件,以字典编码序号表示。 |
| row numbers | 该文件中的行号。 |
| value count(可选) | 值的数量,用于支持分页。 |
经验上,为 TB 级数据建立索引,索引约为 GB 级;PB 级数据的索引约为 TB 级。大型索引很适合通过哈希分桶分布。
原文将它与 Parquet 内置的 PageIndex、布隆过滤器进行区别:后两者缩小扫描范围;外部索引给定一个键,就确定地返回准确文件与行号,从而完全消除扫描。
文件未改造时,RAP 仍需读取包含目标行的整个页,可能为提取100字节而读入4 MB。对于对延迟或成本敏感的负载,在写入时准备数据可以缩小读取量,使定位更精确。这需要深入 Parquet 内部结构与数据处理流水线,但真正的收益也来自这里。
针对预处理 Parquet 文件的优化
外部索引改变了读取器访问文件前已知的信息:准确的文件、行以及所需列。以下优化针对提供点查服务的列,同一文件的其他列仍可以使用最适合批量分析的布局。很多技术本身就有用,有些也有利于其他读取器,而不只是 RAP。
外部索引改变了权衡:有利于文件内查找的属性,如细粒度页索引、用于谓词跳过的小页、支持下推的字典编码,重要性下降;能够尽量缩小最终读取的属性,如更少往返、更小读取量、连续数据,变得更重要。
优化分三类:集中一个键的数据、减少每次读取的字节数、减少读取次数。
集中同一键的数据
按键排序让同一键的所有行在文件内连续排列,尽量集中到少量页中。很多流水线已经输出排序数据。哈希分桶(Spark、Scio SMB、Iceberg bucket transforms)进一步保证每个键确定地映射到每个分区中的一个文件。
共同分组(Co-grouping)通过调整 schema,让每个键仅出现一次,并把值放进重复列或嵌套列。例如:
SELECT user_id, ARRAY_AGG(STRUCT(timestamp, track_uri, duration_ms)) FROM streams GROUP BY user_id
这样无需依赖排序,就能使每个键在每个文件中只有一行,通常也很自然。
更粗的分区减少一个键跨越的文件数量。按日分区时,每个键每年可能涉及365个文件;按周分区缩到52个,索引条目和并行读取更少,索引也更小。代价是批量查询的分区裁剪粒度变粗。
减少读取字节数
即使索引指向准确的页,这页仍可能远大于目标数据。
每个键一个页:写入器在键边界刷出页,即键变化时换页。解压后的整个页都属于目标键,无需再提取行。由于一个页仅属于一个键,可以直接把页位置存入索引条目,不需要独立页索引。文件仍是标准 Parquet。每个键边界增加约20字节页头开销;一个键有大量数据时,可以忽略。
在键边界重置压缩器通常对压缩率影响很小,但这取决于数据。副作用是:如果文件有 PageIndex,它的大小会随键数量增长,而不是随常规页数量增长。
页内重置 ZSTD 帧:如果每个键一个页使 PageIndex 膨胀,可以保留常规页大小,但把每个键的行压缩成页内独立 ZSTD 帧。索引为每列存储每个帧的字节偏移与大小,无需独立页索引即可直接定位。标准读取器正常解压这个页,因为 ZSTD 帧可以直接拼接;RAP 则能够独立定位每个帧。
代价是每个帧的值必须能在不依赖前面帧的情况下解释,因而不能使用差分与游程编码。PLAIN 或字典编码符合要求,但对某些类型可能不够紧凑。RAP 的主要场景是 blob、JSON、平坦值列,通常可以接受。
存储对齐:ZSTD 可跳过帧(skippable frames)可以在键之间填充,使读取对齐到4 KB、16 KB等存储块边界。跨越边界的读取需要访问两个块。本地磁盘受 IOPS 直接约束,对齐能避免额外块读取。云对象存储不按 IOPS 计费或限流,但底层仍然是磁盘,因此对齐仍是一项有价值的细微优化。填充很少,文件仍为有效 Parquet。
减少读取操作
标准 Parquet 文件中,取得一个键在 N 列上的值需要 N 次并行读取,占用 N 倍请求容量,并让单键延迟更接近分布尾部。减少读取次数是最大的单项收益。
Blob 与 Variant:把随机访问所需字段存为一列,例如 JSON、Protobuf 或 Parquet Variant,每个文件便只需一次读取。这与在线应用以文档而非独立字段消费数据的方式很一致。代价是批量分析无法在 blob 内进行按字段的列裁剪和谓词下推。
列交错:需要多个列时,写入器可以把它们物理交错排列,包括用于点查和用于批量分析的列。不同列中属于同一个键的数据相邻写入:键1的A列、键1的B列、键2的A列、键2的B列。用 ZSTD 可跳过帧连接不同列,使每列保持有效压缩流。传统读取器顺序读取A列,解压器静默跳过跳过帧中的B列数据。RAP 读取器则发起一次连续范围读取,覆盖该键的所有列,文件仍完全符合 Parquet 格式。
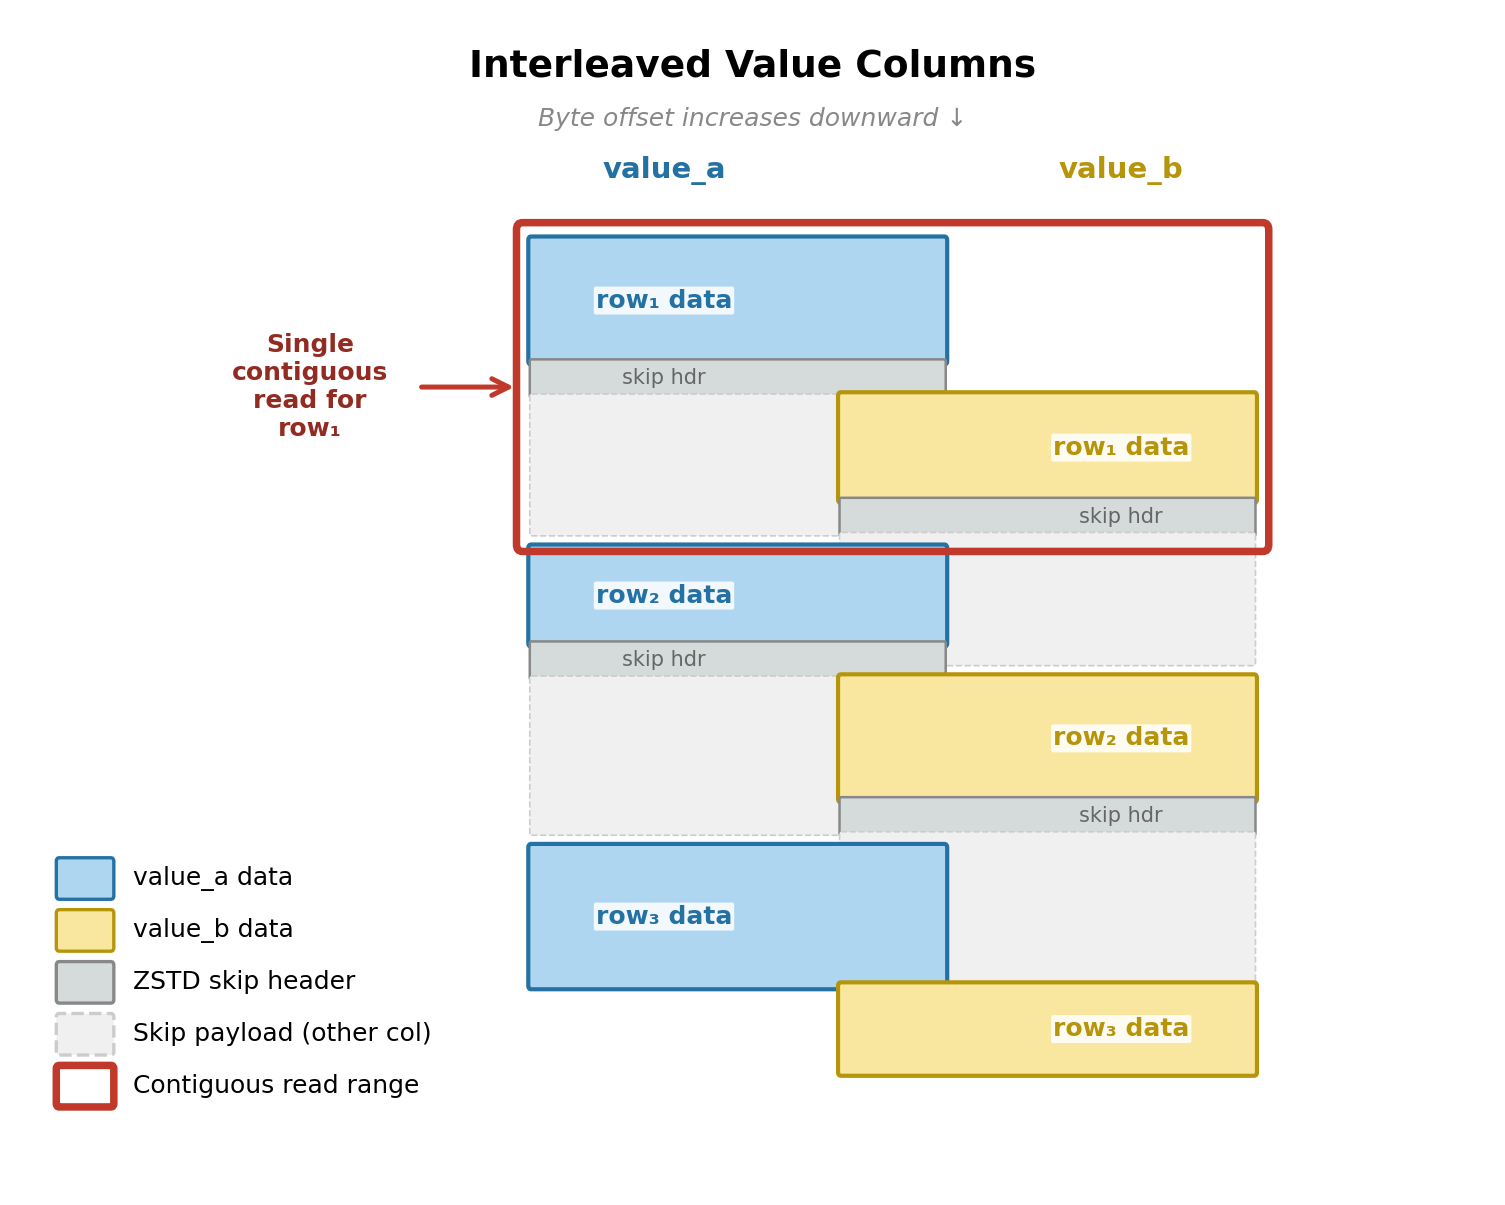
这实际上把选定列组转成按行组织的布局,同时保持向后兼容。代价是传统读取器读取单个交错列时,也把其他列的数据当作空白区读入,放大单列扫描 I/O。本地存储通常由操作系统缓存吸收这个影响;云存储读取器则需要合并重叠读取。
对于部分拆解的 Variant 列,列交错尤其有用:类型化列支持快速向量化分析,与它们相邻存放的 variant blob 则让 RAP 一次读取取齐数据,并使分析读取器的额外开销较小。
覆盖索引与提升值:索引构建时会访问每行。较小的值可以直接提升到索引条目中,形成覆盖索引,完全省去存储读取,将读取次数降为零。预计算聚合也可以这样做,例如每键事件数量、总播放时长、分类统计,都能以索引查询速度取得。提升值还支持索引层谓词下推,在任何存储读取前过滤条目。
优化汇总
| 优化 | 点查收益 | 分析场景的代价 |
|---|---|---|
| 按键排序 | 每键涉及更少文件与页 | 无 |
| 共同分组 | 每键一行,自然集中 | 无 |
| 更粗分区 | 跨时间涉及更少文件 | 分区裁剪更粗 |
| 每键一个页 | 整个页就是结果 | PageIndex 略有增长 |
| 重置 ZSTD 帧 | O(1)访问且不增加页数量 | 汇总表写为仅PLAIN编码;文件略增大 |
| Blob / Variant | 每键一次单列读取 | 无法按字段裁剪 |
| 列交错 | 一次连续读取所有列 | 单列扫描I/O增加 |
| 存储对齐 | 边界处没有读放大 | 文件略增大 |
| 覆盖索引 | 完全不读取存储 | 索引增大 |
结合这些优化,一个点查可以缩到只需读取数 KB 的一次范围读取,或者完全省去存储读取。
二级索引
一个数据集可以有多个查询维度,例如交易数据同时按 buyer_id 和 seller_id 查询。RAP 为同一批索引条目建立多个访问结构,每个维度一个:哈希表提供 O(1) 精确查询,有序索引支持范围查询。增加或删除二级索引是服务层的决定,无需修改流水线或重写数据。
文件布局偏向数据排序采用的维度。二级查询可能分散到更多文件,但读取器会自动合并相邻字节范围。Z-order、Hilbert 曲线等空间填充曲线是互补手段:它们在文件布局层改善二级维度的局部性,而二级索引提供访问路径。
结论
RAP 的关键属性是使用数据湖现有的同一批 Parquet 文件。BigQuery 为每周聚合报告扫描的文件,与 AI 智能体用于上下文检索的文件相同,无需复制、ETL 或第二份存储账单。
这改变了哪些数据可以在线服务的经济性。今天,团队因每GB成本而必须艰难取舍 KV 存储内容。采用 RAP,点查成本降到一次云存储读取的成本。历史数据、长尾实体、低流量功能,都可能提供交互式访问。AI 智能体不再把上下文限制为 KV 存储中的数据,可以回溯数月、数年,访问整个数据湖。
数据湖不再仅用于批量处理。同一存储支持分析与交互两类负载:一个数据集,两种访问模式。










暂无评论内容