
排序
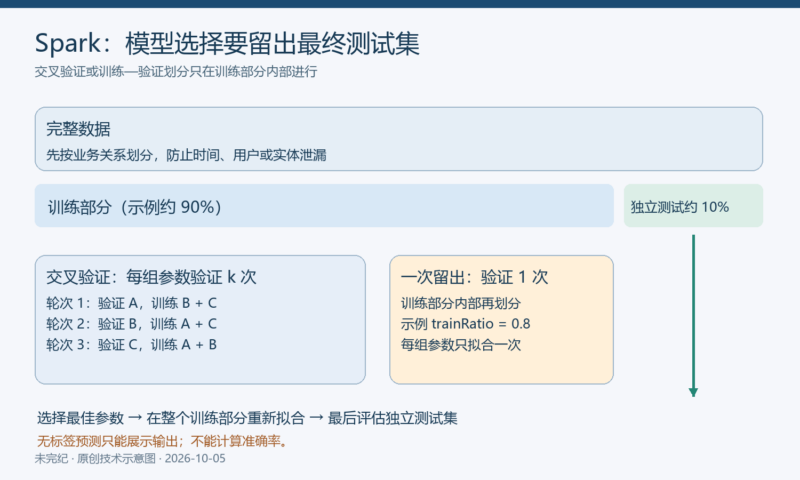
用 Spark 交叉验证和留出集选择模型参数
从 ParamGrid、Pipeline 和 Evaluator 出发比较交叉验证与一次留出,明确训练成本、独立测试集、随机性、数据泄漏和原示例的评价边界。

 10小时前
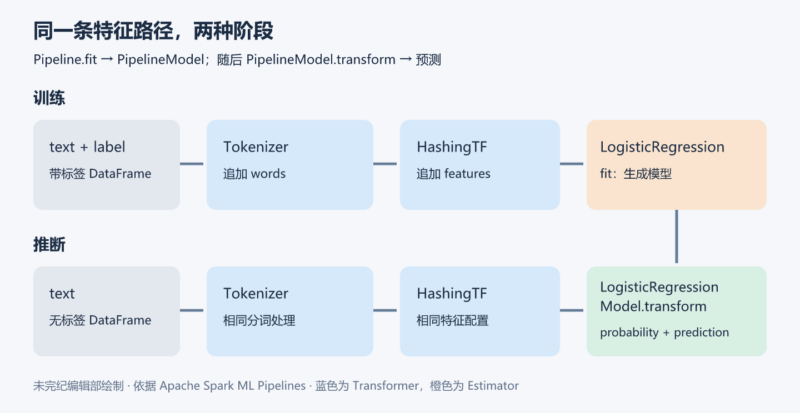
把文本特征处理与分类训练串成 Spark Pipeline
把 Tokenizer、HashingTF 和逻辑回归连成可复用的文本处理流程,理解 Pipeline 与 PipelineModel 的训练推断关系、参数覆盖和持久化边界。
8小时前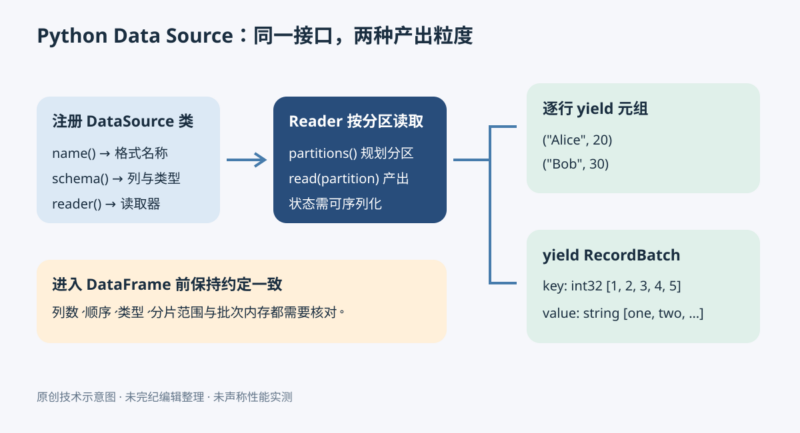
为 PySpark 注册按行和 Arrow 批次读取的数据源
完整实现两个Python批读取数据源:以元组逐行产出,或直接yield Arrow RecordBatch,理解注册、schema、分区与序列化约束。
10小时前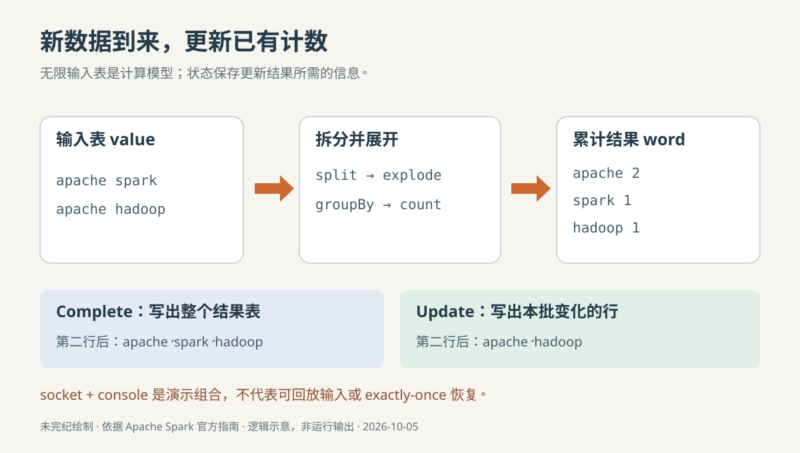
用 Spark Structured Streaming 持续统计输入文本
从本地 socket 词频示例理解流式 DataFrame、增量结果表和三种输出模式,并区分事件时间、水位线与端到端容错的真正前提。
7小时前