


多语言 BERT(mBERT)和 XLM-RoBERTa 的问题在于,直接使用时生成的句子表示效果较差,而且不同语言的向量空间没有对齐:不同语言表达相同内容的句子,会映射到向量空间的不同位置。
论文 Making Monolingual Sentence Embeddings Multilingual using Knowledge Distillation 介绍了一种把句向量扩展到更多语言的简单方法。
Chien Vu 也撰写了介绍该技术的文章:A complete guide to transfer learning from English to other Languages using Sentence Embeddings BERT Models。
扩展自己的模型
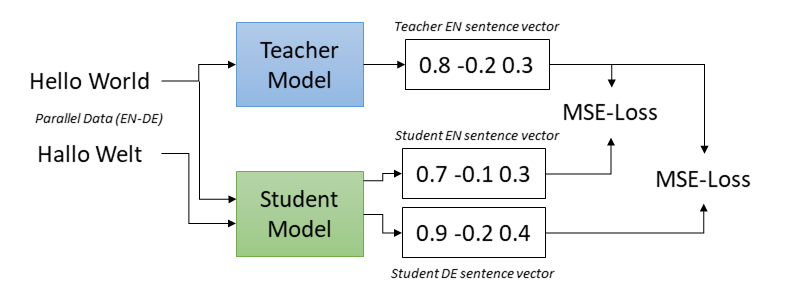
该方法使用固定的单语言教师模型,它能为某种语言(如英语)生成具有所需性质的句向量。学生模型学习模仿教师:同一个英语句子,两个模型应映射到同一向量。为了让学生支持其他语言,还要用平行译文训练。
每个句子的译文也应映射到与原句相同的向量。
上图中,学生应把 Hello World 和德语 Hallo Welt 都映射到 teacher_model('Hello World') 的向量。使用均方误差(MSE)损失训练可实现这一目标。
实验中,学生模型以多语言 XLM-RoBERTa 初始化。
训练
完整自动化代码示例见原文链接的 make_multilingual.py。
该脚本下载包含演讲转录与译文的平行句子语料,再把单语言模型扩展到英语、德语、西班牙语、意大利语、法语、阿拉伯语和土耳其语(en、de、es、it、fr、ar、tr)。语料包含一百多种语言的平行数据,因此可以修改脚本,训练所需语言的模型。
数据集
训练需要平行句子,即同一内容在不同语言中的译文。这里使用带 english 与 non_english 列的 Dataset 实例。Sentence Transformers 的 Parallel Sentences 数据集合集已准备大量此类数据。
训练脚本读取 english 列,新增 label 列,其中存放英语文本的向量。随后训练学生,使其对 english 和 non_english 产生的向量都接近 label。载入示例:
from datasets import load_dataset

train_dataset = load_dataset("sentence-transformers/parallel-sentences-talks", "en-de", split="train")
print(train_dataset[0])
# {"english": "So I think practicality is one case where it's worth teaching people by hand.", "non_english": "Ich denke, dass es sich aus diesem Grund lohnt, den Leuten das Rechnen von Hand beizubringen."}
训练数据来源
OPUS 提供四百多种语言的平行数据集,可用于创建自己的平行句子数据。
评估
训练可从不同角度评估,具体用法参见 make_multilingual.py。
MSE 评估
可以测量学生向量与教师向量之间的均方误差:
from datasets import load_dataset

eval_dataset = load_dataset("sentence-transformers/parallel-sentences-talks", "en-fr", split="dev")

dev_mse = MSEEvaluator(
    source_sentences=eval_dataset["english"],
    target_sentences=eval_dataset["non_english"],
    name="en-fr-dev",
    teacher_model=teacher_model,
    batch_size=32,
)
该评估器对 source_sentences(如英语)计算教师向量;训练过程中用学生模型为 target_sentences(如法语)计算向量,并测量两者距离。分数越低越好。
翻译准确率
也可以测量翻译匹配准确率。输入为 source_sentences(如英语)和 target_sentences(如西班牙语)两个列表,要求第 i 个目标句是第 i 个源句的译文。
对每对句子,检查与 source_sentences[i] 最相似的目标句是否为 target_sentences[i]。是则命中,否则错误。评估器报告准确率,越高越好。
from datasets import load_dataset

eval_dataset = load_dataset("sentence-transformers/parallel-sentences-talks", "en-fr", split="dev")

dev_trans_acc = TranslationEvaluator(
    source_sentences=eval_dataset["english"],
    target_sentences=eval_dataset["non_english"],
    name="en-fr-dev",
    batch_size=32,
)
多语言语义文本相似度
还可以测量不同语言句对之间的语义文本相似度(STS):
from datasets import load_dataset

test_dataset = load_dataset("mteb/sts17-crosslingual-sts", "nl-en", split="test")

test_emb_similarity = EmbeddingSimilarityEvaluator(
    sentences1=test_dataset["sentence1"],
    sentences2=test_dataset["sentence2"],
    scores=[score / 5.0 for score in test_dataset["score"]],  # Convert 0-5 scores to 0-1 scores
    batch_size=32,
    name=f"sts17-nl-en-test",
    show_progress_bar=False,
)
sentences1 和 sentences2 为句子列表,score 是表示两个列表第 i 个句子之间语义相似度的数值。
可用预训练模型
可用模型列表见 预训练模型。
使用
模型可按下列方式使用:
from sentence_transformers import SentenceTransformer

model = SentenceTransformer("sentence-transformers/paraphrase-multilingual-MiniLM-L12-v2")
embeddings = model.encode(["Hello World", "Hallo Welt", "Hola mundo", "Bye, Moon!"])
similarities = model.similarity(embeddings, embeddings)
# tensor([[1.0000, 0.9429, 0.8880, 0.4558],
#         [0.9429, 1.0000, 0.9680, 0.5307],
#         [0.8880, 0.9680, 1.0000, 0.4933],
#         [0.4558, 0.5307, 0.4933, 1.0000]])
性能
性能在 STS 2017 数据集上评估。任务是预测两个句子的语义相似度,范围 0–5。STS2017 包含英语、阿拉伯语、西班牙语的单语言测试,以及英语—阿拉伯语、英语—西班牙语、英语—土耳其语跨语言测试。
研究者扩展了 STS2017,加入英语—德语、法语—英语、意大利语—英语及荷兰语—英语测试数据。性能以预测相似度与标准分数之间的 Spearman 相关系数衡量。
| 模型 | AR-AR | AR-EN | ES-ES | ES-EN | EN-EN | TR-EN | EN-DE | FR-EN | IT-EN | NL-EN | 平均 |
| XLM-RoBERTa mean pooling | 25.7 | 17.4 | 51.8 | 10.9 | 50.7 | 9.2 | 21.3 | 16.6 | 22.9 | 26.0 | 25.2 |
| mBERT mean pooling | 50.9 | 16.7 | 56.7 | 21.5 | 54.4 | 16.0 | 33.9 | 33.0 | 34.0 | 35.6 | 35.3 |
| LASER | 68.9 | 66.5 | 79.7 | 57.9 | 77.6 | 72.0 | 64.2 | 69.1 | 70.8 | 68.5 | 69.5 |
Sentence Transformer 模型:
| sentence-transformers/distiluse-base-multilingual-cased | 75.9 | 77.6 | 85.3 | 78.7 | 85.4 | 75.5 | 80.3 | 80.2 | 80.5 | 81.7 | 80.1 |
引用
使用多语言模型代码时,可以引用上述论文:
@article{reimers-2020-multilingual-sentence-bert,
    title = "Making Monolingual Sentence Embeddings Multilingual using Knowledge Distillation",
    author = "Reimers, Nils and Gurevych, Iryna",
    journal= "arXiv preprint arXiv:2004.09813",
    month = "04",
    year = "2020",
    url = "http://arxiv.org/abs/2004.09813",
}
—
原文:Multilingual Models。作者:Sentence Transformers 项目贡献者;相关论文作者 Nils Reimers、Iryna Gurevych。本文为中文翻译。代码、文档及示意图沿用项目 Apache-2.0 许可。外部数据集与模型的许可应以各自发布页为准。











暂无评论内容