


埃拉托色尼筛法用于找出区间 [1, n] 中的全部素数,所需操作次数为 O(n log log n)。
算法很简单:先写下 2 到 n 之间的所有整数。因为 2 是最小的素数,先把 2 的所有真倍数标记为合数。一个数 x 的真倍数,是大于 x 且能被 x 整除的数。然后找到下一个尚未被标记为合数的数,这里是 3。于是 3 是素数,再把 3 的所有真倍数标记为合数。
下一个未标记的数是 5,也就是下一个素数,再标记它的所有真倍数。不断重复这一过程,直到处理完这一行中的所有数。
下图展示了计算区间 [1, 16] 中全部素数的过程。可以看到,同一个合数经常会被重复标记。
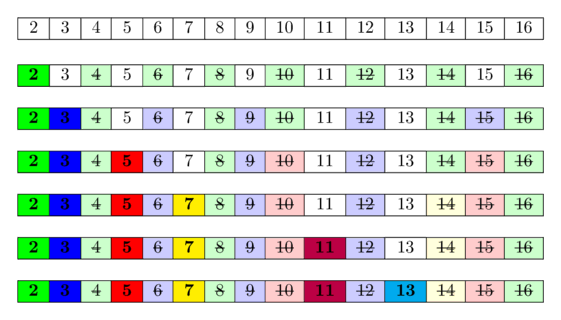
背后的原理是:若一个数不能被任何更小的素数整除,它就是素数。我们按递增顺序遍历素数,因此任何能被至少一个较小素数整除的数,都已被标记。到达某个未标记的位置时,该数不能被任何更小的素数整除,所以必为素数。
实现
int n;
vector<bool> is_prime(n+1, true);
is_prime[0] = is_prime[1] = false;
for (int i = 2; i <= n; i++) {
    if (is_prime[i] && (long long)i * i <= n) {
        for (int j = i * i; j <= n; j += i)
            is_prime[j] = false;
    }
}
这段代码先把 0 和 1 之外的所有数标记为候选素数,然后筛去合数。遍历 2 到 n 的整数;若当前整数 i 是素数,就从 i² 开始,把 i 的所有倍数标记为合数。
从 i² 开始已经是对朴素实现的优化。所有小于 i² 的 i 的倍数,必然还包含一个小于 i 的素因子,因此早已被筛去。由于 i² 很容易超出 int 的范围,进入第二层循环前,额外用 long long 类型进行检查。
这种实现需要 O(n) 的存储空间,执行 O(n log log n) 次操作,后者的分析见下一节。
渐近复杂度分析
即使不了解素数的分布,也容易证明时间复杂度为 O(n log n)。忽略 is_prime 检查,对于 i = 2, 3, 4, …,内层循环至多运行 n/i 次,因此内层循环的总操作次数类似调和和式 n(1/2 + 1/3 + 1/4 + …),其上界是 O(n log n)。
下面说明为什么实际运行时间为 O(n log log n)。对于每个不大于 n 的素数 p,内层循环执行 n/p 次操作,因此需要估计:
Σ(p ≤ n 且 p 为素数) n/p = n · Σ(p ≤ n 且 p 为素数) 1/p。
回顾两个已知事实:
- 不大于 n 的素数个数约为
n / ln n。 - 第 k 个素数约为
k ln k,这可由上一个事实得到。
于是可将求和近似写为:
Σ(p ≤ n 且 p 为素数) 1/p ≈ 1/2 + Σ(k = 2 … n/ln n) 1/(k ln k)。
这里单独提出了第一个素数 2,因为当 k = 1 时,近似式 k ln k 的值为 0,会造成除以零。
现在,用同一函数在 k 从 2 到 n/ln n 上的积分估计这个和。这样的近似是可行的,因为求和实际上相当于使用矩形法近似积分:
Σ(k = 2 … n/ln n) 1/(k ln k) ≈ ∫[2, n/ln n] (1/(k ln k)) dk。
被积函数的一个原函数是 ln ln k。代入上下限并忽略低阶项,可得:
∫[2, n/ln n] (1/(k ln k)) dk = ln ln(n/ln n) − ln ln 2 = ln(ln n − ln ln n) − ln ln 2 ≈ ln ln n。
回到原来的求和,便得到近似估计:
Σ(p ≤ n 且 p 为素数) n/p ≈ n ln ln n + o(n)。
更严格的证明,以及精确到常数因子的更细致估计,可见 Hardy 与 Wright 的《An Introduction to the Theory of Numbers》第 349 页。
埃拉托色尼筛法的不同优化
这项算法最大的弱点是多次沿着内存遍历,每次只操作单个元素,缓存局部性较差。因此,O(n log log n) 隐藏的常数相对较大。
此外,n 很大时,内存占用也会成为瓶颈。
下面的方法既能减少操作次数,也能明显降低内存占用。
只筛到平方根
要找出不大于 n 的全部素数,只需要使用不超过 √n 的素数进行筛选。
int n;
vector<bool> is_prime(n+1, true);
is_prime[0] = is_prime[1] = false;
for (int i = 2; i * i <= n; i++) {
    if (is_prime[i]) {
        for (int j = i * i; j <= n; j += i)
            is_prime[j] = false;
    }
}
这一优化不会改变渐近复杂度。重复上面的证明可得到 n ln ln √n + o(n),根据对数性质,其渐近阶数不变,但操作次数会明显减少。
只处理奇数
除 2 以外的所有偶数都是合数,因此可以完全不再检查偶数,只处理奇数。
这首先可以把所需内存减半;其次,算法执行的操作次数也大致减半。
内存占用与操作速度
上述两种实现都使用 vector<bool>,因此需要 n 位内存。vector<bool> 不是一般意义上存储一系列 bool 的容器——在大多数计算机体系结构中,单个 bool 占一个字节。它是 vector<T> 为节省内存而提供的特化,大约只需要 N/8 字节。
现代处理器通常不能直接访问单个位,对字节的处理比对位更高效。vector<bool> 的底层把位保存在一大片连续内存中,以若干字节为单位访问,再通过位掩码、移位等位运算提取或设置相应的位。
因此,使用 vector<bool> 读写位有额外开销,很多情况下 vector<char> 会更快;后者每个元素占一个字节,内存需求是前者的 8 倍。
不过,对于这里的简单筛法实现,vector<bool> 更快。此时瓶颈在于将数据加载到缓存的速度,减少内存需求有显著优势。原文引用的 基准测试 显示,vector<bool> 比 vector<char> 快约 1.4 至 1.7 倍。
这些分析也适用于 bitset。它与 vector<bool> 一样能高效保存位,约需 N/8 字节,但访问元素稍慢。在上述基准测试中,bitset 的表现略差于 vector<bool>。它的另一项缺点是大小必须在编译时确定。
分段筛
由“只筛到平方根”的优化可知,无需始终保留完整的 is_prime[1...n] 数组。只要保存不大于 √n 的素数,也就是 prime[1...sqrt(n)],将整个范围划分为块,再分别筛选每块即可。
设常数 s 为块大小,总共需要 ⌈n/s⌉ 块;第 k 块(k = 0 … ⌊n/s⌋)包含区间 [ks, ks+s−1]。可以逐块处理:对每一块 k,遍历 1 到 √n 范围中的全部素数,并用它们筛去合数。
处理最初的一批数时,需要稍微调整策略:区间 [1, √n] 中的素数不能把自己筛去,0 和 1 则必须标记为非素数。处理最后一块时,还要记得所需的最后一个数 n 未必位于该块末尾。
如前所述,普通筛法受限于将数据加载到 CPU 缓存的速度。将候选素数区间 [1, n] 分成更小的块后,无需同时在内存中保存多块,所有操作的缓存局部性都更好。
现在缓存加载速度不再是主要瓶颈,就可以用 vector<char> 替代 vector<bool>,进一步提升性能。处理器可以直接按字节读写,无需依赖位运算提取单个位。原文的 基准测试 显示,此时 vector<char> 大约比 vector<bool> 快 3 倍。
下面的实现使用分块筛法,统计不大于 n 的素数个数。
int count_primes(int n) {
    const int S = 10000;

    vector<int> primes;
    int nsqrt = sqrt(n);
    vector<char> is_prime(nsqrt + 2, true);
    for (int i = 2; i <= nsqrt; i++) {
        if (is_prime[i]) {
            primes.push_back(i);
            for (int j = i * i; j <= nsqrt; j += i)
                is_prime[j] = false;
        }
    }

    int result = 0;
    vector<char> block(S);
    for (int k = 0; k * S <= n; k++) {
        fill(block.begin(), block.end(), true);
        int start = k * S;
        for (int p : primes) {
            int start_idx = (start + p - 1) / p;
            int j = max(start_idx, p) * p - start;
            for (; j < S; j += p)
                block[j] = false;
        }
        if (k == 0)
            block[0] = block[1] = false;
        for (int i = 0; i < S && start + i <= n; i++) {
            if (block[i])
                result++;
        }
    }
    return result;
}
除非块大小非常小,分块筛的运行时间与普通埃拉托色尼筛法相同;所需内存则降为 O(√n + S),缓存效果也更好。另一方面,区间 [1, √n] 中的每个素数与每一块的组合都要进行一次除法,块很小时,这会明显恶化性能。因此选择常数 S 时,需要在两者之间取得平衡。
原作者在块大小为 10⁴ 到 10⁵ 时取得了最佳结果。
找出指定区间中的素数
有时需要找出一个较短区间 [L, R] 中的全部素数,例如 R−L+1 ≈ 10⁷,但 R 本身可能很大,例如 10¹²。
可以采用分段筛的思路:预先生成不大于 √R 的全部素数,再用这些素数标记区间 [L, R] 中的合数。
vector<char> segmented_sieve(long long L, long long R) {
    // generate all primes up to sqrt(R)
    long long lim = sqrt(R);
    vector<char> mark(lim + 1, false);
    vector<long long> primes;
    for (long long i = 2; i <= lim; ++i) {
        if (!mark[i]) {
            primes.emplace_back(i);
            for (long long j = i * i; j <= lim; j += i)
                mark[j] = true;
        }
    }

    vector<char> isPrime(R - L + 1, true);
    for (long long i : primes)
        for (long long j = max(i, (L + i - 1) / i) * i; j <= R; j += i)
            isPrime[j - L] = false;
    for (long long x = L; x <= min(R, 1LL); x++)
        isPrime[x - L] = false;
    return isPrime;
}
这一方法的时间复杂度为 O((R−L+1) log log R + √R log log √R)。
也可以不预先生成素数:
vector<char> segmented_sieve_no_pre_gen(long long L, long long R) {
    vector<char> isPrime(R - L + 1, true);
    long long lim = sqrt(R);
    for (long long i = 2; i <= lim; ++i)
        for (long long j = max(i, (L + i - 1) / i) * i; j <= R; j += i)
            isPrime[j - L] = false;
    for (long long x = L; x <= min(R, 1LL); x++)
        isPrime[x - L] = false;
    return isPrime;
}
显然,此时复杂度较差,为 O((R−L+1) log R + √R)。不过,它在实际使用中仍然很快。
线性时间的改进
可以修改算法,使时间复杂度降为线性。这种方法见 线性筛,不过它也有自己的不足。
练习题
- LeetCode:四因数
- LeetCode:计数质数
- LeetCode:范围内最接近的两个质数
- SPOJ:Printing Some Primes
- SPOJ:A Conjecture of Paul Erdos
- SPOJ:Primal Fear
- SPOJ:Primes Triangle (I)
- Codeforces:Almost Prime
- Codeforces:Sherlock And His Girlfriend
- SPOJ:Namit in Trouble
- SPOJ:Bazinga!
- Project Euler:Prime pair connection
- SPOJ:N-Factorful
- SPOJ:Binary Sequence of Prime Numbers
- UVA 11353:A Different Kind of Sorting
- SPOJ:Prime Generator
- SPOJ:Printing some primes (hard)
- Codeforces:Nodbach Problem
- Codeforces:Colliders











暂无评论内容