


原作者反复分析应用性能后得到的经验是:应当把更多工作直接放到数据库内完成。
什么是 CRUD?
CRUD 就是创建、读取、更新和删除,是操作一个或多个表中不断变化的数据所需的基本动作。
多数示例和思考方式一次只关注一张表,容易理解,却不太现实。即使最简单的应用,也会使用多个关联的规范化表。
下面是本教程的表结构:
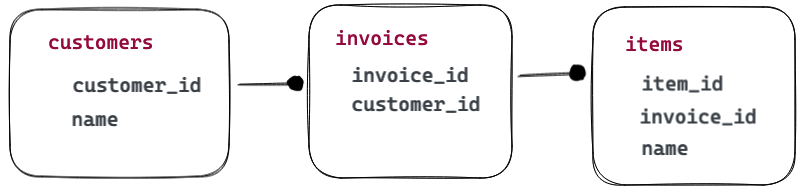
创建表
 DROP TABLE customers, invoices, items;

CREATE TABLE customers (
    customer_id BIGINT GENERATED ALWAYS AS IDENTITY PRIMARY KEY,
    name TEXT NOT NULL UNIQUE
    );

CREATE TABLE invoices (
    invoice_id BIGINT GENERATED ALWAYS AS IDENTITY PRIMARY KEY,
    customer_id BIGINT REFERENCES customers (customer_id)
    );

CREATE TABLE items (
    item_id BIGINT GENERATED ALWAYS AS IDENTITY PRIMARY KEY,
    invoice_id BIGINT REFERENCES invoices (invoice_id),
    name TEXT NOT NULL
    );
最简单的 CRUD
很多数据管理代码始终一次只操作一张表。例如填充 customers:
INSERT INTO customers (name) VALUES ('Ben');
其实一条 INSERT 可以插入多行,带来多项性能优势:
- 服务器只需识别一次列和类型,开销分摊到全部插入行。
- 整个插入只有一个事务块,事务开销同样分摊。
- 写出来也很利落!
 INSERT INTO customers (name)
    VALUES ('Peter'), ('Paul'), ('Mary');
更新和删除时,常见做法同样是一次一行、一次一表:
 UPDATE customers
  SET name = 'Jen'
  WHERE name = 'Ben';

DELETE FROM customers
  WHERE name = 'Jen';
更复杂的 CRUD
填充规范化关系模型的难点之一,是让多张表的键正确对应。
通常使用 BIGINT GENERATED ALWAYS AS IDENTITY 自动生成主键,但创建引用新行的其他记录时,必须取得刚生成的键。
下面在一次 SQL 调用中创建发票,并添加引用它的商品行。注意 RETURNING 返回新生成的 invoice_id 结果集:
WITH new_invoice AS (
    /* Add a fresh invoice and return the newly created id */
    INSERT INTO invoices (customer_id)
        SELECT customer_id FROM customers WHERE name = 'Mary'
        RETURNING invoice_id
)
/* Add the items, using the new invoice id */
INSERT INTO items (name, invoice_id)
    SELECT n.name, new_invoice.invoice_id
    FROM new_invoice
    CROSS JOIN
    (VALUES ('Purple Automobile'),
            ('Yellow Automobile')) AS n(name);
再利用 RETURNING 与数组,为全部客户快速填充数据:
 WITH i AS (
    /* Insert three new invoices for each customer */
    /* returning the invoice_id for each one */
    INSERT INTO invoices (customer_id)
        SELECT customer_id
        FROM customers
        CROSS JOIN generate_series(1,3)
        RETURNING invoice_id
)
/* Insert three new items for each invoice */
/* Each items is a "colored vehicle", with a */
/* distinct color for each item on an invoice, */
/* and a single kind of vehicle for each invoice */
INSERT INTO items (invoice_id, name)
    SELECT i.invoice_id,
        Format('%s %s',
            c,
            (ARRAY['Train', 'Plane', 'Automobile'])[i.invoice_id % 3 + 1]) AS name
    FROM unnest(ARRAY['Red', 'Blue', 'Green']) AS c
    CROSS JOIN i;
读取
连接两端的关联键列名相同时,PostgreSQL 的 USING 可以简洁地连接多表:
 SELECT *
FROM customers
JOIN invoices USING (customer_id)
JOIN items USING (invoice_id)
WHERE customers.name = 'Paul'
ORDER BY customers.name, invoice_id;
查询结果显示 Paul 喜欢汽车,每张发票都各买一种颜色:
 invoice_id | customer_id | name | item_id |       name
------------+-------------+------+---------+------------------
          2 |           2 | Paul |      11 | Blue Automobile
          2 |           2 | Paul |       2 | Red Automobile
          2 |           2 | Paul |      20 | Green Automobile
          5 |           2 | Paul |      14 | Blue Automobile
          5 |           2 | Paul |       5 | Red Automobile
          5 |           2 | Paul |      23 | Green Automobile
          8 |           2 | Paul |       8 | Red Automobile
          8 |           2 | Paul |      26 | Green Automobile
          8 |           2 | Paul |      17 | Blue Automobile
实际上,Peter、Paul 和 Mary 分别收集不同交通工具:
 SELECT DISTINCT
    customers.name,
    split_part(items.name, ' ', 2) AS vehicle
FROM customers
JOIN invoices USING (customer_id)
JOIN items USING (invoice_id);
 name  |  vehicle
-------+------------
 Paul  | Automobile
 Peter | Plane
 Mary  | Train
一定要连接表才能获得这些答案吗?不是,也可以把全部记录拉到客户端,再用应用逻辑汇总,但会慢很多。
将逻辑保留在数据库中,既能让系统规划最快的执行方式,也能避免昂贵的网络传输和大量往返。
更新
现在把 Mary 的所有蓝色商品改成紫色。
“一次一表”的方式可能是:
- 开启事务。
- 查询 customers,取得 Mary 的 customer_id。
- 查询 invoices,取得她的所有 invoice_id。
- 更新这些发票的 items,将蓝色改为紫色。
- 提交事务。
但这样需要三条查询,直觉上就比一条慢。单条语句如下:
 /* Target table to change */
UPDATE items
/* Change to apply to target rows */
SET name = replace(items.name, 'Blue', 'Purple')
/* Other relations to use in finding target rows */
FROM customers, invoices
/* Restriction on relations to find just target rows */
WHERE customers.customer_id = invoices.customer_id
AND invoices.invoice_id = items.invoice_id
AND customers.name = 'Mary'
AND items.name ~ '^Blue';
主要难点是将 items 关联到 customers 中的 Mary。加入 customers 与 invoices 后,就建立了从 Mary 到商品的路径,再将目标行限制为蓝色商品。
用 RETURNING 同时查看旧值与新值
Postgres 18 允许 UPDATE、DELETE、INSERT 和 MERGE 在一条语句中同时返回 OLD 与 NEW 行版本,适合审计日志、变更流或确认实际修改:
 UPDATE items
SET name = replace(items.name, 'Purple', 'Violet')
FROM customers, invoices
WHERE customers.customer_id = invoices.customer_id
AND invoices.invoice_id = items.invoice_id
AND customers.name = 'Mary'
AND items.name ~ '^Purple'
RETURNING OLD.name AS before_name, NEW.name AS after_name;
删除
Peter 不再喜欢红色,因此只从他的发票中删除红色商品。
也可以分多步查找客户、发票、商品再删除,但一条语句就能完成:
 DELETE FROM items
USING invoices, customers
WHERE items.invoice_id = invoices.invoice_id
AND invoices.customer_id = customers.customer_id
AND customers.name = 'Peter'
AND items.name ~ 'Red';
关键字略有不同:DELETE 使用 USING 指定非目标关系,UPDATE 使用 FROM,原理相同。
先找到连接筛选条件所需的关系,本例是客户 Peter 与红色商品,再在 WHERE 中通过外键连接它们。
结语
直接在数据库内完成工作通常更快:
- 规划器统计信息和其他元数据,让数据库更了解数据。
- 数据库比任何客户端更接近数据。
- 将数据传给客户端代价高。
- 数据库擅长一次处理整个关系和多条记录,比客户端逐条操作更高效。
原文:SQL Tricks for More Effective CRUD。作者/维护方:Crunchy Data 教程团队。本文为中文翻译,代码及命令保留原文。
原站版权声明:© 2018–2026 Crunchy Data Solutions, Inc.











暂无评论内容