


NumPy:零基础入门
欢迎阅读面向完全初学者的 NumPy 指南!
NumPy(Numerical Python)是广泛用于科学与工程的开源 Python 库。它提供多维数组数据结构,例如元素类型一致的 N 维 ndarray,以及高效操作这些结构的大量函数。更多介绍见“什么是 NumPy”;如果有意见或建议,欢迎联系 NumPy 社区。[1][2]
如何导入 NumPy
安装 NumPy 后,可以在 Python 代码中这样导入:[3]
import numpy as np
这是广泛采用的约定:用简短、易识别的 np. 前缀访问 NumPy 功能,也能将其与其他同名功能区分开来。
如何阅读示例代码
NumPy 文档中经常出现这样的代码块:
>>> a = np.array([[1, 2, 3],
...               [4, 5, 6]])
>>> a.shape
(2, 3)
带有 >>> 或 ... 前缀的是输入,即写入脚本或 Python 提示符的代码;其余内容是输出,即执行结果。注意,>>> 和 ... 并非代码的一部分,直接输入 Python 提示符可能导致错误。
可以把示例复制到 Python 脚本或 REPL 中运行,也可以使用文档各处提供的实验性浏览器交互示例。
为什么使用 NumPy
Python 列表是优秀的通用容器,可以是异质的,即同时包含不同类型的元素。对少量元素分别执行操作时,列表的速度也很快。
不过,根据数据特征和所需操作,其他容器可能更合适。利用这些特征,可以提高速度、减少内存消耗,并用高级语法完成常见处理任务。当需要在 CPU 上处理大量同质、也就是相同类型的数据时,NumPy 尤其出色。
什么是数组
在编程中,数组是存取数据的一种结构。可以把它想象成空间中的网格,每个单元保存一个数据元素。例如,如果每个元素都是数字,一维数组可以画成列表:
\hline
1 & 5 & 2 & 0 \\
\hline
\end{array}\end{split}\]
二维数组则像一张表:
\hline
1 & 5 & 2 & 0 \\
\hline
8 & 3 & 6 & 1 \\
\hline
1 & 7 & 2 & 9 \\
\hline
\end{array}\end{split}\]
三维数组类似一组表,可以想象为打印在不同纸页上、堆叠起来的表。NumPy 将这一概念推广到任意维数,因此其基本数组类名为 ndarray,表示 N 维数组。
多数 NumPy 数组有一些限制,例如:
-
所有元素的数据类型必须相同。
-
创建后,数组的元素总数不能改变。
-
形状必须规则,不能参差不齐;例如二维数组的每一行必须拥有相同列数。
满足这些条件后,NumPy 能利用这些特征,使数组比限制更少的数据结构更快、更节省内存,也更方便使用。
本文下文使用“数组”一词时,指的是 ndarray 的实例。
数组基础
可以使用 Python 序列(例如列表)初始化数组:
>>> a = np.array([1, 2, 3, 4, 5, 6])
>>> a
array([1, 2, 3, 4, 5, 6])
访问数组元素有多种方式。例如,与访问原列表一样,可以在方括号内使用整数索引访问单个元素。[4]
>>> a[0]
1
注意
与 Python 内置序列一样,NumPy 数组从 0 开始索引:第一个元素的索引是 0,而不是 1。
与原列表一样,数组是可变的。
>>> a[0] = 10
>>> a
array([10,  2,  3,  4,  5,  6])
同样可以使用 Python 切片语法索引数组。
>>> a[:3]
array([10, 2, 3])
一个重要区别是:列表切片会把元素复制到新列表,而数组切片返回视图——引用原数组数据的对象。通过视图修改数据,也会修改原数组。
>>> b = a[3:]
>>> b
array([4, 5, 6])
>>> b[0] = 40
>>> a
array([ 10,  2,  3, 40,  5,  6])
有关哪些操作返回视图而非副本的完整说明,参见“副本与视图”。[5]
二维及更高维数组可以由嵌套的 Python 序列初始化:
>>> a = np.array([[1, 2, 3, 4], [5, 6, 7, 8], [9, 10, 11, 12]])
>>> a
array([[ 1,  2,  3,  4],
       [ 5,  6,  7,  8],
       [ 9, 10, 11, 12]])
在 NumPy 中,数组的一个维度有时称为“轴”。这个术语有助于区分数组本身的维数和数组所表示数据的维数。例如,数组 a 可以表示四维空间中的三个点,但 a 本身只有两个轴。
与列表嵌套列表的另一个区别是:在同一对方括号中,用逗号分隔各轴索引,就可以访问数组元素。例如元素 8 位于行索引 1、列索引 3:
>>> a[1, 3]
8
注意
数学中通常先写矩阵的行索引,再写列索引。二维数组也如此,但更通用的理解是:列索引放在最后,行索引放在倒数第二。这样便能推广到任意维数的数组。
注意
你可能听过将零维数组称为标量、一维数组称为向量、二维数组称为矩阵、N 维数组(通常 N 大于 2)称为张量。为避免混淆,谈论数组时最好避免这些数学名称,因为同名数学对象的行为可能不同,例如矩阵乘法与数组乘法根本不同;科学 Python 生态中也有其他对象使用这些名称,例如 PyTorch 的基本数据结构就是 tensor。
数组属性
本节介绍数组的 ndim、shape、size 和 dtype 属性。
ndim 保存数组的维数。
>>> a.ndim
2
数组形状是非负整数元组,指定每个维度的元素数量。
>>> a.shape
(3, 4)
>>> len(a.shape) == a.ndim
True
size 保存数组固定的元素总数。
>>> a.size
12
>>> import math
>>> a.size == math.prod(a.shape)
True
数组通常是同质的,即只包含一种数据类型的元素。该类型记录在 dtype 属性中。
>>> a.dtype
dtype('int64')  # "int" for integer, "64" for 64-bit
如何创建基本数组
本节介绍 np.zeros()、np.ones()、np.empty()、np.arange()、np.linspace()。
除了由元素序列创建数组,还能方便地创建全 0 数组:
>>> np.zeros(2)
array([0., 0.])
或全 1 数组:
>>> np.ones(2)
array([1., 1.])
甚至可以创建未初始化的数组!empty 的初始内容不确定,取决于内存状态。它比 zeros 等方法快,但必须确保随后为每个元素赋值。
>>> # Create an empty array with 2 elements
>>> np.empty(2)
array([3.14, 42.  ])  # may vary
可以创建包含一个数值范围的数组:
>>> np.arange(4)
array([0, 1, 2, 3])
还可以指定起始值、结束边界和步长,创建等间隔数值数组:
>>> np.arange(2, 9, 2)
array([2, 4, 6, 8])
也可以使用 np.linspace(),在指定区间内创建线性等间距的数值:
>>> np.linspace(0, 10, num=5)
array([ 0. ,  2.5,  5. ,  7.5, 10. ])
指定数据类型
虽然这里默认的数据类型是浮点数 np.float64,也可以通过 dtype 关键字明确指定所需类型。
>>> x = np.ones(2, dtype=np.int64)
>>> x
array([1, 1])
更多内容参见数组创建文档。[8]
添加、删除和排序元素
本节介绍 np.sort() 与 np.concatenate()。
使用 np.sort() 排序很简单,调用时可以指定轴、算法类型以及字段顺序。
假设有以下数组:
>>> arr = np.array([2, 1, 5, 3, 7, 4, 6, 8])
可以快速将数字按升序排序:
>>> np.sort(arr)
array([1, 2, 3, 4, 5, 6, 7, 8])
除了返回排序后副本的 sort,还可以使用:
-
argsort:沿指定轴进行间接排序。[9] -
lexsort:按多个键进行间接稳定排序。[10] -
searchsorted:在已排序数组中查找元素的位置。[11] -
partition:进行部分排序。[12]
更多排序信息参见 sort。[13]
假设有这些数组:
>>> a = np.array([1, 2, 3, 4])
>>> b = np.array([5, 6, 7, 8])
可以用 np.concatenate() 拼接它们。
>>> np.concatenate((a, b))
array([1, 2, 3, 4, 5, 6, 7, 8])
或者,对于以下数组:
>>> x = np.array([[1, 2], [3, 4]])
>>> y = np.array([[5, 6]])
可以这样拼接:
>>> np.concatenate((x, y), axis=0)
array([[1, 2],
       [3, 4],
       [5, 6]])
要删除数组元素,简单的方法是用索引选出希望保留的元素。
更多拼接信息参见 concatenate。[14]
如何查看数组的形状和大小
本节介绍 ndarray.ndim、ndarray.size 和 ndarray.shape。
ndarray.ndim 表示数组的轴数,也就是维数。
ndarray.size 表示元素总数,等于数组形状中各数值的乘积。
ndarray.shape 返回整数元组,表示各维度存储的元素数量。例如两行三列的二维数组,其形状为 (2, 3)。
例如创建以下数组:
>>> array_example = np.array([[[0, 1, 2, 3],
...                            [4, 5, 6, 7]],
...
...                           [[0, 1, 2, 3],
...                            [4, 5, 6, 7]],
...
...                           [[0 ,1 ,2, 3],
...                            [4, 5, 6, 7]]])
查看维数:
>>> array_example.ndim
3
查看元素总数:
>>> array_example.size
24
查看形状:
>>> array_example.shape
(3, 2, 4)
可以改变数组形状吗
本节介绍 arr.reshape()。
可以!
arr.reshape() 返回形状改变后的数组,而不改变数据。需要记住,新数组与原数组的元素总数必须相同。如果原数组有 12 个元素,新数组也必须有 12 个元素。
假设有以下数组:
>>> a = np.arange(6)
>>> print(a)
[0 1 2 3 4 5]
使用 reshape() 可以改变形状,例如变成三行两列:
>>> b = a.reshape(3, 2)
>>> print(b)
[[0 1]
 [2 3]
 [4 5]]
np.reshape 提供以下参数,包括可选参数:
>>> np.reshape(a, shape=(1, 6), order='C')
array([[0, 1, 2, 3, 4, 5]])
a 是要改变形状的数组。
shape 是期望的新形状,可以是整数或整数元组。若指定整数,结果是一维且长度为该整数的数组。新形状必须与原形状兼容。
order 为 C 时,按 C 风格索引顺序读写元素;为 F 时,按 Fortran 风格顺序读写;为 A 时,如果 a 在内存中按 Fortran 顺序连续存储,就采用 Fortran 顺序,否则采用 C 顺序。这是可选参数,可以省略。
关于 C 与 Fortran 顺序,参见 NumPy 数组内部组织文档。本质上,它们描述索引与内存存储顺序的对应关系。Fortran 中,沿内存顺序遍历二维数组时,第一个索引变化最快;因为第一个索引每变一次就到下一行,矩阵实际按列存储,因此称为列优先。C 中则是最后一个索引变化最快,矩阵按行存储,因此称为行优先。选择哪种方式,取决于更重视保留索引约定,还是避免重新排列数据。[15]
更多内容参见形状操作文档。[16]
将一维数组转换为二维数组:添加新轴
本节介绍 np.newaxis 与 np.expand_dims。
可以用 np.newaxis 和 np.expand_dims 增加现有数组的维数。
每使用一次 np.newaxis,就增加一个维度:一维变二维,二维变三维,依此类推。
例如,从这个数组开始:
>>> a = np.array([1, 2, 3, 4, 5, 6])
>>> a.shape
(6,)
使用 np.newaxis 添加一个轴:
>>> a2 = a[np.newaxis, :]
>>> a2.shape
(1, 6)
可以明确将一维数组转换为行向量或列向量。例如在第一个维度插入轴,可得到行向量:
>>> row_vector = a[np.newaxis, :]
>>> row_vector.shape
(1, 6)
在第二个维度插入轴,则得到列向量:
>>> col_vector = a[:, np.newaxis]
>>> col_vector.shape
(6, 1)
还可以使用 np.expand_dims 在指定位置插入新轴。
例如,从这个数组开始:
>>> a = np.array([1, 2, 3, 4, 5, 6])
>>> a.shape
(6,)
在索引位置 1 添加轴:
>>> b = np.expand_dims(a, axis=1)
>>> b.shape
(6, 1)
在索引位置 0 添加轴:
>>> c = np.expand_dims(a, axis=0)
>>> c.shape
(1, 6)
索引和切片
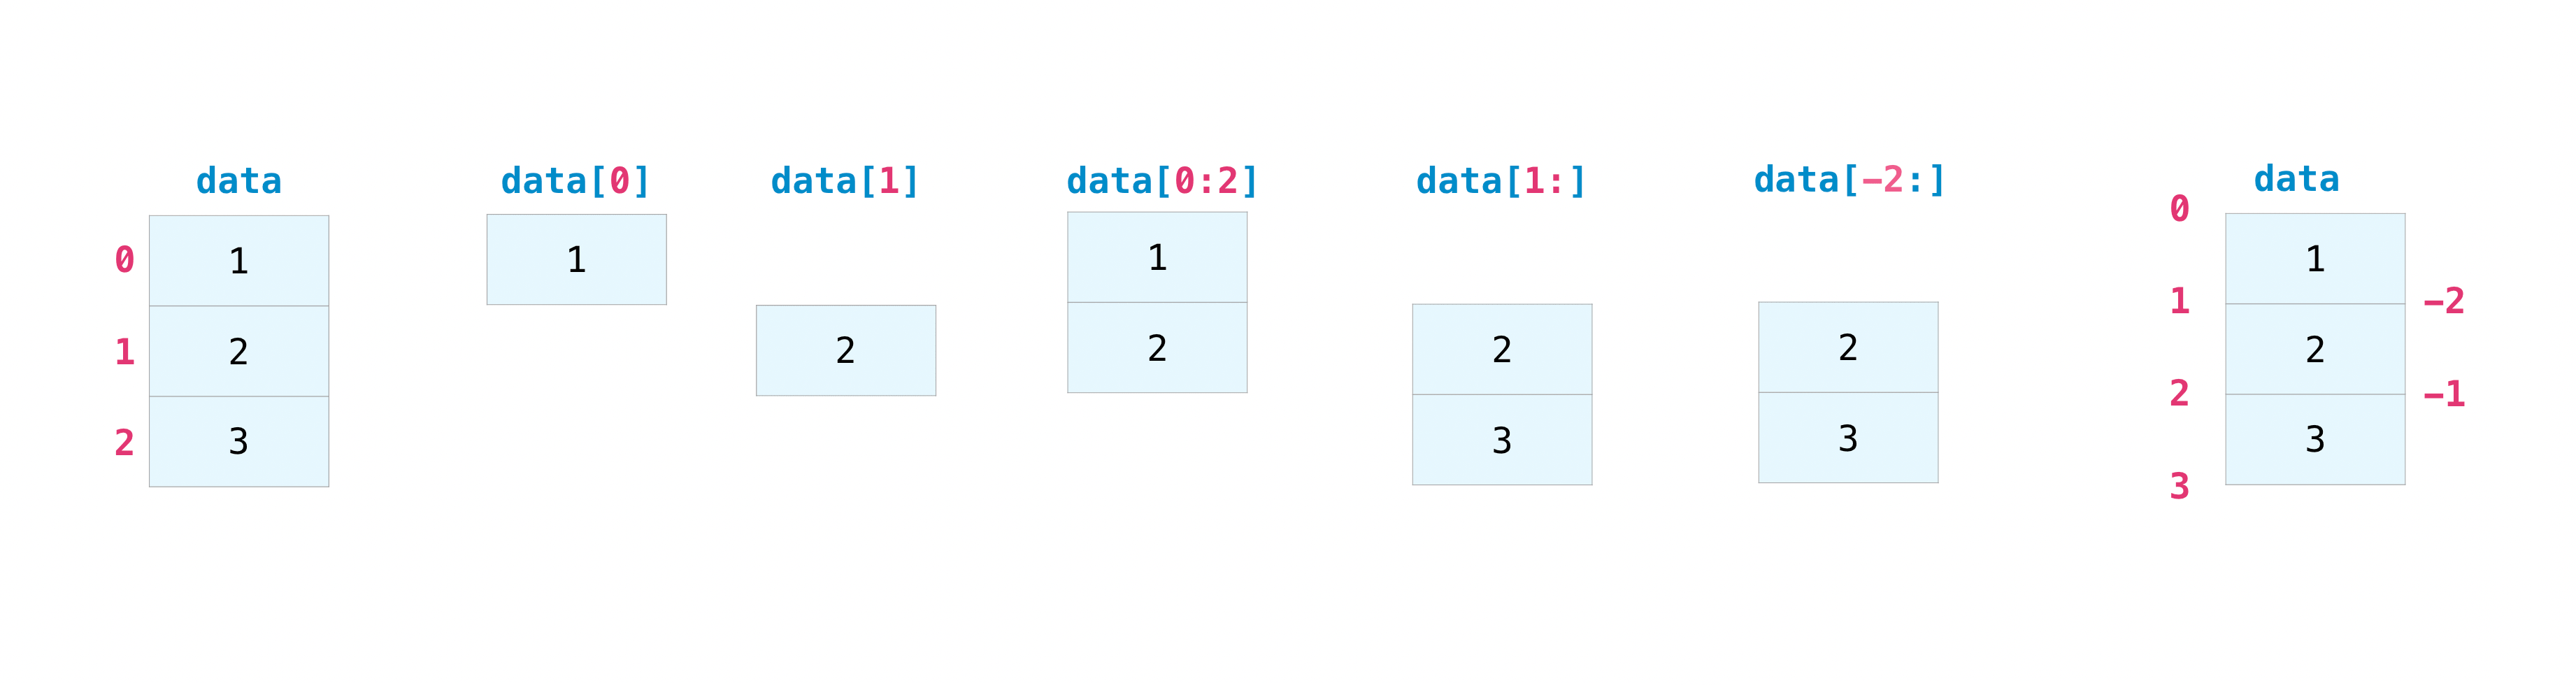
NumPy 数组的索引与切片,可以采用与 Python 列表相同的方式。
>>> data = np.array([1, 2, 3])

>>> data[1]
2
>>> data[0:2]
array([1, 2])
>>> data[1:]
array([2, 3])
>>> data[-2:]
array([2, 3])
可以将其画成下面的示意图:
若要取出数组的一部分或特定元素,用于后续分析或其他操作,就需要对子集进行选择、切片或索引。
使用 NumPy 选择满足特定条件的值很直接。
例如,对于以下数组:
>>> a = np.array([[1, 2, 3, 4], [5, 6, 7, 8], [9, 10, 11, 12]])
可以轻松打印所有小于 5 的值。
>>> print(a[a < 5])
[1 2 3 4]
也可以选择大于或等于 5 的数字,并用这个条件索引数组。
>>> five_up = (a >= 5)
>>> print(a[five_up])
[ 5  6  7  8  9 10 11 12]
选择能被 2 整除的元素:
>>> divisible_by_2 = a[a%2==0]
>>> print(divisible_by_2)
[ 2  4  6  8 10 12]
或者使用 & 与 | 运算符,结合两个条件选择元素:
>>> c = a[(a > 2) & (a < 11)]
>>> print(c)
[ 3  4  5  6  7  8  9 10]
也可以使用逻辑运算符 & 与 | 返回布尔值,指出数组元素是否满足条件。对于包含名称或其他类别值的数组,这也很有用。
>>> five_up = (a > 5) | (a == 5)
>>> print(five_up)
[[False False False False]
 [ True  True  True  True]
 [ True  True  True True]]
还可以使用 np.nonzero() 选择元素或索引。
从以下数组开始:
>>> a = np.array([[1, 2, 3, 4], [5, 6, 7, 8], [9, 10, 11, 12]])
例如,使用 np.nonzero() 打印小于 5 的元素的索引:
>>> b = np.nonzero(a < 5)
>>> print(b)
(array([0, 0, 0, 0]), array([0, 1, 2, 3]))
该示例返回一个由数组组成的元组,每个维度对应一个数组。第一个数组是这些值所在的行索引,第二个是列索引。
若希望生成元素坐标列表,可以使用 zip 合并这些数组,再遍历并打印坐标。例如:
>>> list_of_coordinates= list(zip(b[0], b[1]))

>>> for coord in list_of_coordinates:
...     print(coord)
(np.int64(0), np.int64(0))
(np.int64(0), np.int64(1))
(np.int64(0), np.int64(2))
(np.int64(0), np.int64(3))
也可以配合 np.nonzero() 打印数组中小于 5 的元素:
>>> print(a[b])
[1 2 3 4]
如果要查找的元素不存在,返回的索引数组将为空。例如:
>>> not_there = np.nonzero(a == 42)
>>> print(not_there)
(array([], dtype=int64), array([], dtype=int64))
更多 nonzero 用法参见对应函数文档。[21]
从现有数据创建数组
本节介绍切片、索引、np.vstack()、np.hstack()、np.hsplit()、.view() 与 copy()。
可以方便地从现有数组的一部分创建新数组。
假设有以下数组:
>>> a = np.array([1, 2, 3, 4, 5, 6, 7, 8, 9, 10])
指定切片位置,即可随时从数组的一部分创建新数组。
>>> arr1 = a[3:8]
>>> arr1
array([4, 5, 6, 7, 8])
这里取出了索引 3 到索引 8 之前的部分,不包含索引 8 本身。
提醒:数组索引从 0 开始。第一个元素索引为 0,第二个为 1,依此类推。
也可以纵向或横向堆叠两个现有数组。假设有 a1 和 a2:
>>> a1 = np.array([[1, 1],
...                [2, 2]])

>>> a2 = np.array([[3, 3],
...                [4, 4]])
使用 vstack 纵向堆叠:
>>> np.vstack((a1, a2))
array([[1, 1],
       [2, 2],
       [3, 3],
       [4, 4]])
使用 hstack 横向堆叠:
>>> np.hstack((a1, a2))
array([[1, 1, 3, 3],
       [2, 2, 4, 4]])
可以用 hsplit 将数组拆分成若干较小数组,既可以指定返回多少个同形状数组,也可以指定在哪些列之后切分。
假设有以下数组:
>>> x = np.arange(1, 25).reshape(2, 12)
>>> x
array([[ 1,  2,  3,  4,  5,  6,  7,  8,  9, 10, 11, 12],
       [13, 14, 15, 16, 17, 18, 19, 20, 21, 22, 23, 24]])
要拆分成三个形状相同的数组:
>>> np.hsplit(x, 3)
  [array([[ 1,  2,  3,  4],
         [13, 14, 15, 16]]), array([[ 5,  6,  7,  8],
         [17, 18, 19, 20]]), array([[ 9, 10, 11, 12],
         [21, 22, 23, 24]])]
要在第三列和第四列之后切分:
>>> np.hsplit(x, (3, 4))
  [array([[ 1,  2,  3],
         [13, 14, 15]]), array([[ 4],
         [16]]), array([[ 5,  6,  7,  8,  9, 10, 11, 12],
         [17, 18, 19, 20, 21, 22, 23, 24]])]
更多内容参见数组堆叠与拆分文档。[22]
view 方法可以创建一个新的数组对象,它与原数组查看同一份数据,即浅拷贝。
视图是 NumPy 中的重要概念!NumPy 函数以及索引、切片等操作,会尽可能返回视图,避免复制数据,从而节省内存并提高速度。但必须注意:修改视图中的数据,也会修改原数组。
假设创建以下数组:
>>> a = np.array([[1, 2, 3, 4], [5, 6, 7, 8], [9, 10, 11, 12]])
通过切片 a 创建 b1,然后修改 b1 的第一个元素。a 中对应元素也会改变!
>>> b1 = a[0, :]
>>> b1
array([1, 2, 3, 4])
>>> b1[0] = 99
>>> b1
array([99,  2,  3,  4])
>>> a
array([[99,  2,  3,  4],
       [ 5,  6,  7,  8],
       [ 9, 10, 11, 12]])
copy 方法会完整复制数组及其数据,即深拷贝。可以这样使用:
>>> b2 = a.copy()
更多内容参见副本与视图文档。[23]
数组基本运算
本节介绍加、减、乘、除等运算。
创建数组后就能开始运算。例如,有两个数组,分别名为 data 和 ones。
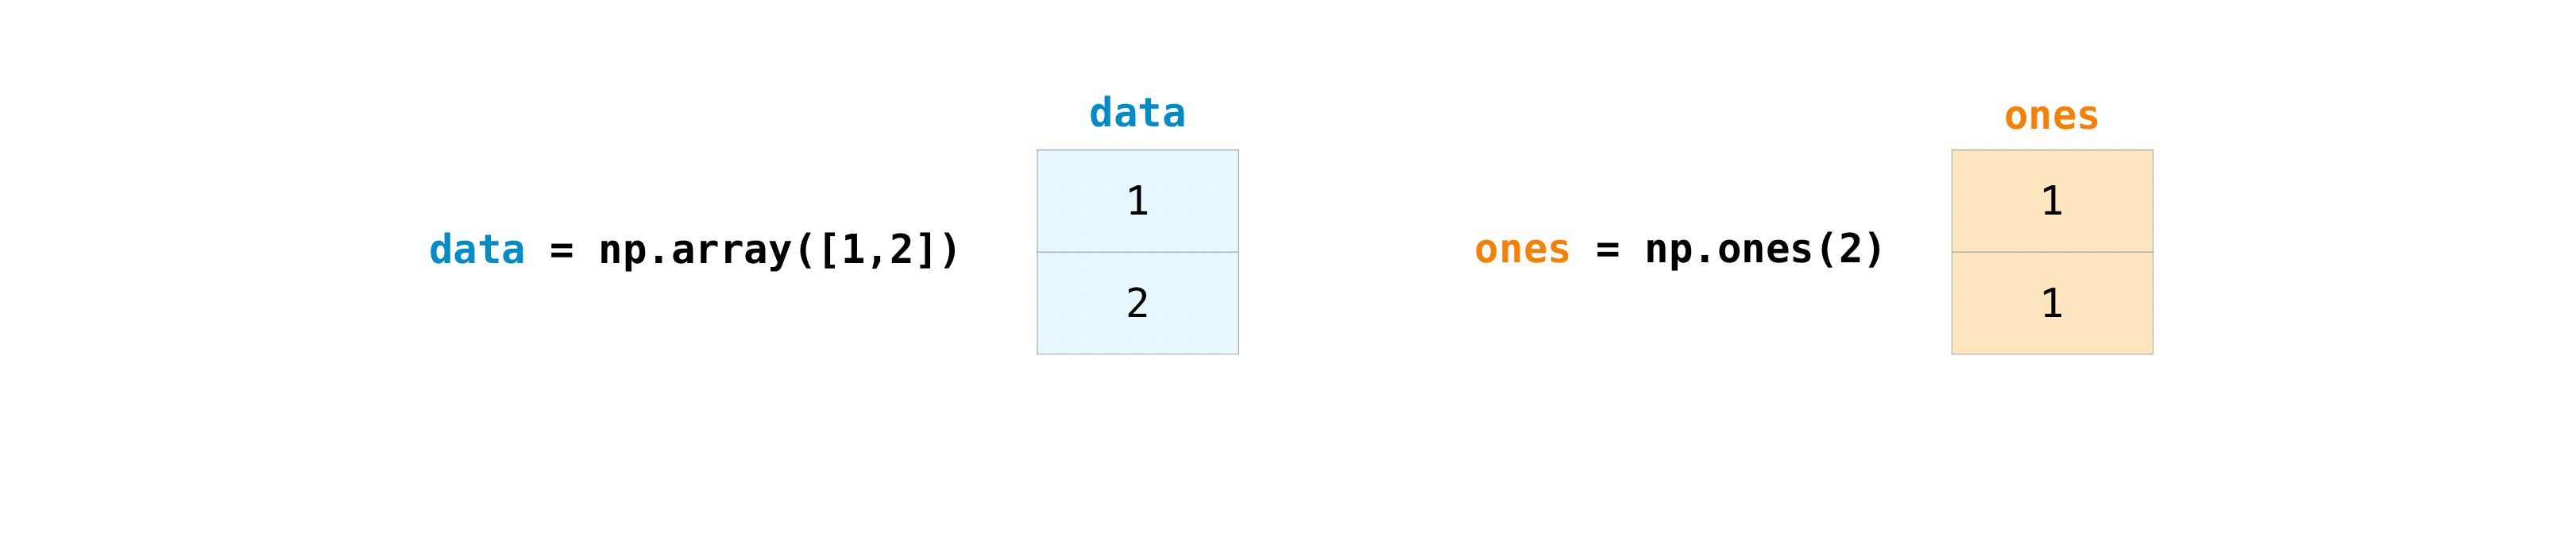
用加号就能将数组相加。
>>> data = np.array([1, 2])
>>> ones = np.ones(2, dtype=np.int_)
>>> data + ones
array([2, 3])
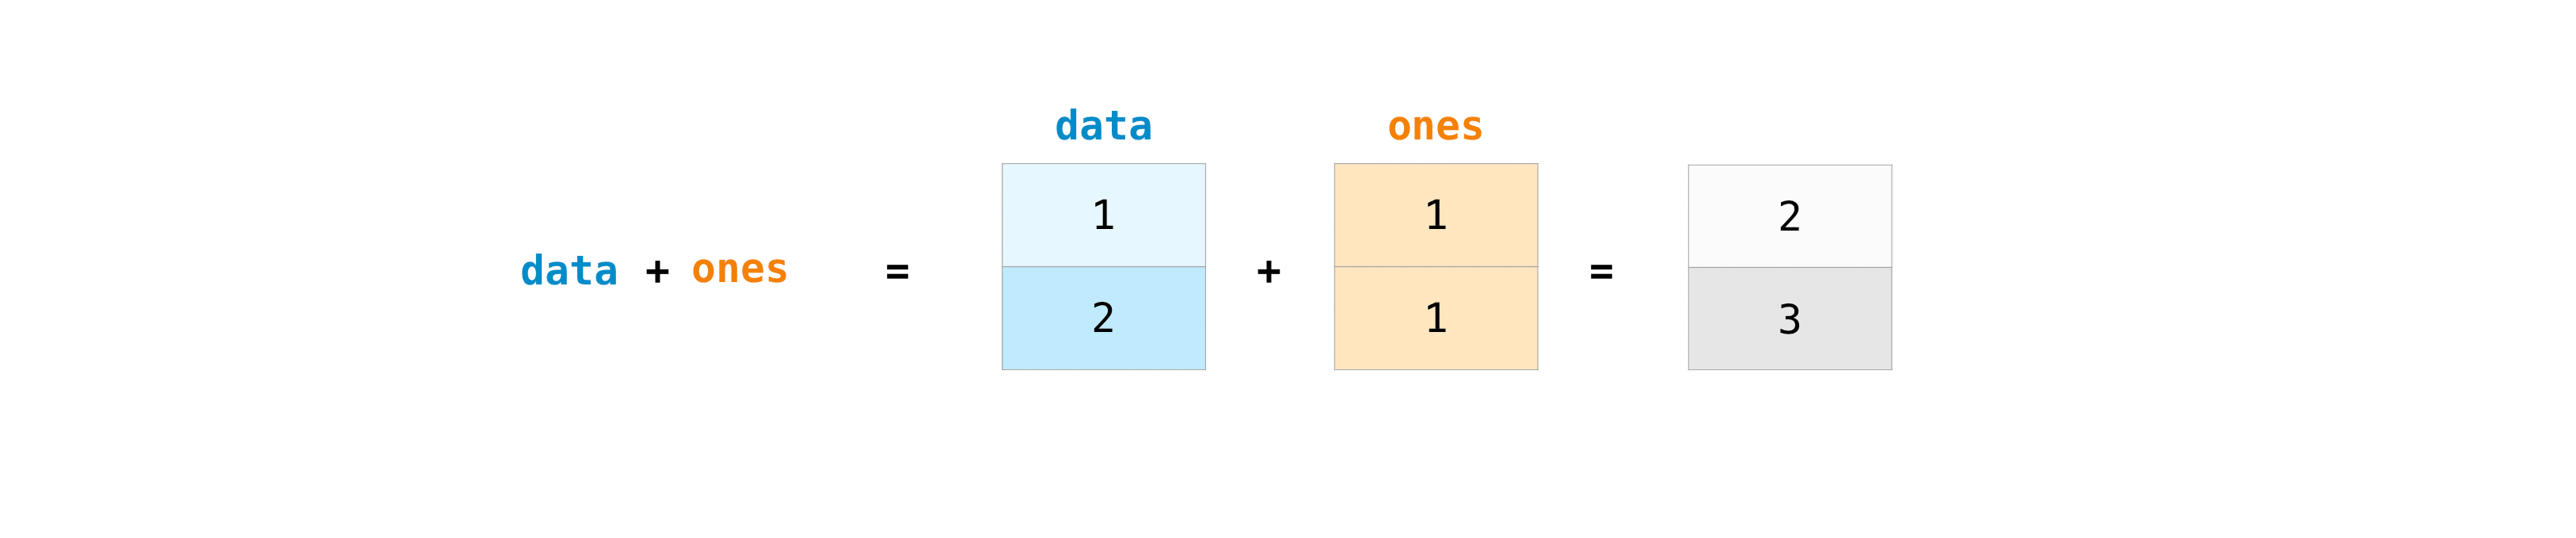
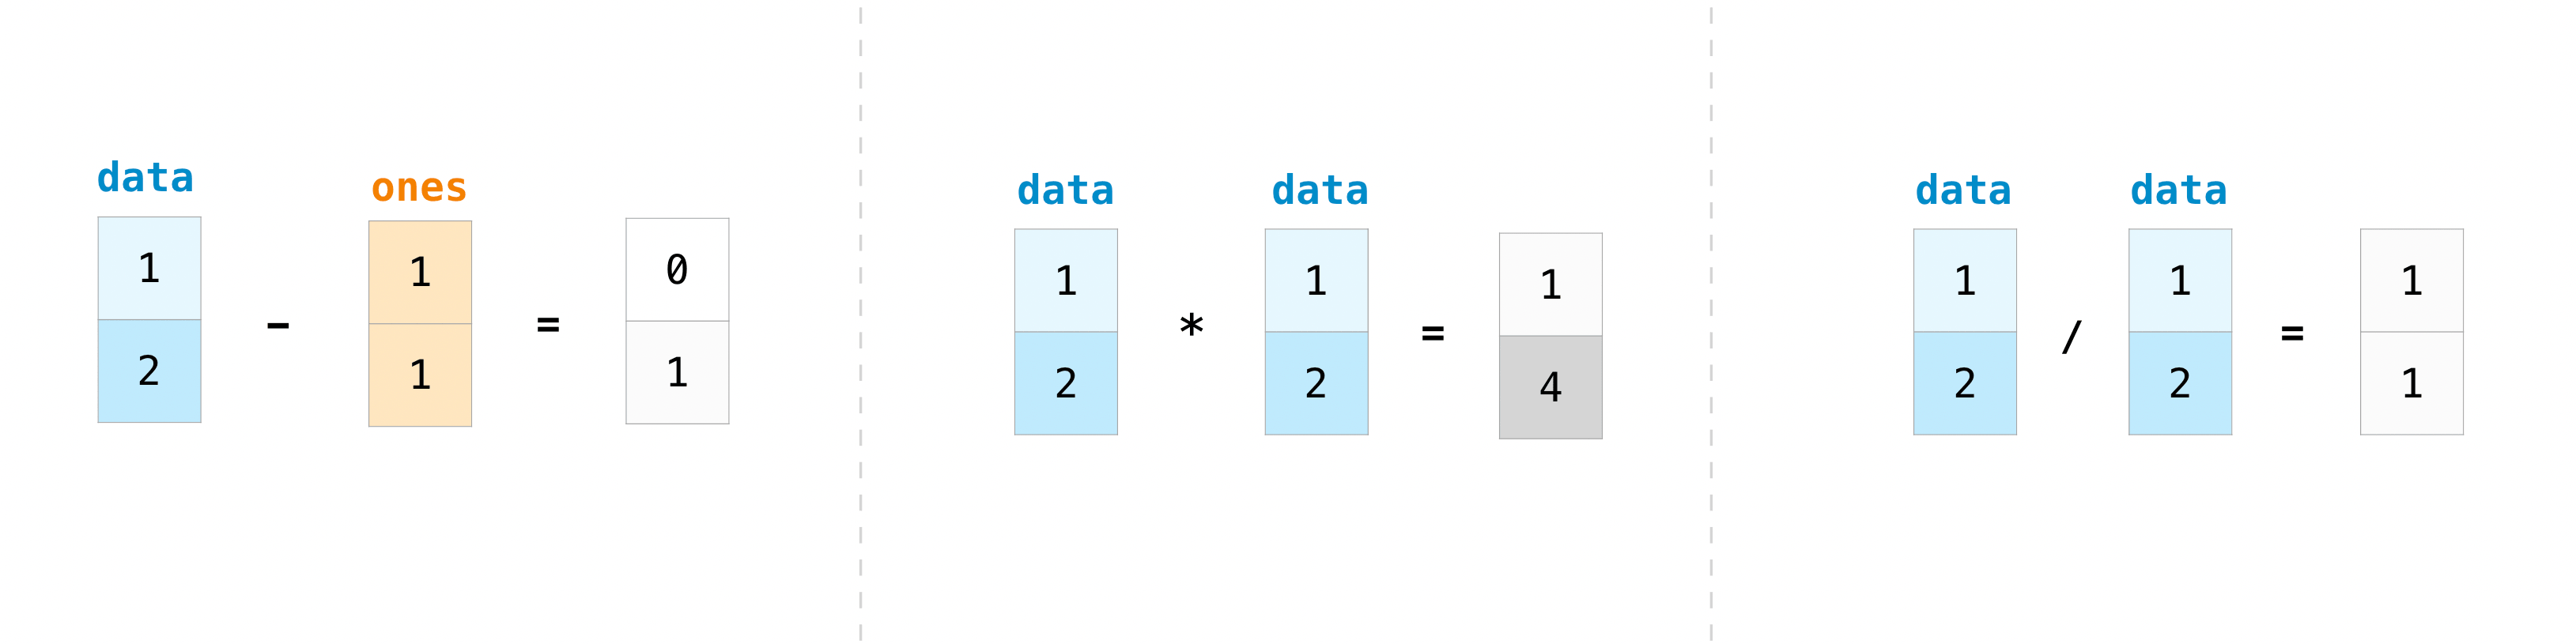
当然,能做的不仅是加法!
>>> data - ones
array([0, 1])
>>> data * data
array([1, 4])
>>> data / data
array([1., 1.])
NumPy 的基本运算很简单。sum() 可以计算元素之和,适用于一维、二维及更高维数组。
>>> a = np.array([1, 2, 3, 4])

>>> a.sum()
10
要对二维数组的行或列求和,需要指定轴。
对于以下数组:
>>> b = np.array([[1, 1], [2, 2]])
沿行轴求和:
>>> b.sum(axis=0)
array([3, 3])
沿列轴求和:
>>> b.sum(axis=1)
array([2, 4])
更多内容参见基本运算文档。[24]
广播
有时需要在数组与一个数字之间运算,也称向量与标量之间的运算,或者在大小不同的两个数组之间运算。例如 data 数组保存英里距离,希望将它转换为千米:
>>> data = np.array([1.0, 2.0])
>>> data * 1.6
array([1.6, 3.2])
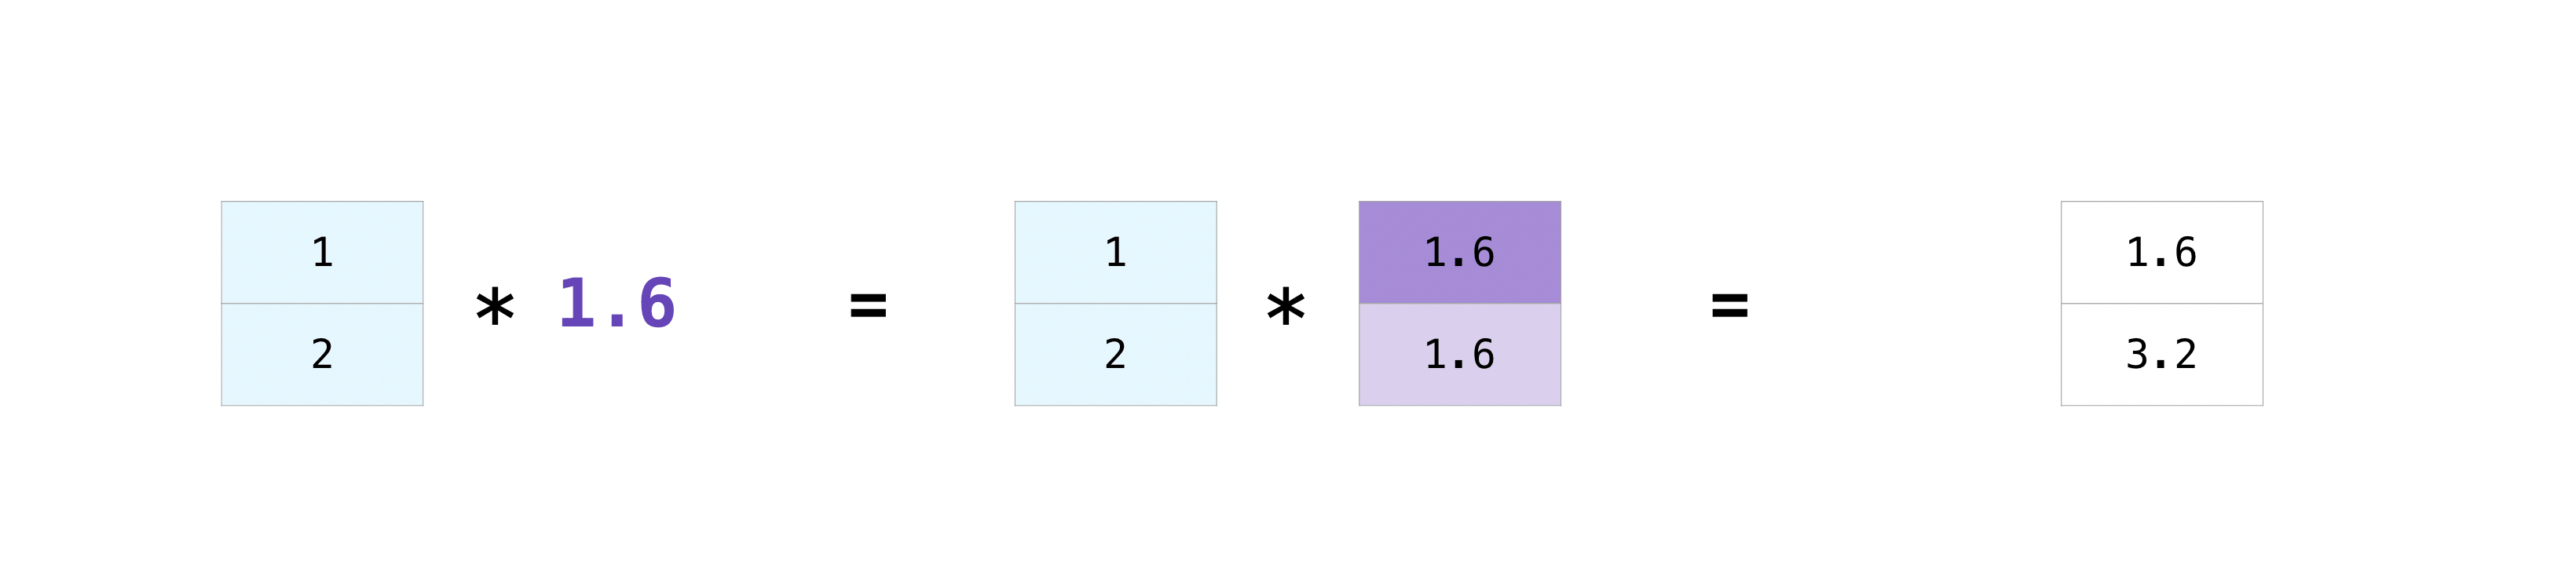
NumPy 知道应该对每个单元执行乘法,这个概念称为广播。广播让不同形状的数组可以参与运算,但维度必须兼容,例如对应维度相等,或者其中一个为 1。不兼容时会产生 ValueError。
更多内容参见广播文档。[25]
更多实用数组运算
本节介绍最大值、最小值、求和、均值、乘积、标准差等。
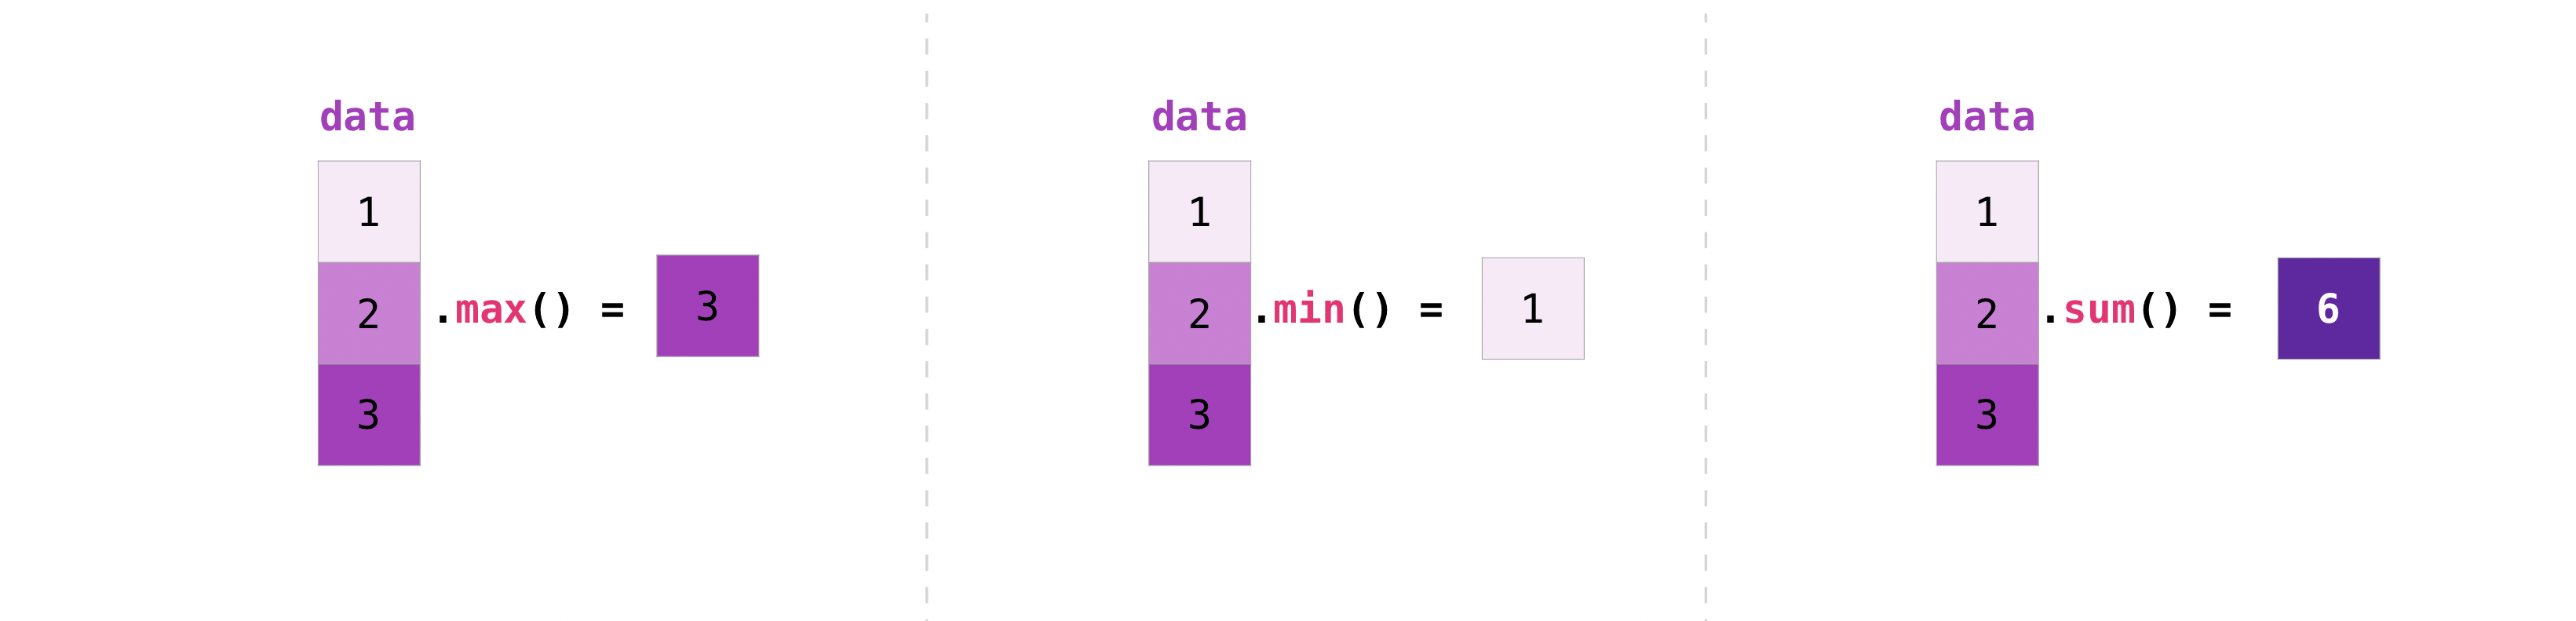
NumPy 也支持聚合函数。除 min、max、sum 外,还可以用 mean 求平均值、prod 求元素乘积、std 求标准差等。
>>> data = np.array([1, 2, 3])
>>> data.max()
3
>>> data.min()
1
>>> data.sum()
6
从名为 a 的以下数组开始:
>>> a = np.array([[0.45053314, 0.17296777, 0.34376245, 0.5510652],
...               [0.54627315, 0.05093587, 0.40067661, 0.55645993],
...               [0.12697628, 0.82485143, 0.26590556, 0.56917101]])
按行或列聚合很常见。默认情况下,NumPy 聚合函数针对整个数组返回结果。例如求所有元素的和或最小值:
>>> a.sum()
4.8595784
或者:
>>> a.min()
0.05093587
可以指定聚合函数计算的轴。例如指定 axis=0,得到每一列的最小值。
>>> a.min(axis=0)
array([0.12697628, 0.05093587, 0.26590556, 0.5510652 ])
上面的四个值对应数组的四列。四列数组的结果就是四个值。
更多内容参见数组方法文档。[26]
创建矩阵
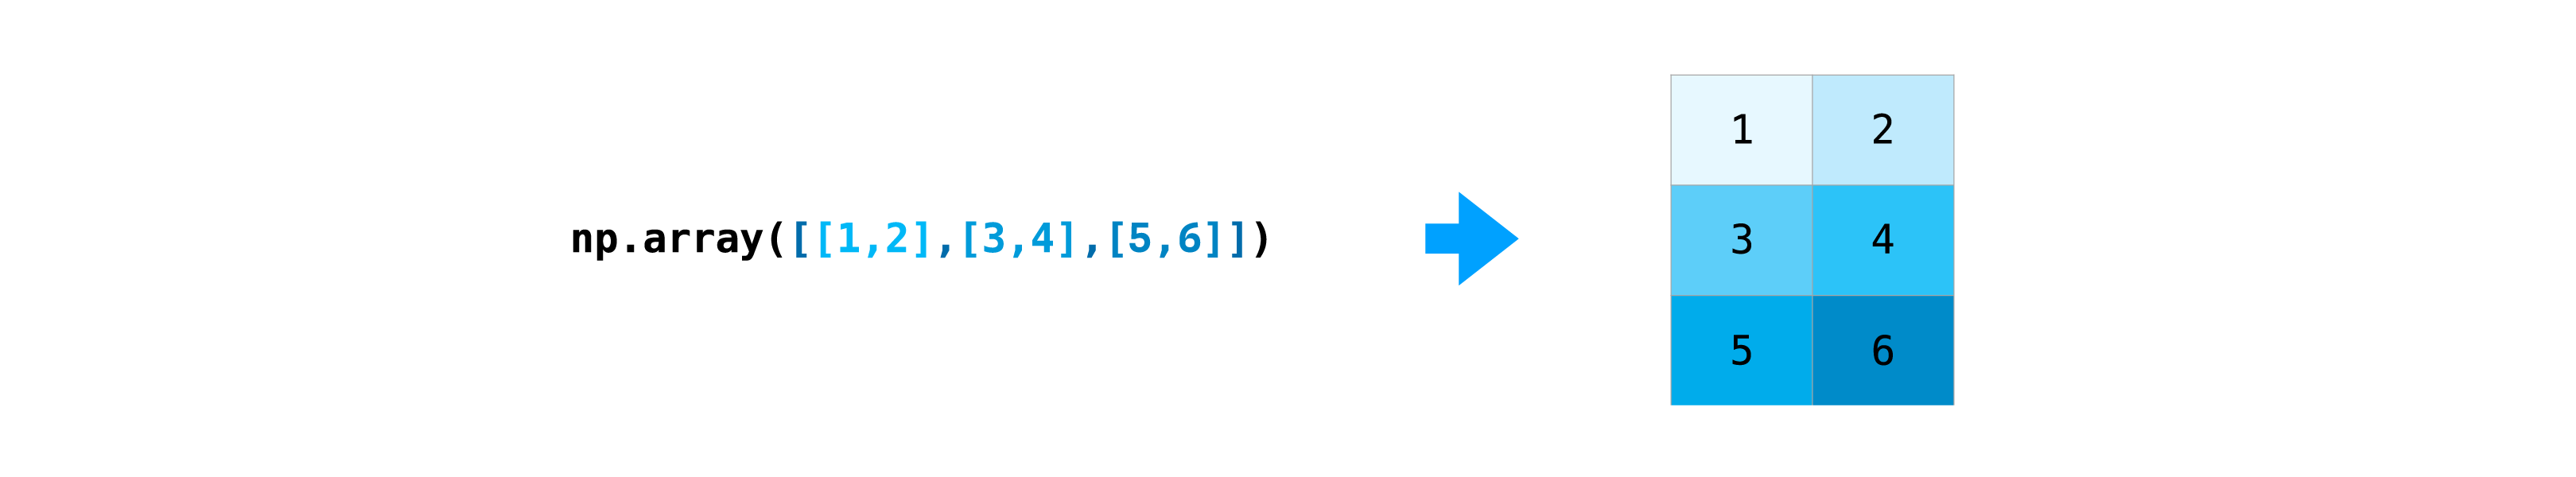
可以传入 Python 列表的列表,创建二维数组,也就是这里所说的矩阵,在 NumPy 中表示它们。
>>> data = np.array([[1, 2], [3, 4], [5, 6]])
>>> data
array([[1, 2],
       [3, 4],
       [5, 6]])
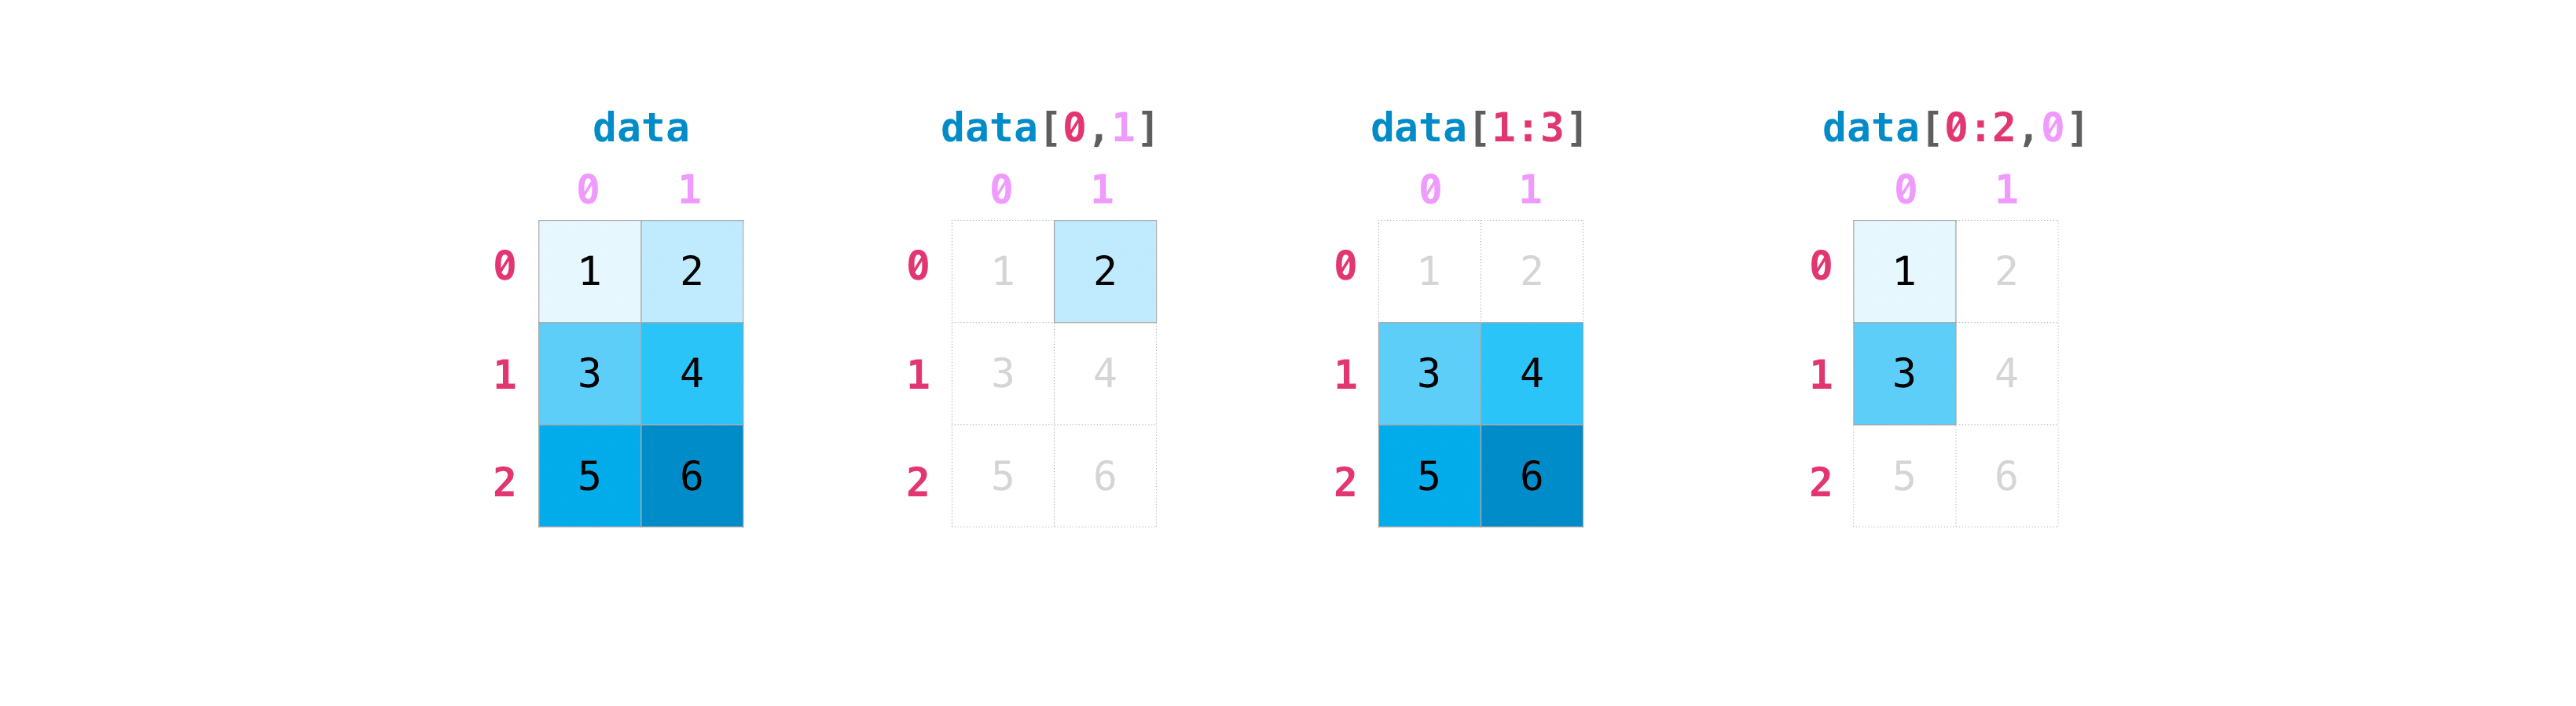
处理矩阵时,索引和切片十分有用:
>>> data[0, 1]
2
>>> data[1:3]
array([[3, 4],
       [5, 6]])
>>> data[0:2, 0]
array([1, 3])
可以像聚合向量一样聚合矩阵:
>>> data.max()
6
>>> data.min()
1
>>> data.sum()
21
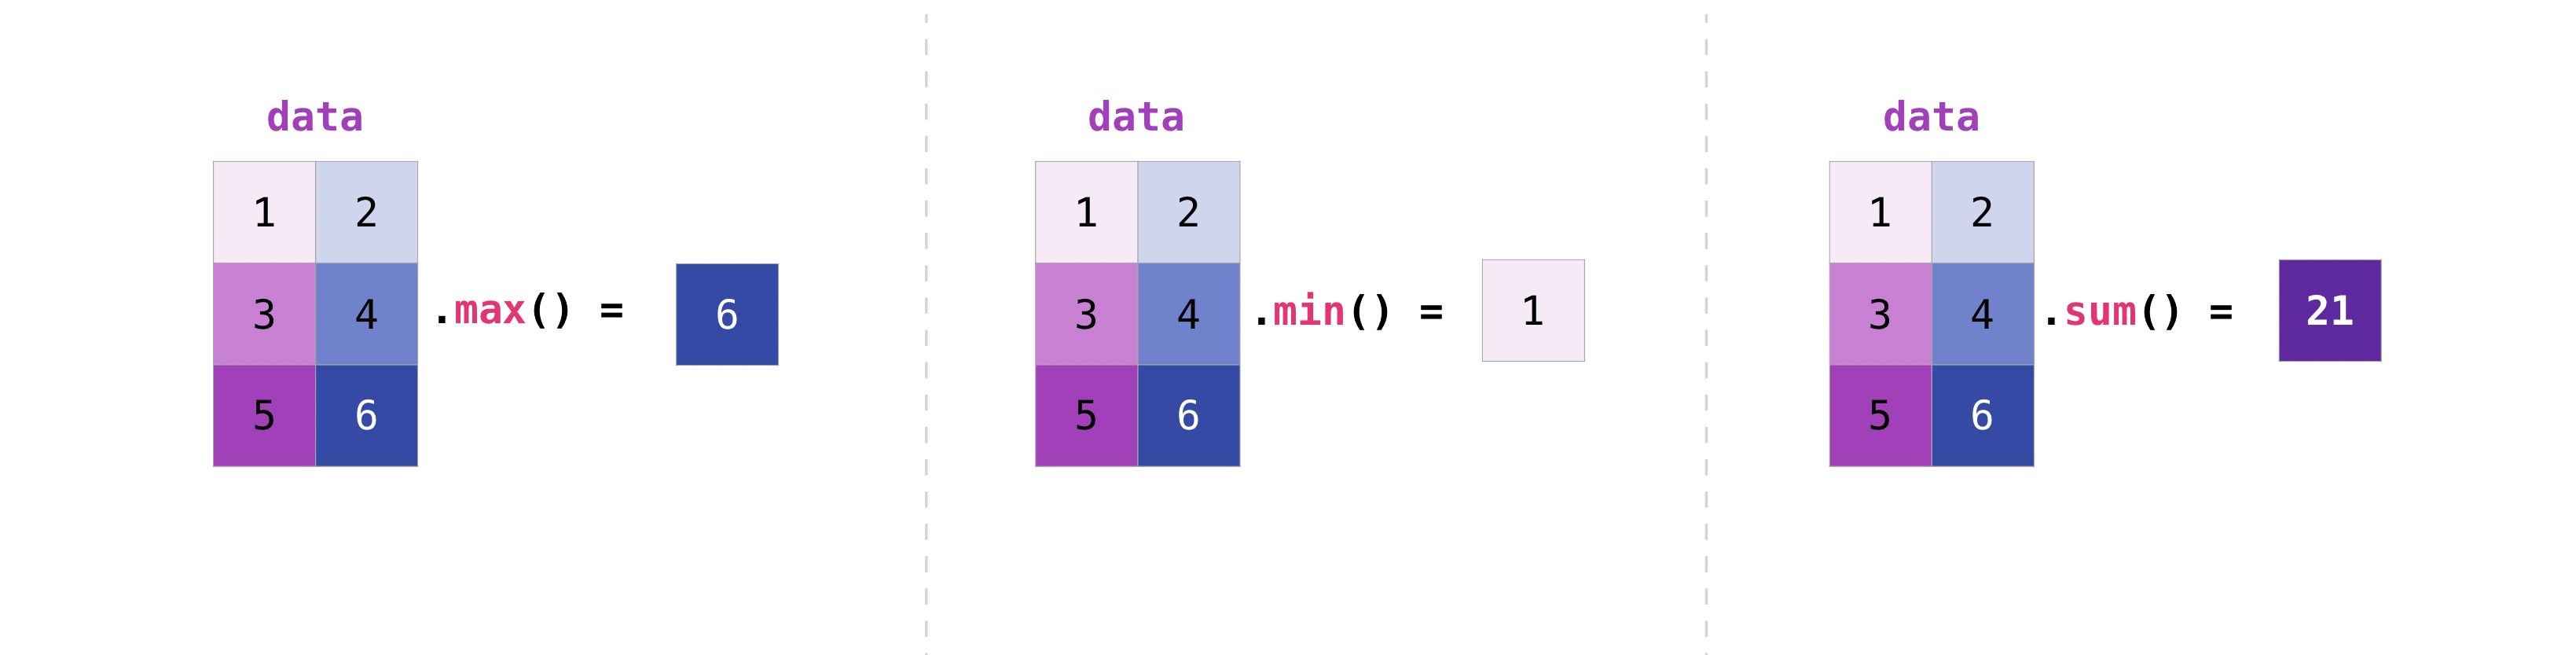
既可以聚合全部值,也可以用 axis 参数沿行或列聚合。下面用略作修改的数据说明:
>>> data = np.array([[1, 2], [5, 3], [4, 6]])
>>> data
array([[1, 2],
       [5, 3],
       [4, 6]])
>>> data.max(axis=0)
array([5, 6])
>>> data.max(axis=1)
array([2, 5, 6])
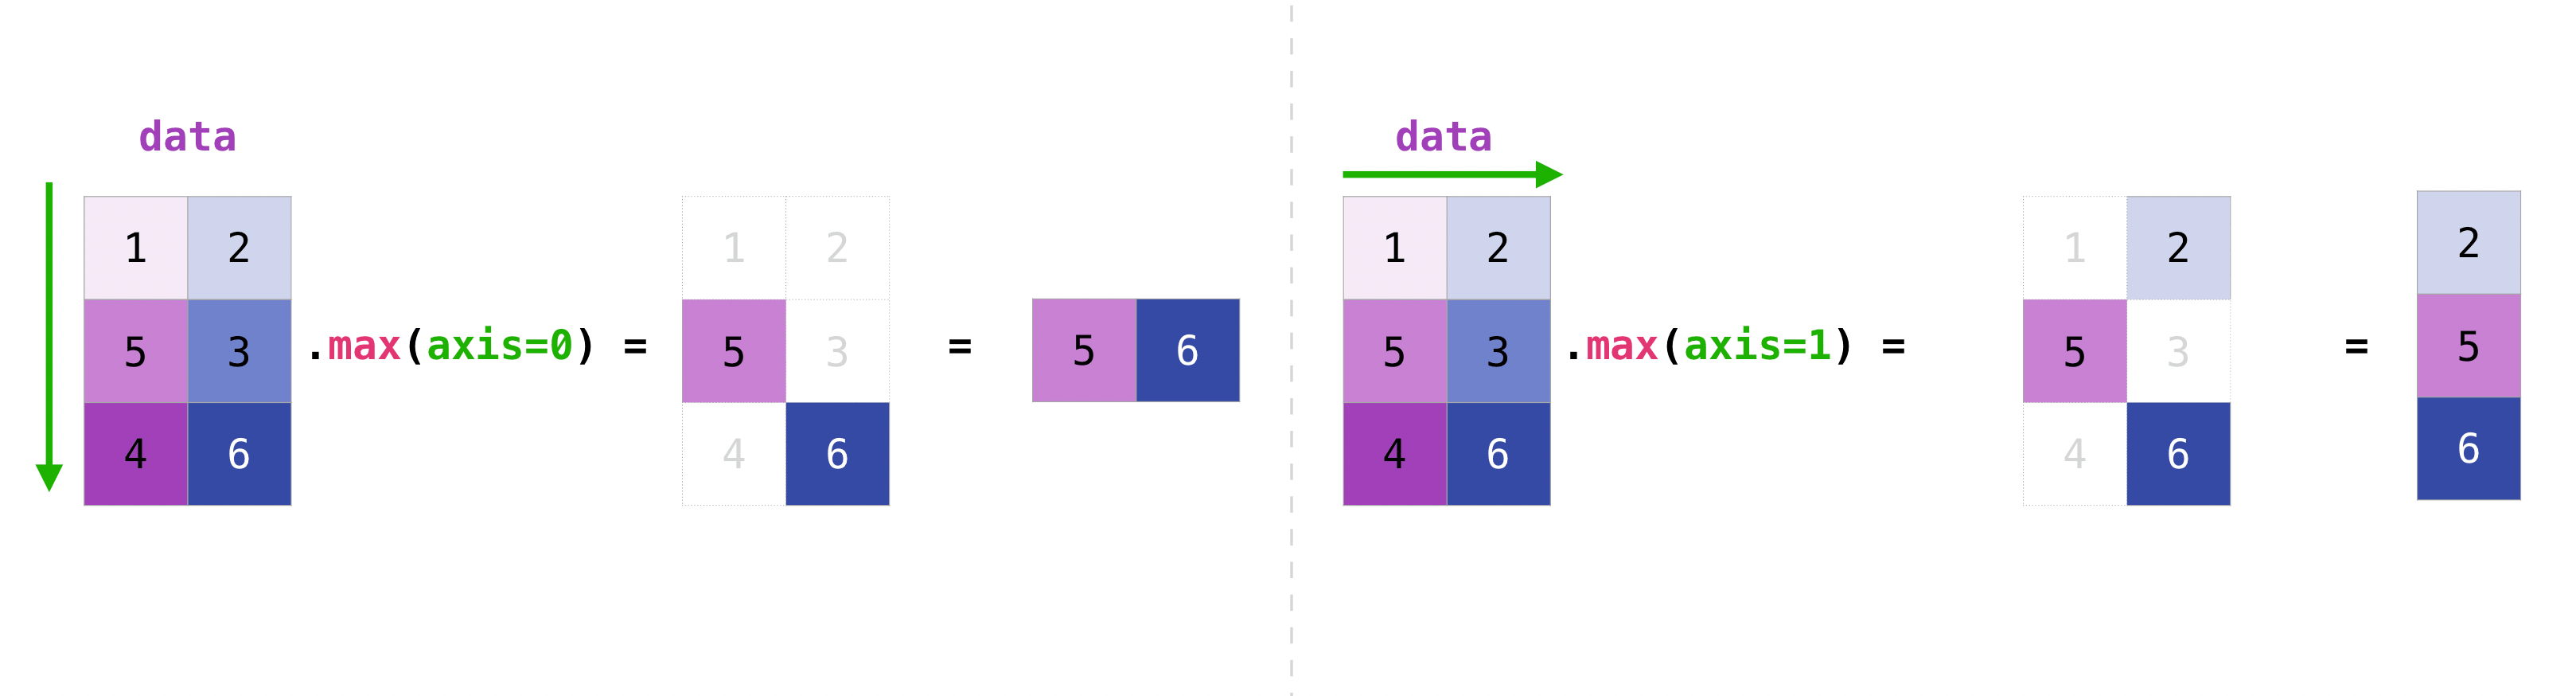
创建矩阵后,如果两个矩阵大小相同,可以用算术运算符相加和相乘。
>>> data = np.array([[1, 2], [3, 4]])
>>> ones = np.array([[1, 1], [1, 1]])
>>> data + ones
array([[2, 3],
       [4, 5]])
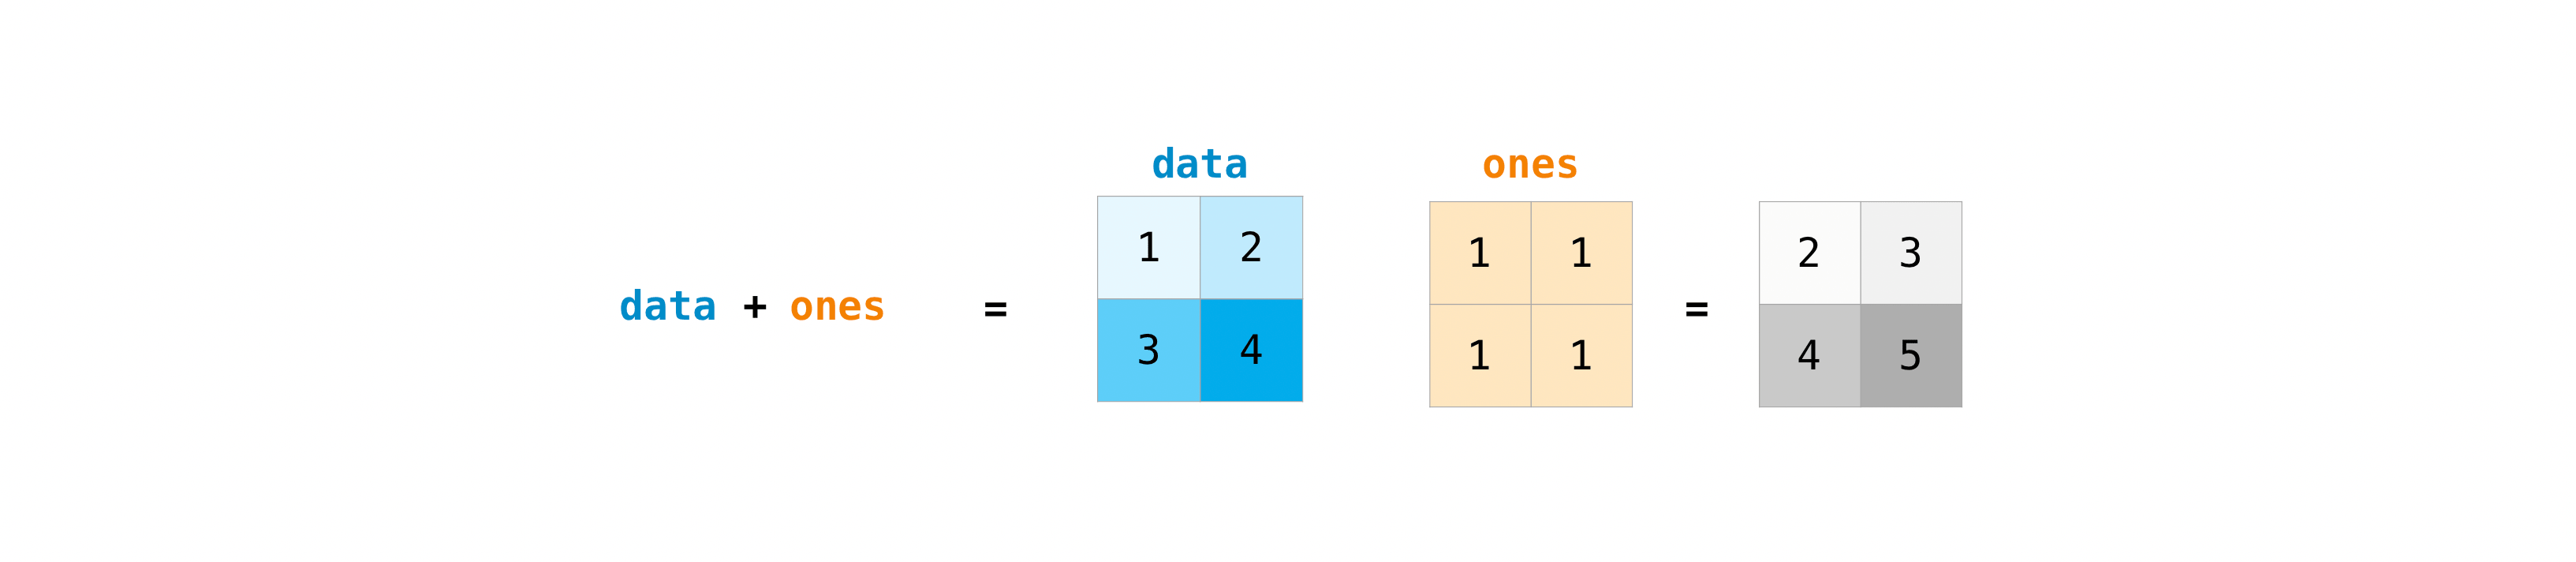
不同大小的矩阵也能执行这些运算,但这里要求一个矩阵只有一行或一列,此时 NumPy 会应用广播规则。
>>> data = np.array([[1, 2], [3, 4], [5, 6]])
>>> ones_row = np.array([[1, 1]])
>>> data + ones_row
array([[2, 3],
       [4, 5],
       [6, 7]])
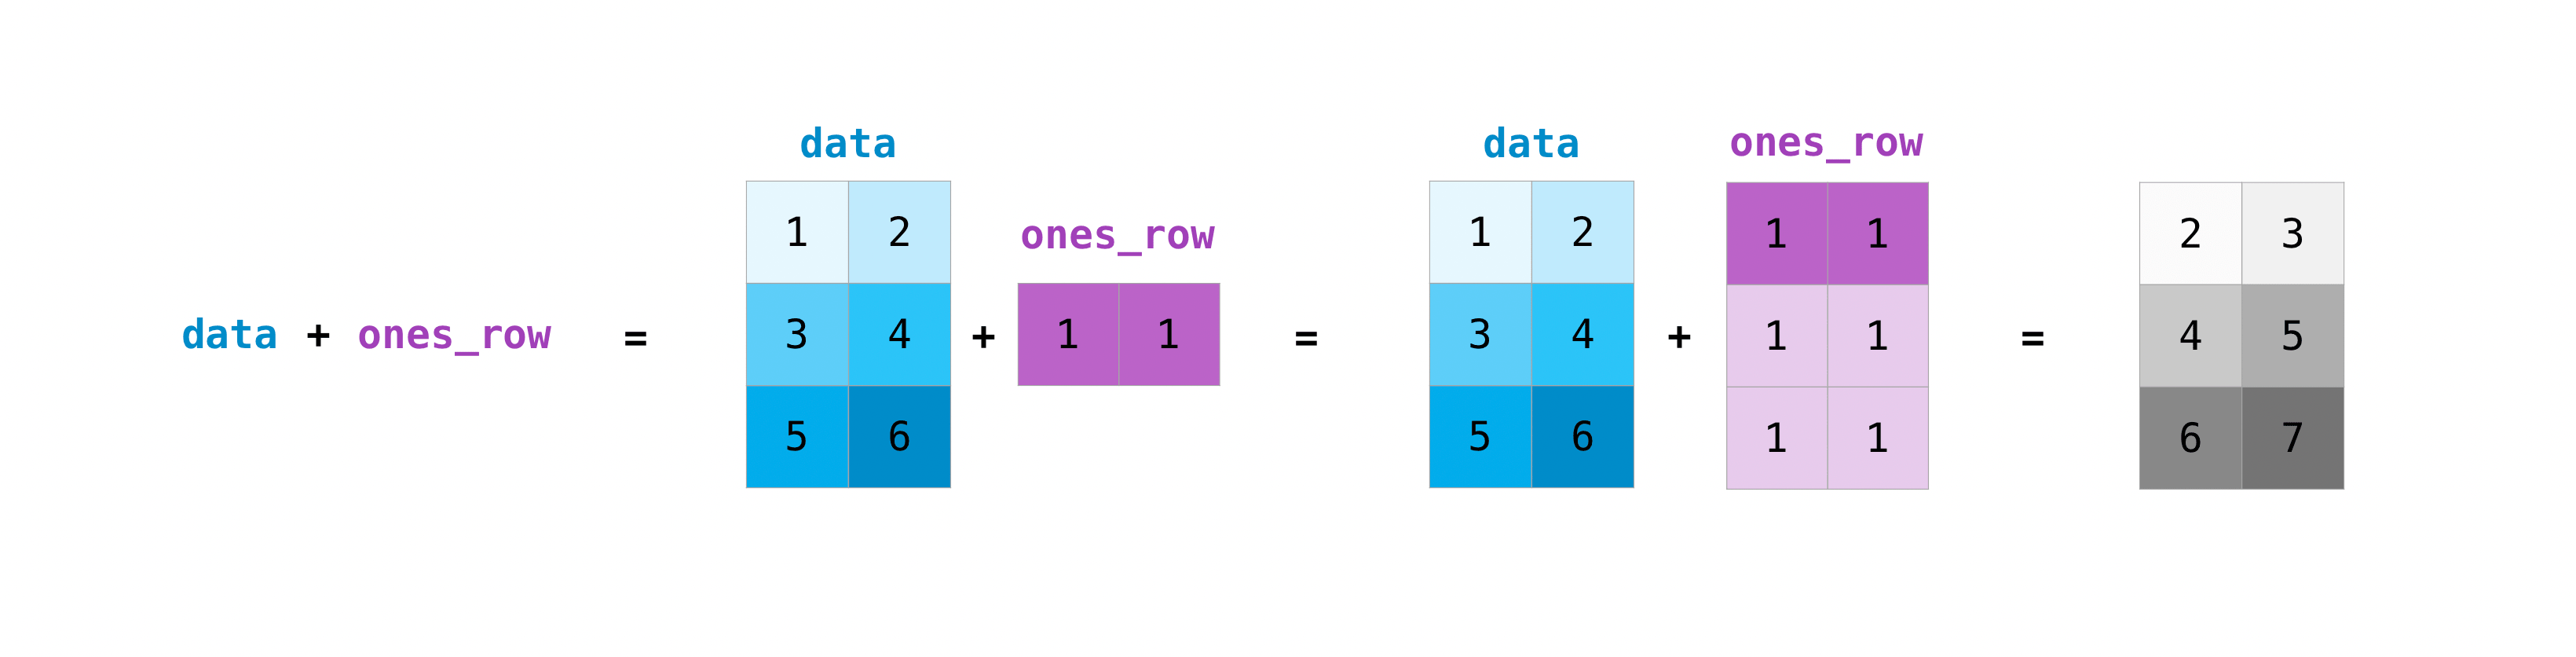
注意,NumPy 打印 N 维数组时,最后一轴遍历最快,第一轴最慢。例如:
>>> np.ones((4, 3, 2))
array([[[1., 1.],
        [1., 1.],
        [1., 1.]],

       [[1., 1.],
        [1., 1.],
        [1., 1.]],

       [[1., 1.],
        [1., 1.],
        [1., 1.]],

       [[1., 1.],
        [1., 1.],
        [1., 1.]]])
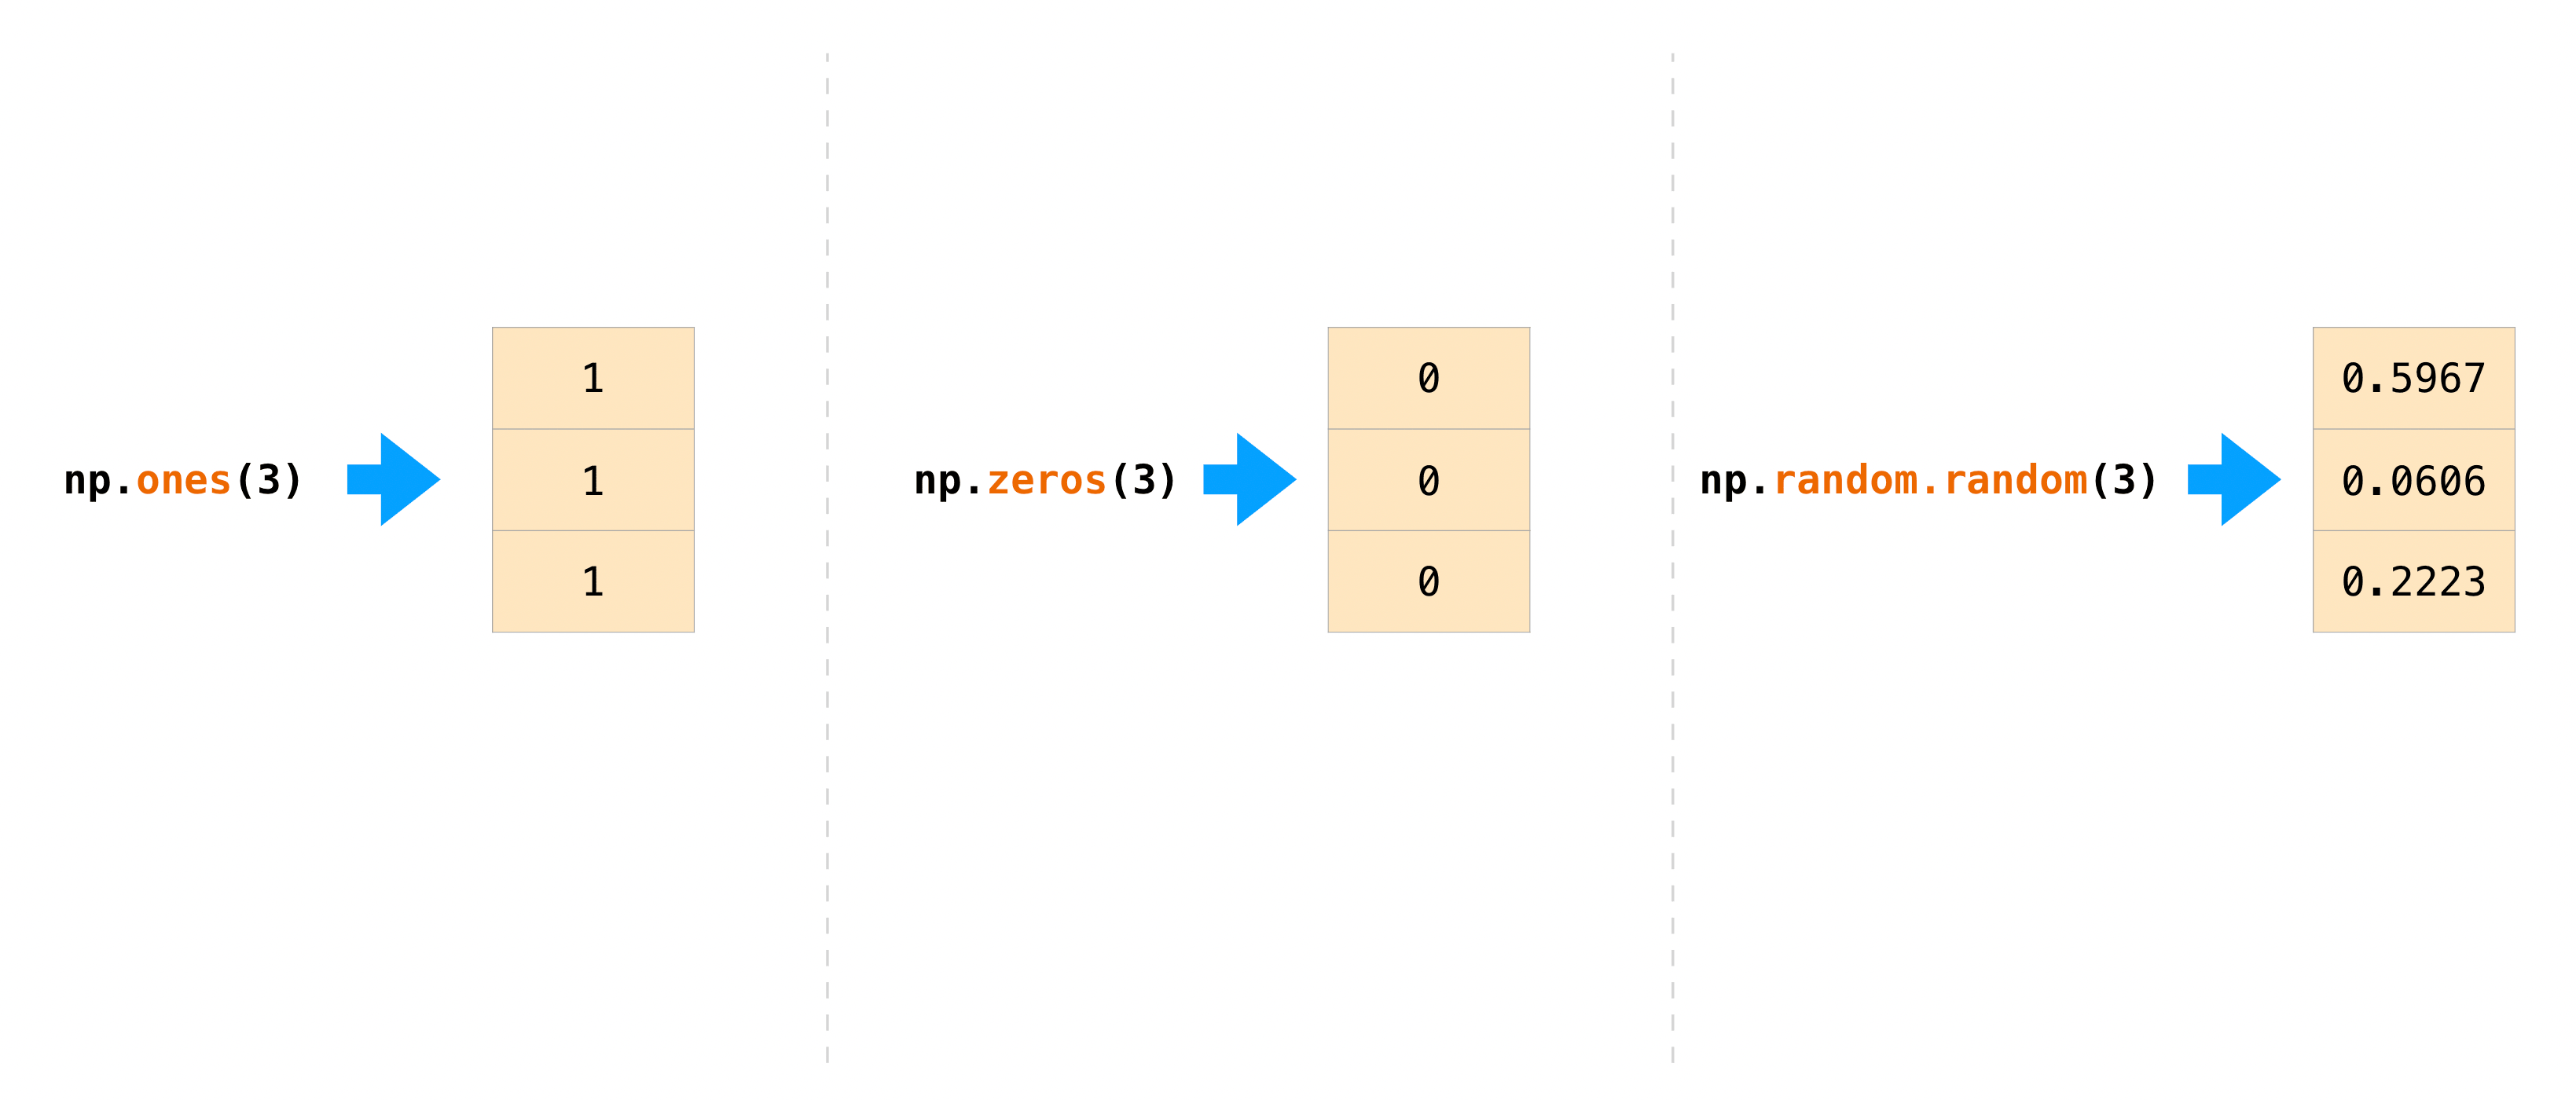
经常需要让 NumPy 初始化数组的值。为此,它提供 ones()、zeros(),以及用于生成随机数的 random.Generator 类。只需传入要生成的元素数量:
>>> np.ones(3)
array([1., 1., 1.])
>>> np.zeros(3)
array([0., 0., 0.])
>>> rng = np.random.default_rng()  # the simplest way to generate random numbers
>>> rng.random(3)
array([0.63696169, 0.26978671, 0.04097352])
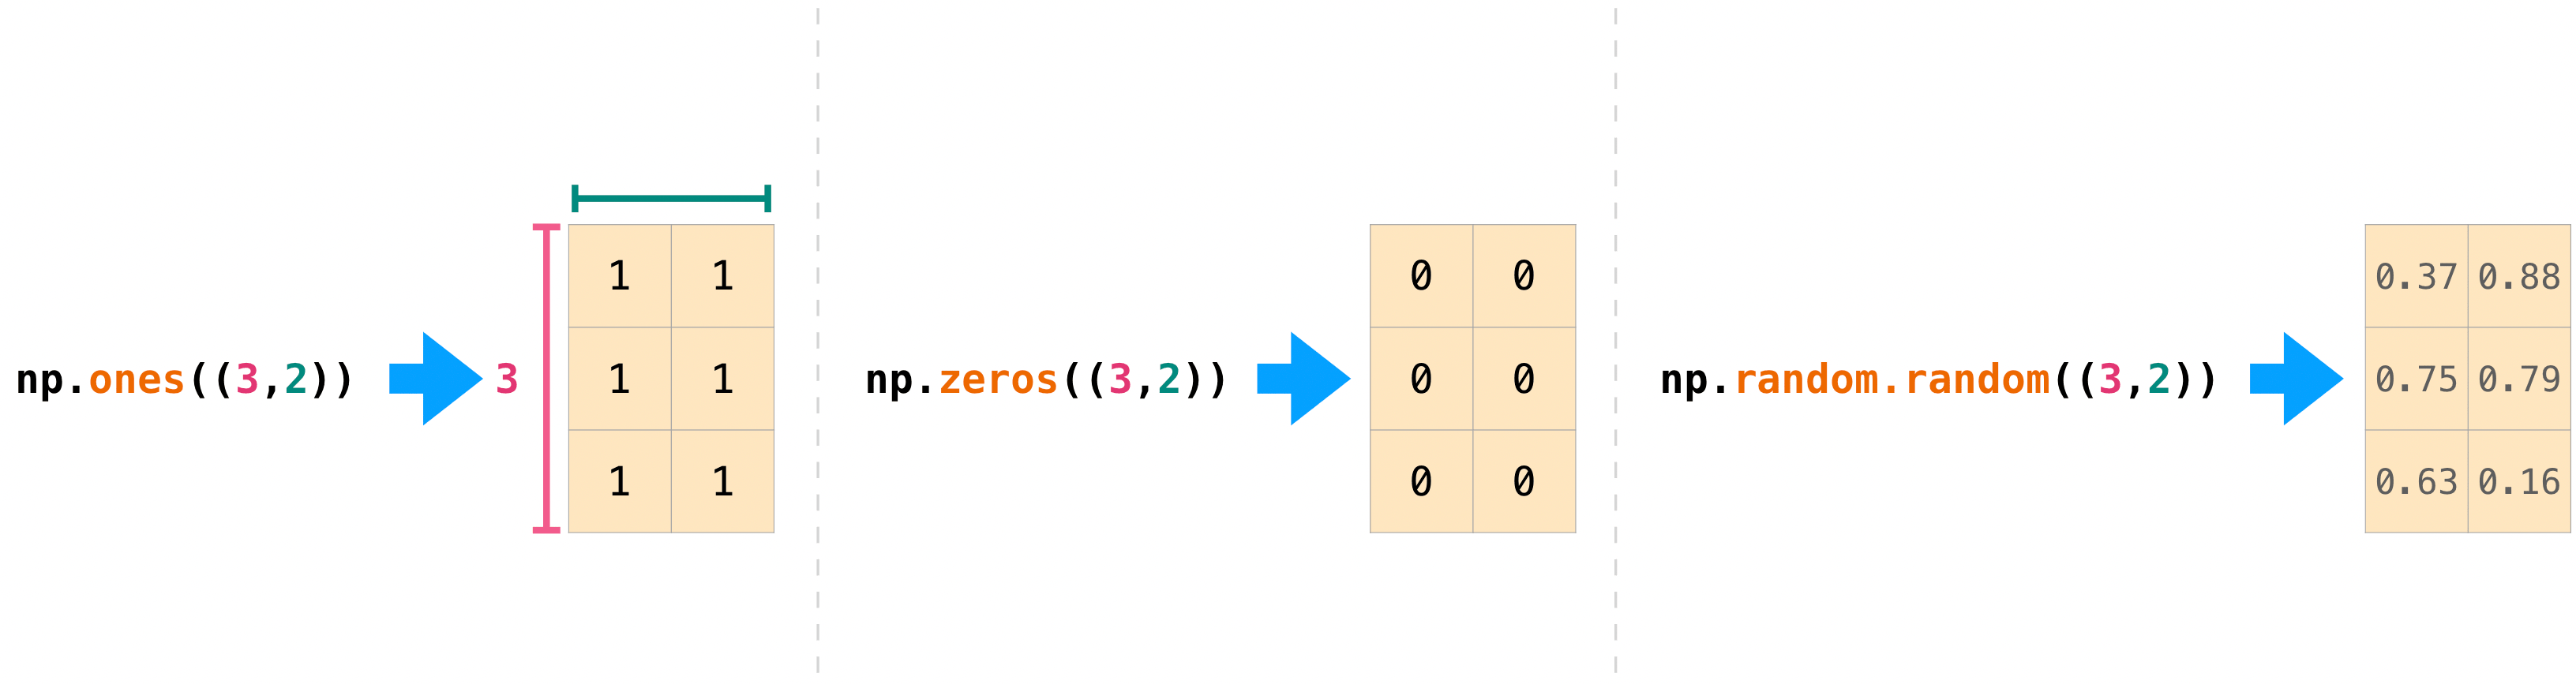
如果传入描述矩阵维度的元组,也可以用 ones()、zeros() 和 random() 创建二维数组:
>>> np.ones((3, 2))
array([[1., 1.],
       [1., 1.],
       [1., 1.]])
>>> np.zeros((3, 2))
array([[0., 0.],
       [0., 0.],
       [0., 0.]])
>>> rng.random((3, 2))
array([[0.01652764, 0.81327024],
       [0.91275558, 0.60663578],
       [0.72949656, 0.54362499]])  # may vary
关于全 0、全 1、其他填充值或未初始化数组,参见数组创建函数文档。[27]
生成随机数
随机数生成是许多数值算法和机器学习算法配置、评估的重要部分。无论是随机初始化神经网络权重、随机划分数据,还是打乱数据集,都需要随机数——严格来说,是可重复生成的伪随机数。
Generator.integers 可以生成从 low(包含)到 high(不包含)的随机整数。设置 endpoint=True 可使 high 也包含在内。
以下代码生成 2×4 的数组,随机整数在 0 到 4 之间:
>>> rng.integers(5, size=(2, 4))
array([[2, 1, 1, 0],
       [0, 0, 0, 4]])  # may vary
更多内容参见随机数生成文档。[28]
取得唯一值及其计数
本节介绍 np.unique()。
使用 np.unique 可以方便地找出数组中的唯一元素。
例如,对于以下数组:
>>> a = np.array([11, 11, 12, 13, 14, 15, 16, 17, 12, 13, 11, 14, 18, 19, 20])
用 np.unique 打印唯一值:
>>> unique_values = np.unique(a)
>>> print(unique_values)
[11 12 13 14 15 16 17 18 19 20]
要取得唯一值的索引,也就是各唯一值第一次出现的位置,除数组外,再向 np.unique() 传入 return_index 参数。
>>> unique_values, indices_list = np.unique(a, return_index=True)
>>> print(indices_list)
[ 0  2  3  4  5  6  7 12 13 14]
传入 return_counts 参数,则可得到每个唯一值出现的次数。
>>> unique_values, occurrence_count = np.unique(a, return_counts=True)
>>> print(occurrence_count)
[3 2 2 2 1 1 1 1 1 1]
这也适用于二维数组。例如:
>>> a_2d = np.array([[1, 2, 3, 4], [5, 6, 7, 8], [9, 10, 11, 12], [1, 2, 3, 4]])
可以这样查找唯一值:
>>> unique_values = np.unique(a_2d)
>>> print(unique_values)
[ 1  2  3  4  5  6  7  8  9 10 11 12]
如果不传 axis 参数,二维数组会先被展平。
若要得到不重复的行或列,必须传 axis 参数。指定 axis=0 查找不重复的行,axis=1 查找不重复的列。
>>> unique_rows = np.unique(a_2d, axis=0)
>>> print(unique_rows)
[[ 1  2  3  4]
 [ 5  6  7  8]
 [ 9 10 11 12]]
要同时取得不重复的行、索引位置与出现次数:
>>> unique_rows, indices, occurrence_count = np.unique(
...      a_2d, axis=0, return_counts=True, return_index=True)
>>> print(unique_rows)
[[ 1  2  3  4]
 [ 5  6  7  8]
 [ 9 10 11 12]]
>>> print(indices)
[0 1 2]
>>> print(occurrence_count)
[2 1 1]
更多内容参见 unique 文档。[29]
矩阵转置与改变形状
本节介绍 arr.reshape()、arr.transpose() 和 arr.T。
矩阵转置是常见需求。NumPy 数组的 T 属性可以实现转置。
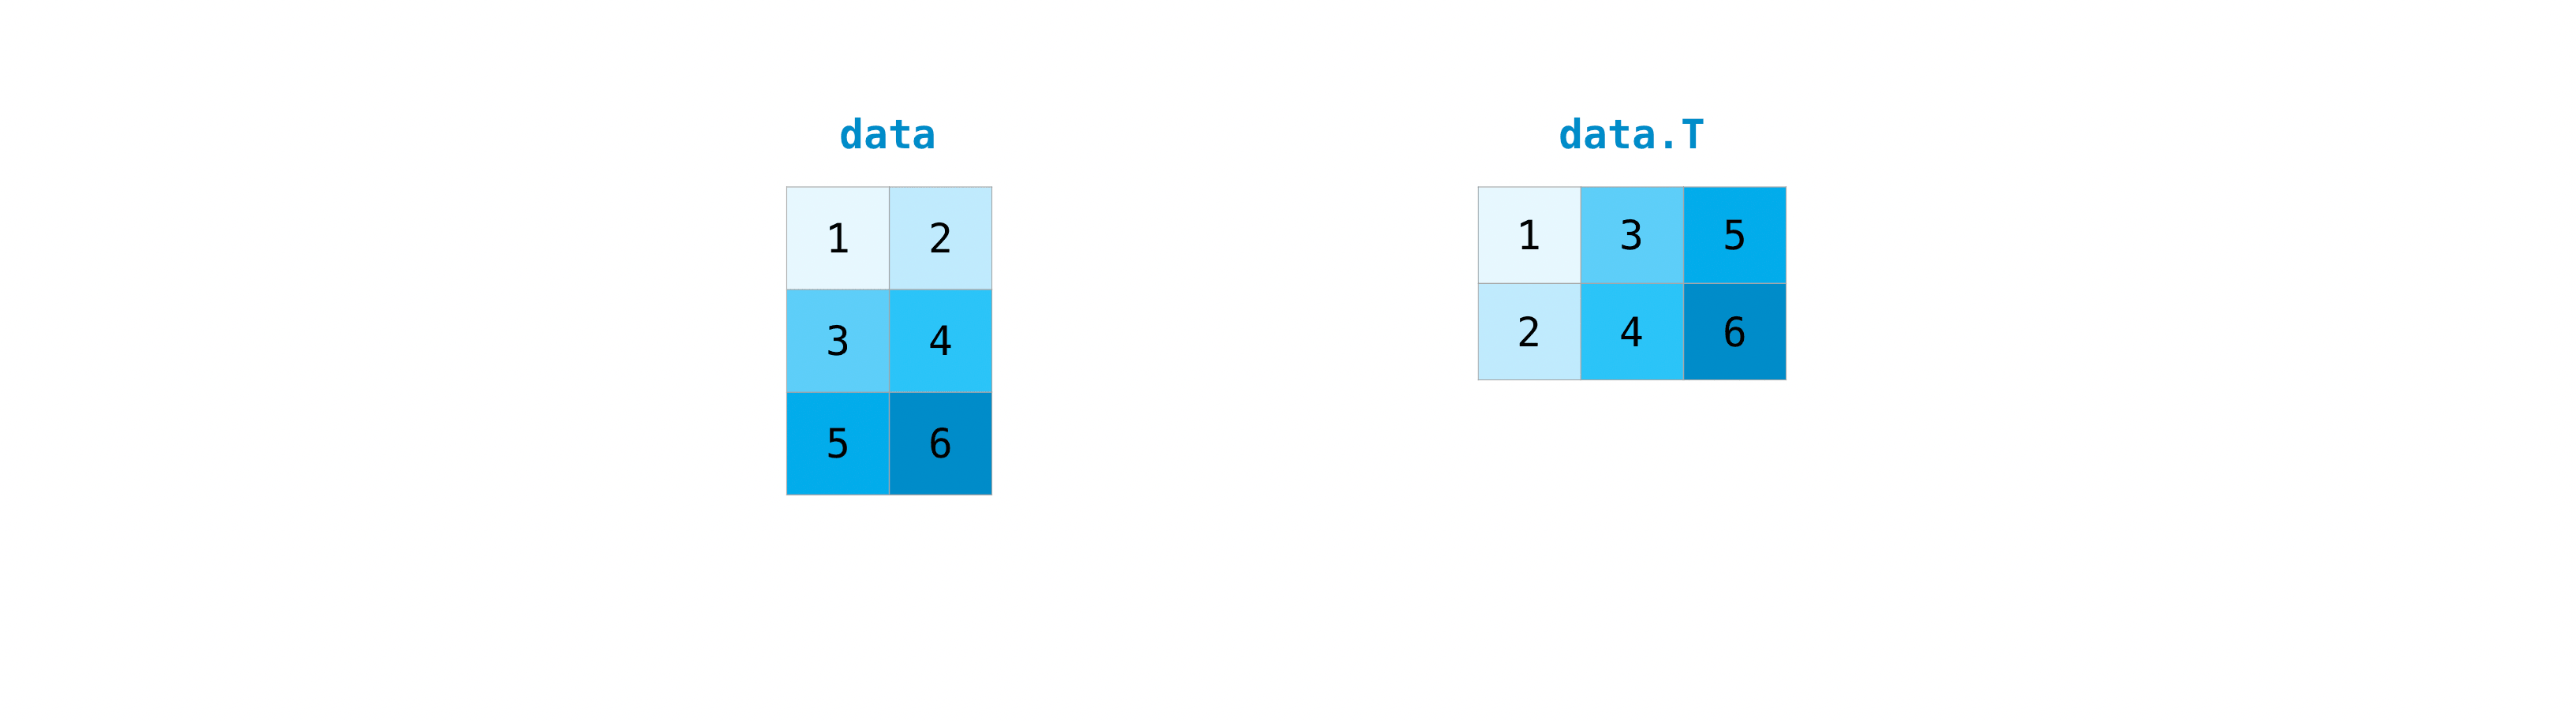
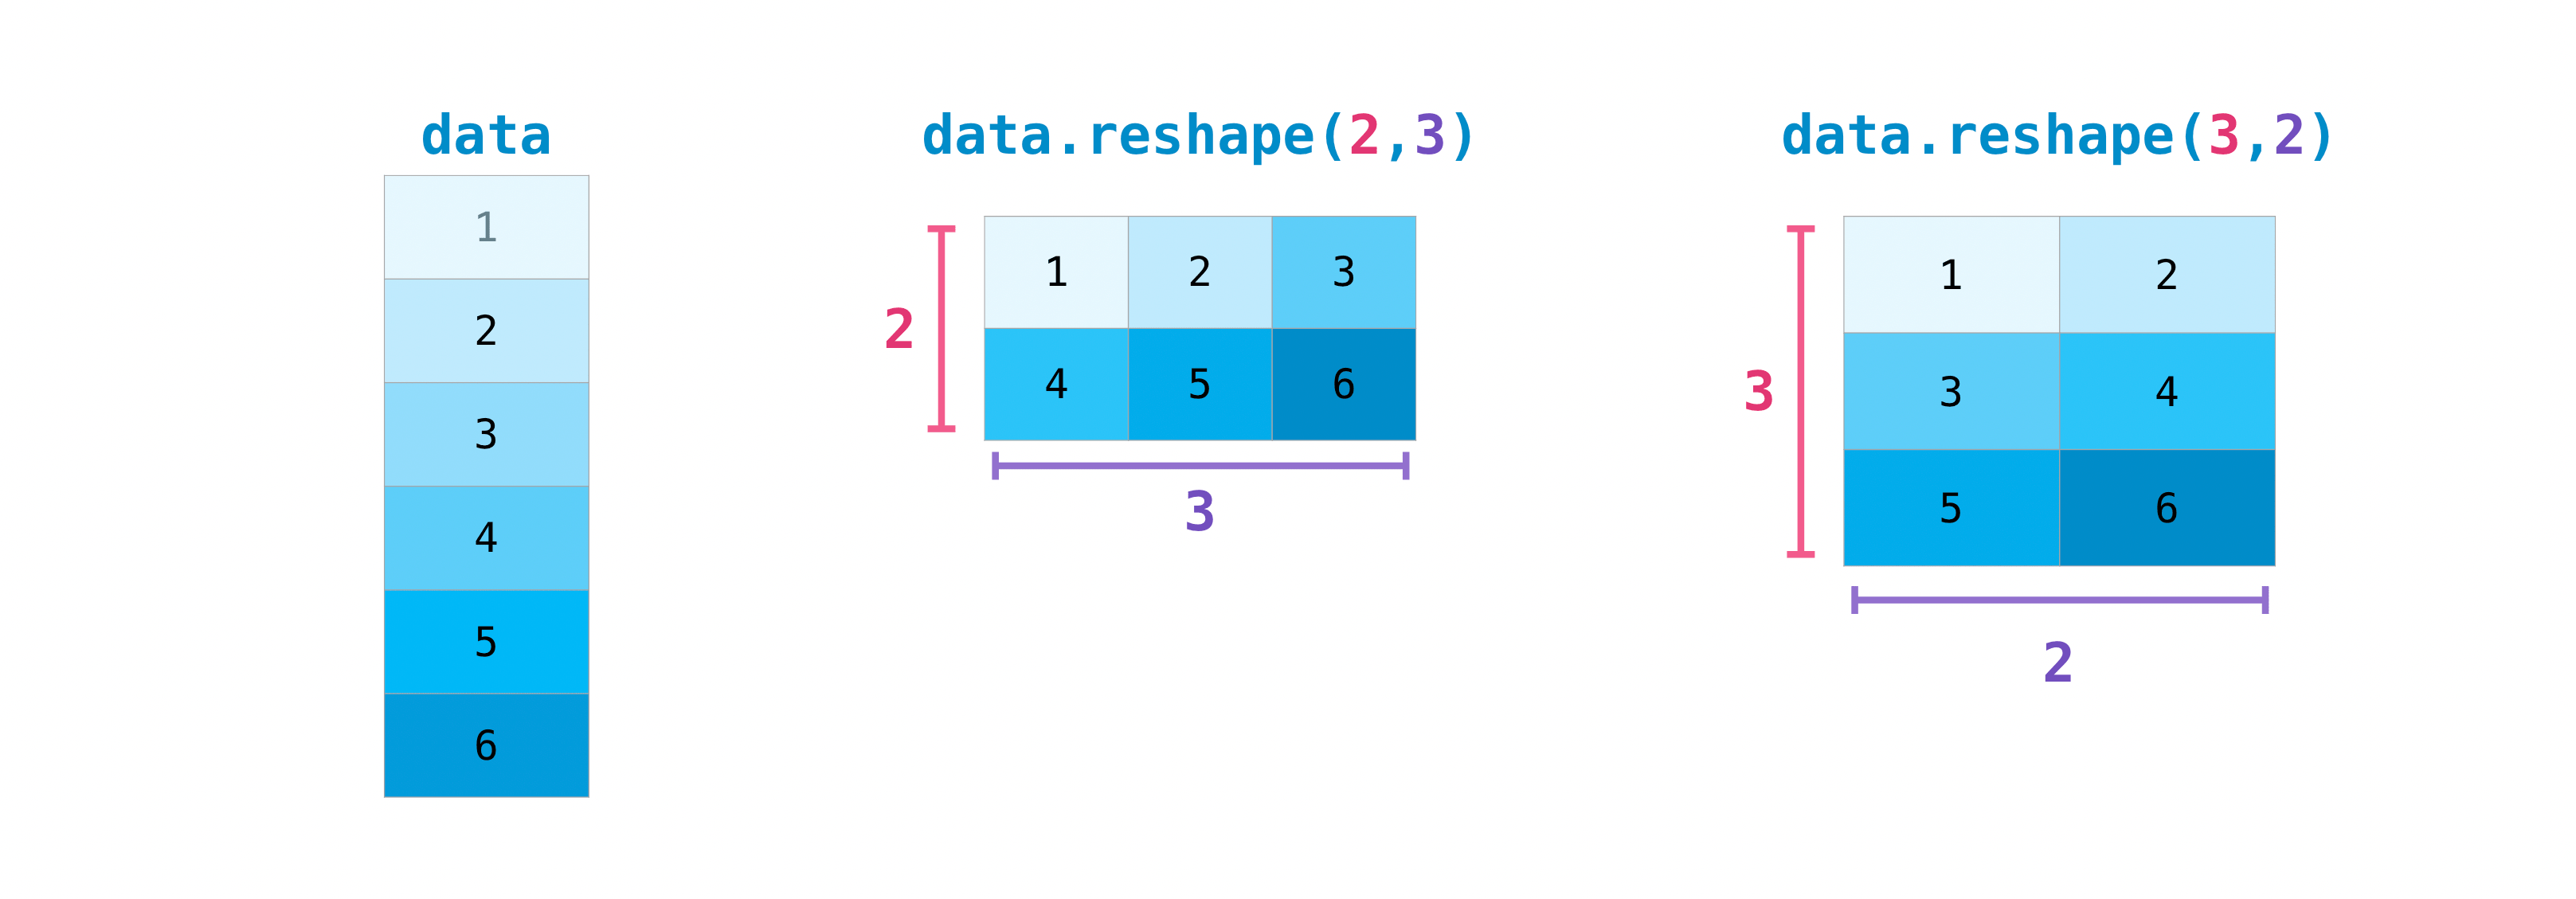
有时也需要改变矩阵维度,例如模型要求的输入形状与数据集不同。reshape 方法就适合这种情况,只需传入新的维度。
>>> data.reshape(2, 3)
array([[1, 2, 3],
       [4, 5, 6]])
>>> data.reshape(3, 2)
array([[1, 2],
       [3, 4],
       [5, 6]])
还可以使用 .transpose(),按指定顺序倒置或改变数组的轴。
例如,对于以下数组:
>>> arr = np.arange(6).reshape((2, 3))
>>> arr
array([[0, 1, 2],
       [3, 4, 5]])
用 arr.transpose() 转置:
>>> arr.transpose()
array([[0, 3],
       [1, 4],
       [2, 5]])
也可以用 arr.T:
>>> arr.T
array([[0, 3],
       [1, 4],
       [2, 5]])
如何反转数组
本节介绍 np.flip()。
np.flip() 可以沿某个轴翻转数组内容。使用时指定数组与轴;如果不指定轴,就会沿输入数组的所有轴反转内容。
反转一维数组
例如,从下面的一维数组开始:
>>> arr = np.array([1, 2, 3, 4, 5, 6, 7, 8])
这样反转:
>>> reversed_arr = np.flip(arr)
打印反转后的数组:
>>> print('Reversed Array: ', reversed_arr)
Reversed Array:  [8 7 6 5 4 3 2 1]
反转二维数组
二维数组的操作基本相同。
对于以下数组:
>>> arr_2d = np.array([[1, 2, 3, 4], [5, 6, 7, 8], [9, 10, 11, 12]])
反转所有行和列中的内容:
>>> reversed_arr = np.flip(arr_2d)
>>> print(reversed_arr)
[[12 11 10  9]
 [ 8  7  6  5]
 [ 4  3  2  1]]
只反转行:
>>> reversed_arr_rows = np.flip(arr_2d, axis=0)
>>> print(reversed_arr_rows)
[[ 9 10 11 12]
 [ 5  6  7  8]
 [ 1  2  3  4]]
只反转列:
>>> reversed_arr_columns = np.flip(arr_2d, axis=1)
>>> print(reversed_arr_columns)
[[ 4  3  2  1]
 [ 8  7  6  5]
 [12 11 10  9]]
也可以只反转某一行或某一列内部的内容。例如反转索引 1,即第二行的内容:
>>> arr_2d[1] = np.flip(arr_2d[1])
>>> print(arr_2d)
[[ 1  2  3  4]
 [ 8  7  6  5]
 [ 9 10 11 12]]
也可以反转索引 1,即第二列的内容:
>>> arr_2d[:,1] = np.flip(arr_2d[:,1])
>>> print(arr_2d)
[[ 1 10  3  4]
 [ 8  7  6  5]
 [ 9  2 11 12]]
更多内容参见 flip 文档。[32]
改变形状与展平多维数组
本节介绍 .flatten() 与 ravel()。
展平数组的常用方式有 .flatten() 和 .ravel()。原文通过下面的例子说明二者的主要区别:ravel() 返回的数组引用父数组的数据,即视图,因此修改它也会影响父数组;不复制数据时,内存效率更高。
从以下数组开始:
>>> x = np.array([[1, 2, 3, 4], [5, 6, 7, 8], [9, 10, 11, 12]])
用 flatten 将数组展平为一维。
>>> x.flatten()
array([ 1,  2,  3,  4,  5,  6,  7,  8,  9, 10, 11, 12])
使用 flatten 后,修改新数组不会改变父数组。
例如:
>>> a1 = x.flatten()
>>> a1[0] = 99
>>> print(x)  # Original array
[[ 1  2  3  4]
 [ 5  6  7  8]
 [ 9 10 11 12]]
>>> print(a1)  # New array
[99  2  3  4  5  6  7  8  9 10 11 12]
而在这里使用 ravel 后,修改新数组会影响父数组。
例如:
>>> a2 = x.ravel()
>>> a2[0] = 98
>>> print(x)  # Original array
[[98  2  3  4]
 [ 5  6  7  8]
 [ 9 10 11 12]]
>>> print(a2)  # New array
[98  2  3  4  5  6  7  8  9 10 11 12]
访问文档字符串以获取更多信息
本节介绍 help()、? 和 ??。
在数据科学生态中,Python 与 NumPy 的设计充分考虑使用者。内置的文档访问方式就是很好的例子。每个对象都关联一个称为 docstring 的文档字符串,通常简要说明对象及其用法。Python 内置 help() 可以访问这些信息。因此需要更多说明时,几乎随时都能通过 help() 快速查找。
例如:
>>> help(max)
Help on built-in function max in module builtins:

max(...)
    max(iterable, *[, default=obj, key=func]) -> value
    max(arg1, arg2, *args, *[, key=func]) -> value

    With a single iterable argument, return its biggest item. The
    default keyword-only argument specifies an object to return if
    the provided iterable is empty.
    With two or more ...arguments, return the largest argument.
由于这种信息访问非常有用,IPython 使用 ? 作为快捷语法,显示文档及相关信息。IPython 是支持多种语言交互计算的命令 shell,详情参见其文档。[35]
例如:
In [0]: max?
max(iterable, *[, default=obj, key=func]) -> value
max(arg1, arg2, *args, *[, key=func]) -> value

With a single iterable argument, return its biggest item. The
default keyword-only argument specifies an object to return if
the provided iterable is empty.
With two or more arguments, return the largest argument.
Type:      builtin_function_or_method
该语法也适用于对象方法和对象本身。
假设创建以下数组:
>>> a = np.array([1, 2, 3, 4, 5, 6])
可以取得大量信息:先是 a 对象本身的详情,随后是它所属 ndarray 类型的文档字符串。
In [1]: a?
Type:            ndarray
String form:     [1 2 3 4 5 6]
Length:          6
File:            ~/anaconda3/lib/python3.9/site-packages/numpy/__init__.py
Docstring:       <no docstring>
Class docstring:
ndarray(shape, dtype=float, buffer=None, offset=0,
        strides=None, order=None)

An array object represents a multidimensional, homogeneous array
of fixed-size items.  An associated data-type object describes the
format of each element in the array (its byte-order, how many bytes it
occupies in memory, whether it is an integer, a floating point number,
or something else, etc.)

Arrays should be constructed using `array`, `zeros` or `empty` (refer
to the See Also section below).  The parameters given here refer to
a low-level method (`ndarray(...)`) for instantiating an array.

For more information, refer to the `numpy` module and examine the
methods and attributes of an array.

Parameters
----------
(for the __new__ method; see Notes below)

shape : tuple of ints
        Shape of created array.
...
这也适用于自己创建的函数与其他对象。记得在函数中使用字符串字面量包含文档,例如用三双引号或三单引号包住文档内容。
例如,创建以下函数:
>>> def double(a):
...   '''Return a * 2'''
...   return a * 2
便能查询函数的信息:
In [2]: double?
Signature: double(a)
Docstring: Return a * 2
File:      ~/Desktop/<ipython-input-23-b5adf20be596>
Type:      function
阅读对象源码可以获得更深一层的信息。使用双问号 ?? 即可访问源码。
例如:
In [3]: double??
Signature: double(a)
Source:
def double(a):
    '''Return a * 2'''
    return a * 2
File:      ~/Desktop/<ipython-input-23-b5adf20be596>
Type:      function
如果对象是由 Python 之外的语言编译而成,?? 与 ? 会返回相同信息。许多内置对象和类型都如此,例如:
In [4]: len?
Signature: len(obj, /)
Docstring: Return the number of items in a container.
Type:      builtin_function_or_method
以及:
In [5]: len??
Signature: len(obj, /)
Docstring: Return the number of items in a container.
Type:      builtin_function_or_method
它们的输出相同,因为这些对象由 Python 之外的编程语言编译而成。
使用数学公式
能够轻松实现作用于数组的数学公式,是 NumPy 在科学 Python 社区广泛应用的原因之一。
例如,下面是均方误差公式,它是监督学习回归模型中的重要公式:
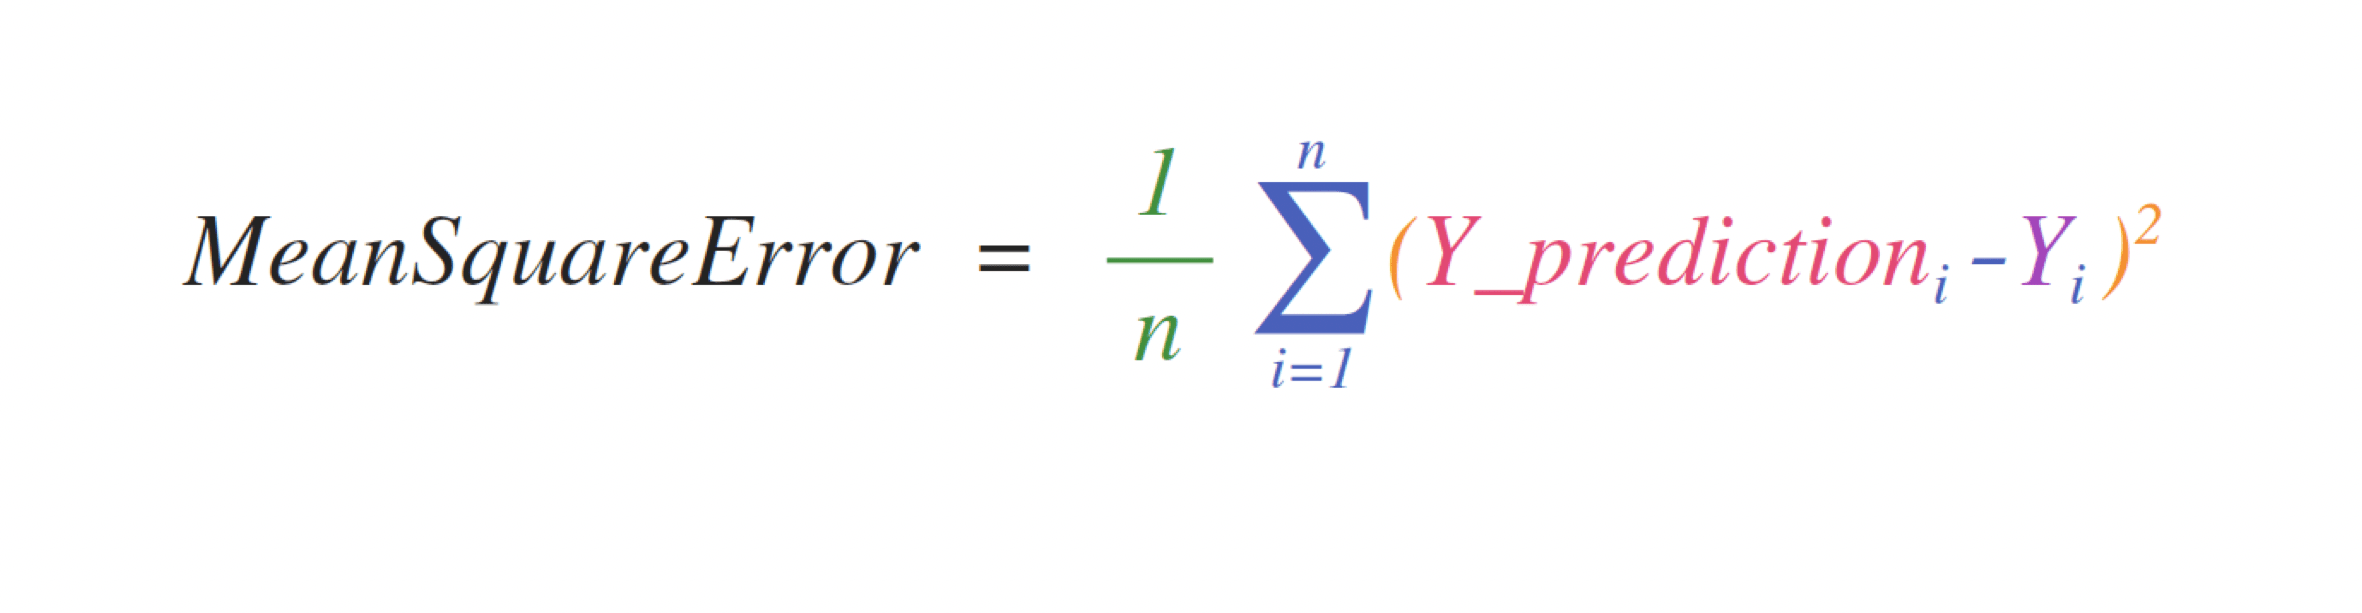
在 NumPy 中实现这一公式简单直接:
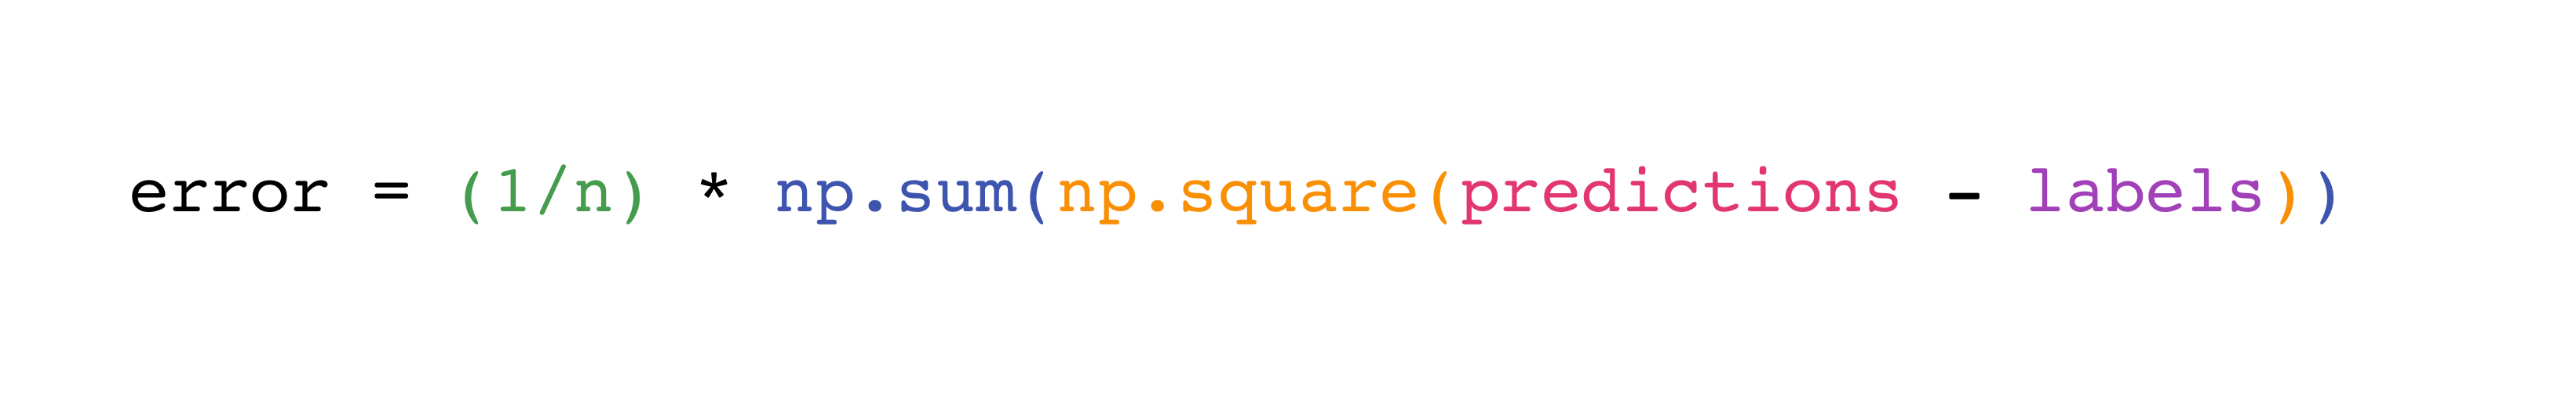
它之所以方便,是因为 predictions 和 labels 可以包含一个或一千个值,只需二者大小相同。
可以这样画出计算过程:
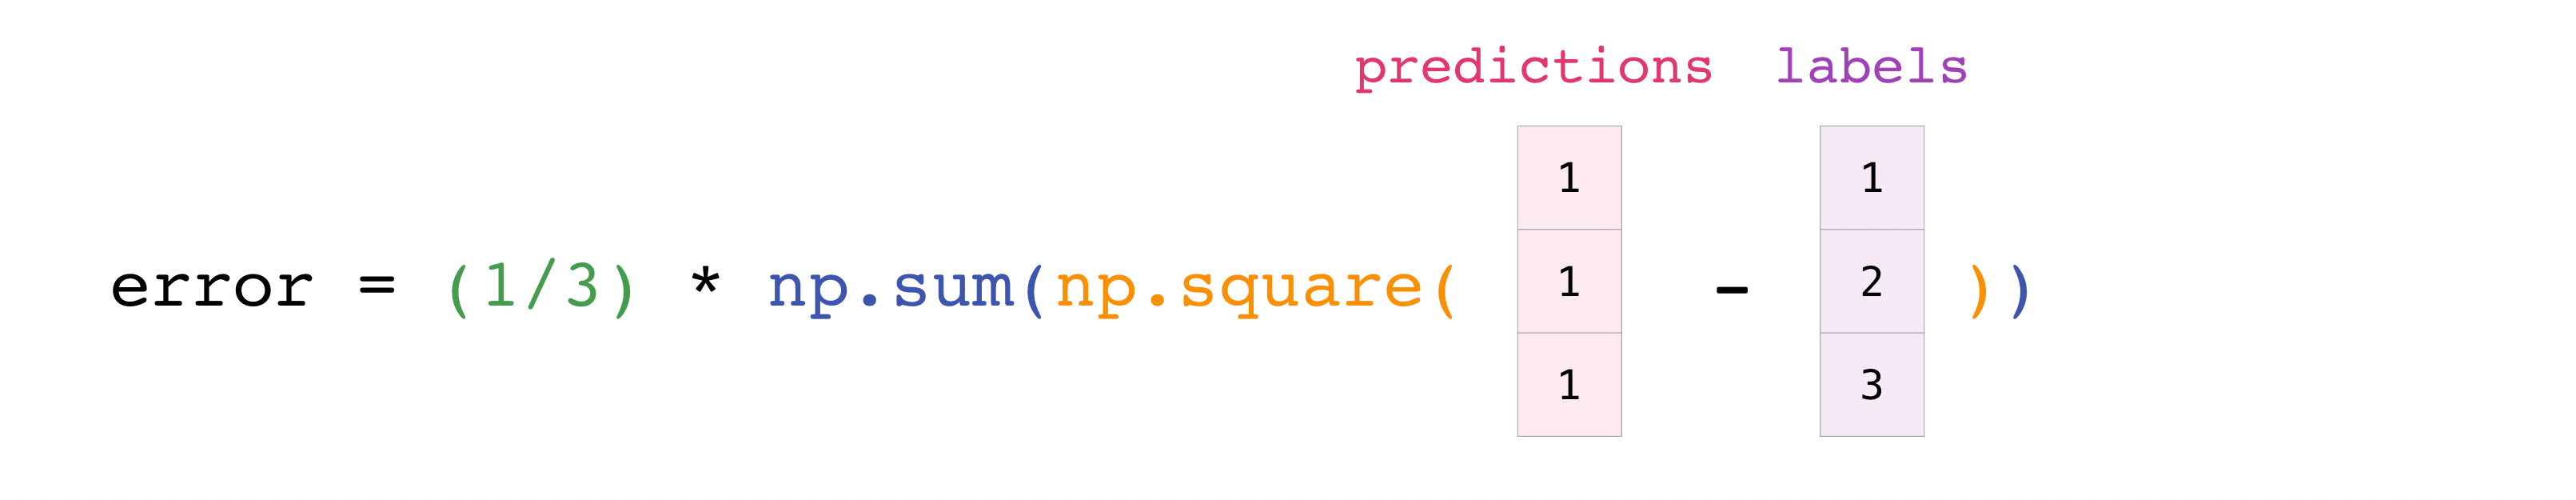
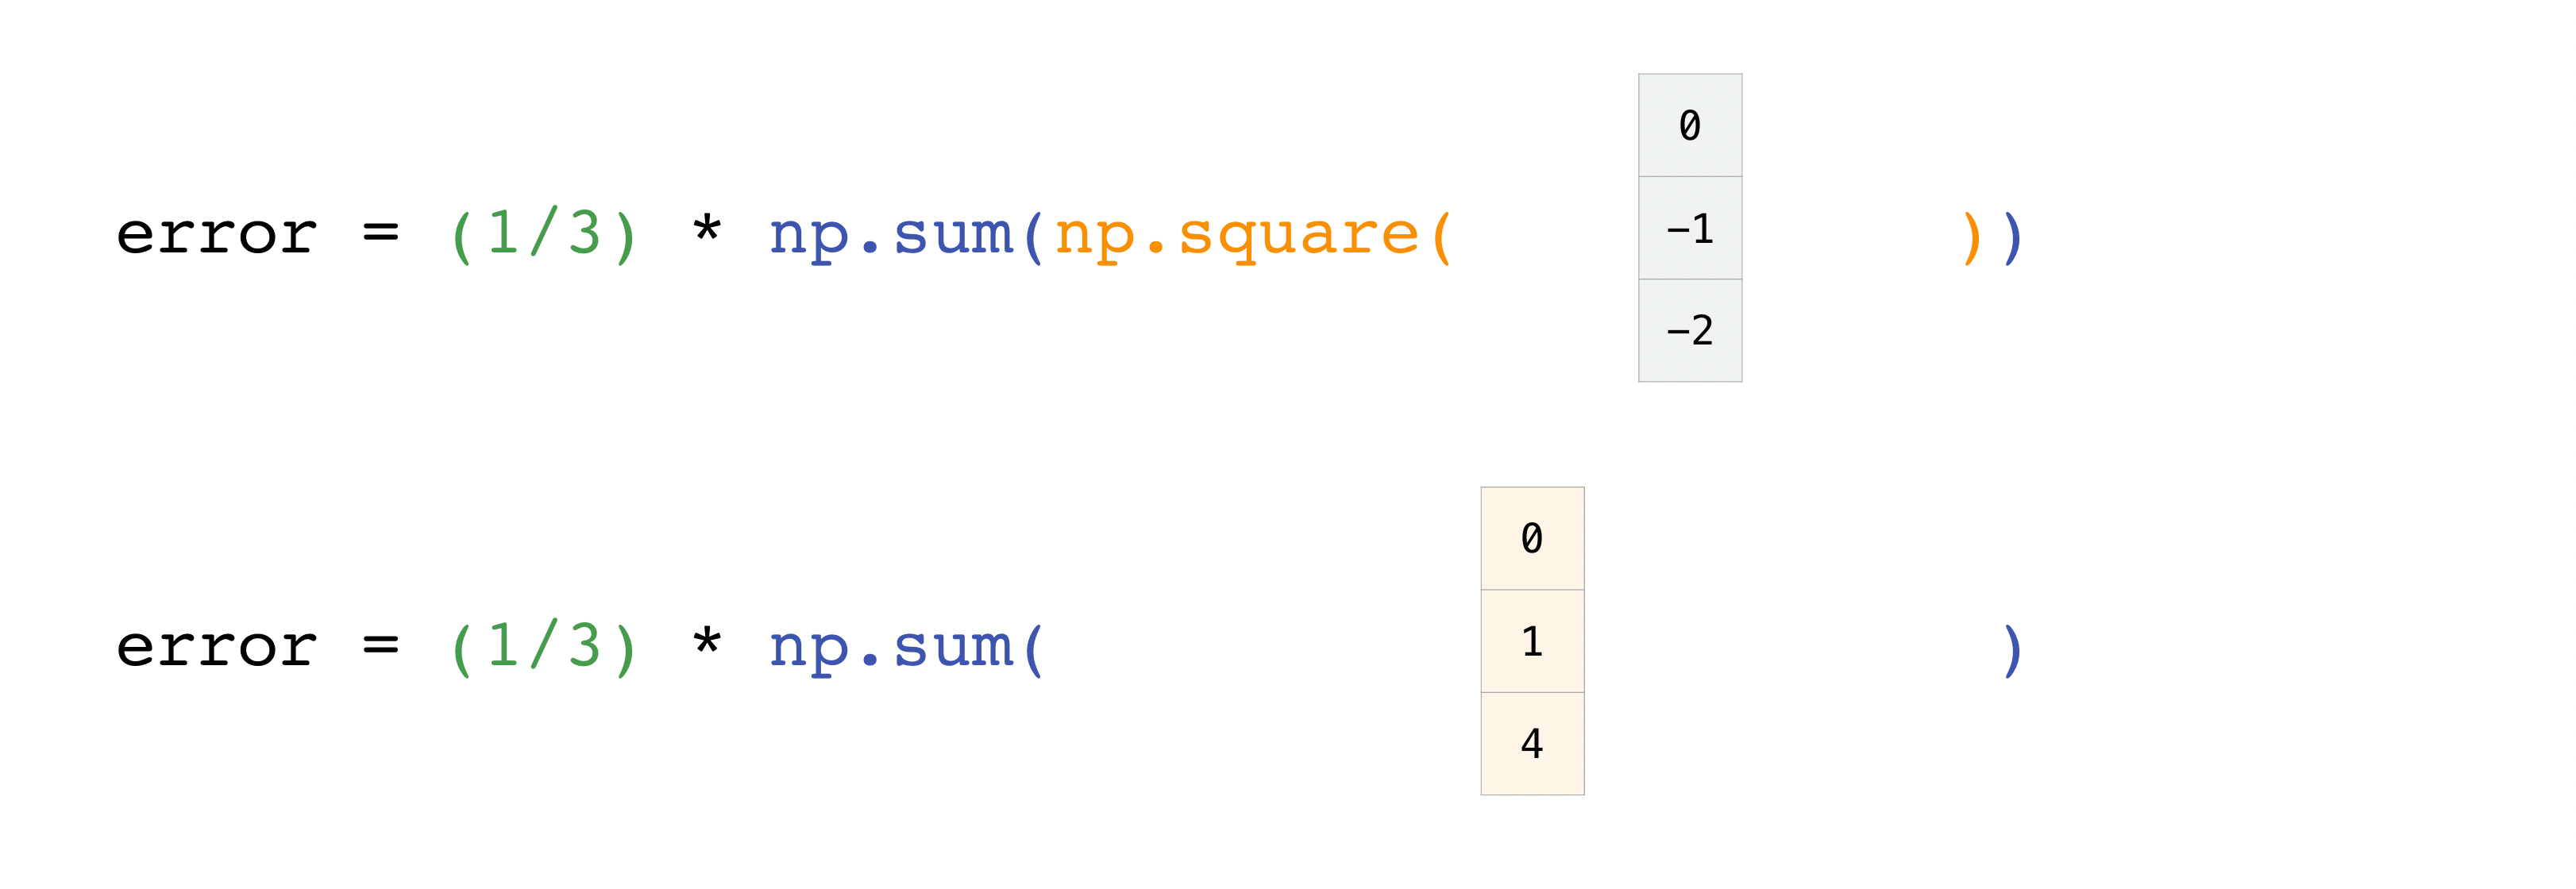
本例中 predictions 与 labels 都含三个值,因此 n=3。先相减,再将各值平方,然后求和,得到预测误差及模型质量的评分;均方误差还按公式除以 n。
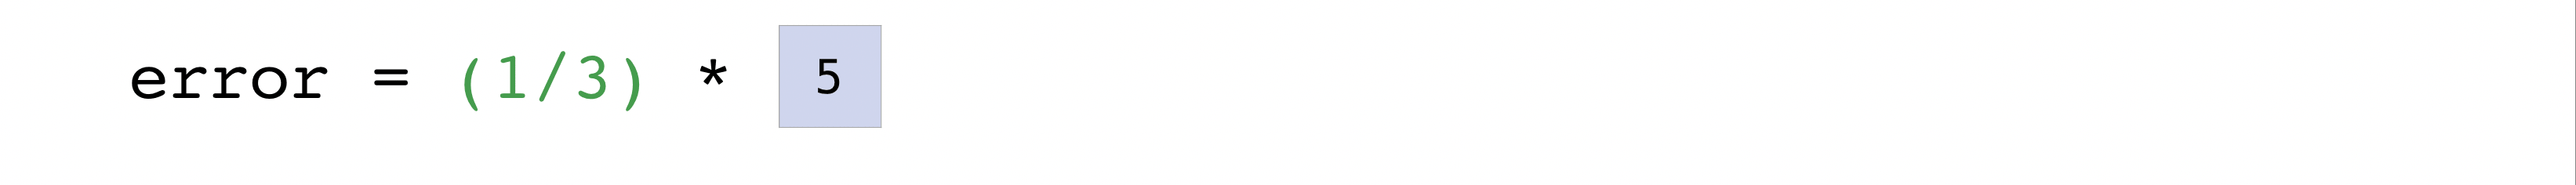
保存与加载 NumPy 对象
本节介绍 np.save、np.savez、np.savetxt、np.load 和 np.loadtxt。
有时需要把数组保存到磁盘,之后重新加载,避免再次运行全部代码。NumPy 提供多种方式:loadtxt 与 savetxt 处理普通文本文件;load 与 save 处理扩展名为 .npy 的 NumPy 二进制文件;savez 处理扩展名为 .npz 的 NumPy 文件。
.npy 和 .npz 保存数据、形状、dtype 以及重建 ndarray 所需的其他信息,即使文件位于架构不同的另一台机器上,也能正确恢复数组。
保存单个 ndarray 时,用 np.save 写入 .npy;在一个文件中保存多个 ndarray 时,用 np.savez 写入 .npz;还可以用 savez_compressed 将多个数组保存为压缩 npz 文件。[36]
使用 np.save() 保存数组很简单,只需指定数组和文件名。例如创建以下数组:
>>> a = np.array([1, 2, 3, 4, 5, 6])
将其保存为 filename.npy:
>>> np.save('filename', a)
用 np.load() 重建数组:
>>> b = np.load('filename.npy')
检查加载后的数组:
>>> print(b)
[1 2 3 4 5 6]
也可以用 np.savetxt 将数组保存为 .csv、.txt 等纯文本文件。
例如创建以下数组:
>>> csv_arr = np.array([1, 2, 3, 4, 5, 6, 7, 8])
将其保存为 new_file.csv:
>>> np.savetxt('new_file.csv', csv_arr)
使用 loadtxt() 可以快速加载保存的文本文件:
>>> np.loadtxt('new_file.csv')
array([1., 2., 3., 4., 5., 6., 7., 8.])
savetxt() 与 loadtxt() 还接受 header、footer、delimiter 等可选参数。文本文件可能更易分享,但 .npy 与 .npz 更小、读取更快。如果需要更复杂的文本处理,例如处理包含缺失值的行,应使用 genfromtxt。[37]
savetxt 还能指定页眉、页脚、注释等。[38]
更多内容参见输入输出函数文档。[39]
导入与导出 CSV
读取包含现有数据的 CSV 很简单,原文推荐使用 Pandas 作为方便易用的方式。[40]
>>> import pandas as pd

>>> # If all of your columns are the same type:
>>> x = pd.read_csv('music.csv', header=0).values
>>> print(x)
[['Billie Holiday' 'Jazz' 1300000 27000000]
 ['Jimmie Hendrix' 'Rock' 2700000 70000000]
 ['Miles Davis' 'Jazz' 1500000 48000000]
 ['SIA' 'Pop' 2000000 74000000]]

>>> # You can also simply select the columns you need:
>>> x = pd.read_csv('music.csv', usecols=['Artist', 'Plays']).values
>>> print(x)
[['Billie Holiday' 27000000]
 ['Jimmie Hendrix' 70000000]
 ['Miles Davis' 48000000]
 ['SIA' 74000000]]
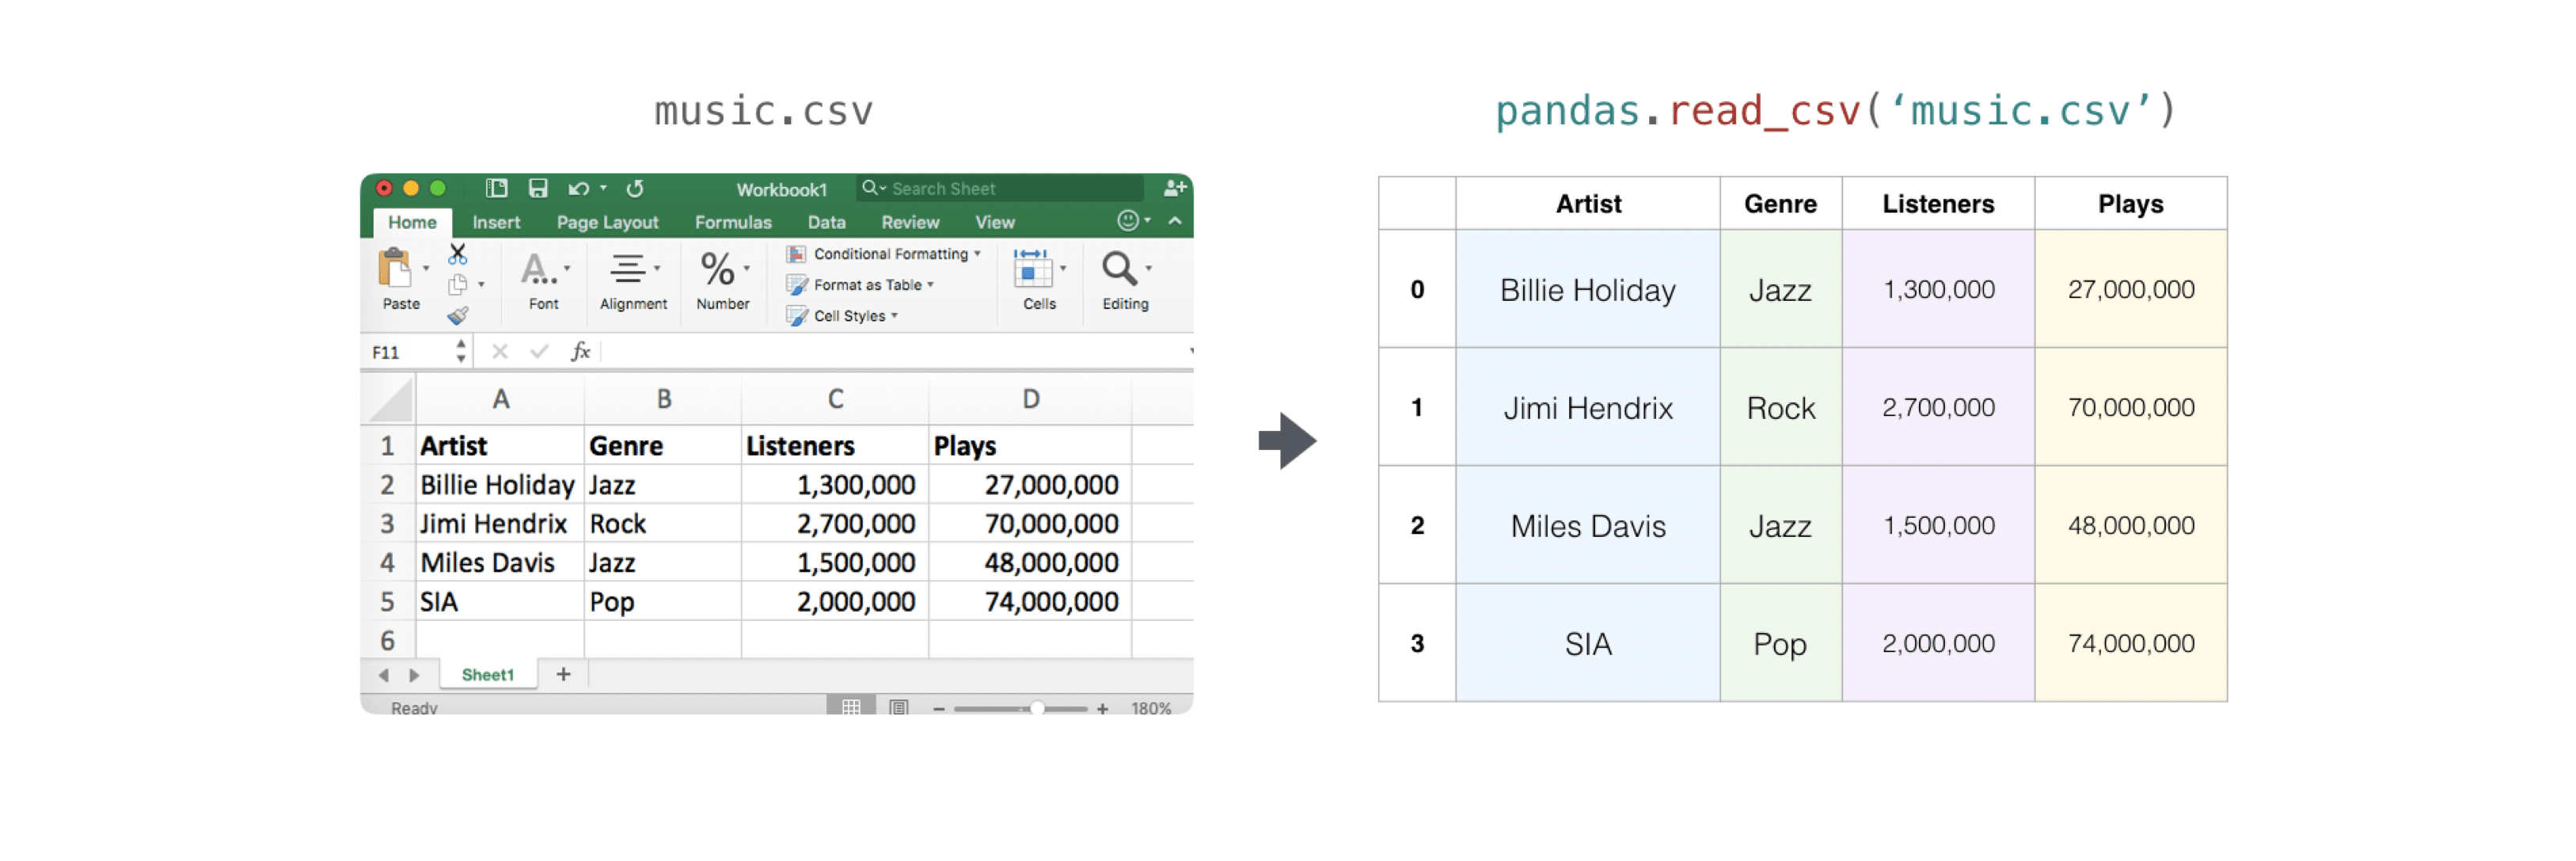
用 Pandas 导出数组也很简单。初学 NumPy 时,可以先根据数组中的值创建 Pandas DataFrame,再用 Pandas 将它写入 CSV。
假设创建了数组 a:
>>> a = np.array([[-2.58289208,  0.43014843, -1.24082018, 1.59572603],
...               [ 0.99027828, 1.17150989,  0.94125714, -0.14692469],
...               [ 0.76989341,  0.81299683, -0.95068423, 0.11769564],
...               [ 0.20484034,  0.34784527,  1.96979195, 0.51992837]])
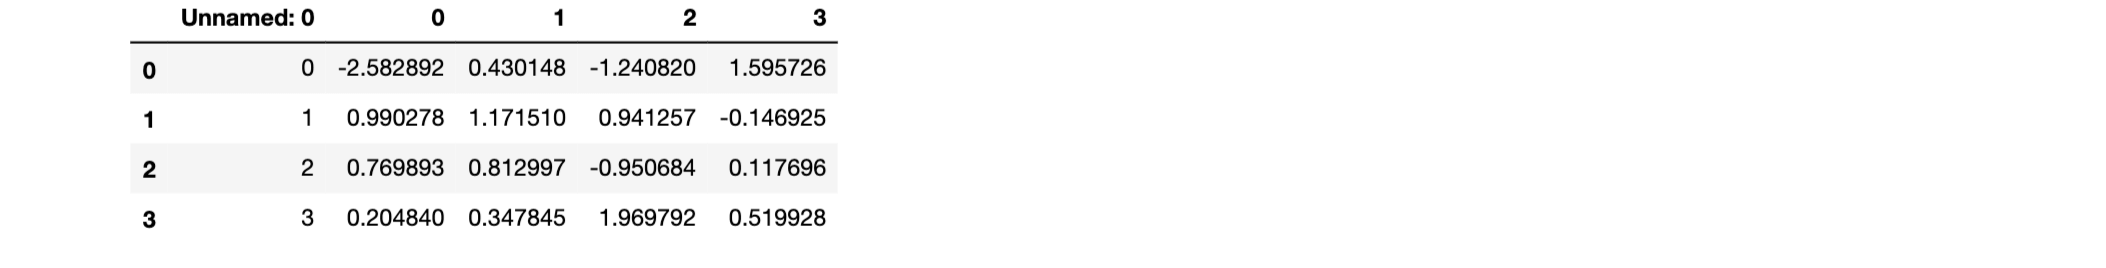
创建 Pandas DataFrame:
>>> df = pd.DataFrame(a)
>>> print(df)
          0         1         2         3
0 -2.582892  0.430148 -1.240820  1.595726
1  0.990278  1.171510  0.941257 -0.146925
2  0.769893  0.812997 -0.950684  0.117696
3  0.204840  0.347845  1.969792  0.519928
保存 DataFrame:
>>> df.to_csv('pd.csv')
读取 CSV:
>>> data = pd.read_csv('pd.csv')
也可以用 NumPy 的 savetxt 方法保存数组。
>>> np.savetxt('np.csv', a, fmt='%.2f', delimiter=',', header='1, 2, 3, 4')
如果使用命令行,可以随时用如下命令查看保存的 CSV:
$ cat np.csv
#  1,  2,  3,  4
-2.58,0.43,-1.24,1.60
0.99,1.17,0.94,-0.15
0.77,0.81,-0.95,0.12
0.20,0.35,1.97,0.52
也可以随时用文本编辑器打开文件!
用 Matplotlib 绘制数组
如果需要绘制这些数值,使用 Matplotlib 很简单。[43]
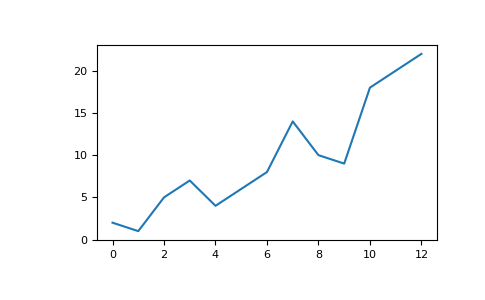
例如,有以下数组:
>>> a = np.array([2, 1, 5, 7, 4, 6, 8, 14, 10, 9, 18, 20, 22])
安装 Matplotlib 后可以这样导入:
>>> import matplotlib.pyplot as plt

# If you're using Jupyter Notebook, you may also want to run the following
# line of code to display your code in the notebook:

%matplotlib inline
绘图只需运行:
>>> plt.plot(a)

# If you are running from a command line, you may need to do this:
# >>> plt.show()
例如这样绘制一维数组:
>>> x = np.linspace(0, 5, 20)
>>> y = np.linspace(0, 10, 20)
>>> plt.plot(x, y, 'purple') # line
>>> plt.plot(x, y, 'o')      # dots
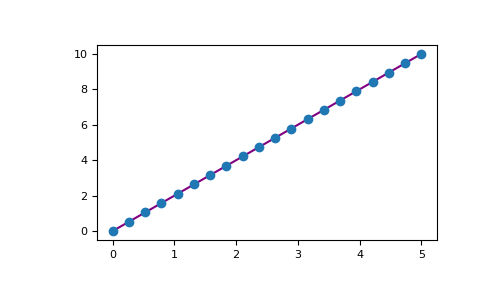
Matplotlib 提供了丰富的可视化选项。
>>> fig = plt.figure()
>>> ax = fig.add_subplot(projection='3d')
>>> X = np.arange(-5, 5, 0.15)
>>> Y = np.arange(-5, 5, 0.15)
>>> X, Y = np.meshgrid(X, Y)
>>> R = np.sqrt(X**2 + Y**2)
>>> Z = np.sin(R)

>>> ax.plot_surface(X, Y, Z, rstride=1, cstride=1, cmap='viridis')
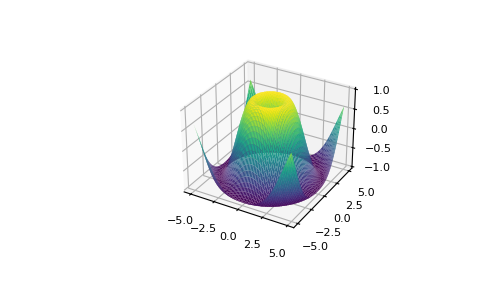
更多功能参见 Matplotlib 官方文档,安装方法参见官方安装章节。[44][45]
图片作者:Jay Alammar,https://jalammar.github.io/。[46]











暂无评论内容