


多列近似排序:让仪表板查询更快
|
19 min
加载列式数据时,采用更高级的多列排序策略,可以加速多种具有筛选条件的读取查询。Morton(Z-order)和 Hilbert 等空间填充曲线可同时对多列进行近似排序;如果还需要筛选近期数据,先按截断后的时间戳排序,也能带来额外收益。
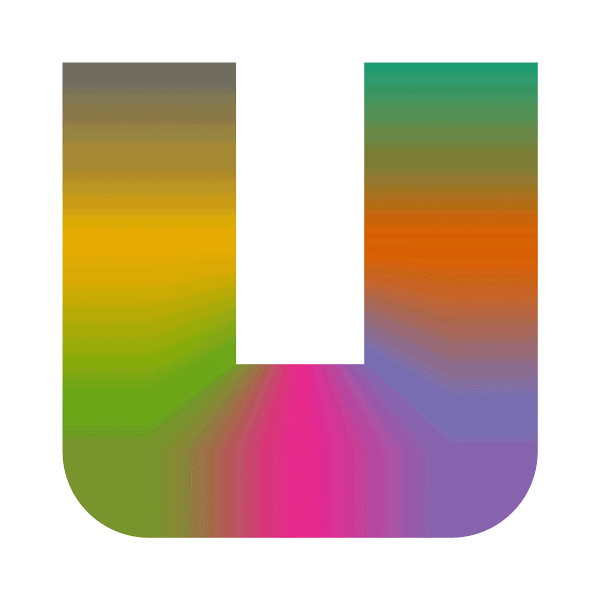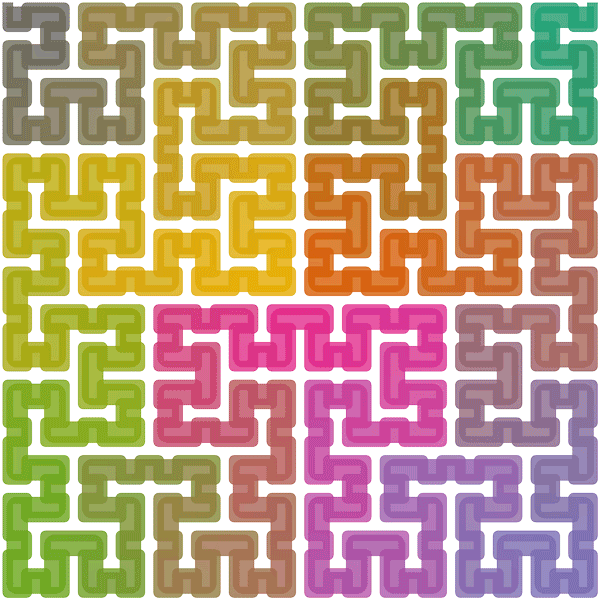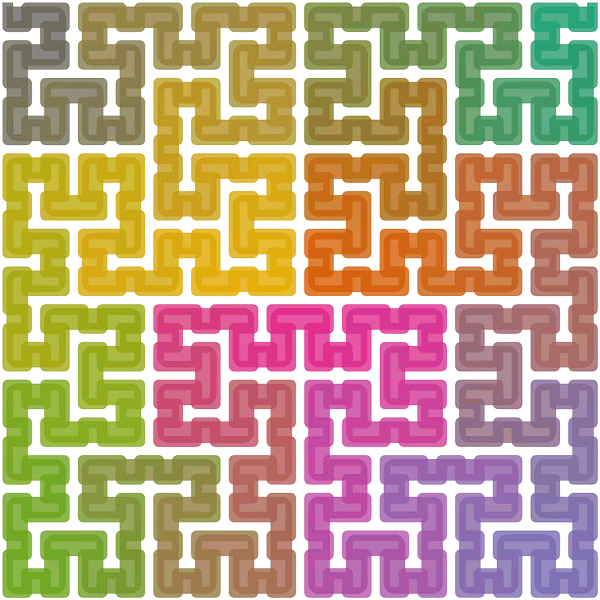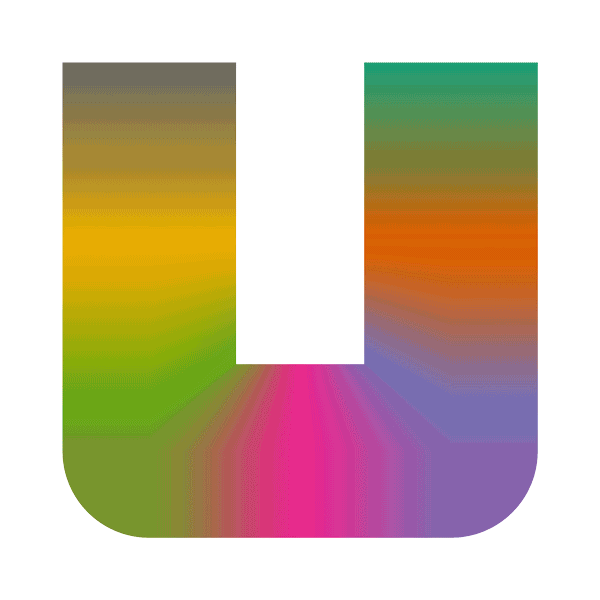
An animated Hilbert space filling curve by TimSauder – Own work, CC BY-SA 4.0
仪表板很少只有一张图,查询数据的方式也很少只有一种;完全不带筛选条件的查询就更少见了。
当查询只读取部分行时,在加载阶段对数据排序能带来明显收益。本系列上一篇文章介绍了原理和实用建议。
要让更多实际场景受益,需要更灵活的排序方式。以下情况尤其适合这些进阶技巧:
- 不同查询筛选不同列。
- 查询模式无法完全预测。
- 查询同时筛选时间和至少一个其他字段。
本文介绍几种高级排序策略,通过微基准实验比较效果,并用一个指标衡量排序质量。
策略
目标是对更多列进行近似排序,而不是只对一列或少数几列精确排序,让带有不同 WHERE 条件的查询都能受益于 DuckDB 的 min-max 索引(zone map)。主要方法有两类:空间填充曲线,以及截断后的时间戳排序。
空间填充曲线
Morton 和 Hilbert 算法将多个维度映射到一个顺序,同时尽量保留各维度上的邻近关系。地理空间分析是一个直观例子。
假设数据集每行是一家咖啡馆的经纬度,希望地理位置相近的咖啡馆在列表中也彼此靠近,就可以使用空间填充曲线。经纬度都比较接近的点,会得到相近的 Morton 或 Hilbert 编码,从而加速“查找地图某个矩形范围内的全部咖啡馆”这样的查询;该矩形在地理空间分析中称为边界框。本文开头的 GIF 展示了不同精细程度的 Hilbert 编码:可把横轴看作经度、纵轴看作纬度,曲折的线就是近似排序后的列表。
两种编码接受整数或浮点数,但也可以用于 VARCHAR 列:先通过 SQL 宏将字符串的前几个字符转换为整数,再进行编码。
截断时间戳
较新的数据通常更有用,因此查询经常筛选时间列;但往往还会同时筛选其他字段。
不要只按精确时间戳排序。时间戳通常很细,结果实际上只按时间排序,后续排序字段难以发挥作用。例如,恰好在 2025-01-01 01:02:03.456789 插入的行,可能只有一行。
要同时兼顾时间与其他列,应先将时间截断到日、周、年等粒度的起点,再按其他列排序。
航班准点数据集
想知道美国某条航线的延误概率,可以使用政府公布的航班准点数据。原文作者从 Kaggle 下载了 Parquet 版本,包含近 5 年美国航班数据,文件合计约 1.1GB。本地访问时不算大,但慢速远程连接会遇到挑战。下面的实验展示数据裁剪如何减少回答查询所需的网络传输。
第一个实验模拟仪表板:用户可以筛选单个出发机场 origin、单个目的机场 dest,或一对出发地—目的地。字段值是 LAX、JFK 等三字母机场代码。选择筛选后,用户需要全部匹配行以及任意几个字段。
第二个实验增加时间条件:用户还可以筛选数据集最近 1、13 或 52 周的数据。
实验设计
下面比较几种用于加速读取的近似排序方式。
对照组包括:
random:按哈希排序,模拟最不利的随机分布。origin:仅按出发机场排序。origin-dest:先按出发机场,再按目的机场排序。
替代排序方式包括:
zipped_varchar:交替取出发机场和目的机场的字符。例如 ABC 与 XYZ 交织成 AXBYCZ,再按它排序。morton:将两个机场代码转为整数,再按 Morton(Z-order)编码排序。hilbert:将两个机场代码转为整数,再按 Hilbert 编码排序。
zipped_varchar使用 SQL 宏实现,无需扩展,也支持任意长度的字符串。
Morton 与 Hilbert 函数来自 Rusty Conover 贡献的 DuckDB 社区扩展
lindel,其底层使用同名 Rust crate。感谢相关贡献者。spatial扩展还提供作用相近的ST_Hilbert,也感谢 Max Gabrielsson 与 GDAL 社区。
图表展示从 S3 上的 DuckDB 文件读取时的查询耗时。同样的方法也适用于 DuckLake 集成式数据湖与目录格式。DuckLake 另有分区概念,可以跳过整个文件;为了充分利用它,应先按时间等字段分区,再在加载时采用本文排序技巧。有关 DuckLake 的介绍见原文所链接的发布文章。
原文实验使用 M1 MacBook Pro 和 DuckDB v1.2.2,通过 Python 客户端执行,并将结果返回为 Apache Arrow 表。每次查询之间都会关闭并重新创建连接,这段时间不计入结果,用于模拟单个用户访问仪表板的体验。
展开查看基本排序查询
下面是原文用于复现的加载与对照排序查询:从 Kaggle 下载的 Parquet 加载数据,再分别随机排序、按出发机场排序,以及先出发后目的机场排序。
CREATE TABLE IF NOT EXISTS flights AS
    FROM './Combined_Flights*.parquet';

-- The hash function is used instead of random
-- for consistency across re-runs
CREATE TABLE IF NOT EXISTS flights_random AS
    FROM flights
    ORDER BY hash(rowid + 42);

CREATE TABLE IF NOT EXISTS flights_origin AS
    FROM flights
    ORDER BY origin;

CREATE TABLE IF NOT EXISTS flights_origin_dest AS
    FROM flights
    ORDER BY origin, dest;
展开查看 Zipped 排序查询
下面的 SQL 宏不需要扩展,它用字母数字字符而非整数,粗略模拟空间填充曲线的思路,使数据在两列上都保留一定顺序。
CREATE OR REPLACE FUNCTION main.zip_varchar(i, j, num_chars := 6) AS (
    -- By default using 6 characters from each string so that
    -- if data is ASCII, we can fit it all in 12 bytes so that it is stored inline
    -- rather than requiring a pointer
    [
        list_value(z[1], z[2])
        FOR z
        IN list_zip(
            substr(i, 1, num_chars).rpad(num_chars, ' ').string_split(''),
            substr(j, 1, num_chars).rpad(num_chars, ' ').string_split('')
        )
    ].flatten().array_to_string('')
);

CREATE TABLE IF NOT EXISTS flights_zipped_varchar AS
    FROM flights
    ORDER BY
        main.zip_varchar(origin, dest, num_chars := 3);
zip_varchar 的输出示例:
SELECT
    'ABC' AS origin,
    'XYZ' AS dest,
    main.zip_varchar(origin, dest, num_chars := 3) AS zipped_varchar;
| origin | dest | zipped_varchar |
|---|---|---|
| ABC | XYZ | AXBYCZ |
展开查看 Morton 和 Hilbert 排序查询
空间填充曲线将多个维度(这里是出发地与目的地两维)压缩为一维,同时尽量保留高维空间中的局部邻近关系。Morton 和 Hilbert 接受整数或浮点数,而这里需要处理字符串。
字符串的每个字符可以表示大小写字母、符号等,比十进制每位只有 10 种取值携带更多信息。因此不能把很长的字符串完整编码进一个整数,只能取前几个字符;对于近似排序,这已经有用。
下面的 SQL 函数将至多 8 个 ASCII 字符转换为 UBIGINT:拆分字符,求 ASCII 值,转成位串,拼接后再转为无符号大整数。
CREATE OR REPLACE FUNCTION main.varchar_to_ubigint(i, num_chars := 8) AS (
    -- The maximum number of characters that will fit in a UBIGINT is 8
    -- and a UBIGINT is the largest type that the lindel community extension accepts for Hilbert or Morton encoding
    list_reduce(
        [
            ascii(my_letter)::UTINYINT::BIT::VARCHAR
            FOR my_letter
            IN (i[:num_chars]).rpad(num_chars, ' ').string_split('')
        ],
        (x, y) -> x || y
    )::BIT::UBIGINT
);
随后即可在 ORDER BY 中调用 lindel 的 morton_encode 或 hilbert_encode:
INSTALL lindel FROM community;
LOAD lindel;

CREATE TABLE IF NOT EXISTS flights_morton AS
    FROM flights
    ORDER BY
        morton_encode([
            varchar_to_ubigint(origin, num_chars := 3),
            varchar_to_ubigint(dest, num_chars := 3)
        ]::UBIGINT[2]);

CREATE TABLE IF NOT EXISTS flights_hilbert AS
    FROM flights
    ORDER BY
        hilbert_encode([
            varchar_to_ubigint(origin, num_chars := 3),
            varchar_to_ubigint(dest, num_chars := 3)
        ]::UBIGINT[2]);
也可以使用 spatial 扩展的 Hilbert 编码。它要求提供边界框,用于确定地理空间编码的精细程度;原文实验中,其表现与图中 Hilbert 方法相近。
SET VARIABLE bounding_box = (
    WITH flights_converted_to_ubigint AS (
        FROM flights
            SELECT
            *,
            varchar_to_ubigint(origin, num_chars := 3) AS origin_ubigint,
            varchar_to_ubigint(dest, num_chars := 3) AS dest_ubigint
        )
    FROM flights_converted_to_ubigint
    SELECT {
        min_x: min(origin_ubigint),
        min_y: min(dest_ubigint),
        max_x: max(origin_ubigint),
        max_y: max(dest_ubigint)
    }::BOX_2D
);
CREATE OR REPLACE TABLE flights_hilbert_spatial AS
    FROM flights
    ORDER BY
        ST_Hilbert(
            varchar_to_ubigint(origin, num_chars := 3),
            varchar_to_ubigint(dest, num_chars := 3),
            getvariable('bounding_box')
        );
展开查看用于测量性能的选择性读取查询
这一微基准覆盖:
- 按 6 种方式排序的表:3 种对照方式和 3 种进阶方式。
- 3 种查询模式:筛选出发地、目的地,或两者同时筛选。
- 4 组机场组合:SFO–LAX、LAX–SFO、ORD–LGA、LGA–ORD。
共有 72 个不同查询,每个重复 3 次,共执行 216 次;结果全部纳入图表。
FROM sorted_table
SELECT flightdate, airline, origin, dest, deptime, arrtime
WHERE origin = origin;

FROM sorted_table
SELECT flightdate, airline, origin, dest, deptime, arrtime
WHERE dest = dest;

FROM sorted_table
SELECT flightdate, airline, origin, dest, deptime, arrtime
WHERE origin = origin AND dest = dest;
实验结果
按出发地筛选时,单列 origin 排序约比随机分布快一个数量级,耗时从 16 秒降到 1.6 秒。进阶方法的速度也接近专门按 origin 排序。
按目的地筛选时,更均衡的方法显示出价值。仅将 destination 放在排序字段列表第二位的 origin_dest,没有获得大部分潜在收益。
同时筛选出发地和目的地时,所有方法都显著快于随机分布。排除随机组后,进阶方法与按 origin 或 origin-destination 排序相当,或略快。由于筛选更严格、需要读取的数据更少,整体也比其他查询模式快。
Hilbert 编码在三类查询中表现最稳定,是原文这三类工作负载的最佳折中。
近似时间排序
近似时间排序先将时间截断到指定粒度。本实验分别按 flightdate 的日、月、年起点排序,再按出发地和目的地的 Hilbert 编码排序。
性能测试沿用前面的三种机场筛选模式,并额外筛选最近 1、13 或 52 周。
展开查看近似时间排序查询
CREATE TABLE IF NOT EXISTS flights_hilbert_day AS
    FROM flights
    ORDER BY
        date_trunc('day', flightdate),
        hilbert_encode([
            varchar_to_ubigint(origin, num_chars := 3),
            varchar_to_ubigint(dest, num_chars := 3)
        ]::UBIGINT[2]);

CREATE TABLE IF NOT EXISTS flights_hilbert_month AS
    FROM flights
    ORDER BY
        date_trunc('month', flightdate),
        hilbert_encode([
            varchar_to_ubigint(origin, num_chars := 3),
            varchar_to_ubigint(dest, num_chars := 3)
        ]::UBIGINT[2]);

CREATE TABLE IF NOT EXISTS flights_hilbert_year AS
    FROM flights
    ORDER BY
        date_trunc('year', flightdate),
        hilbert_encode([
            varchar_to_ubigint(origin, num_chars := 3),
            varchar_to_ubigint(dest, num_chars := 3)
        ]::UBIGINT[2]);
展开查看用于测量性能的选择性读取查询
这一微基准覆盖:
- 时间按日、月、年三种粒度截断,再按 Hilbert 编码排序。
- 最近 1、13、52 周三种时间范围。
- 出发地、目的地及两者组合三种筛选方式。
- 4 组机场组合:SFO–LAX、LAX–SFO、ORD–LGA、LGA–ORD。
共有 108 个不同查询,每个重复 3 次,共执行 324 次。
FROM sorted_table
SELECT flightdate, airline, origin, dest, deptime, arrtime
WHERE
    origin = origin
    AND flightdate >= ('2022-07-31'::TIMESTAMP – INTERVAL time_range WEEKS);

FROM sorted_table
SELECT flightdate, airline, origin, dest, deptime, arrtime
WHERE
    dest = dest
    AND flightdate >= ('2022-07-31'::TIMESTAMP – INTERVAL time_range WEEKS);

FROM sorted_table
SELECT flightdate, airline, origin, dest, deptime, arrtime
WHERE
    origin = origin
    AND dest = dest
    AND flightdate >= ('2022-07-31'::TIMESTAMP – INTERVAL time_range WEEKS);
查询某个出发机场最近一周的数据时,按日排序最好;查询最近 13 或 52 周时,按月或年这样的粗时间粒度更好,因为较大的时间桶让 Hilbert 编码能更有效地将不同出发机场分散到不同的行组。
时间加目的机场的查询呈现类似模式:最佳排序方式高度依赖回溯时间范围。
同时筛选出发地与目的地时,结果不同:按年粒度排序在各个时间范围都更好。时间顺序足够粗时,两个机场条件更容易排除行组。
因此,对这三类工作负载,按年这样的粗时间粒度可能是最佳折中。不要只按精确时间戳排序。
建表耗时
这些收益的前期成本,是插入时排序的时间。通常值得交换:插入往往在后台进行,而用户不愿盯着仪表板加载动画。
不排序、直接从 Parquet 创建 DuckDB 表耗时略超过 21 秒。其余方法从未排序的 DuckDB 表复制数据并创建新表,各种排序方式耗时相近,约 48~61 秒,因此可按查询效果选择。不过,排序使整体插入耗时增加到接近原来的 3 倍。
| Table name | Creation time (s) |
|---|---|
from_parquet |
21.4 |
random |
60.2 |
origin |
51.9 |
origin_dest |
48.7 |
zipped_varchar |
58.2 |
morton |
54.6 |
hilbert |
58.5 |
hilbert_day |
58.7 |
hilbert_month |
53.8 |
hilbert_year |
60.2 |
衡量排序程度
选择排序方式的最好办法是模拟生产负载,但这未必方便。也可以衡量目标列的每个取值涉及多少行组:选择性查询要高效,每个筛选值应只出现在少量行组中,越少越好。不过,行组数量低于 DuckDB 使用的线程数后,收益可能递减。
其他数据库也有类似指标,称为“聚簇深度”(Clustering Depth)。
图中随机排序让几乎每个值分散在 100 个以上行组中;为方便阅读,图表在 100 处截断,说明随机排序不利于选择性查询。按 origin 排序大幅减少各出发机场涉及的行组,但目的机场仍很分散。先 origin 后 destination 保持了前者的紧凑分布,并略微改善后者。
三种进阶方法更均衡:出发机场和目的机场都只涉及适量行组。虽然它们的 origin 指标不如直接按 origin 排序,但大多数值涉及的行组仍少于现代笔记本的处理器核心数,因此保持了高性能。Hilbert 最均衡,这个指标同样将它评为最佳。
为计算该指标,先用动态 SQL 与 query 表函数定义几个 SQL 宏:
展开查看计算“每个值所涉及行组数”的宏
-- These are helper functions for writing dynamic SQL
-- sq = single quotes
-- dq = double quotes
-- nq = no quotes
CREATE OR REPLACE FUNCTION sq(my_varchar) AS (
    '''' || replace(my_varchar,'''', '''''') || ''''
);
CREATE OR REPLACE FUNCTION dq(my_varchar) AS (
    '"' || replace(my_varchar,'"', '""') || '"'
);
CREATE OR REPLACE FUNCTION nq(my_varchar) AS (
    replace(my_varchar, ';', 'No semicolons are permitted here')
);


CREATE OR REPLACE FUNCTION dq_list(my_list) AS (
    list_transform(my_list, (i) -> dq(i))
);
CREATE OR REPLACE FUNCTION nq_list(my_list) AS (
    list_transform(my_list, (i) -> nq(i))
);

CREATE OR REPLACE FUNCTION dq_concat(my_list, separator) AS (
    list_reduce(dq_list(my_list), (x, y) -> x || separator || y)
);
CREATE OR REPLACE FUNCTION nq_concat(my_list, separator) AS (
    list_reduce(nq_list(my_list), (x, y) -> x || separator || y)
);

-- This function produces the "Number of row groups per Value" boxplot
CREATE OR REPLACE FUNCTION rowgroup_counts(table_name, column_list) AS TABLE (
    FROM query('
    WITH by_rowgroup_id AS (
        FROM ' || dq(table_name) || '
        SELECT
        ceiling((count(*) OVER ()) / 122_880) AS total_row_groups,
        floor(rowid / 122_880) AS rowgroup_id,
        ' || dq_concat(column_list, ',') || '
    ), rowgroup_id_counts AS (
    FROM by_rowgroup_id
    SELECT
        case ' ||
        nq_concat(list_transform(column_list, (i) -> ' when grouping(' || dq(i) || ') = 0 then alias(' || dq(i) || ') '),' ')
            || ' end AS column_name,
        coalesce(*columns(* exclude (rowgroup_id, total_row_groups))) AS column_value,
        first(total_row_groups) AS total_row_groups,
        count(distinct rowgroup_id) AS rowgroup_id_count
    GROUP BY
        GROUPING SETS ( ' || nq_concat(list_transform(dq_list(column_list), (j) -> '(' || j || ')'), ', ') ||' )
    )
    FROM rowgroup_id_counts
    SELECT
        ' || sq(table_name) || ' AS table_name,
        *
    ORDER BY
        column_name
    ')
);

-- This is an optional function that can summarize the data
-- as an alternative to boxplot charts
CREATE OR REPLACE FUNCTION summarize_rowgroup_counts(table_name, column_list) AS TABLE (
    FROM rowgroup_counts(table_name, column_list)
    SELECT
        table_name,
        column_name,
        total_row_groups,
        min(rowgroup_id_count) AS min_cluster_depth,
        avg(rowgroup_id_count) AS avg_cluster_depth,
        max(rowgroup_id_count) AS max_cluster_depth,
        map([0.1, 0.25, 0.5, 0.75, 0.9], quantile_cont(rowgroup_id_count, [0.1, 0.25, 0.5, 0.75, 0.9]))::JSON AS quantiles,
        histogram(rowgroup_id_count, [1, 2, 3, 4, 5, 6, 7, 8, 9, 10, 11, 12, 13, 14, 15, 16, 32, 64, 128, 256])::JSON AS histograms,
    GROUP BY ALL
    ORDER BY ALL
);
然后就能对任意表、任意列调用 rowgroup_counts:
FROM rowgroup_counts('flights_hilbert', ['origin', 'dest']);
| table_name | column_name | column_value | total_row_groups | rowgroup_id_count |
|---|---|---|---|---|
| flights_hilbert | dest | PSG | 238 | 2 |
| flights_hilbert | dest | ESC | 238 | 2 |
| flights_hilbert | origin | YUM | 238 | 2 |
| … | … | … | … | … |
rowgroup_id_count 表示某个列值出现在多少个不同的行组中,可反映 DuckDB 取出该值的全部数据所需的工作量。
此计算依赖伪列
rowid。只有数据在单个批次中插入时才完全准确;分批插入时,它只是近似指标。
结语
在 DuckDB 数据库或 Parquet 等列式格式中,多列近似排序可以加速多种查询模式。原文实验中,Hilbert 在多个工作负载上表现良好;若还筛选时间,先按年、再按 Hilbert 排序也有良好效果。
“每个取值涉及的行组数”能衡量任意表在任意列上的排序程度,并与实验性能相吻合,因此可以用它快速预估不同排序方法的效果,不必每次都完整运行读取基准。
这些技巧能改善难以预测的用户交互,也可以结合本系列上一篇介绍的其他方法。不同数据各有特点,可以据此设计合适的策略。
祝分析顺利!











暂无评论内容