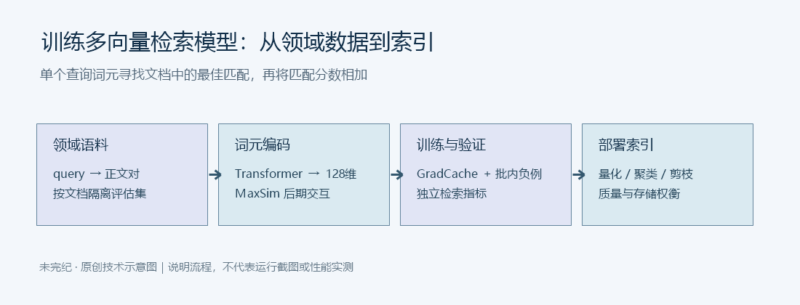



原作:Tom Aarsen,Hugging Face Blog,2026 年 8 月 26 日。本文译编完整技术正文,保留训练代码、评估表格及资源入口;编者补充单独标记。本文针对原文的 Sentence Transformers 6.0 系列接口,未在本次工作中执行训练或复现实验。
Sentence Transformers 是用于嵌入模型和重排序模型的 Python 库,覆盖检索增强生成、语义搜索及语义文本相似度等任务。6.0 更新加入第四种模型类型 MultiVectorEncoder,支持 ColBERT 风格的后期交互检索,也提供完整训练流程。本文围绕模型、数据、损失函数、训练参数、评估器和 Trainer,介绍如何在自己的领域上微调多向量模型,以及如何从基础 Transformer 构造新模型。
原文安装命令是 pip install -U "sentence-transformers[train]"。编者注:这会升级环境中的依赖,不能作为精确复现的版本锁。应在独立虚拟环境中安装,记录实际解析版本,并固定模型与数据集 revision;本文没有替作者补造锁文件。
作者用一块 RTX 3090 训练 14.5 小时获得 mLateOn-medical,在其医学检索评测中优于所比较的通用检索配置。这个结论只适用于文中的数据和实验设置。本文讲训练;模型加载、编码和数据库索引的用法另见原站的 多向量模型配套文章。
为什么保留多个向量,为什么还要微调
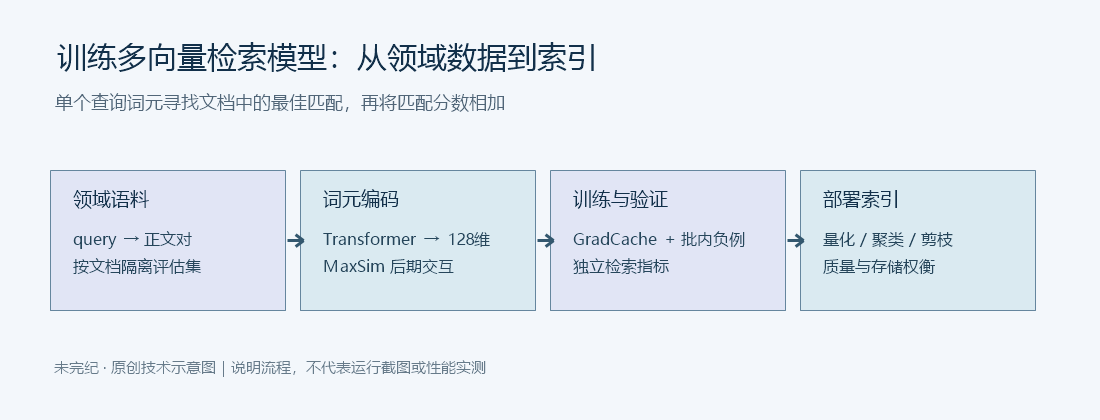
稠密嵌入模型把整段文字压缩成一个向量,两段文本的相似度就是两个摘要向量的点积。多向量模型保留每个词元的小向量,使用 MaxSim:每个查询词元在文档中找到最佳匹配词元,然后把分数相加。这能保留被单向量平均掉的细粒度信号,代价是索引更大。
领域之间的术语、查询方式和相关性定义并不相同。网页搜索、法律发现、代码搜索和科学文献检索需要不同的匹配方式;词元级匹配尤其容易从领域内样本中获益。与此同时,许多公开模型是在短段落上训练的:传统 ColBERT 可能把文档截断到 180 或 300 个词元,常见稠密模型则为 256 或 512。长文档尚未进入打分环节,大部分内容就可能已被截掉。
作者的医学段落平均 941 个词元,最长约 1,400 个词元。其测量显示,截断可造成最高 0.24 的 NDCG@10 损失,超过所比较模型架构之间的许多差距。自己训练的另一个好处,就是让文档长度符合实际数据。LightOn 也因代码任务的需求,在 LateOn 之外训练了 LateOn-Code;这说明领域适配与通用模型能力是两回事。
一、选择模型起点
继续微调已有多向量检查点
载入现有检查点时,其查询/文档标记词元、投影头和打分跳过列表也随之载入。通常保留这些既有约定,只修改数据确实需要的部分。训练时,显存允许的话优先用 float32 载入权重:
from sentence_transformers import MultiVectorEncoder

# Loading in fp32 is preferred for training if your memory can handle it
model = MultiVectorEncoder(
    "lightonai/mLateOn-unsupervised",
    model_kwargs={"torch_dtype": "float32"},
    processor_kwargs={"model_max_length": 8192},  # the tokenizer-level token limit
)
mLateOn 家族已支持骨干的 8192 词元上下文;若别的检查点仍自带任务级上限,例如 GTE-ModernColBERT-v1 的 query_length=48、document_length=300,则可取消:
# Let the model read full documents instead of the caps it was trained with,
# e.g. GTE-ModernColBERT-v1 ships with query_length=48 and document_length=300
model[0].query_length = None
model[0].document_length = None
取消之后仍受分词器 model_max_length 约束,绝不是无限上下文。作者还比较了不过滤、只过滤标点、只过滤停用词以及两者都过滤四种设置;只过滤标点在本数据中略有质量优势,并将文档索引缩小 9.6%。修改跳过词列表后要重新解析词元 ID:
import string

# model[2] is the MultiVectorMask module
model[2].skiplist_words = list(string.punctuation)
model[2].resolve_with_tokenizer(model.tokenizer)  # token ids are cached, so re-resolve after changing
从基础 Transformer 构建
也可以直接传入骨干名称。框架会补上随机初始化的词元投影层:
from sentence_transformers import MultiVectorEncoder

model = MultiVectorEncoder("answerdotai/ModernBERT-base", model_kwargs={"torch_dtype": "float32"})
# MultiVectorEncoder(
#   (0): Transformer({..., 'architecture': 'ModernBertModel'})
#   (1): Dense({'in_features': 768, 'out_features': 128, 'bias': False, ...})
#   (2): MultiVectorMask({'skiplist_words': [], 'skiplist_tasks': ['document'], ...})
#   (3): Normalize({...})
# )
流程依次是上下文化词元表示的 Transformer、把每个词元投影到 128 维的 Dense、决定参与打分词元的 MultiVectorMask,以及逐词元 Normalize。随机投影未经训练并没有实用的检索能力。强稠密检索骨干也能作为起点:作者在 gte-modernbert-base 上加新投影,仅用 25,000 对样本训练后,离最佳已有检查点起点约差 0.03。
传统 ColBERT 的 [MASK] 查询扩展、[Q]/[D] 前缀、文档长度上限和标点列表,在新建模型时默认关闭、可自行配置。作者试过四种 [MASK] 扩展配置,没有观察到可测量的收益,因此不要把传统配方当成必须项。
六种起点的对照
以下是作者使用同一配方、25,000 对医学问答样本、1,000 个保留查询和 50,000 篇候选段落得到的结果,数值未经本次独立复测:
| Starting point | Zero-shot NDCG@10 | After 25k pairs | Delta |
|---|---|---|---|
| lightonai/mLateOn-unsupervised | 0.9087 | 0.9398 | +0.0311 |
| lightonai/mLateOn | 0.9277 | 0.9319 | +0.0042 |
| lightonai/LateOn-unsupervised | 0.9026 | 0.9206 | +0.0180 |
| lightonai/LateOn | 0.9185 | 0.9105 | -0.0080 |
| lightonai/GTE-ModernColBERT-v1 | 0.9198 | 0.9007 | -0.0191 |
| Fresh head on gte-modernbert-base | – | 0.9177 | – |
-unsupervised 检查点处于大规模对比预训练之后、通用检索监督微调之前。在作者的两个模型家族实验中,这类起点虽然初始分数较低,但领域适配更强;已完成通用监督微调的模型则提升很小,甚至在所试学习率下退步。原文据此建议优先使用监督微调前的检查点;其次是在强检索骨干上训练新投影。这个排序是领域实验结论,并非对所有任务的定理。
二、准备数据,核对列的含义
Trainer 接受 datasets.Dataset 或 DatasetDict。数据可来自 Hub,也可来自本地 CSV、JSON、Parquet、Arrow 或 SQL。Hub 上带 sentence-transformers 标记的数据集可作为检索训练的候选,但仍要检查质量与许可。作者使用 MIRIAD 医学问题及包含答案的来源段落:
from datasets import load_dataset

train_dataset = load_dataset("tomaarsen/miriad-4.4M-split", split="train")

print(train_dataset)
"""
Dataset({
    features: ['question', 'passage_text'],
    num_rows: 4467542
})
"""
这个拆分的 train 集展示 4,467,542 行、question 与 passage_text 两列。简单的“查询—相关段落”对已足够组成本文的训练任务,不需要人为编造标签或先挖掘负例。本地文件和自定义预处理可这样加载:
from datasets import load_dataset

dataset = load_dataset("csv", data_files="my_file.csv")
# or
dataset = load_dataset("json", data_files="my_file.json")
from datasets import Dataset

queries = []
documents = []
# Open a file, perform preprocessing, filtering, cleaning, etc.
# and append to the lists

dataset = Dataset.from_dict({
    "query": queries,
    "document": documents,
})
数据格式必须与损失函数匹配。若损失函数要求标签,列名需为 label 或 score;其余列按顺序作为输入,列数量必须符合损失函数要求。多向量训练还有两条约定:第一列默认编码为查询,后续列编码为文档,不依赖列名;可用 router_mapping 按列覆盖。知识蒸馏使用 (query, document_1, ..., document_N, scores),其中 scores 是每行 N 个教师分数。若文本与 ID 分表存储,可用 resolve_ids 在读取时解析。
编者注:示例 Dataset.from_dict 中的空列表只是演示构造方式,真正训练前必须填入数据。语料里可能包含个人信息,公开来源也不免除用途与数据许可证检查;医学检索指标不代表临床适用性。
三、损失函数与有效批大小
损失函数度量一个 batch 上的表现,并为优化器提供更新方向。对“问题—正例段落”数据,MultiVectorMultipleNegativesRankingLoss 会把同一 batch 中其他文档当作当前查询的负例。更大 batch 通常提供更多负例;其 GradCache 变体把有效 batch 大小与单次编码占用显存解耦:
from sentence_transformers import MultiVectorEncoder
from sentence_transformers.multi_vector_encoder.losses import CachedMultiVectorMultipleNegativesRankingLoss

model = MultiVectorEncoder("lightonai/mLateOn-unsupervised", model_kwargs={"torch_dtype": "float32"})

loss = CachedMultiVectorMultipleNegativesRankingLoss(
    model=model,
    mini_batch_size=16,  # how many documents to encode per chunk: bounds memory, not quality
)
mini_batch_size=16 规定每次编码的块大小,主要限制显存。原文有效对比 batch 为 128,继续扩大在其消融中没有额外收益。GradCache 的目标是在不改变等价梯度计算的情况下分块,用更多时间换显存;不同硬件和随机性下不应据此承诺逐位相同的数值。
当文档长度差异较大时,还可以使用 mini_batch_num_tokens,按每个编码块的总词元预算分组,而不是按文档篇数分块。这样更便于约束长文档带来的显存波动;作者把每篇约 940 个词元、mini_batch_size=16 的设置,对应为约 mini_batch_num_tokens=15_000。这只是原文给出的预算对照,实际显存需求仍需结合模型、硬件与实现验证。
多向量损失的默认 scale=1.0。稠密检索中常用 scale=20 把约 [-1,1] 的余弦分数放大;MaxSim 已按查询词元求和,32 个查询词元的量级可到约 32。直接照搬稠密模型的缩放可能使 softmax 饱和,破坏梯度。教师蒸馏路线另见 MultiVectorDistillKLDivLoss 与官方训练总览中的 Knowledge Distillation。
四、训练参数
以下参数来自作者实际训练配方:
from sentence_transformers import MultiVectorEncoderTrainingArguments
from sentence_transformers.base.sampler import BatchSamplers

args = MultiVectorEncoderTrainingArguments(
    # Required parameter:
    output_dir="models/mLateOn-medical",
    # Optional training parameters:
    num_train_epochs=1,
    per_device_train_batch_size=128,  # the effective contrastive batch, thanks to GradCache
    per_device_eval_batch_size=16,
    learning_rate=1e-4,
    warmup_steps=0.05,
    prompts={"question": "[Q] ", "passage_text": "[D] "},  # the checkpoint's markers, keyed by training column
    fp16=False,  # Set to True if you have a GPU that supports FP16
    bf16=True,  # Set to True if you have a GPU that supports BF16
    batch_sampler=BatchSamplers.NO_DUPLICATES,  # in-batch negatives benefit from no duplicates
    # Optional tracking/debugging parameters:
    eval_strategy="steps",
    eval_steps=0.1,
    save_strategy="steps",
    save_steps=0.05,
    logging_steps=0.01,
    run_name="mLateOn-medical",  # Will be used in e.g. Trackio, W&B, etc.
)
prompts 必须显式映射到训练列,因为训练不会自动套用模型储存的提示。这里 question 用 [Q] ,passage_text 用 [D] ,保持训练与推理一致。未设置的 max_length 是训练时额外截断:作者在 512 词元训练约快两倍,但损失约 0.015 NDCG@10,增加样本未消除差距。若质量优先,训练应看见推理时会出现的完整文档。
学习率 1e-4 来自作者在 5e-6 到 2e-4 的扫描。bf16 要有相应硬件支持;NO_DUPLICATES 用来减少批内重复造成的负例冲突。warmup_steps、eval_steps、save_steps 等参数中的小数,依赖所配套 Trainer 版本的比例语义;要核对实际安装版本,不能把这些数字直接当成绝对步数。
五、评估器:构造足够难的检索测试
只传 eval_dataset 能观察评估损失,但检索指标更有解释力。官方多向量评估器包括:
| Evaluator | Required Data |
|---|---|
MultiVectorInformationRetrievalEvaluator |
Queries, corpus, and relevant document mappings |
MultiVectorNanoBEIREvaluator |
No data required |
MultiVectorTripletEvaluator |
(anchor, positive, negative) triplets |
MultiVectorRerankingEvaluator |
List of {'query': '...', 'positive': [...], 'negative': [...]} dictionaries |
MultiVectorDistillationEvaluator |
Queries with candidate documents and teacher scores |
领域微调最重要的是用保留数据构造 MultiVectorInformationRetrievalEvaluator。MIRIAD 的问题由对应段落生成,如果只在约一万篇答案段落中检索,几乎所有模型都能超过 0.97 NDCG@10,难以拉开差异。作者在 1,000 个评估查询之外,将训练拆分中的去重段落作为干扰项,扩展到 200,000 篇候选:
from datasets import load_dataset
from sentence_transformers.multi_vector_encoder.evaluation import MultiVectorInformationRetrievalEvaluator

dataset = load_dataset("tomaarsen/miriad-4.4M-split")

# Gold: 1,000 evaluation questions, each mapping to its own passage, with the
# eval split's full ~10k unique passages as the initial corpus
corpus = {}
queries = {}
relevant_docs = {}
passage_to_id = {}
for idx, row in enumerate(dataset["eval"]):
    if row["passage_text"] not in passage_to_id:
        passage_to_id[row["passage_text"]] = f"p{len(passage_to_id)}"
        corpus[passage_to_id[row["passage_text"]]] = row["passage_text"]
    if idx < 1_000:
        queries[f"q{idx}"] = row["question"]
        relevant_docs[f"q{idx}"] = {passage_to_id[row["passage_text"]]}

# Distractors: unique train passages that make the haystack realistic
seen = set(passage_to_id)
for row in dataset["train"]:
    if len(corpus) >= 200_000:
        break
    if row["passage_text"] not in seen:
        seen.add(row["passage_text"])
        corpus[f"d{len(corpus)}"] = row["passage_text"]

evaluator = MultiVectorInformationRetrievalEvaluator(
    queries=queries,
    corpus=corpus,
    relevant_docs=relevant_docs,
    name="miriad-dev",
    batch_size=16,
)
# results = evaluator(model)
编者注:这里的干扰项来自 train,但查询来自 eval;该安排不等于可以将评估查询泄漏进训练。近重复、同文档切片、生成问题的数据谱系仍须自行检查。代码按文本完全相等去重,不能识别语义近重复。
六、将组件组合成完整训练脚本
以下完整脚本保留原文,包含载入模型、解除任务级截断、过滤标点、选取 100 万对样本、GradCache 损失、轻量开发评估器、训练及保存。开发评估器只用 500 个保留查询和约一万篇段落;前面的 20 万语料完整协议在训练后另跑。
执行前注意:原文第 10 步虽标为 Optional,model.push_to_hub(run_name) 实际放在会自动执行的 try 块中。若已有登录凭据,脚本可能上传模型。本文为保留原文不偷偷删改该调用;只做本地训练时应移除整个第 10 步,明确需要上传、审核数据与仓库可见性之后再单独调用。异常捕获只处理失败,不等于禁用上传。
import logging
import string
import traceback

from datasets import load_dataset

from sentence_transformers import (
    MultiVectorEncoder,
    MultiVectorEncoderModelCardData,
    MultiVectorEncoderTrainer,
    MultiVectorEncoderTrainingArguments,
)
from sentence_transformers.base.sampler import BatchSamplers
from sentence_transformers.multi_vector_encoder.evaluation import MultiVectorInformationRetrievalEvaluator
from sentence_transformers.multi_vector_encoder.losses import CachedMultiVectorMultipleNegativesRankingLoss

logging.basicConfig(format="%(asctime)s - %(message)s", datefmt="%Y-%m-%d %H:%M:%S", level=logging.INFO)


def main():
    # 1. Load the starting checkpoint: contrastively pretrained, not yet supervised
    # Loading in fp32 is preferred for training if your memory can handle it
    model = MultiVectorEncoder(
        "lightonai/mLateOn-unsupervised",
        model_kwargs={"torch_dtype": "float32"},
        processor_kwargs={"model_max_length": 8192},
        model_card_data=MultiVectorEncoderModelCardData(
            language="en",
            license="apache-2.0",
            model_name="mLateOn finetuned on MIRIAD medical retrieval",
        ),
    )

    # 2. Lift the per-task length caps so training and inference see full medical passages
    model[0].query_length = None
    model[0].document_length = None

    # 3. Skip punctuation tokens during scoring: a small quality win and a 9.6% smaller index
    model[2].skiplist_words = list(string.punctuation)
    model[2].resolve_with_tokenizer(model.tokenizer)

    # 4. Load 1 million medical question-passage pairs
    train_dataset = load_dataset("tomaarsen/miriad-4.4M-split", split="train").select(range(1_000_000))

    # 5. In-batch negatives with GradCache: large effective batch, memory-bounded chunks
    loss = CachedMultiVectorMultipleNegativesRankingLoss(model=model, mini_batch_size=16)

    # 6. A light dev evaluator to watch progress during training: 500 held-out questions
    # against the eval split's ~10k unique passages. The full 200k protocol runs afterwards.
    eval_split = load_dataset("tomaarsen/miriad-4.4M-split", split="eval")
    corpus, queries, relevant_docs, passage_to_id = {}, {}, {}, {}
    for idx, row in enumerate(eval_split):
        if row["passage_text"] not in passage_to_id:
            passage_to_id[row["passage_text"]] = f"p{len(passage_to_id)}"
            corpus[passage_to_id[row["passage_text"]]] = row["passage_text"]
        if idx < 500:
            queries[f"q{idx}"] = row["question"]
            relevant_docs[f"q{idx}"] = {passage_to_id[row["passage_text"]]}
    dev_evaluator = MultiVectorInformationRetrievalEvaluator(
        queries=queries, corpus=corpus, relevant_docs=relevant_docs, name="miriad-dev", batch_size=16
    )

    # 7. Training arguments, as discussed above
    run_name = "mLateOn-medical"
    args = MultiVectorEncoderTrainingArguments(
        output_dir=f"models/{run_name}",
        num_train_epochs=1,
        per_device_train_batch_size=128,
        per_device_eval_batch_size=16,
        learning_rate=1e-4,
        warmup_steps=0.05,
        prompts={"question": "[Q] ", "passage_text": "[D] "},
        fp16=False,  # Set to True if you have a GPU that supports FP16
        bf16=True,  # Set to True if you have a GPU that supports BF16
        batch_sampler=BatchSamplers.NO_DUPLICATES,
        eval_strategy="steps",
        eval_steps=0.1,
        save_strategy="steps",
        save_steps=0.05,
        logging_steps=0.01,
        run_name=run_name,
    )

    # 8. Create a trainer & train
    trainer = MultiVectorEncoderTrainer(
        model=model,
        args=args,
        train_dataset=train_dataset,
        loss=loss,
        evaluator=dev_evaluator,
    )
    trainer.train()

    # 9. Save the trained model
    model.save_pretrained(f"models/{run_name}/final")

    # 10. (Optional) Push it to the Hugging Face Hub
    try:
        model.push_to_hub(run_name)
    except Exception:
        logging.error(f"Error uploading model to the Hugging Face Hub:\n{traceback.format_exc()}")


if __name__ == "__main__":
    main()
这就是作者的完整配方:监督微调前检查点、100 万对领域数据、批内负例、完整文档长度以及相对较高学习率。作者报告 RTX 3090 耗时 14.5 小时、峰值显存 17.5 GB。10 万对样本训练约 75 分钟,距离百万样本结果约差 0.012 NDCG@10。这些都是原文报告,本文未运行,读者的硬件、版本和数据会改变结果。
回调与多数据集训练
Trainer 支持 Transformers TrainerCallback:安装 wandb 后可用 WandbCallback 记录指标,TensorBoardCallback 用于 TensorBoard,CodeCarbonCallback 记录碳排放估计。通过 report_to=["wandb", "codecarbon"] 等参数开启;原文指出默认是 "none","all" 会启动已安装依赖对应的全部集成。开启外部记录前先确认上报字段和组织的数据政策。
同时训练多个数据集时,train_dataset(以及可选 eval_dataset)可以是数据集字典或 DatasetDict;不同数据集不必有相同格式,还可按名称传入不同损失函数。每个 batch 只来自一个数据集。ROUND_ROBIN 轮流抽样,某个数据集用尽就停止,可能无法用完其他数据;默认 PROPORTIONAL 按大小比例抽取,会用完所有数据,大数据集出现更频繁。该选择通过 multi_dataset_batch_sampler 设置。
七、作者的最终评测,以及结论的边界
最终实验比较了四类架构、50 多种配置:1,000 个保留医学问题,在 200,000 个去重段落中检索,其中约 10,000 篇为答案候选、190,000 篇是干扰项。候选规模是前面起点实验的四倍,因此两张表的分数不能直接横向比较。主要结果如下:
| Model | Family | NDCG@10 |
|---|---|---|
| multi-vector-encoder/mLateOn-medical (mine) | Multi-vector, finetuned | 0.9139 |
| lightonai/mLateOn | Multi-vector, zero-shot | 0.8520 |
| lightonai/GTE-ModernColBERT-v1 (cap lifted) | Multi-vector, zero-shot | 0.8502 |
| Qwen/Qwen3-Embedding-4B | Dense, zero-shot | 0.7817 |
| voyageai/voyage-4-nano | Dense, zero-shot | 0.7563 |
| BM25 | Lexical | 0.7501 |
| naver/splade-v3 | Sparse, zero-shot | 0.6853 |
微调模型 NDCG@10 为 0.9139,比最强通用零样本配置约高 0.062;首位命中率从 75.8% 提高到 84.9%,首位错误减少超过三分之一。相同训练/骨干家族中,LateOn 相对 DenseOn 的提升约为 0.12,多语言配对约为 0.13。Qwen3-Embedding-4B 的活跃非嵌入参数约为本文模型的 33 倍,仍差约 0.13;原文的 8B 配置又低于 4B。
BM25 也强于全部稀疏模型、保留默认截断的多向量模型,以及除三种以外的稠密配置。但 MIRIAD 查询直接由答案段落生成,词面重叠很高,且 BM25 不受神经模型上下文截断限制。因此值得保留 BM25 基线,却不能把这一优势推广到别的数据。
展开完整评测表(原文实验,未独立复测)
表中 @N 表示把文档上限提高到 N 个词元。作者报告多向量模型因此获益约 +0.08 到 +0.24 NDCG@10,DenseOn 也增加约 0.03。mLateOn-medical 是作者这个领域实验中的最强配置,并不是所有领域的冠军。模型选择要回到自己的数据验证。
八、优化索引大小
多向量的主要代价是索引:本文模型每篇段落约 878 个向量,20 万段落的 fp16 原始向量约 45 GB,而许多单向量配置远低于 1 GB。配套文中的 Natural Questions 每段约 125 个向量,短段落索引从一开始就小得多。HierarchicalTokenPooling 通过聚类文档内词元向量并保存簇均值,大约保留原来 1/pool_factor 的向量:
from sentence_transformers.multi_vector_encoder.modules import HierarchicalTokenPooling

pooling = HierarchicalTokenPooling(pool_factor=4)
document_embeddings = model.encode_document(passages, token_pooling=pooling)
作者没有进行池化感知训练,而是在训练后测量压缩:向量减半损失 0.0033 NDCG@10,首位命中率不变;保留四分之一时约 11.2 GB、NDCG@10 为 0.8991;保留十分之一时仍为 0.8765。原图中实心点是未经压缩、采用精确搜索的原始表示,它反映相对存储成本,而不是购买磁盘的直接依据。真实系统还会用稠密 int8/二值量化、稀疏 posting 压缩,或多向量 PLAID 残差压缩。
Omar Khattab 使用 fast-plaid 测量了 1-bit 残差量化,并将通常未打包的 64 位整数改为紧凑的 17 位质心 ID 和 18 位文档 ID,再叠加文档端剪枝:
| configuration | vectors kept | index | NDCG@10 |
|---|---|---|---|
| 1-bit PLAID, all vectors | 100% | 3.37 GB | 0.8984 |
| 1-bit PLAID + pruning | 65% | 2.23 GB | 0.8830 |
| 1-bit PLAID + pruning | 42% | 1.45 GB | 0.8642 |
第一种配置比 45 GB 原始向量约小 13 倍,NDCG@10 下降 0.0155。量化减少每个向量的体积,池化和剪枝减少向量个数,二者可以组合;作者建议优先关注量化。最小的 1.45 GB 配置比 Qwen3-Embedding-8B 的 fp16 向量 1.64 GB 还小,分数高 0.0895。剪枝实现只是探索性的下限,不能把表中数据当成其他索引版本的容量承诺。索引配置需要和检查点一样认真地选择。
致谢与后续阅读
原作者感谢 Omar Khattab 测量量化、剪枝索引并讨论后期交互检索的成本。训练样例覆盖 MIRIAD 医学检索、MS MARCO 对比与知识蒸馏、多模态 ColPali 文档检索、PEFT/LoRA;进一步可查阅 Sentence Transformers 的安装、快速开始、使用、自定义模型、预训练模型、训练总览、损失总览、API 和分布式训练文档。原文链接集合随来源快照保留,官方入口为 sbert.net。
- MIRIAD 医学检索训练
- MS MARCO 对比与知识蒸馏
- 多模态文档检索
- PEFT / LoRA 适配器
- 安装
- 快速开始
- 使用说明
- 创建自定义模型
- 预训练模型
- 训练总览
- 损失函数总览
- API 参考
- 分布式训练
- Multi-Vector (Late Interaction) Embedding Models with Sentence Transformers
静态审核说明:本文没有发现展示代码中存在硬编码访问令牌或直接拼接不可信命令的行为。已经确认的风险包括未锁定依赖/远程资源、可自动上传 Hub、外部回调上报、100 万样本选取与长上下文的资源成本,以及数据/模型许可证需分别遵守。示例中的 license="apache-2.0" 是模型卡声明,不会自动把训练数据、基础权重或本文转为 Apache 许可。没有发现其他问题不等于不存在漏洞。
来源与归属:Tom Aarsen / Hugging Face Blog;中文译编:未完纪编辑部;索引量化实验贡献:Omar Khattab。阅读原文。全文翻译、转载及配图按权利人授权使用;原作者及项目归属保留。











暂无评论内容