


原作者:Rafael Pardinas、Ehsan Kamalloo(ServiceNow-AI)· 原载 Hugging Face Blog · 2026 年 5 月 6 日
PipelineRL 使用 vLLM 作为生成 rollout 的推理引擎。推理引擎采样 token,并返回每个 token 的对数概率(logprob);训练器据此计算策略比率、KL、裁剪率、熵和奖励等训练相关量。只要这些 logprob 的计算方式出现差异,就可能改变训练动态。这正是我们从 vLLM V0 迁移到 V1 时需要消除的训练与推理不一致。
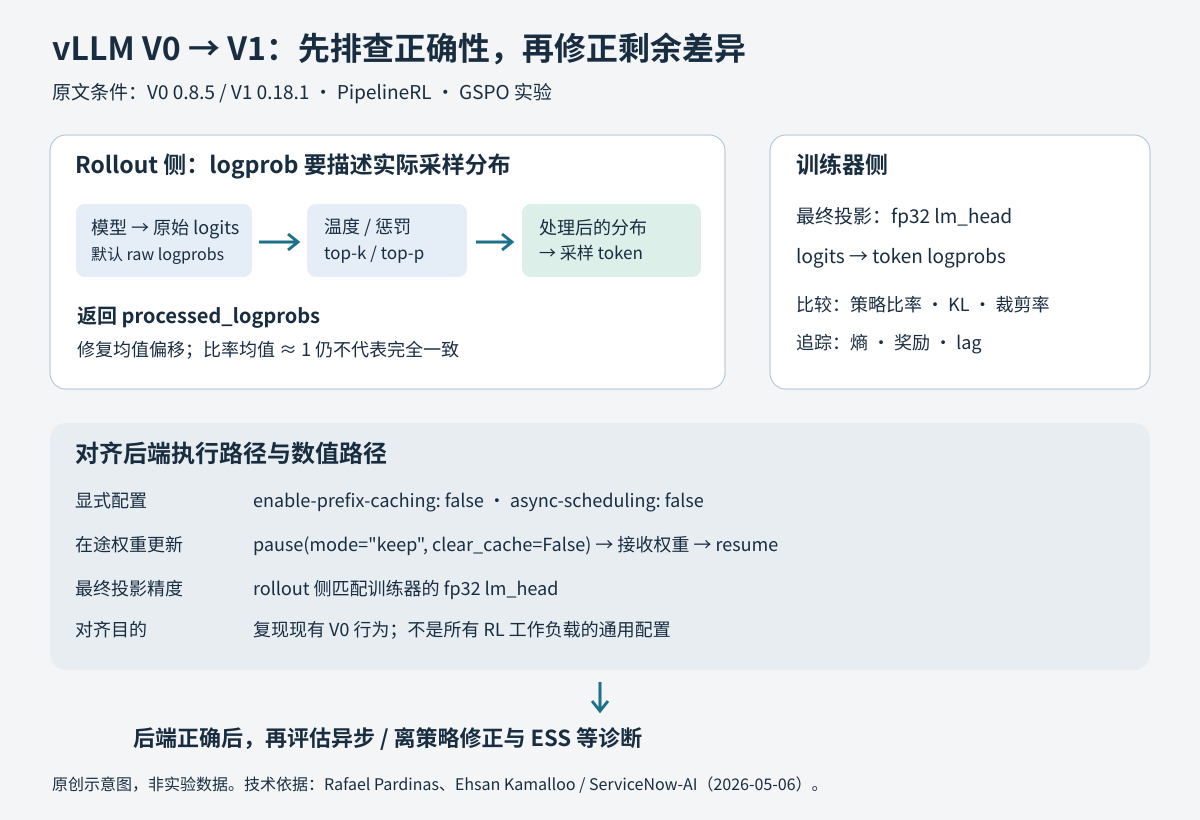
先给出结论:修复四项问题后,vLLM V1 才与我们的 V0 参考结果接近。这四项分别是返回经过采样处理的 rollout logprob、明确 V1 专有的运行时默认值、对齐在途权重更新路径,以及在最终投影中使用 fp32 的 lm_head。我们的顺序是先修复后端行为,再考虑改变强化学习目标函数。
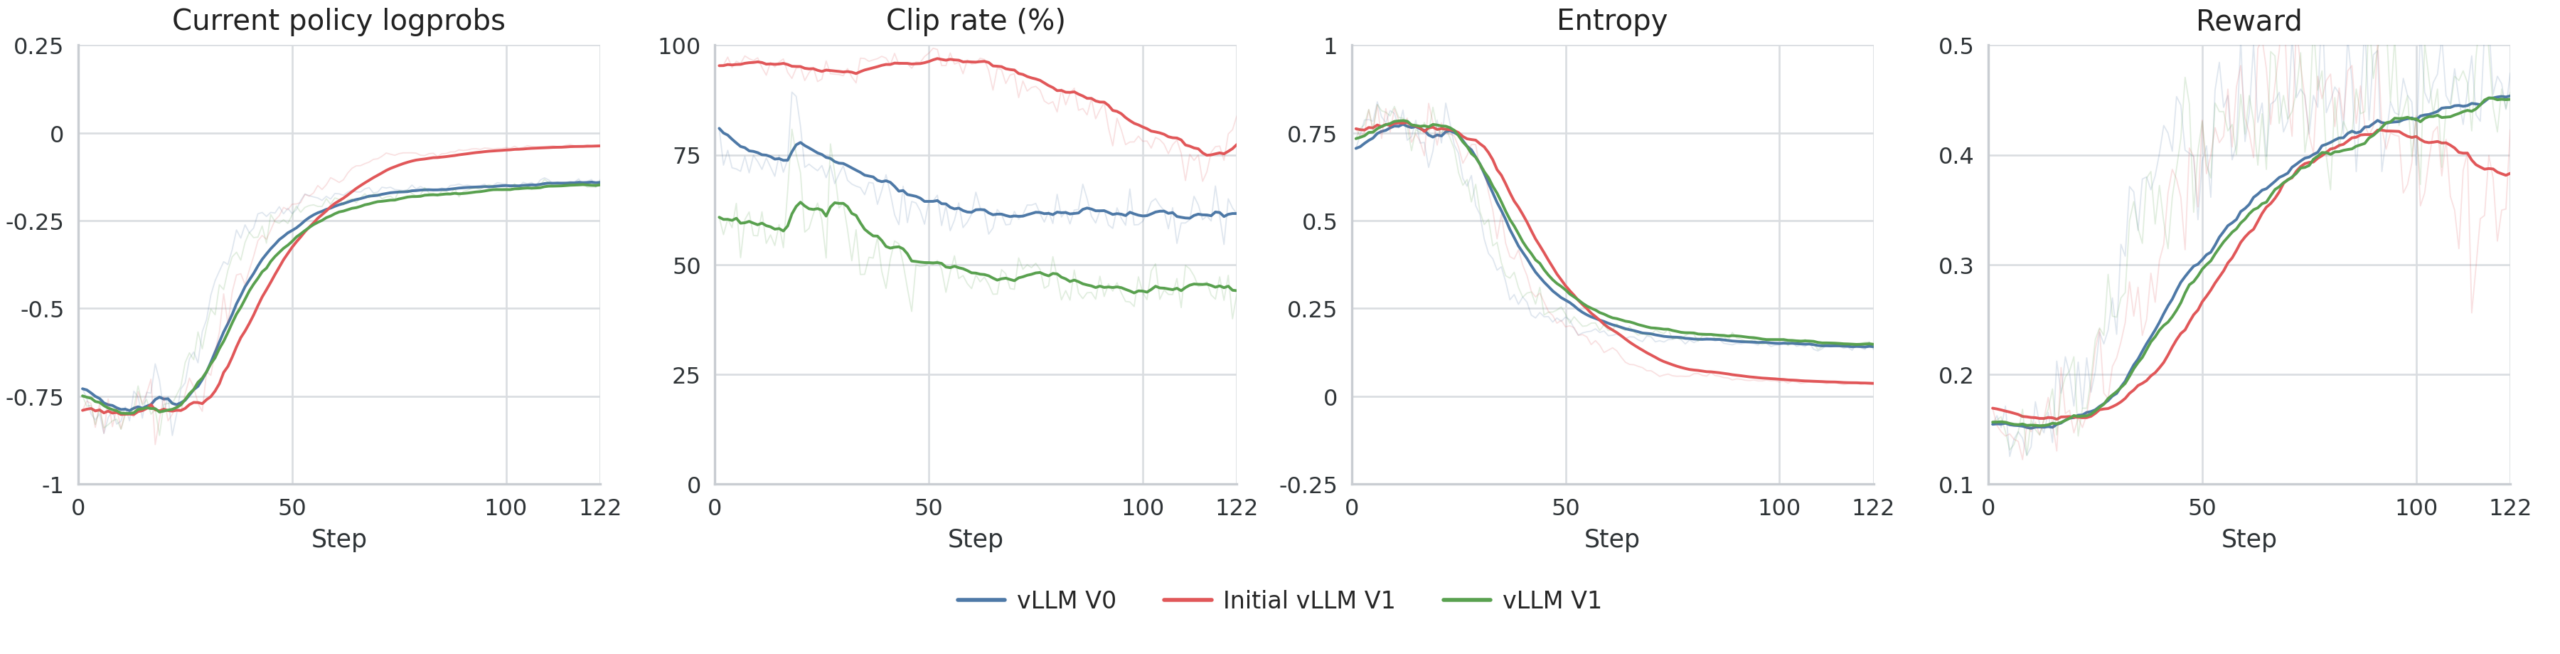
参考运行使用 vLLM 0.8.5,V1 运行使用 0.18.1。原文图 1 展示最终结果:蓝色是 V0 参考运行,红色是最初的 V1 尝试,绿色是完成下述修复、包括 fp32 lm_head 后的最终 V1 运行。
迁移目标:先恢复后端的一致性
V1 对 V0 引擎进行了大幅重写,因此我们刻意将迁移目标收窄为三件事:
- 确认 V1 返回的 rollout logprob 符合训练器所期望的语义。
- 使用同一个工作负载重新运行,并与 V0 参考结果比较。
- 只有在后端行为恢复一致之后,才评估目标函数层面的改动。
最先暴露异常的是以下指标:
clamp_log_ratio_new_old_indicatorkl_new_oldentropyreward
这些指标来自采用 GSPO 目标函数的训练运行。同一类问题也可能出现在 PPO、GRPO,或者任何把 rollout 侧 logprob 作为优化目标组成部分的在线强化学习系统中。
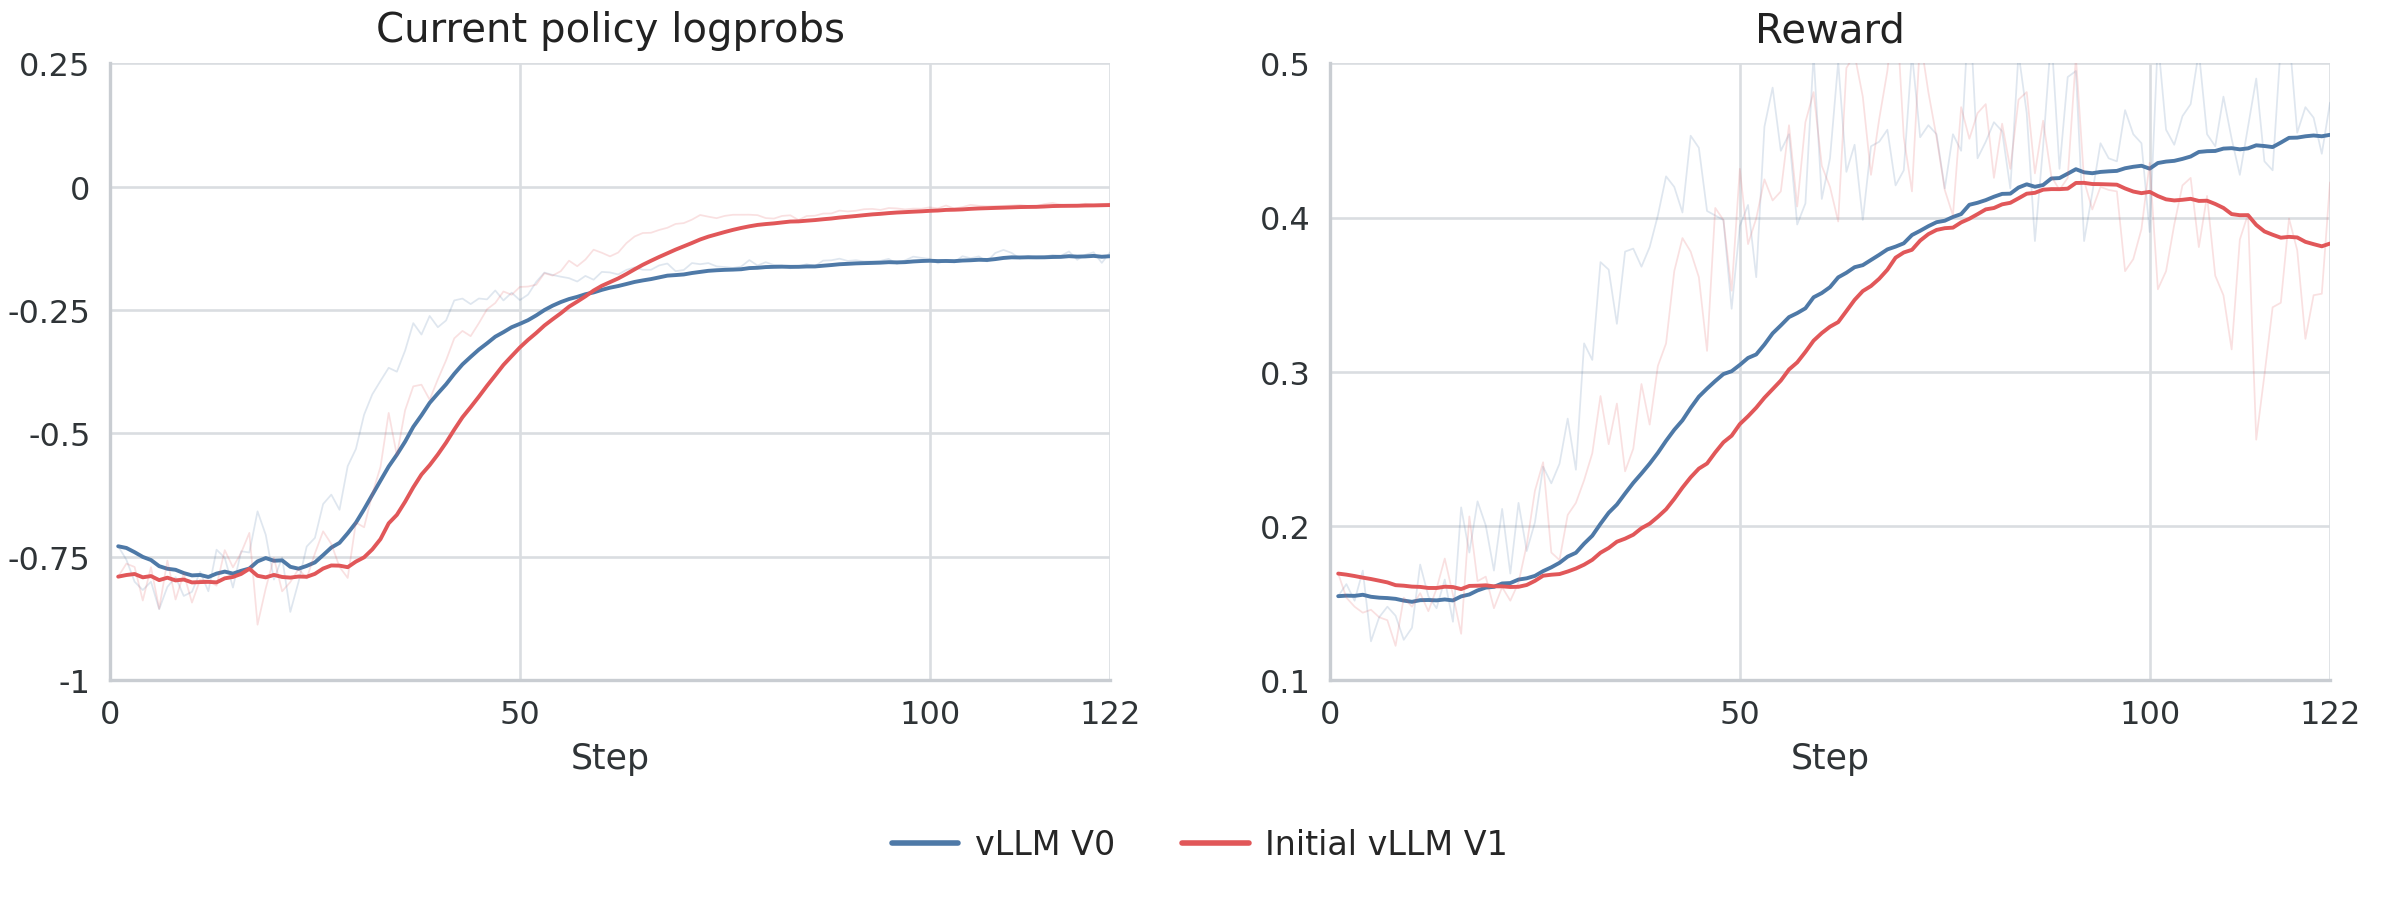
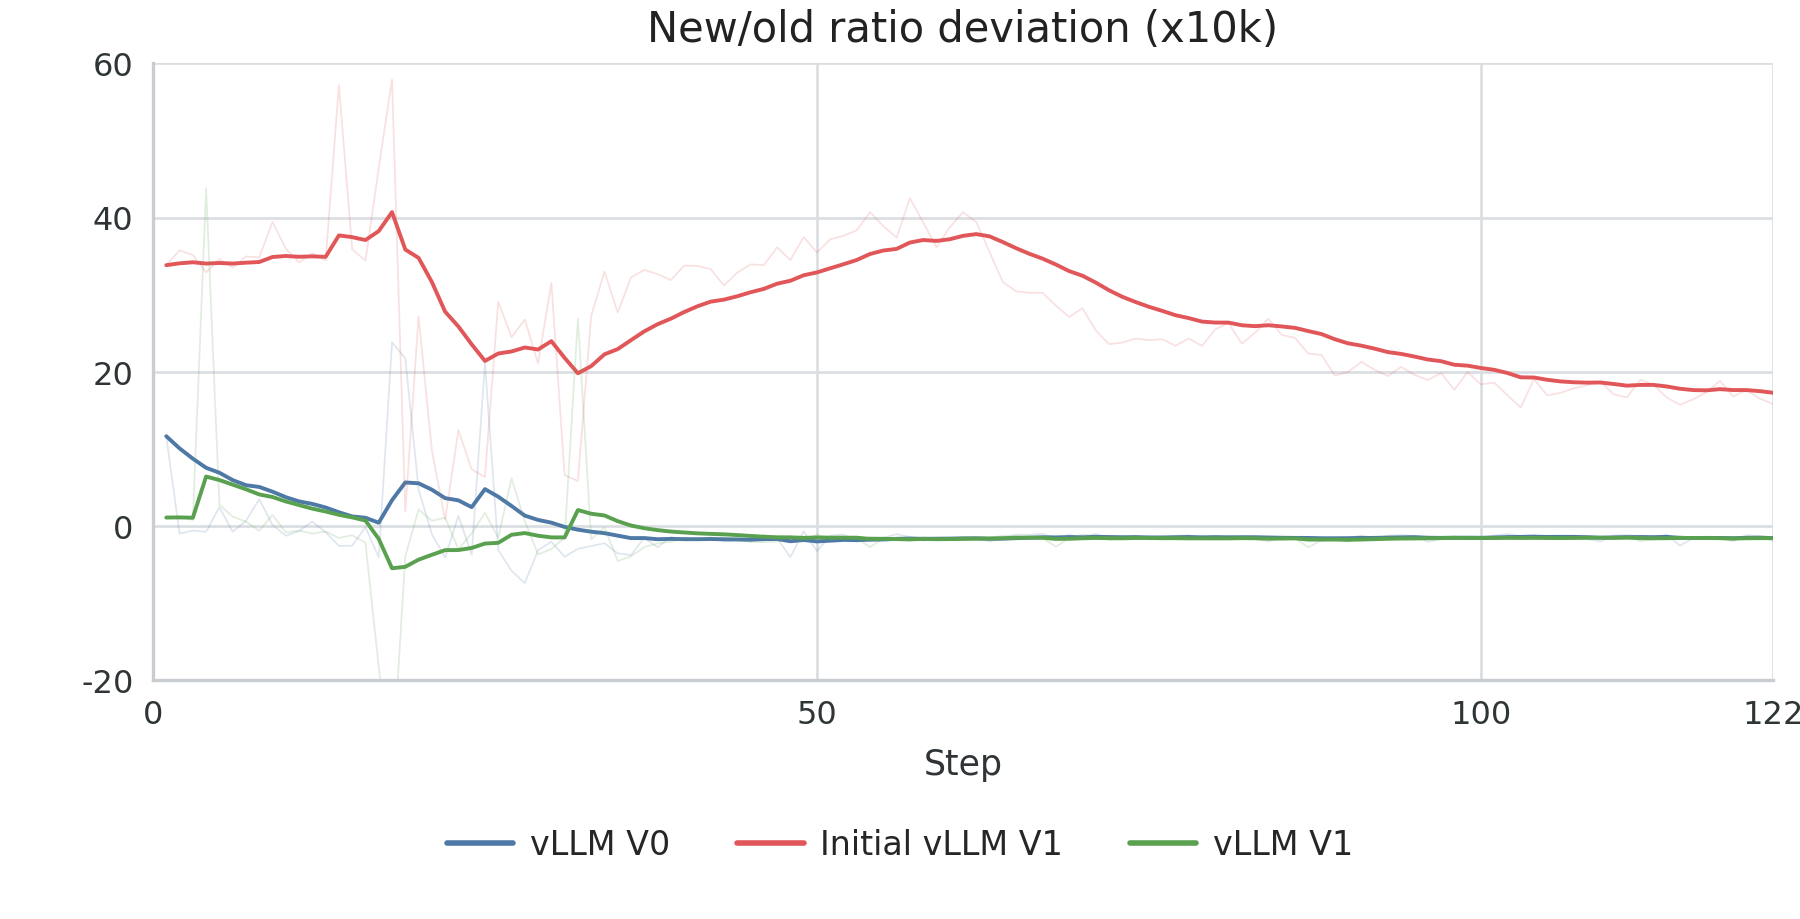
最初的 V1 运行很快就显出了问题:训练早期,训练器侧的 logprob 和奖励便开始偏离 V0 参考。
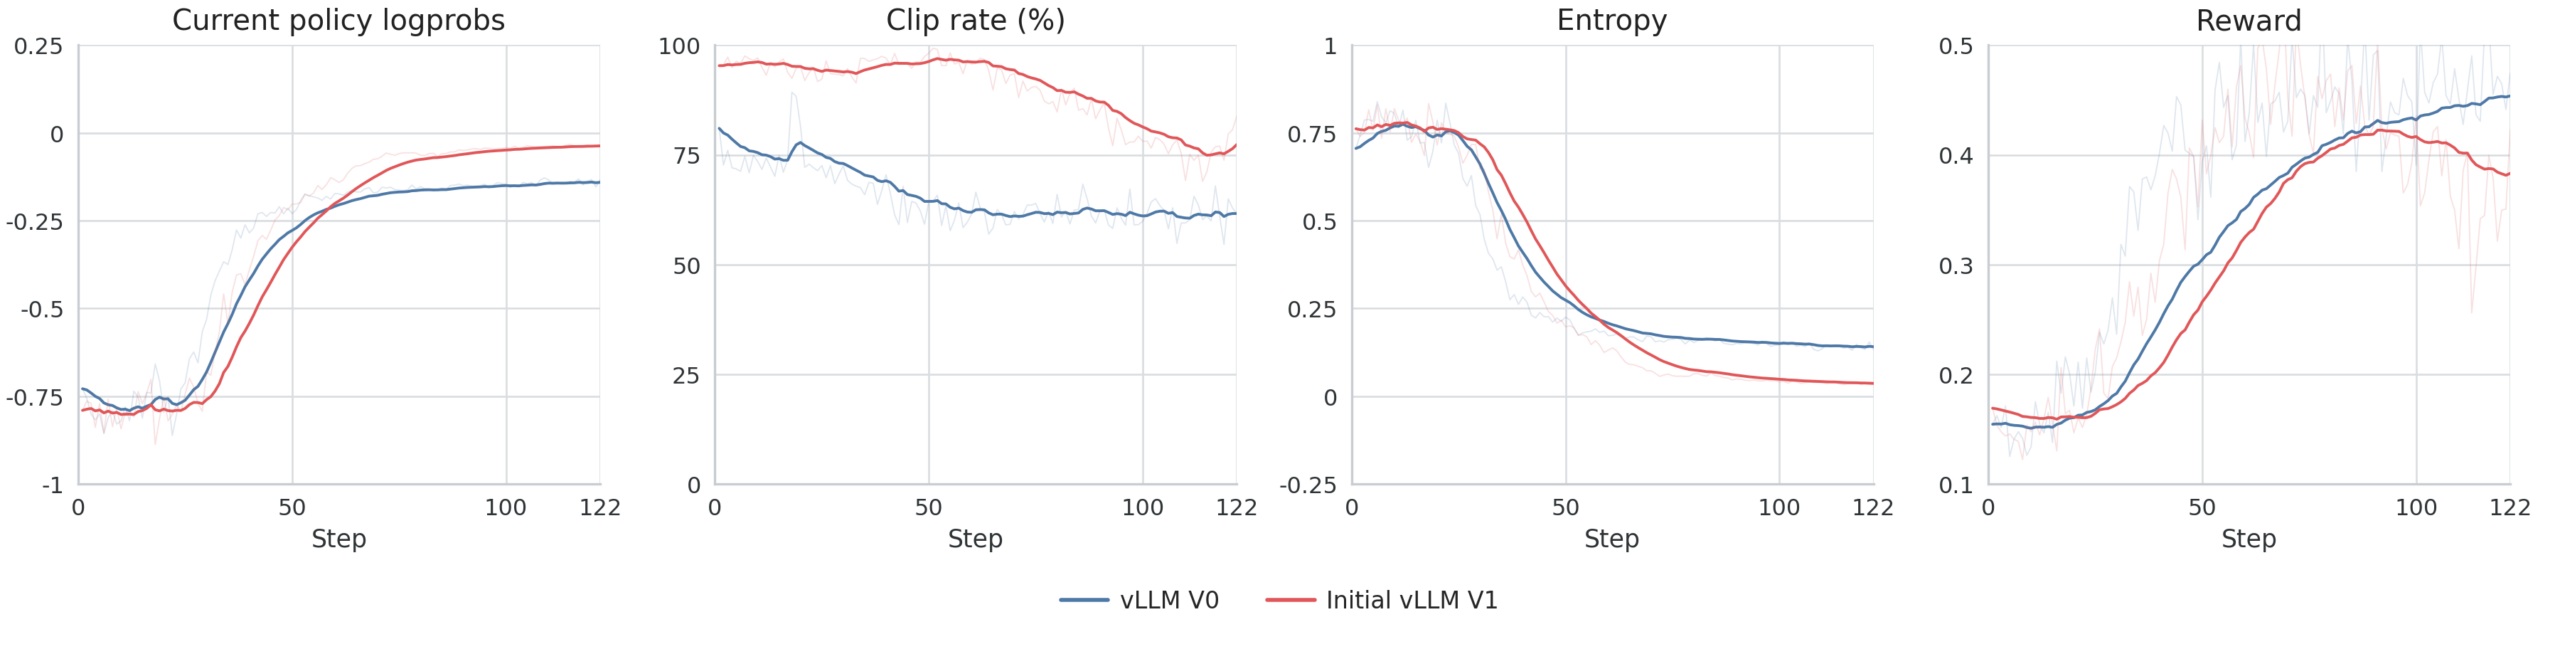
训练器的其他指标也呈现同样的趋势。在最初的对比中,裁剪率是最直观的信号。
把可能的故障分成三层
我们把原因划分为三个层次:
- 语义不一致:后端返回的 logprob 与训练器期望的 logprob,含义不同。
- 推理路径不一致:缓存、调度或请求处理的默认设置发生变化,使相同提示词经过不同执行路径。
- 目标函数不一致:对于剩余的策略陈旧程度或后端差异,需要在 RL 目标函数中加入修正。
我们一开始过早怀疑了第三层。真正有效的诊断来自先把前两层视为后端行为问题,并逐一排除。
修复 V1 后端
第一项:logprob 的语义
首先是语义问题。按原文所用的 V1 版本,默认返回的是原始模型输出对应的 logprob,位置在 logits 后处理之前;后处理包括温度缩放、惩罚,以及 top-k、top-p 过滤。而 PipelineRL 需要的是采样器实际使用的、经过这些处理之后的概率分布的 logprob。
所需设置为 logprobs-mode=processed_logprobs。
这消除了 rollout logprob 明显的均值偏移,但训练曲线仍然与已知正常的参考运行存在差距。因此,下一个问题需要沿推理执行路径排查。
策略比率图直接反映了这一点。对 V1 启用 processed_logprobs 后,三个运行的平均策略比率都极接近 1.0。这证明均值偏差已经修复;剩余差异则仍体现在裁剪率、KL、熵及后续训练行为中。
第二项:运行时默认值
早期 V1 运行把“更换引擎版本”和“采用 V1 运行默认值”混在了一起:
- 没有显式设置前缀缓存,因而使用了 vLLM
0.18.1的默认行为。 - 没有显式设置异步调度,同样落入
0.18.1的默认行为。 - 还通过启动时透传关键字参数,临时添加了
disable-cascade-attn覆盖项;它不属于已提交配置中的一致性对照方案。
在对照运行中,我们把选择明确写进配置:
vllm_config:
  use_v1: true
  vllm_kwargs:
    logprobs-mode: processed_logprobs
    enable-prefix-caching: false
    async-scheduling: false
前缀缓存需要单独解释。对于固定模型状态,它通常是一项保持正确性的推理优化。但在这套在线 RL 系统中,相对 V0 参考路径,缓存的生命周期和复用方式构成了 V1 特有的差异。与此同时,actor 还在处理重复前缀、并发请求、异步调度与在途权重更新。
如果缓存策略不考虑权重更新边界,一次前缀缓存命中就可能复用更新之前计算出的状态。关闭前缀缓存,是为了在一致性对照中移除一个只有 V1 才有的变量。
第三项:在途权重更新
权重同步也必须匹配在线强化学习的更新模式。可以选择让 V1 比 V0 更严格:每次更新前等请求全部完成,再清空缓存。但这回答的是另一个问题。我们首先要验证的是,V1 能否复现现有 V0 的行为。
V0 的实际做法更接近以下过程:
- 在引擎边界处阻塞执行。
- 载入新权重。
- 恢复执行,不显式使缓存状态失效。
在 V1 中,最接近的写法是:
await engine.pause_generation(mode="keep", clear_cache=False)
await engine_client.collective_rpc_async(
    "receive_weight_update",
    args=(request.model_dump_json(),),
)
await engine.resume_generation()这里有两个关键细节。第一,mode="keep" 比 wait 或 abort 更接近旧的在途更新模型。第二,clear_cache=False 与 V0 包装层更新时保留缓存状态的行为一致。
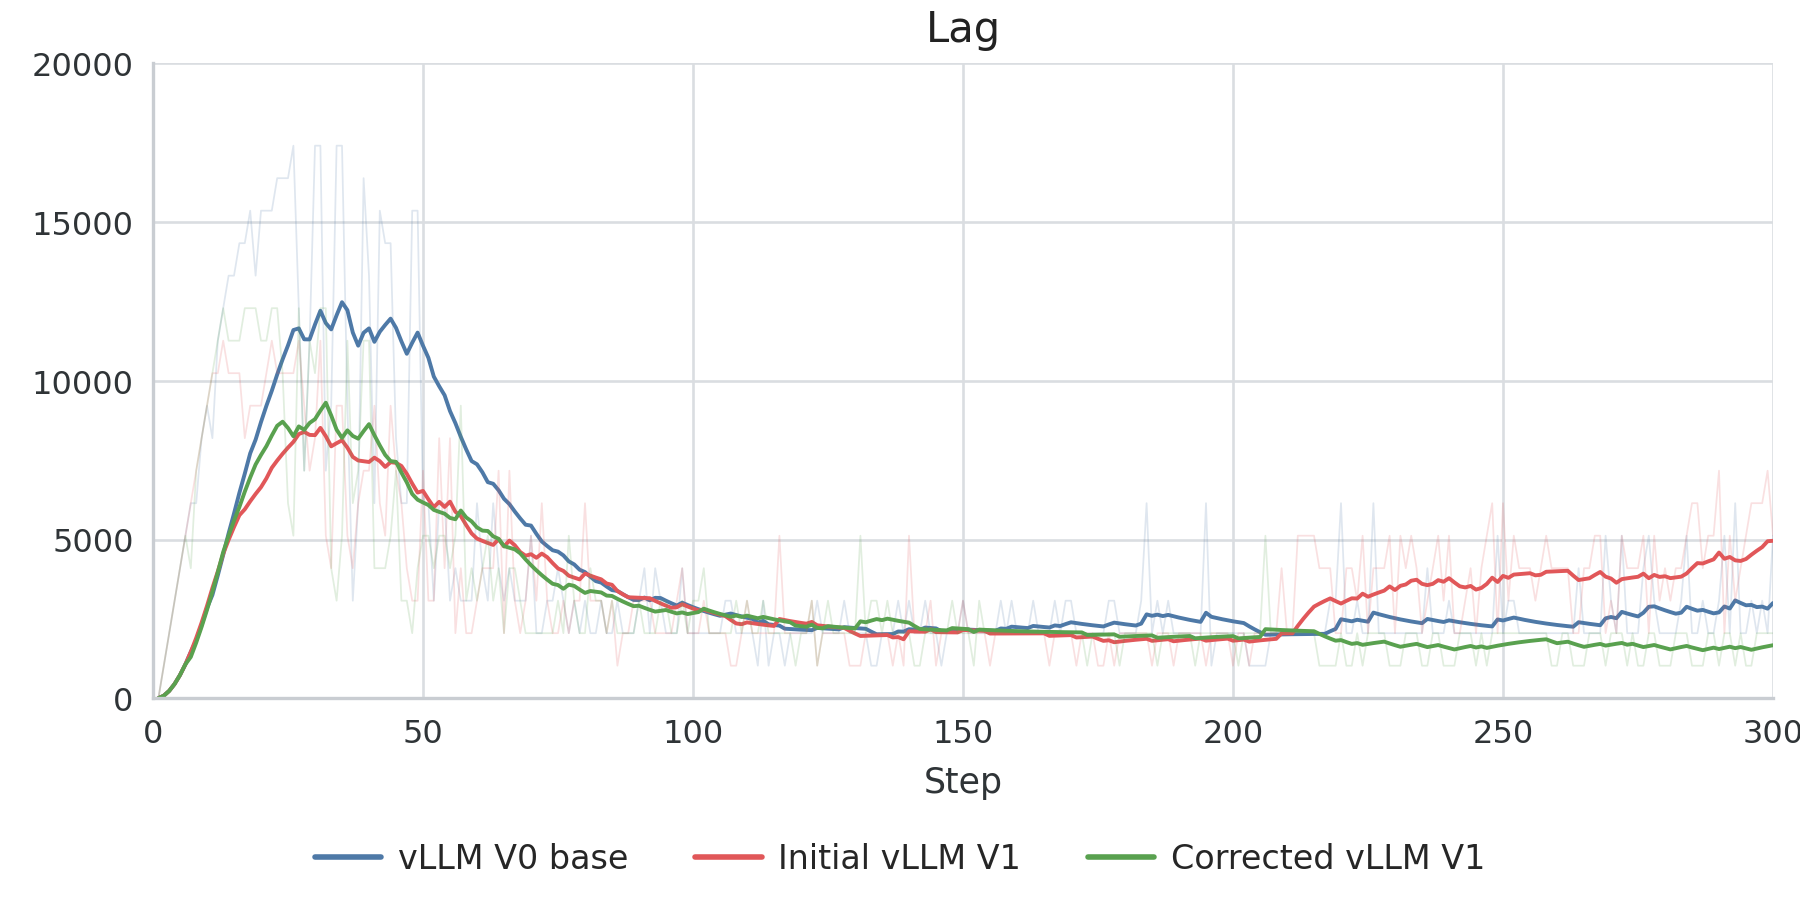
滞后程度(lag)是一个有用的运行时诊断指标。训练后期,最初 V1 路径的滞后比修正后的 V1 更持久。
最后的差距:fp32 的 lm_head
上述修复消除了明显的迁移问题,但最终要恢复一致性,还必须对齐计算 logits 的数值路径。训练器在最后的投影中使用 fp32 的 lm_head,rollout 后端也必须与之匹配。
作者指出,MiniMax-M1 技术报告中出现过很接近的问题:RL 训练与推理的 token 概率不一致,最终定位到语言模型输出头,并通过以 fp32 计算输出头解决。
这之所以重要,是因为 RL 更新直接使用 token logprob。logits 的微小变化可能反映到策略比率、KL 和裁剪行为中。因此,最终投影的计算精度属于在线 RL 正确性的一部分。作者还引用后来的 ScaleRL 论文:其中将 fp32 logits/输出头计算纳入 RL 配方,并通过消融实验讨论其在大规模 RL 中的作用。
加入 fp32 lm_head 路径之后,奖励曲线可以简洁展示最终对齐结果。图 6 中,最终 V1 运行跟随 V0 参考轨迹,而最初 V1 尝试的奖励曲线明显不同。
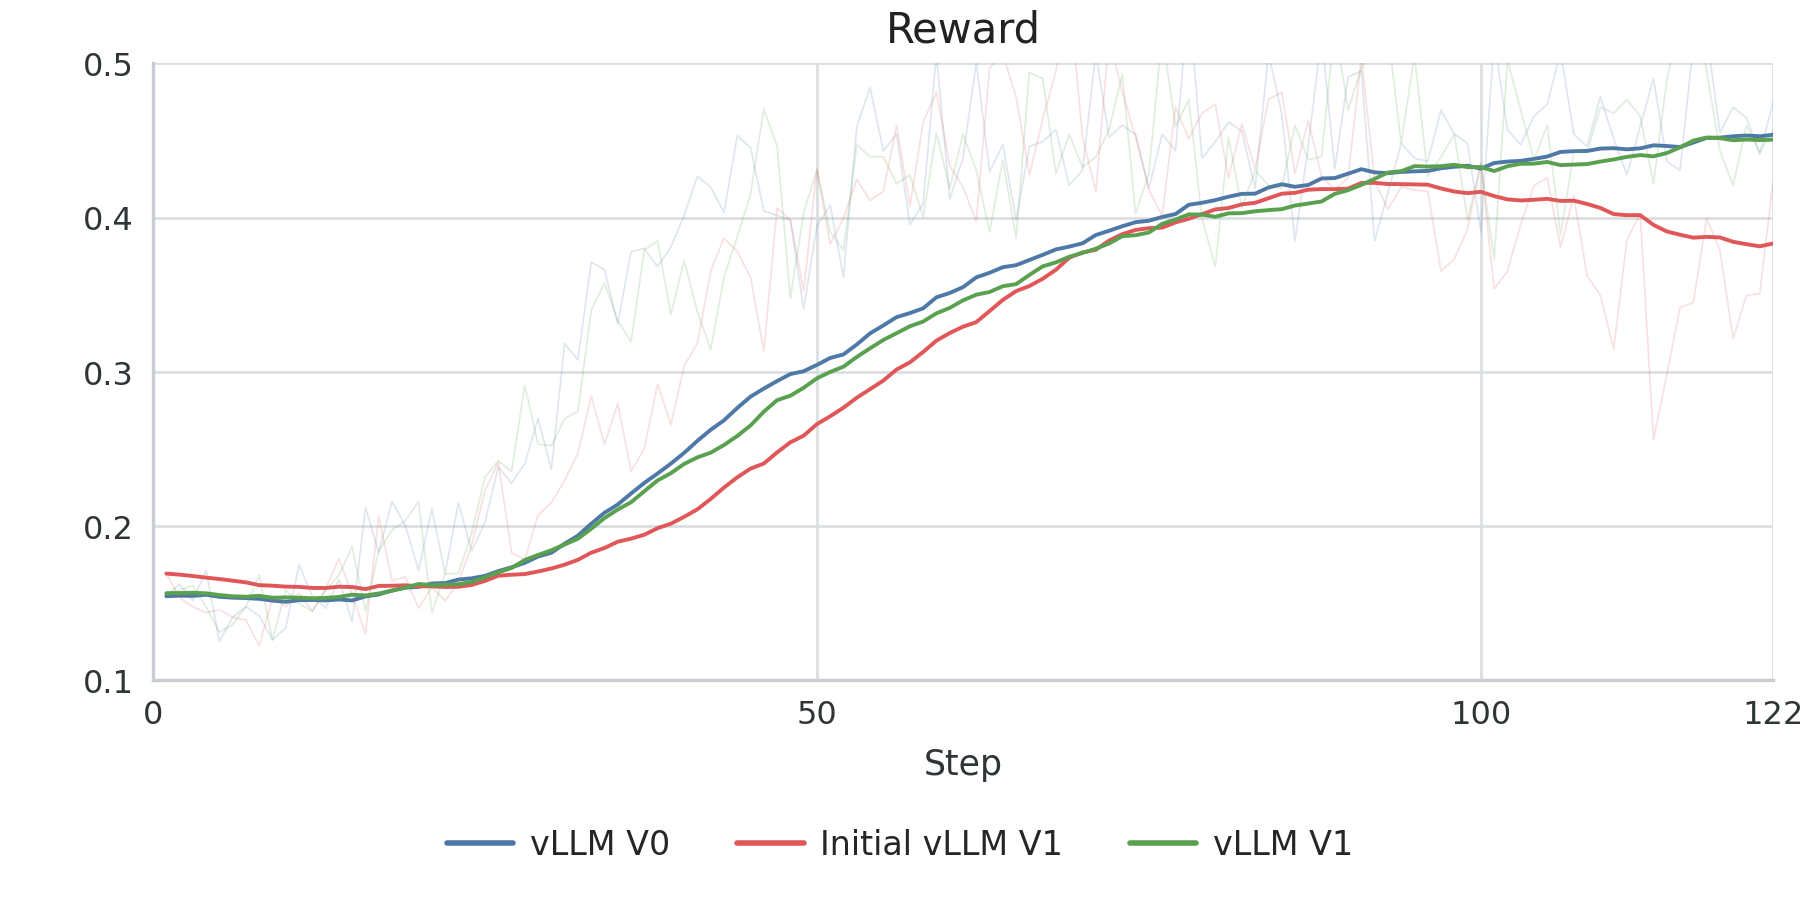
lm_head 的最终 V1(绿)的奖励。采用 fp32 输出头后,最终 V1 跟随 V0 参考运行。图及实验归属原作者 / ServiceNow-AI。消融:哪些解释没有成立
负面结果同样重要,因为它们能排除常见解释:
- 只开启
processed_logprobs:修复了 logprob 的语义错误,但训练不一致仍然存在。 - 批次不变性(batch invariance):另一次独立测试中,差异仍未消失,并伴随更高的滞后、更高的裁剪率和 NCCL 相关问题。
- 把第一次 V1 运行当成公平基线:最初运行启用了多个 V1 专有默认行为,因此这是一组存在混杂因素的迁移比较。
为什么先修后端正确性
截断重要性采样、重要性比率重加权,以及其他目标函数侧修正,都是有用的工具。如果 rollout 本来就有意允许陈旧、以异步方式生成,或者所用后端无法做到与训练器策略等价,那么加入某种修正通常是合理的。
但这里的第一问题是推理正确性。迁到 V1 后,rollout 后端返回的 logprob 及其运行行为破坏了训练器原有假设。此时立即加入目标函数修正,就会把两个问题混在一起:
- 推理后端是否产生了正确的 logprob?
- 在 logprob 正确的前提下,目标函数是否仍然需要离策略或异步修正?
这两个问题必须分开。否则,目标函数修正可能恰好补偿了有问题的后端行为,反而让训练曲线难以解释。
现有目标函数当然还有改进空间。恢复推理一致性之后,下一步才是通常的异步/离策略整理工作:
- 明确保留 rollout 生成时的行为策略 logprob。
- 在优化时重新计算训练器侧的旧策略 logprob。
- 把后端不一致修正与策略更新比率分离。
- 除了汇总训练器指标,还跟踪修正项的有效样本量 ESS 等诊断信息。
这次迁移的核心经验更具体:先修复后端正确性,再针对仍然存在的不一致加入修正。











暂无评论内容